Когда эндпоинт модели возвращает ошибки или ответы замедляются, инженерам инфраструктуры необходимо найти первопричину среди распределенных ресурсов обслуживания. Готовы ли поды воркеров? Может ли кластер выделить дополнительную емкость, которую запрашивает рабочая нагрузка? Фреймворки инференса распределяют эту работу между ресурсами Kubernetes, из-за чего инженерам приходится собирать воедино конфигурацию модели, состояние подов и события планирования с помощью разрозненных команд и дашбордов.
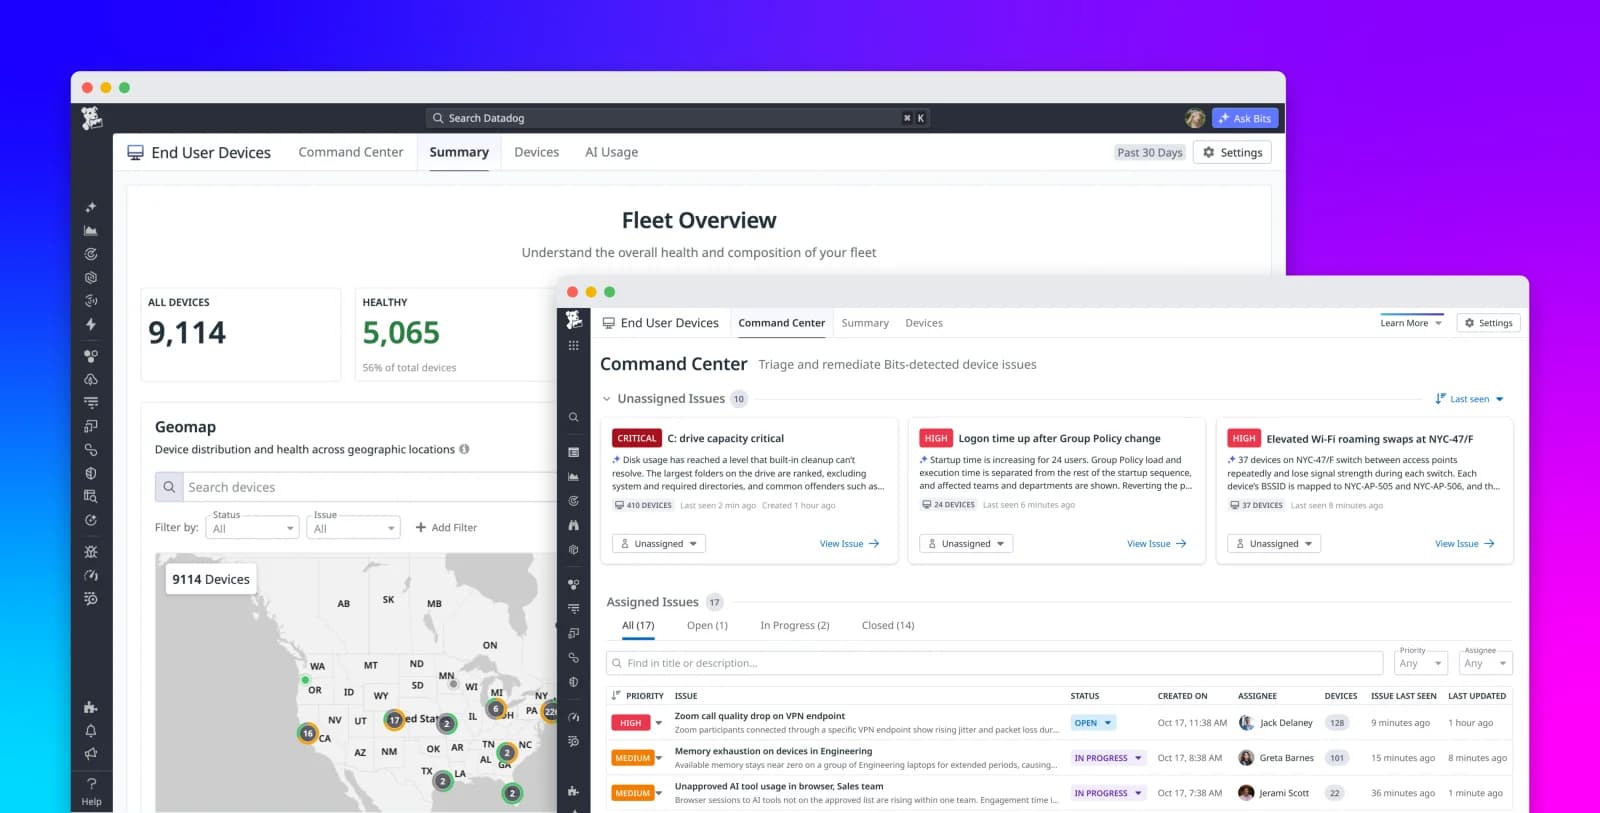
Рабочая нагрузка инференса Kubernetes в Datadog, доступная теперь в режиме предварительного просмотра (Preview), связывает конфигурацию оркестрации, объявленную в пользовательских ресурсах (custom resources), с управляемыми ими ресурсами по всему кластеру. В Kubernetes Explorer инженеры могут сравнить эту конфигурацию с наблюдаемым состоянием подов и доступными метриками во время выполнения. Контекст модели, компонента и пода помогает выявить проблемные поды, исследовать проблемы с готовностью и понять, как решения по планированию и масштабированию влияют на емкость обслуживания. Поддерживаются рабочие нагрузки на базе vLLM с использованием KubeRay, NVIDIA Dynamo и KServe.
В этой статье мы покажем вам, как:
- Объединить ресурсы инференса в одно представление рабочей нагрузки
Объединить ресурсы инференса в одно представление рабочей нагрузки
- Исследовать надежность инференса в ваших кластерах Kubernetes
Исследовать надежность инференса в ваших кластерах Kubernetes
- Исследовать ограничения емкости GPU
Исследовать ограничения емкости GPU
Объединить ресурсы инференса в одно представление рабочей нагрузки
Согласно CNCF’s 2025 survey, 66% организаций, размещающих модели генеративного ИИ, сообщили об использовании Kubernetes для некоторых или всех своих рабочих нагрузок инференса.
В Datadog рабочая нагрузка инференса — это виртуальный ресурс, который объединяет ресурсы Kubernetes, поддерживающие модель обслуживания. В Kubernetes Explorer контекст модели, фреймворка и кластера помогает определить рабочую нагрузку для исследования. В представлении рабочей нагрузки изучите связанные ресурсы, такие как поды, развертывания (deployments), наборы реплик (replica sets) и управляющие ими пользовательские ресурсы. Доступные детали зависят от фреймворка и его конфигурации.
Datadog уже позволяет проверять пользовательские ресурсы в Kubernetes Explorer. Мониторинг рабочих нагрузок инференса объединяет пользовательский ресурс, лежащие в его основе объекты Kubernetes и движок инференса — например, vLLM, запущенный внутри обслуживающих контейнеров — в единое представление рабочей нагрузки.
Сопоставление телеметрии по компонентам рабочей нагрузки
Datadog автоматически обнаруживает поды, выполняющие поддерживаемые фреймворки инференса, и присваивает теги inference_workload и inference_workload_component. Метрики, трейсы и логи наследуют эти теги, когда их можно связать с этими подами. Вы можете использовать теги для сопоставления телеметрии рабочей нагрузки или компонента в продуктах Datadog.
Рабочие нагрузки инференса также доступны через инструменты MCP Kubernetes в Datadog. С помощью совместимого с MCP ассистента вы можете обнаруживать рабочие нагрузки инференса и определять их модель и фреймворк. Используйте инструменты ресурсов Kubernetes для проверки деталей базовых ресурсов, отношений родитель-потомок и манифестов при исследовании состояния и конфигурации подов.
Исследование готовности к инференсу и использования ресурсов
Сам по себе запущенный под еще не гарантирует работоспособность системы обслуживания. Маршрутизация, состояние кэша и взаимосвязь между компонентами обслуживания также могут влиять на производительность.
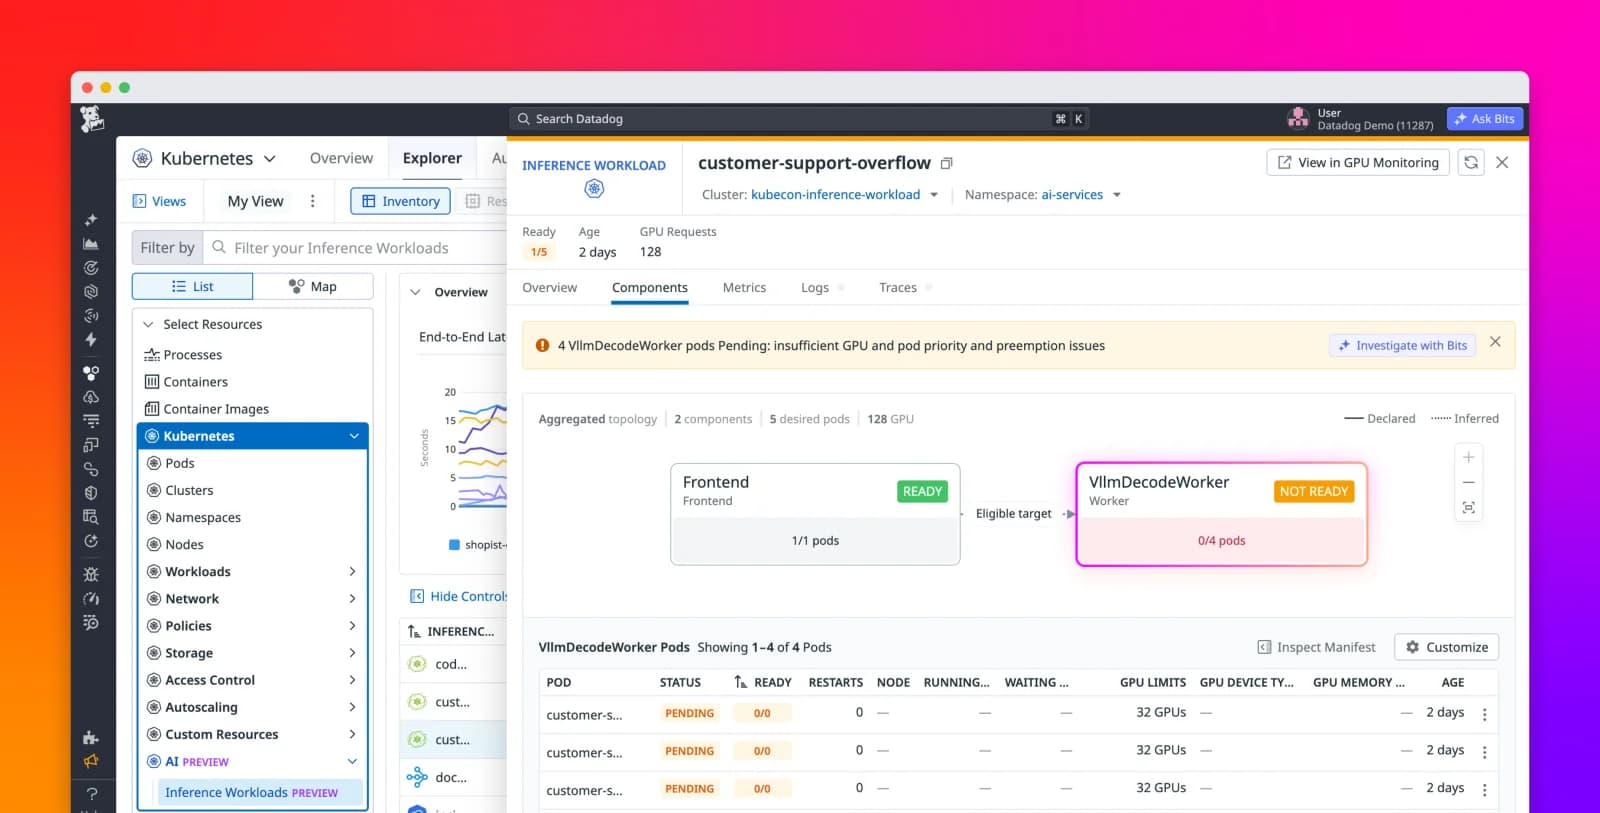
Используйте вкладку Компоненты (Components) для проверки работоспособности подов в структуре обслуживания фреймворка, например головных и рабочих компонентов Ray или фронтенда и рабочих компонентов Dynamo. Топология показывает готовность каждого компонента и количество подов, а поды выбранного компонента отображаются ниже. Проверьте статус подов, перезапуски, размещение на узлах и детали планирования, чтобы отличить поды, ожидающие ресурсов, от работающих подов, которые неисправны.
Используйте вкладку Метрики (Metrics) для анализа производительности во время выполнения и использования ресурсов. Для рабочих нагрузок Dynamo с платным доступом к мониторингу GPU и настроенным сбором данных доступные метрики включают память GPU, активность и степень занятости, а также использование CPU и памяти контейнером. Сравните эти сигналы на работающих подах, чтобы выявить нехватку ресурсов, а затем выберите Просмотр в мониторинге GPU (View in GPU Monitoring) для исследования работоспособности устройства. В совокупности состояние подов и телеметрия GPU помогают определить, на чем следует сосредоточиться: на оркестрации, емкости или аппаратном обеспечении.
Исследование ограничений емкости GPU
Пользовательский ресурс определяет, как должна работать рабочая нагрузка инференса; статус ресурсов и готовность подов показывают, вступает ли эта конфигурация в силу. Представьте критически важную модель Dynamo с отдельными компонентами предварительного заполнения (prefill) и декодирования (decode). Заметив отклонение в основной таблице или получив оповещение по модели, вы открываете вкладку Компоненты (Components) рабочей нагрузки и обнаруживаете под воркера декодирования, зависший в статусе Pending. В деталях его планирования сообщается о недостаточной емкости для требуемого типа GPU, что объясняет, почему запрошенная емкость обслуживания не стала доступной.
Поиск емкости для высвобождения
Чтобы найти емкость, которую можно высвободить, отфильтруйте страницу Рабочие нагрузки инференса (Inference Workloads) по этому типу GPU и изучите другие рабочие нагрузки, использующие его. В этом примере модель Dynamo с более низким приоритетом потребляет емкость, необходимую критически важной рабочей нагрузке. Проанализируйте требования к модели и конфигурацию ресурсов, чтобы оценить, целесообразно ли уменьшать ее масштаб. Для клиентов с включенным мониторингом GPU перейдите по ссылке «Просмотр в мониторинге GPU», чтобы изучить использование и работоспособность устройств наряду с данными планирования.
Исследование с помощью Bits
Функция «Исследование с помощью Bits» (Investigate with Bits) использует инструменты Kubernetes MCP для сбора контекста рабочей нагрузки о находящихся в ожидании подах и рекомендации дальнейших шагов. В этом сценарии сокращение числа реплик модели с более низким приоритетом может высвободить емкость GPU для воркера декодирования критически важной модели при условии, что освобожденные ресурсы удовлетворяют требованиям к ее планированию.
Начните исследование инференса в Kubernetes с Datadog
Рабочая нагрузка инференса Kubernetes в Datadog связывает конфигурацию оркестрации с готовностью к обслуживанию, помогая командам переходить от симптома на уровне модели к подам и ограничениям емкости, лежащим в его основе. Используйте этот контекст для расследования сбоев размещения, поиска возможностей перераспределения GPU и оценки изменений в задействованных рабочих нагрузках.
Узнайте больше о мониторинге контейнеров Datadog и мониторинге GPU. Если вы впервые используете Datadog, зарегистрируйтесь для получения бесплатной 14-дневной пробной версии.