В эпоху искусственного интеллекта, когда телеметрия генерируется каждым вызовом модели, обращением к инструменту и шагом агента, организациям как никогда нужна помощь в управлении экономикой наблюдаемости.
Для многих команд стандартным ответом становится «диета данных»: сокращение сроков хранения, исключение сервисов или сред из сбора либо базовая выборка, в которой больше гадания на кофейной гуще, чем стратегии. В любом случае вы прибегаете к сокращениям ради экономии и рискуете потерять именно те данные, которые понадобятся во время инцидента.
Ваши затраты не должны расти пропорционально объему поступающих данных. Вместо этого они должны зависеть от ценности, которую эти данные приносят, чтобы вы платили только за хранение информации, которая оправдывает свое место.
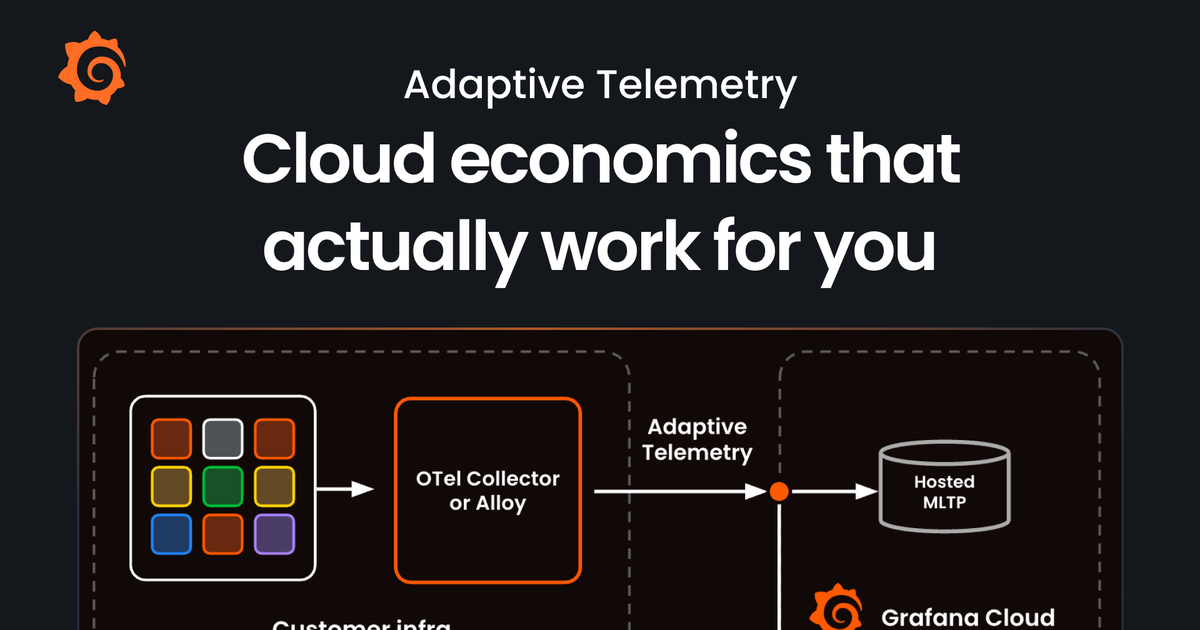
Именно для этого создана система Adaptive Telemetry, и такие организации, как Rapid7, уже видят результаты.
«Переход на Grafana Cloud и использование Adaptive Telemetry сократили наши расходы на метрики настолько, что этого хватило на финансирование логов и трассировок, — говорит Карл Истман (Carl Eastman), ведущий инженер-программист в Rapid7. — Наша видимость выросла, а затраты снизились, при этом дашборды и запросы стали работать быстрее и генерировать меньше шума».
Вы уже можете использовать Adaptive Telemetry для всех своих сигналов наблюдаемости, и мы продолжаем развивать эту платформу, чтобы вы могли еще точнее выбирать сохраняемые трассировки, повышать экономичность логов и извлекать максимум из Adaptive Metrics с меньшими усилиями. Вот как это выглядит на практике.
Сохраняйте только важные трассировки и сокращайте объем на 90%
Трассировки — это то, где диета данных бьет сильнее всего. Многие команды используют фиксированный процент выборки, который одинаково относится к медленному запросу оформления заказа и к рутинной проверке работоспособности. Уменьшите процент — и ваш счет уменьшится, но вместе с ним упадет и вероятность того, что нужная трассировка окажется на месте, когда что-то сломается.
Adaptive Telemetry уже справляется со сложной частью задачи (выборкой по хвостам — tail sampling) без необходимости настраивать конвейер. Три новые возможности делают хранение еще более точным.
Автоматически сохраняйте самые ценные трассировки без лишней рутины с правилами
Объемная выборка (volumetric sampling) дает более ценный результат, чем вероятностная выборка. Она справедливо распределяет ваш бюджет выборки между сервисами и типами запросов, поэтому низкоинтенсивные сервисы не вытесняются, а сама выборка продолжает адаптироваться по мере изменения трафика. Вы задаете одно число (процент выборки), не написав при этом ни единого сложного правила и не настраивая их вручную. В ходе тестирования Grafana Labs этот подход обеспечил примерно на 25% более высокую плотность информации по сравнению с вероятностной выборкой при том же объеме.
Сохраняйте хотя бы одну трассировку из каждого набора, чтобы всегда было на что опереться
Выборка по разнообразию (diversity sampling) гарантирует, что у вас всегда будет материал для анализа. Каждые 15 минут она сохраняет уникальную комбинацию таких атрибутов, как сервис, маршрут и коды состояния. Когда ваша среда меняется, вам не нужно писать и обновлять пользовательскую логику выборки для отслеживания нового сервиса или пути выполнения кода.
Проводите агрессивную выборку и все равно получайте именно те трассировки, которые вам нужны
Возможность запрашивать трассировки, отброшенные Adaptive Telemetry, служит вашей страховочной сеткой. Adaptive Telemetry сохраняет каждую отброшенную трассировку доступной для запросов по ее ID в течение 24 часов после поступления. Если у вас есть ID трассировки из строки лога, тикета техподдержки или фреймворка тестирования, вы можете получить эту конкретную трассировку, даже если Adaptive Telemetry отбросила ее. Отброшенные трассировки не отображаются в поиске или агрегациях, поэтому это именно инструмент поиска, а не замена выборке нужных для поиска трассировок. Именно это позволяет вам уверенно применять агрессивную выборку.
В совокупности эти функции позволяют значительно сократить объем трассировок, не опасаясь, что вы удалили что-то необходимое.
Объемная выборка и выборка по разнообразию, а также возможность запроса отброшенных трассировок, теперь общедоступны.
Повышайте экономичность логов, не жертвуя данными, которые могут вам понадобиться
Объемы логов растут быстро, и многое из того, что вы сохраняете, никто никогда не просматривает. Adaptive Logs уже умеет находить паттерны логов, к которым никто не обращается, и удалять их на входе. Теперь две новые функции помогают сокращать объем данных еще раньше и с большей уверенностью.
Удаляйте ненужные логи на источнике и сокращайте сетевые накладные расходы и исходящий трафик
Управляемая через Fleet Adaptive Logs использует те же правила отсечения и исключения, которые вы уже применяете, и распространяет их напрямую на ваши коллекторы с помощью Fleet Management. Совпадающие логи фильтруются еще до того, как покидают вашу среду, что позволяет сэкономить на исходящем трафике и сетевых расходах в дополнение к экономии на хранении.
Adaptive Logs создает и поддерживает синхронизацию конвейеров коллекторов за вас, поэтому ничего дополнительно писать или обслуживать не нужно. Рекомендации на основе паттернов по-прежнему работают в Grafana Cloud для всего, что осталось.
Сохраняйте то, что может пригодиться, в недорогом хранилище
Команды вполне обоснованно с опаской относятся к удалению логов. В конце концов, удаленную строку нельзя восстановить, поэтому нежелание рисковать понятно. Функции Archive и Replay меняют это положение дел.
Archive перенаправляет логи в ваше собственное недорожное объектное хранилище вместо того, чтобы удалять их. Replay возвращает их по требованию, когда они нужны для расследования, аудита или запроса на соответствие требованиям. Вы сохраняете экономию от отказа от индексации малоценных логов, не теряя при этом навсегда данные, которые могут понадобиться позже.
В этом и заключается сдвиг: меньшие затраты и надежный способ вернуть нужные данные.
Fleet-managed Adaptive Logs находится в стадии публичного превью. Функция Archive находится в публичном превью, а Replay появится в ближайшее время.
Получайте больше от Adaptive Metrics с меньшими усилиями
Adaptive Metrics отлично умеет находить неэффективность. Система анализирует, как именно ваши метрики используются на дашбордах, в алертах, правилах записи и запросах, и рекомендует агрегировать в версии с меньшей кардинальностью те метрики, которые никому не нужны в полной детализации. Подвох в том, что кто-то должен просматривать каждую рекомендацию, и для платформ-инженеров этот процесс быстро превращается в рутину. Истман из Rapid7 хорошо знаком с этим чувством:
«Раньше поиск неэффективности означал, что кто-то вручную копается в кардинальности метрик и объеме логов, и эта работа никогда не заканчивалась, потому что новые сервисы постоянно добавляли новые метрики, — говорит Истман. — Теперь Adaptive Metrics и Adaptive Logs выполняют этот анализ за нас... Наши инженеры тратят время на те немногие правила, которые требуют участия человека... а не на весь этот «длинный хвост»».
Применяйте экономию автоматически, не проверяя каждую рекомендацию
Функция Auto-Apply снимает с вас задачу по проверке. Включите ее для сегмента, и новые рекомендации будут применяться автоматически по мере их генерации, без участия человека.
Вы сами выбираете, где она работает, и можете исключить метрики, которые никогда не должны затрагиваться. Используйте режим coverage-first (в приоритете покрытие), чтобы автоматически идти в ногу с использованием, или режим cost-first (в приоритете затраты), если вы хотите гарантировать, что количество ваших временных рядов никогда не увеличится.
Функция Auto-Apply общедоступна. Полное руководство читайте в нашем недавнем блоге по этой теме.
Готовьтесь к новой волне телеметрии
ИИ принесет больше телеметрии, но это не значит, что вместе с ней должны расти расходы и шум. Избавьтесь от того, что никто не использует, сохраните важные сигналы и будьте уверены: нужные данные не пропадут навсегда. Вам больше не придется сокращать сроки хранения, исключать сервисы из сбора данных или настраивать выборку вслепую.
Это имеет значение, выходящее за рамки счета. Когда ваши расходы соответствуют ценности ваших данных, вы можете реинвестировать экономию в более широкое покрытие и лучшие аналитические данные, вместо того чтобы ограничивать объем данных. Rapid7 — отличный пример. Вот как они это описывают:
«Мы реинвестируем сэкономленные средства в покрытие наблюдаемости, а не просто складываем их в банк, — сказал Истман (Eastman). — Каждый сигнал должен оправдывать свое место, а экономия идет на оплату тех сигналов, которые это делают».
Будь то метрики, логи, трассировки или профили, Adaptive Telemetry помогает сохранять ценную информацию по мере роста объема данных.
Adaptive Telemetry доступна в Grafana Cloud. Попробуйте ее сегодня и ознакомьтесь с нашей документацией, чтобы узнать больше!