Вы расследуете ошибки оформления заказа, когда кто-то спрашивает, кто координирует инцидент. Поддержке требуется обновление информации, а другой участник реагирования ищет инструкцию (runbook). Вы прерываете то, что делали, чтобы все снова двигались в одном направлении.
Все эти запросы вполне разумны, но каждый из них отвлекает ваше внимание от понимания проблемы. Да, у вашей команды есть процесс обработки инцидентов, но его выполнение — это еще одна задача для того, кто и так занят.
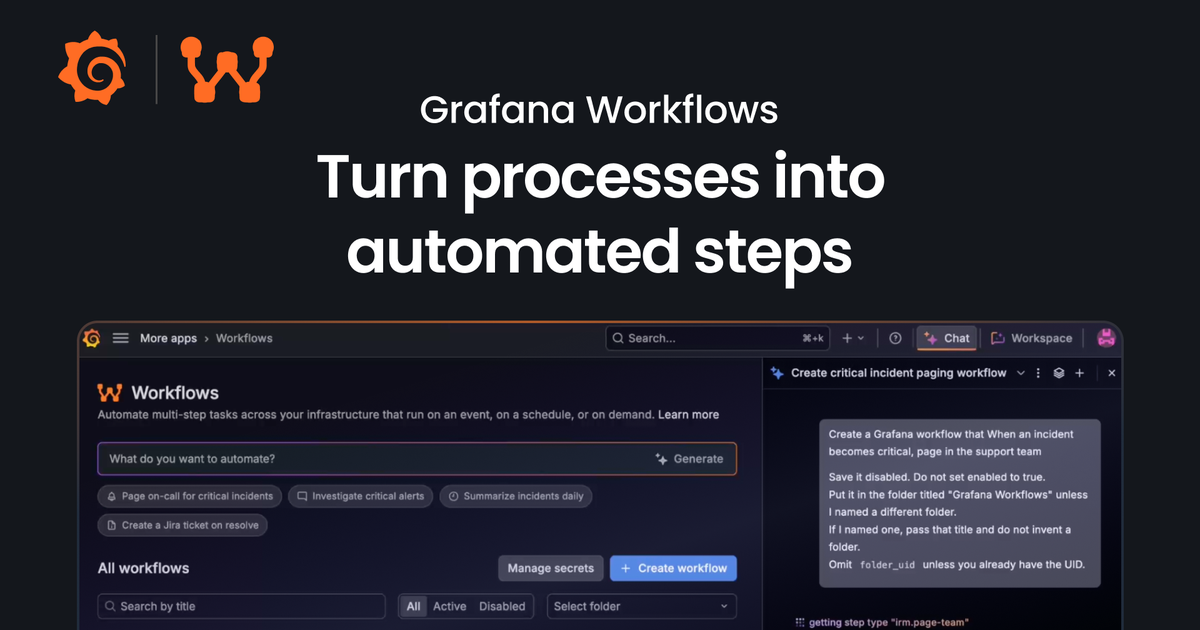
Grafana Workflows, доступная в публичной предварительной версии, превращает процессы вашей команды в автоматизированные шаги в Grafana Cloud и других ваших инструментах. Вы даже можете включить Grafana Assistant в эти шаги для расследования проблемы, суммирования результатов или подготовки проекта обновления. Например, рабочий процесс может создать канал инцидента, вызвать поддержку в соответствии с правилами вашей команды и попросить Assistant подготовить сводку на основе доступных данных.
Тот же подход работает и с вашей повседневной операционной деятельностью. Как только вы определяете рабочий процесс, Grafana Cloud может подготовить передачу смены следующему инженеру или собрать результаты для вашего еженедельного обзора сервиса. Вы решаете, что должно происходить последовательно и где ИИ может помочь разобраться в меняющейся информации.
Ускорьте реагирование на инциденты
Чтобы проиллюстрировать, как ваша команда может извлечь выгоду из Workflows, давайте рассмотрим процесс реагирования на серьезный инцидент.
Для начала вашей команде нужно место для совместной работы и кто-то, кто будет координировать реагирование. Инструкция помогает, но кто-то все равно должен найти дежурного командира, открыть канал и поделиться правильными ссылками.
Workflows включают в себя чертежи (blueprints) — готовые шаблоны, которые можно адаптировать под процесс вашей команды. Для проекта такого типа вы можете начать с чертежа запуска серьезного инцидента, который может автоматически реагировать на активный критический инцидент в Grafana Cloud IRM, включая инцидент, который только что был эскалирован до критического.
Он создает связанный канал в Slack, ищет ваше расписание командиров инцидентов и назначает дежурного командира. Он также публикует ваши инструкции по реагированию, добавляет в закладки инструкцию и страницу инцидента, а также записывает информацию о заезде на шкалу времени. Если никто не дежурит, он оставляет заметку, чтобы команда знала о необходимости назначения командира.
Теперь у участников реагирования под рукой есть запись об инциденте и инструкция, и командир может приступить к координации расследования. Настройка следует тому процессу, который вы настроили.
Исходя из этого, вы можете развивать данный фундамент. Предположим, ваша политика заключается в том, чтобы привлекать поддержку к каждому критическому инциденту. Просто добавьте шаг, который вызывает вашу службу поддержки в IRM, и еще один, который публикует ссылку на инцидент в их канале Slack. Поддержка может подключиться, пока инженеры ведут расследование, не дожидаясь, пока кто-то вспомнит о еще одной передаче смены.
Примечание: Workflows в настоящее время доступны в разделе "Больше приложений" (More apps) в меню навигации Grafana Cloud.
Примечание: Workflows в настоящее время доступны в разделе "Больше приложений" (More apps) в меню навигации Grafana Cloud.
Размещайте результаты работы ИИ там, где они нужны людям
Собрать всех вместе — это только начало. Следующему присоединившемуся нужно будет узнать, что происходит, что вы уже проверили и где искать дальше.
Дополните рабочий процесс запуска шагом запроса к Assistant. Передайте Workflows ссылку на инцидент, затрагиваемый сервис и конкретную задачу:
Изучите этот инцидент и доступные сигналы ошибок и задержек вокруг времени его начала. Обобщите наблюдаемые симптомы, дайте ссылки на доказательства и предложите следующие проверки. Отделите наблюдения от гипотез и отметьте недостающую информацию.
Изучите этот инцидент и доступные сигналы ошибок и задержек вокруг времени его начала. Обобщите наблюдаемые симптомы, дайте ссылки на доказательства и предложите следующие проверки. Отделите наблюдения от гипотез и отметьте недостающую информацию.
Assistant проводит расследование, используя доступный контекст наблюдаемости, и возвращает сводку. Последующие шаги рабочего процесса публикуют сводку в канале инцидента и добавляют ее на шкалу времени инцидента. Команда может следить за доказательствами и задавать более точные вопросы, а те, кто присоединится позже, получат отправную точку для того, чтобы войти в курс дела.
В то же время у поддержки есть другая потребность. Им нужно превратить технические результаты в понятные обновления для клиентов. Обновление статуса инцидента может запустить рабочий процесс, который попросит Assistant содрать это объяснение на основе подтвержденных фактов. Шаг публикации сообщения в канал Slack отправляет проект во внутренний канал поддержки, где команда проверяет и редактирует его перед внешним распространением.
Именно здесь сочетание правил и ИИ становится полезным. Вы определяете триггер, задачу и пункт назначения. Assistant интерпретирует предоставленный контекст и возвращает результат, который может использовать следующий шаг. Инженеру не нужно копировать ответ из чата и помещать его в нужное место.
Вы также можете использовать ИИ для ответа на конкретный вопрос, который определяет следующий шаг в вашем реагировании. Например, при срабатывании алерта рабочий процесс может попросить Assistant оценить, затронуты ли клиенты, и оценить их количество. Если результат превышает заданный вами порог, рабочий процесс может объявить об инциденте и вызвать дежурного SRE. Эта целенаправленная оценка может проводиться параллельно с более широким расследованием первопричины.
Дайте следующему дежурному инженеру фору
Вскоре ротация меняется, и заступающий инженер спрашивает: "Есть ли что-то, что мне следует знать?"
Достаточно полный ответ на этот вопрос может потребовать определенных усилий. Вы помните об инциденте, который все еще открыт и свеж в вашей памяти, но заступающему инженеру также необходимо знать, какие алерты заслуживают повторного внимания. Сбор этого контекста становится еще одной задачей, которую нужно решить до того, как вы сможете сдать смену.
Чертеж отчета о передаче дежурства делает подготовку этого контекста частью смены ротации. Он следит за выбранным вами расписанием IRM и просит Assistant просмотреть недавние инциденты и группы алертов команды. По умолчанию он просматривает прошедшую неделю, а затем публикует сводку в Slack со ссылками на соответствующие записи.
Промпт просит Assistant начать с того, что требует внимания прямо сейчас: активных инцидентов, повторяющихся алертов и последующей работы. Вы можете настроить временное окно и фокус отчета в соответствии с вашей ротацией.
Уходящий инженер может добавить все, что не попало в отчеты. Заступающий инженер получает сводку для проверки и дальнейшей работы по мере вступления в должность. Это облегчает передачу смены для обоих участников, особенно после напряженного дежурства.
Приходите на обзор сервиса с готовыми результатами
Инцидент теперь решен, но на этом работа не заканчивается. Регулярные обзоры сервисов имеют собственную нагрузку по подготовке. Например, вы можете захотеть обсудить, ухудшается ли задержка или бюджетам ошибок требуется внимание. Сначала кто-то должен открыть дашборды, сравнить цифры и собрать обновление для всех остальных.
Чертеж еженедельной сводки о работоспособности сервиса может подготовить эту первую оценку в Slack. Настройте его запуск перед встречей для сервисов, которыми владеет ваша команда.
Ассистент анализирует статус SLO за предыдущую неделю, потребление бюджета ошибок, а также тенденции ошибок и задержек вместе с соответствующими инцидентами и алертами. Он готовит оценку работоспособности для каждой службы и выделяет риски на предстоящую неделю. Следующий шаг рабочего процесса публикует сводку в Slack.
Ваша команда приходит на разбор с готовой оценкой для обсуждения, поэтому вы можете потратить время на определение того, что требует внимания.
Начните с одного процесса, который ваша команда уже повторяет
Готовы начать работу с Workflows? Выберите ту часть вашей недели, которая постоянно требует от кого-то сбора контекста или координации следующего шага. Выберите отправную точку из библиотеки шаблонов или опишите свой процесс Grafana Assistant и попросите его создать для вас рабочий процесс.
Рабочий процесс открывается в отключенном состоянии, поэтому вы можете просмотреть и протестировать его, прежде чем включать. Визуальный редактор показывает, как шаги связаны между собой. История запусков позволяет проверять их входные и выходные данные, а также ошибки, помогая контролировать как выполненные действия, так и информацию, передаваемую между ними.
Например, нажмите кнопку ниже, чтобы создать свой первый рабочий процесс с помощью подсказки Assistant для создания ежедневной сводки по инцидентам и активным алертам.
Grafana Workflows теперь доступна в рамках публичного предварительного просмотра. Воспользуйтесь руководством по началу работы, чтобы опробовать свой первый шаблон и узнать больше об этой новой функции в Grafana Cloud. Начните с настройки инцидентов, которую вы постоянно повторяете, передачи смены, которая всегда занимает слишком много времени, или обзора сервиса, на подготовку которого у вас вечно не хватает времени. Упростите один этот процесс, а затем развивайте успех дальше.