Аналитики, инженеры по данным и даже бизнес-пользователи пишут все меньше SQL и Python вручную. Вместо этого они дают подсказки агенту, и при наличии правильного контекста (моделей данных, документации, каталога данных) агент пишет вполне приличный запрос. Представьте себе BI-инструмент, который смещается влево и демократизирует новый контекст из моделей и источников данных. Это помогает агентам лучше понять бизнес-проблему и написать более точный SQL-запрос.
С более продвинутыми инструментами, которые автоматически просматривают или генерируют запросы итеративно, качество вывода агентов с каждым разом повышается. Модели совершенствуются, и мы можем добавлять дополнительную документацию из внутренних страниц Confluence или каталогов данных, и это станет еще лучше.
При использовании генеративного ИИ для BI-инструментов нам нужны лучшие способы проверки базовой основы для дашборда. Но как? Что нам нужно в дальнейшем, так это линтеры и компиляторы, которые выполняют ИИ-линтинг всего перед запуском, а также интегрированные наборы тестов, которые становятся все лучше и лучше. По сути, возврат к разработке через тестирование (Test-Driven Development): сначала формулировка тестов в виде промптов, чтобы мы заявляли то, что хотим построить.
По мере того как модели совершенствуются, итеративные наборы тестов также улучшаются, и вместе с этим мы получаем улучшенную верификацию. Но все же в верификации сегодня заключается главная сложность агентной инженерной работы, и именно об этом мы говорим в данной статье: помогаем дата-аналитикам и экспертам в предметной области разрабатывать более значимую работу с данными для организации.
Нам нужно перенести всю логику в одно место, чтобы перейти от стека компонентов к стеку, оптимизированному для эргономики человека. Нам нужны новые способы сделать это удобным для человека, даже новая архитектура — единое дерево происхождения данных. В этой статье рассматриваются текущие проблемы в BI с фундаментальных позиций, анализируется то, что работало до сих пор, что уже не работает и как мы можем улучшить архитектуру для более эффективного предотвращения ошибок.
📝 Люди уже чувствуют это. В опросе Metabase, проведенном во время недели AI analytics, 74% команд создавали решения с помощью ИИ, и только 2% масштабировали их. Узкое место сместилось от создания анализа к его проверке. Пройдите тест на готовность к ИИ, чтобы узнать, где находится ваша команда
📝 Люди уже чувствуют это
В опросе Metabase, проведенном во время недели AI analytics, 74% команд создавали решения с помощью ИИ, и только 2% масштабировали их. Узкое место сместилось от создания анализа к его проверке.
Пройдите тест на готовность к ИИ, чтобы узнать, где находится ваша команда
Верификация с помощью агентов через наборы тестов и человеческая интуиция?
Итак, первый вопрос заключается в том, что нам нужно проверять? Что такое итеративный набор тестов?
Если дело доходит до проверки метрик и KPI, все сводится к математике. KPI удержания (retention) создан в коде, определен в SQL. Это математика. Агенты со временем сгенерируют правильный набор тестов для проверки KPI удержания на основе тысяч тестовых случаев, — сказал Самеер Аль-Сахран (Sameer Al-Sakran), генеральный директор Metabase. Это стандартное уравнение: с evals, запускаемым механизмом выполнения (новый дух времени), агенты могут выявлять крайние случаи (edge cases).
Но с другой стороны, вам также необходима верификация человеком. Самеер сказал:
Люди из бизнеса — это лучшие контракты данных, они знают, когда что-то не имеет смысла, они знают цифры. К тому же они чувствуют это на подсознательном уровне.
Люди из бизнеса — это лучшие контракты данных, они знают, когда что-то не имеет смысла, они знают цифры. К тому же они чувствуют это на подсознательном уровне.
Это интуиция, приобретенная за годы опыта, понимание того, какими должны быть цифры в том или ином случае. Таким образом, набор тестов может быть инициирован в начале, доработан и улучшен, но человек привносит в этот процесс свою интуицию.
Такие фреймворки, как Superpowers, задают вопросы человеку по ходу дела, а Ponytail побуждает агента изначально писать меньше кода.
Пять уровней иерархии для тестирования системного качества
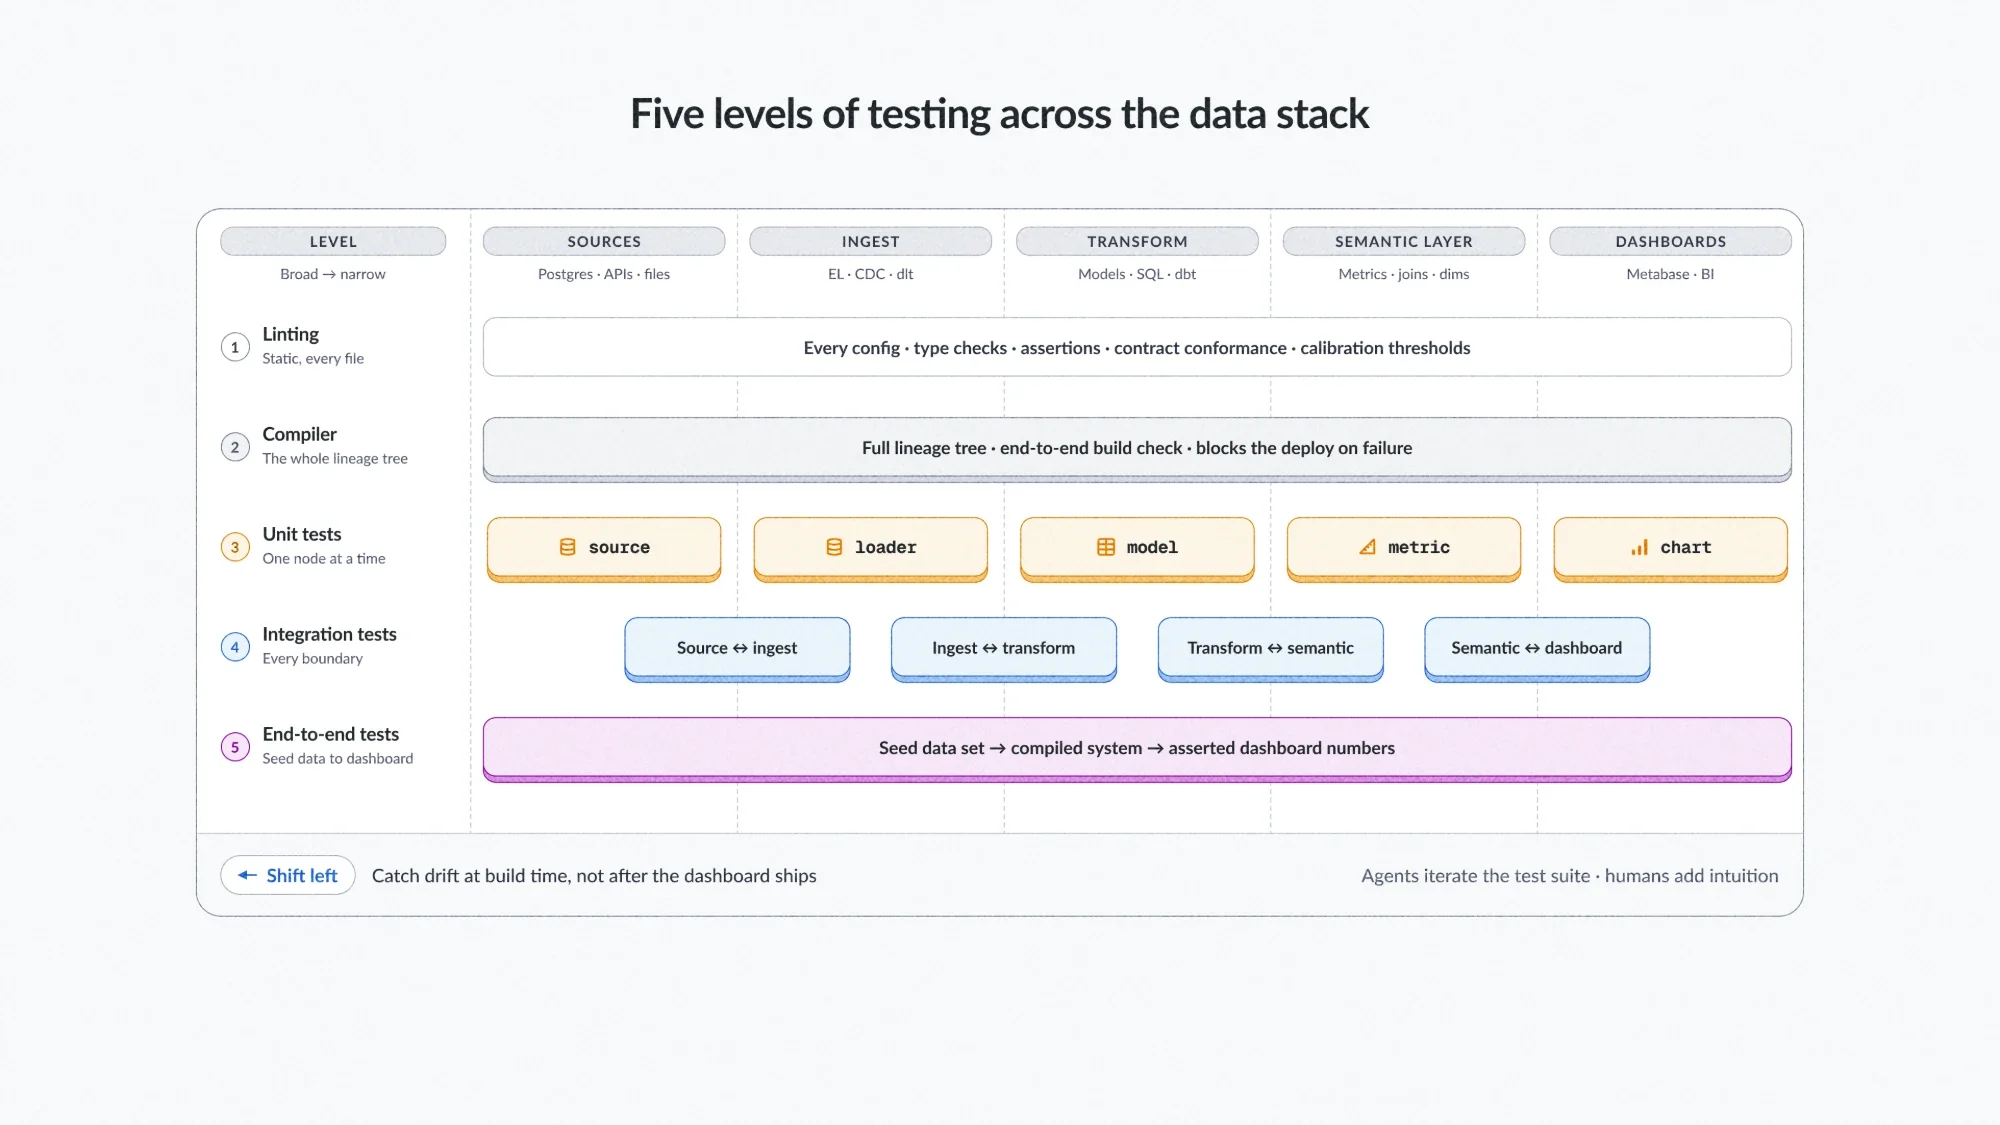
Для тестирования всего стека данных нам нужны системные тесты и тесты, которые выполняются на разных уровнях. Ниже приведены пять различных иерархий для тестирования с повышенным качеством:
- Линтинг (Linting): статический анализ нашего кода разработки и агрегаций без их запуска, предоставление в реальном времени диагностики наших метрик и конфигураций с помощью проверки типов и соблюдения контрактов.
Линтинг (Linting): статический анализ нашего кода разработки и агрегаций без их запуска, предоставление в реальном времени диагностики наших метрик и конфигураций с помощью проверки типов и соблюдения контрактов.
- Компилятор (Compiler): проверка всего дерева, которая разрешает и проверяет типы всего дерева происхождения перед развертыванием и запуском в среде, отказываясь собирать то, что не стыкуется друг с другом.
Компилятор (Compiler): проверка всего дерева, которая разрешает и проверяет типы всего дерева происхождения перед развертыванием и запуском в среде, отказываясь собирать то, что не стыкуется друг с другом.
- Модульное тестирование (Unit Test): тестирование небольших функций и компонентов всей системы каждый раз, когда мы что-то меняем. Здесь находятся утверждения значений (value assertions) и пороговые значения калибровки для известных входных данных.
Модульное тестирование (Unit Test): тестирование небольших функций и компонентов всей системы каждый раз, когда мы что-то меняем. Здесь находятся утверждения значений (value assertions) и пороговые значения калибровки для известных входных данных.
- Интеграционные тесты (Integration Tests): аналогичны модульным тестам, но мы тестируем несколько частей системы, модулей или компонентов как группу для проверки взаимодействия.
Интеграционные тесты (Integration Tests): аналогичны модульным тестам, но мы тестируем несколько частей системы, модулей или компонентов как группу для проверки взаимодействия.
- Сквозные тесты (End-to-End Tests): запуск скомпилированной системы со специализированными наборами данных (seeds) и проверка результатов от начала до конца.
Сквозные тесты (End-to-End Tests): запуск скомпилированной системы со специализированными наборами данных (seeds) и проверка результатов от начала до конца.
Если сложить все это вместе, мы сможем получить тщательные и хорошо протестированные KPI для бизнес-аналитики и стека данных от начала до конца благодаря возможностям новейшей агентной инженерии, а также элементу человеческого вмешательства и интуиции.
ℹ️ Единый балл тестирования для представления качества данных? Конечная цель состояла бы в том, чтобы иметь единый балл тестирования, который дает вам представление о том, насколько хороши качество данных, ETL, агрегации и дашборды, но сделать это действительно сложно. Опять же, здесь набор тестов имеет больше смысла. Кроме того, агенты лучше справляются с тестированием узких областей в широком наборе тестов.
ℹ️ Единый балл тестирования для представления качества данных?
Конечная цель состояла бы в том, чтобы иметь единый балл тестирования, который дает вам представление о том, насколько хороши качество данных, ETL, агрегации и дашборды, но сделать это действительно сложно. Опять же, здесь набор тестов имеет больше смысла. Кроме того, агенты лучше справляются с тестированием узких областей в широком наборе тестов.
Решение: перенести всю логику в одно место?
Один репозиторий git, один монорепозиторий, один хэш коммита, одно изменение для всех метрик, дашбордов и загрузок ETL. Очень похоже на то, о чем я писал некоторое время назад, в статье «Декларативный стек данных», где весь стек данных выражается как одна функция.
Это точная и декларативная конфигурация, похожая на функцию, например run_stack(serve(transform(ingest))), которая может воссоздать весь стек данных.
Для наших целей мы хотим иметь более качественную верификацию, что тоже в этом помогает. Логика (метрики, дашборд, ETL) хранится стандартизированным образом, агенты могут создавать на ее основе наборы тестов, и мы можем быстро итерировать. Мы не можем верифицировать логику в четырех разных базах данных и репозиториях git. Объединение ее в одном декларативном месте позволит избежать этого.
В конечном итоге определения метрик, сегменты, трансформации, агрегация — всё это приводит к созданию дашборда. Мы проходим путь от источника до визуализации. Это полнофункциональная платформа инженерии данных, включающая трансформацию, семантический слой, фактические вычисления, дашборд и дата-приложение.
Различные форматы сериализации
Помимо хранения кода и конфигурации в одном месте, в настоящее время допускается использование различных форматов или синтаксиса. Модели dbt представляют собой SQL с шаблонизатором Jinja на диалекте каждого хранилища, Metabase имеет нативный SQL и собственный язык запросов (MBQL), а Looker использует LookML. Перевод между ними всё чаще может выполняться агентом и верифицироваться с помощью компилятора или инструментов инспекции.
Это означает, что мы стали менее зависимы от проприетарного синтаксиса, чем раньше, хотя такие форматы, как LookML и MBQL, по-прежнему являются проприетарными.
Компоновка компонентов для оптимизации под эргономику человека
Нам нужна система, ориентированная на продуктивность человека за счет встраивания в наш рабочий процесс, подобно макросам в dbt или функциям LookML. В программировании мы тоже начинали с ассемблера, затем перешли к языкам высокого уровня вроде FORTRAN и C, потом к объектно-ориентированным языкам вроде Smalltalk, а теперь у нас есть всевозможные языки программирования. Сейчас мы продвинулись еще дальше, так что можем просто давать инструкции на естественном языке.
Мы поднялись по стеку вверх, и это совсем другой уровень оптимизации, когда нам больше не нужно писать на ассемблере. Конечно, иногда писать на ассемблере все еще полезно, если вам нужен полный контроль над всем для достижения супервысокой производительности, но иногда нам просто нужна настройка, которая помогает выполнять работу. Для BI-разработчиков это надежная система, которая поддерживает нас в работе с агентами везде, где это возможно, но при этом учитывает эргономику и продуктивность человека — например, производить больше не значит лучше, важнее более высокое качество и корректность метрик.
Мы хотим иметь возможность верификации. Некоторые компании переписали свое ядро, поскольку блокноты оказались непригодными для использования: состояние не управлялось должным образом, переменные выполнялись не по порядку или переназначались, и было трудно понять, какой блок кода создал какие наборы данных. Именно здесь в BI-инструменте становится важна связь между метрикой и вычислительным движком: чем лучше интеграция, тем меньше расхождений между определением и наборами данных.
Эта идея старше, чем BI. Концепция Литературного программирования (1984) Дональда Кнута рассматривает компьютерную программу скорее как эссе, объясняющее логику рассуждений, где код выступает в роли иллюстрации. Один инструмент создает спутанную версию, которую выполняет машина, а другой — связанную версию, которую читает человек. Смысл и реализация не могут расходиться, потому что это один и тот же документ.
Примените это к метрике (и ее контрактам), и вы получите то, о чем эта статья, где люди пишут меньше кода: определение, описывающее значение метрики, и код, который ее вычисляет, хранятся в одном месте и проверяются друг другом.
📝 Проблема равенства классов P и NP, наоборот Проблема равенства классов P и NP — это крупная нерешенная проблема в теоретической информатике. Неформально она ставит вопрос о том, можно ли каждую проблему, решение которой поддается быстрой проверке, также быстро решить. Для задач NP проверка — это простая часть, а поиск ответа может оказаться сложным. В агентском BI наблюдается обратная асимметрия: агент может недорого создать метрику или дашборд, но проверка их правильности — сложная и дорогая задача, именно поэтому мы так много инвестируем в слой верификации.
📝 Проблема равенства классов P и NP, наоборот
Проблема равенства классов P и NP — это крупная нерешенная проблема в теоретической информатике. Неформально она ставит вопрос о том, можно ли каждую проблему, решение которой поддается быстрой проверке, также быстро решить. Для задач NP проверка — это простая часть, а поиск ответа может оказаться сложным.
В агентском BI наблюдается обратная асимметрия: агент может недорого создать метрику или дашборд, но проверка их правильности — сложная и дорогая задача, именно поэтому мы так много инвестируем в слой верификации.
Унидиный иерархический граф связей (DAG)
Чтобы разместить набор тестов в едином месте, я экспериментировал с идеей создания единого вычислительного графа, который представляет полное состояние от инжеста до дашборда.
Когда я обсуждал это с Самиром, он отметил, что в нем нет циклов и он иерархичен: это DAG, который спускается уровень за уровнем в свои подграфы. Это не строгое дерево, так как любое соединение дает модели более одного родителя, но оно читается сверху вниз как дерево. Именно это я имею в виду под «деревом связей» или «иерархическим DAG связей» в этой статье:
Для линтинга мы можем использовать так называемое Абстрактное синтаксическое дерево (AST). Это структура данных, представляющая структуру программы или фрагмента кода. Оно представляет собой древовидное представление абстрактной синтаксической структуры текста, написанного на формальном языке. Существует также специализированное SQL AST, и такие инструменты, как SQLMesh, а также большинство парсеров в BI-инструментах, активно их используют. Например, функция Виртуальных сред данных, которая обнаруживает изменения и автоматически классифицирует влияние критических или некритических изменений, в значительной степени опирается на AST.
Это становится возможным благодаря способности платформы семантически понимать SQL на уровне AST. Сравнивая текущую версию модели с предыдущей, мы можем вычислить семантический дифф, который SQLMesh дополнительно анализирует, чтобы понять его влияние на последующие (downstream) модели.
Таким образом, с помощью таких методов и продвинутых знаний о конфигурации всей системы, а также добавления SQL-транспайляции и линтеров LSP (Language Server Protocol), мы получаем довольно надежное дерево связей, которое может помочь нам актуализировать верификацию для новой эпохи искусственного интеллекта и обеспечить более быстрые итерации.
📝 Современный граф данных? Стивен Бэйли в работе «Современный граф данных» переосмысливает концепцию a16z «унифицированной инфраструктуры данных» из стека в граф: хотя существует общий поток слева направо от источников данных к системам вывода, вокруг хранилища и систем хранения существует центр обмена. Вы можете избавиться почти от всех остальных узлов и все равно получить платформу, способную поддерживать рабочие нагрузки.
📝 Современный граф данных?
Стивен Бэйли в работе «Современный граф данных» переосмысливает концепцию a16z «унифицированной инфраструктуры данных» из стека в граф: хотя существует общий поток слева направо от источников данных к системам вывода, вокруг хранилища и систем хранения существует центр обмена. Вы можете избавиться почти от всех остальных узлов и все равно получить платформу, способную поддерживать рабочие нагрузки.
Его роль заключается в «передаче знаний, чтобы люди могли ими пользоваться»: граф данных поддерживает граф систем, который поддерживает граф человека. Его разделение на системы, работающие внутри графа (с определенными границами, внутри коробок), и системы, работающие с ним (вне коробок), точно соответствует двум вещам, которые нам необходимо проверять: состоянию покоя в центре хранилища и декларациям, границам преобразований, метрик и соединений, которые его создают.
Состояние — это враг, за исключением известных тестовых данных
Один из элементов уравнения, который мы не можем исключить, — это состояние системы, и в еще большей степени само состояние: клиенты или наши данные.
Говоря о состоянии системы, Самир отмечает:
Состояние — это враг: чем больше изменяемого состояния в системе, тем меньше доверия к результатам ее работы.
Состояние — это враг: чем больше изменяемого состояния в системе, тем меньше доверия к результатам ее работы.
Проблема заключается в изменяемом состоянии. Планирование должно осуществляться на основе зафиксированного, известного состояния: наборе тестовых данных или исходных данных, для которых вам известен ожидаемый результат. Без этой фиксированной точки отсчета проверка превращается в простое угадывание. На этой идее основаны тесты Transform в Metabase (появится в версии v65): известные входные строки, ожидаемый результат и откат (rollback) после каждого запуска.
Обычно состояние имеет особо важное значение при развертывании стека данных системы, что заметно, например, в подходах DevOps с использованием Kubernetes, где нам нужно выполнять развертывание в различных средах (dev, test, prod) и сохранять состояние и соответствующие данные для нашего стека данных при обновлении программного обеспечения или конфигураций.
Сдвиг проверок влево: обнаружение отклонений на этапе сборки
Последний вопрос заключается в том, когда именно мы проводим проверку? Во время разработки — подобно компилятору, который проверяет код в конце цикла разработки после того, как мы определили метрики, и блокирует или отказывается выполнять что-либо?
Или лучше — подобно линтеру, который постоянно показывает нам предупреждения и ошибки в процессе разработки? Оба варианта возможны в зависимости от того, насколько строгими мы хотим их сделать.
С точки зрения времени — чем раньше, тем лучше. Во времени разработки, перед продакшеном, поскольку проверка во время выполнения уже хорошо покрыта оркестраторами и интегрированными инструментами качества данных. И снова: чем сильнее мы сдвигаем процесс влево, тем лучше.
Обнаружение отклонений: качественные данные
Но как узнать, проверены ли измерения и ключевые показатели эффективности (KPI) или хорошо ли они протестированы? Важное значение имеют хороший набор данных и комплект тестов, которые повышают качество данных, самих тестов, а также качество бизнес-процессов. Нам необходимо измерять «качество данных» (Goodness of data).
Имея всеобъемлющий иерархический граф происхождения (DAG) с поддержкой связей, который знает бизнес-логику лучше, чем существующие BI-инструменты, мы можем использовать декларативные метрики, покрывать их модульными тестами, чтобы они декларировали результат, создать компилятор со встроенными утверждениями и развивать программирование на основе проверок (assertion programming). Сегодня большинство проверок данных — тесты данных в dbt, проверки в Airflow, функции метрик данных в Snowflake — выполняются после вычисления данных; это проверки во время выполнения. dbt начал смещаться влево: начиная с версии v1.8, модульные тесты проверяют логику моделей на статических входных данных до их материализации, а контракты моделей обеспечиваются на этапе сборки. Нам нужно продвинуться дальше и сдвинуть проверки влево по всему стеку, чтобы они выводились линтером в процессе написания метрики и применялись на этапе сборки до запуска конвейера.
Избегайте отклонения определения от его первоначального вида путем модульного тестирования конфигурации на большом наборе тестов и с привлечением человеческой интуиции. Большинство отклонений в BI сегодня происходит из-за противоположного подхода: дашборд создается ad-hoc один раз с ручными тестами и больше не затрагивается, со временем отклоняясь от нормы.
Результатом является система компонентов, оптимизированная для тестов и высокого качества данных, что позволяет быстро проводить итерации с высокой уверенностью и контролем.
Инспектор элементов, но для числа на дашборде (DevTool для данных)
Думайте об этом как об инструментах разработчика (Developer Tools) в Chrome: одна панель, полный контекст, все прослеживается от отрисованного элемента через DOM, стили и сетевые запросы. Именно этого нам не хватает для работы с данными. Единый интерфейс, в котором вы можете проследить число на дашборде до самого источника через метрики, семантический слой, преобразования и «сырые» исходные данные — без необходимости переключаться между инструментами или с самого начала расспрашивать пять человек.
💡 Замедлите темп: Марио Цехнер (Mario Zechner), создатель Pi, призывает создавать «модульные» системы в своей работе Building pi in a World of Slop. Он также говорит: замедлите темп, научитесь говорить «нет».
💡 Замедлите темп
Марио Цехнер (Mario Zechner), создатель , призывает создавать «модульные» системы в своей работе Building pi in a World of Slop. Он также говорит: замедлите темп, научитесь говорить «нет».
Что дальше: куда движутся BI и написанный человеком код
Мы обсудили многое: почему проверка стала новой зоной ответственности в стеке агентного BI, почему нам нужны комплекты тестов на пяти уровнях иерархии (линтеры, компилятор, модульные, интеграционные и сквозные тесты), почему перенос всей логики в одно декларативное место помогает в проверке по сравнению с разрозненными компонентами, и почему единый иерархический граф происхождения DAG, построенный на основе синтаксических деревьев (AST), семантических различий и линтеров в стиле LSP, решает часть задач линтинга и верификации. Мы также рассмотрели, почему состояние является врагом доверия и почему проверки должны смещаться слева направо — от проверок во время выполнения к гарантиям на этапе сборки.
Но остаются открытые вопросы. Как запускать тесты детерминированно и надежно? Как написать «механизм правил верификации» (verification rule engine)? Как на самом деле создать единый иерархический граф происхождения DAG, вычислить всю иерархию до запуска и потенциально скомпилировать ее в бинарный файл, который будет работать быстро, даже в веб-среде? И помогают ли нам большие языковые модели (LLM) в верификации?
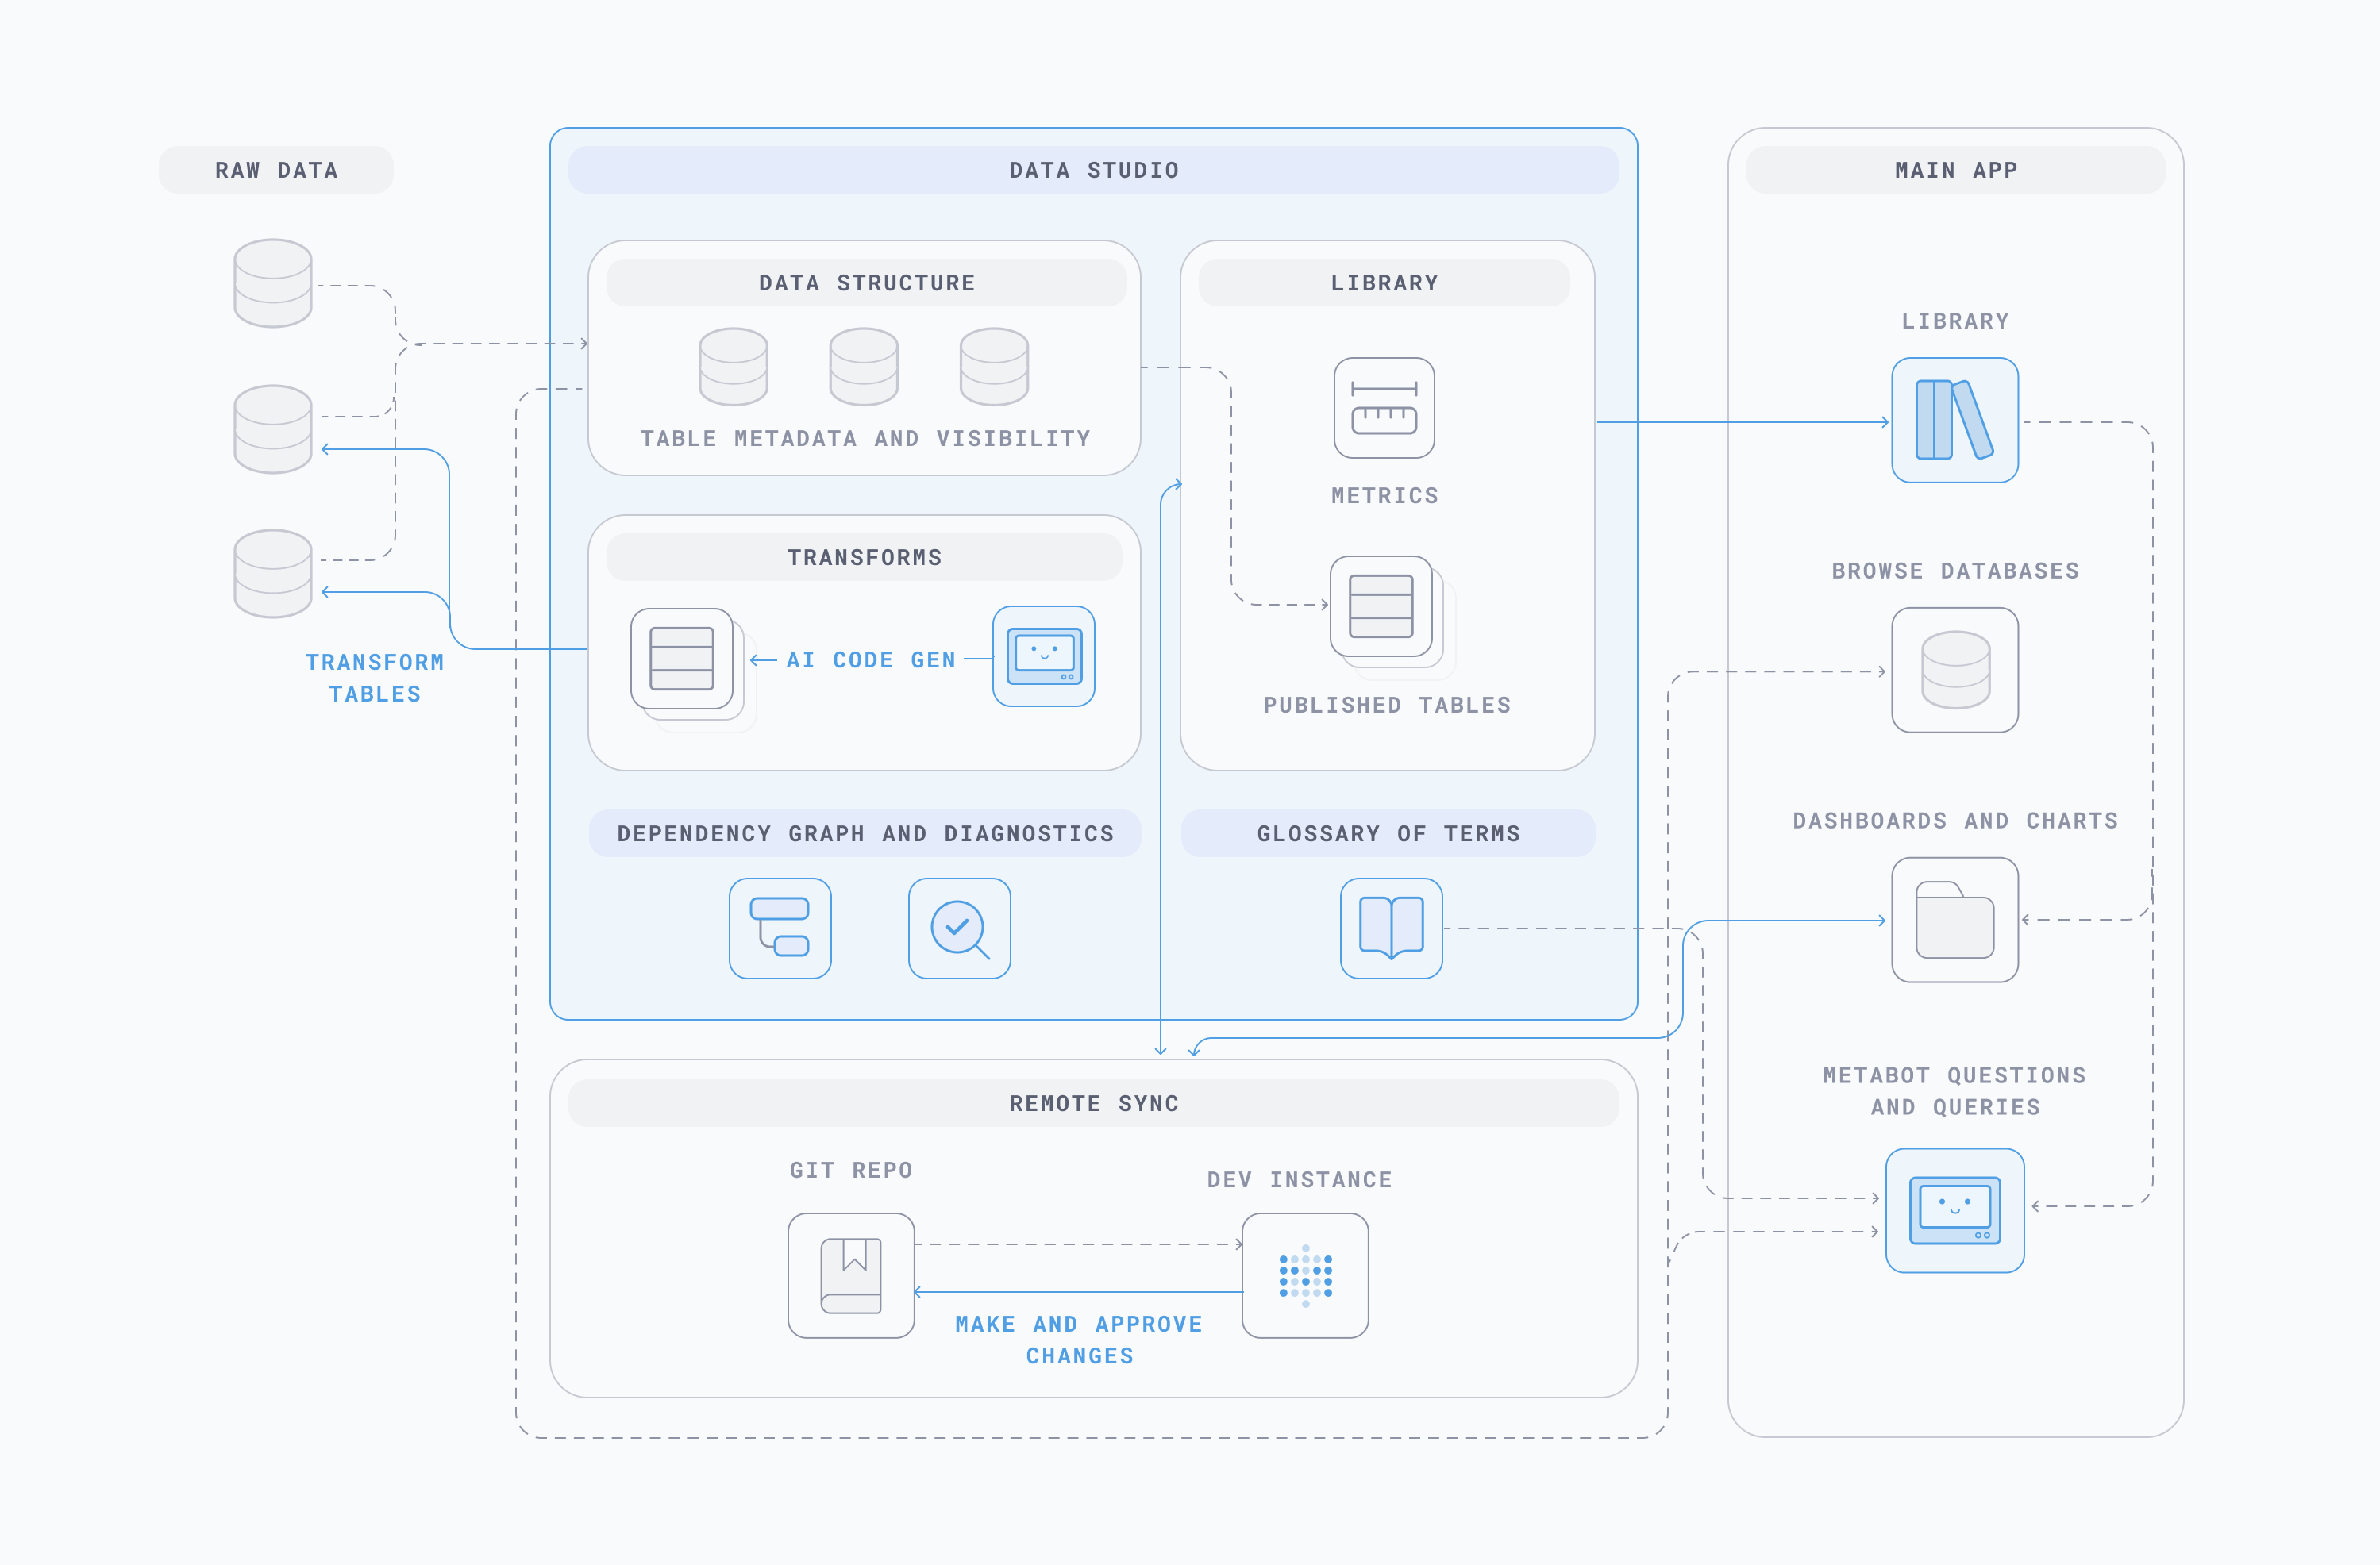
Именно в этом направлении движется концепция Data Studio в Metabase. Преобразования, метрики и дашборды находятся в одном месте. Отслеживание зависимостей показывает, что от чего зависит, поэтому вы можете увидеть, что сломает ваше изменение, еще до его публикации. Удаленная синхронизация позволяет вести версионирование всего этого в Git. Это еще не полноценный линтер для данных, описанный здесь, но это основа, в которой вся логика находится в одном месте, с графом зависимостей происхождения, преобразованиями и повторно используемыми метриками.