Нам надоело ждать загрузки сводных таблиц, и мы сделали их быстрее.
Раньше сводные таблицы в Metabase работали медленно, а их реализация требовала сложной логики для обеспечения согласованности результатов. Metabase отправляла в базу данных отдельные запросы для вычисления итогов по строкам, столбцам и общих итогов. Это означало, что сводная таблица с двумя полями группировки могла выполнять четыре запроса, а с пятью полями — до 32.
У такого подхода было две проблемы. Первая, очевидная — это скорость, поскольку такое количество обращений к базе данных требует времени. Но на результаты также могли влиять ограничения на количество строк. Metabase ограничивает число строк, которые может вернуть запрос, и когда это ограничение затрагивало одни запросы сводной таблицы, но не другие, нам приходилось обрабатывать эти расхождения для обеспечения согласованности результатов.
В версии Metabase 64 мы выпустили крупное обновление сводных таблиц. Теперь вместо этого Metabase может запросить у базы данных вычисление всей сводной таблицы в рамках одного запроса, используя стандартную функцию SQL (GROUPING SETS), которую поддерживают большинство современных хранилищ данных. Результат представляет собой ту же сводную таблицу, но в наших бенчмарках она часто работает в 2–3 раза быстрее, а точность деталей и итогов гарантированно согласована.
В этой статье подробно рассматривается новый подход: как запрос для сводной таблицы представлен в процессоре запросов (QP) Metabase, какой SQL генерируют старый и новый пути, как работают механизмы защиты от превышения лимита строк, а также особенности диалектов, с которыми мы столкнулись при внедрении нового подхода.
Что такое запрос сводной таблицы?
Сводная таблица сопоставляет набор измерений строк с набором измерений столбцов и отображает одну или несколько агрегированных метрик в ячейках. Интерфейс может запрашивать промежуточные итоги по осям строк и столбцов, а также общий итог.
В частности, следующий запрос представляет собой сводную таблицу с двумя группировками и одной метрикой (количеством). Запрос представляет собой последовательность вызовов функций Clojure, написанных с использованием библиотеки MBQL от Metabase. Metabase использует MBQL для построения запросов, созданных с помощью настроек сводных таблиц в графическом конструкторе запросов, до того как запрос будет скомпилирован.
Группировки, указанные в разделе :rows, становятся заголовками строк в сводной таблице. Группировки, указанные в разделе :columns, становятся заголовками столбцов. Агрегация заполняет каждую пересекающуюся ячейку (в данном случае агрегацией является количество).
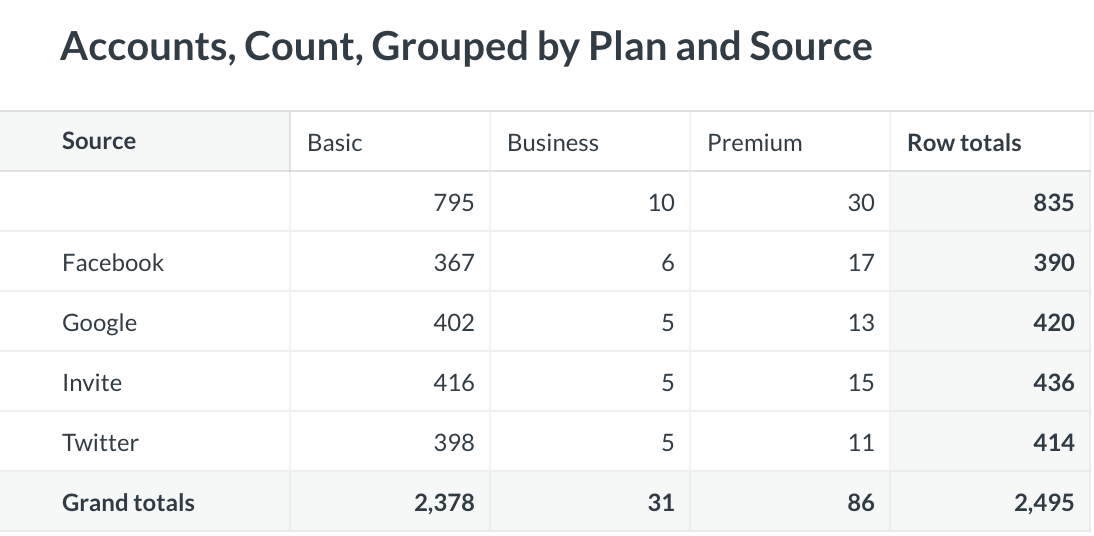
При наличии двух группировок и включенных обоих итогах отрисовщику сводной таблицы требуется четыре набора результатов:
Столбец группировки сводной таблицы содержит битовую маску: по одному биту на каждую группировку, который устанавливается, когда эта группировка сворачивается в данной строке. Интерфейс использует ее, чтобы определить, куда поместить каждую строку в сводной таблице.
Старый путь с множеством запросов
Исторически функция run-pivot-query генерировала один подзапрос для каждого подмножества группировок сводной таблицы, выполняла их отдельно к базе данных и объединяла результаты на уровне приложения. Для нашего примера с двумя группировками это означает четыре подзапроса, по одному для каждой строки таблицы выше:
Каждый уровень промежуточных итогов представляет собой отдельное обращение к хранилищу данных: четыре для нашего примера с двумя группировками и до 32 для сводной таблицы с пятью группировками.
Мы включили части NULL AS <column> и <n> AS "pivot-grouping" исключительно для наглядности, поскольку интерфейс ожидает единообразную форму строк во всех четырех подзапросах: [source, plan, pivot-grouping, count]. Реальные подзапросы опускали бы отброшенные столбцы, а конструктор запросов вместо этого встраивал бы константную битовую маску и недостающие значения NULL в каждую строку.
Сложность с лимитом строк
Metabase применяет ограничение по умолчанию :max-results (10000) к агрегированным запросам. Если применить это ограничение наивно к каждому подзапросу сводной таблицы, результаты могут разойтись. Например, подзапрос с деталями может достичь лимита и отбросить строки, которые все еще учитываются в подзапросах с промежуточными итогами. Когда эти подсчеты расходятся, пользователи видят промежуточные итоги, которые не сходятся.
Старый многозапросный путь справлялся с этим с помощью прерывания: если первый подзапрос (на уровне деталей) усекается параметром :max-results, остальные подзапросы промежуточных итогов полностью пропускаются, а для :pivot_rows_truncated устанавливается значение true. Таким образом, интерфейс получает либо полную сводную таблицу, либо усеченные детали без промежуточных итогов и с предупреждением (чтобы Metabase не отображала некорректные данные).
Однако с новым нативным путем мы смогли полностью отказаться от всей логики обнаружения и пропуска.
Нативный путь с GROUPING SETS
GROUPING SETS — это расширение конструкции GROUP BY, являющееся частью стандарта SQL. Оно позволяет одному запросу выполнять агрегацию по нескольким группировкам одновременно. Вы перечисляете каждый набор столбцов для группировки, и база данных возвращает все эти группировки в одном результате. Это те же строки, которые вы получили бы при использовании UNION ALL для отдельных запросов GROUP BY. В каждой строке столбцы, не входящие в группировку данной строки, возвращаются как NULL. ROLLUP и CUBE являются сокращениями для распространенных шаблонов наборов группировок.
Мы могли бы обойти проблему с лимитом строк с помощью UNION ALL. Просто запустить четыре подзапроса, объединить их через union и обернуть результаты во внешний запрос с единым LIMIT. Но тогда база данных все равно выполняла бы четыре независимые агрегации по аккаунтам.
Однако с помощью GROUPING SETS мы можем позволить планировщику запросов базы данных вычислить все четыре уровня промежуточных итогов за один проход по таблице фактов. Его функция GROUPING() также напрямую передает нам битовую маску группировки сводной таблицы (без необходимости использовать жестко закодированную константу для каждой ветви).
Для приведенного выше примера с двумя группировками нативный путь компилируется в следующий запрос:
Функция GROUPING() помечает каждую строку ее уровнем промежуточных итогов. Порядок ее битов обратен соглашению Metabase о группировке сводных таблиц, поэтому компилятор меняет местами список аргументов.
Предложение ORDER BY сортирует строки с деталями в первую очередь, а итоги — в последнюю, поэтому, если лимит строк усекает результат, сводная таблица теряет итоги с конца, а не отображает разбросанные пропущенные ячейки. Это также означает, что нам не нужно беспокоиться о порядке, в котором база данных возвращает строки.
Наконец, не каждая база данных использует одинаковую функцию GROUPING(): некоторые называют ее GROUPING_ID(), а другие принимают только один аргумент за раз. Небольшое переопределение для каждого драйвера удерживает эти различия в одном месте.
Преимущества и ограничения нативного подхода
У нового нативного подхода есть очевидные преимущества:
- Улучшенная производительность: один общий проход. GROUPING SETS позволяет базе данных вычислять все уровни промежуточных итогов за один проход по таблице фактов. Каждое хранилище, оптимизированное для рабочих нагрузок в стиле сводных таблиц, знает, как это делать.
Улучшенная производительность: один общий проход. GROUPING SETS позволяет базе данных вычислять все уровни промежуточных итогов за один проход по таблице фактов. Каждое хранилище, оптимизированное для рабочих нагрузок в стиле сводных таблиц, знает, как это делать.
- Согласованные результаты. Детали и итоги получаются из одного и того же запроса, поэтому любое усечение применяется к обоим.
Согласованные результаты. Детали и итоги получаются из одного и того же запроса, поэтому любое усечение применяется к обоим.
- Удобство проверки и отладки. Все вычисление представляет собой одно выражение SQL. Вы можете скопировать его в клиент базы данных, запустить, выполнить EXPLAIN или отследить, как формируется конкретный промежуточный итог.
Удобство проверки и отладки. Все вычисление представляет собой одно выражение SQL. Вы можете скопировать его в клиент базы данных, запустить, выполнить EXPLAIN или отследить, как формируется конкретный промежуточный итог.
Тем не менее, стоит отметить и несколько ограничений:
- Не все базы данных поддерживают GROUPING SETS. :native-pivot-tables ограничивает эту функцию. Драйвер базы данных должен происходить от :sql, а его диалект должен принимать GROUP BY GROUPING SETS. Это охватывает большинство аналитических хранилищ данных, однако MySQL (которая предлагает только WITH ROLLUP) и SQLite (где поддержка отсутствует вообще) остаются на пути с множеством запросов.
Не все базы данных поддерживают GROUPING SETS. :native-pivot-tables ограничивает эту функцию. Драйвер базы данных должен происходить от :sql, а его диалект должен принимать GROUP BY GROUPING SETS. Это охватывает большинство аналитических хранилищ данных, однако MySQL (которая предлагает только WITH ROLLUP) и SQLite (где поддержка отсутствует вообще) остаются на пути с множеством запросов.
- Отсутствует поддержка агрегаций с оконными функциями. :offset, :cum-count и :cum-sum вычисляют свои значения для каждой строки на основе других строк в результирующем наборе (нарастающий итог, смещение и т. д.). Вычисления поверх вывода GROUP_ING SETS включали бы строки промежуточных итогов, что не имеет смысла.
Отсутствует поддержка агрегаций с оконными функциями. :offset, :cum-count и :cum-sum вычисляют свои значения для каждой строки на основе других строк в результирующем наборе (нарастающий итог, смещение и т. д.). Вычисления поверх вывода GROUP_ING SETS включали бы строки промежуточных итогов, что не имеет смысла.
Что дальше
Некоторые сводные таблицы по-прежнему не могут использовать GROUPING SETS: любые таблицы в MySQL или SQLite, а также запросы с агрегациями на основе оконных функций. Промежуточный шаг с UNION ALL из предыдущего пункта по-прежнему работает для них: он устраняет разрывы в количестве обращений и лимитах строк без необходимости для хранилища планировать совмещенное сканирование.
MongoDB — это совершенно другая история. Ее конвейер агрегации может выражать ту же идею «нескольких уровней группировки в одном запросе», но с помощью $facet вместо SQL. Для этого требуется отдельная инженерная разработка, поэтому в v64 MongoDB остается на пути с множеством запросов.
Попробуйте более быстрые сводные таблицы
Сводные таблицы на основе единого запроса появились в Metabase 64.
Нативный путь выбирается при соблюдении двух условий: параметр MB_USE_NATIVE_PIVOT_TABLES включен (в v64 по умолчанию он отключен, пока не зарекомендует себя в достаточном количестве реальных инсталляций), а драйвер объявляет функцию :native-pivot-tables. Если хотя бы одно из условий не выполняется, Metabase возвращается к пути с множеством запросов.
Включите их при самостоятельной хостинг-установке: обновитесь до Metabase 64, установите эту переменную окружения и перезапустите Metabase:
Если вы запускаете JAR:
Если вы запускаете Docker:
Включите их в Metabase Cloud: свяжитесь с поддержкой, и мы включим их для вас.
После включения сводные таблицы в поддерживаемых базах данных (PostgreSQL, Redshift, Snowflake, BigQuery, Oracle, SQL Server, Presto, Starburst, Vertica, Athena, ClickHouse, Druid и драйверах семейства Hive: Spark SQL, Databricks) автоматически переключаются на путь с единым запросом. Все остальное продолжает работать так же, как и раньше. Вам не нужно менять какие-либо вопросы или дашборды.
Расскажите нам о результатах. Если ваши сводные таблицы стали работать быстрее (или что-то выглядит странно), создайте тикет на GitHub или напишите на форум. Отчеты из реальных конфигураций помогают сделать это поведение стандартом по умолчанию.
- Как мы выбирали LibreChat и в итоге создали агента для Slack
- Познакомьтесь с Repro-Bot — нашим агентом для сортировки задач в GitHub
- Как мы создали десять пользовательских субагентов для усмирения кодовой базы на Clojure объемом 500 тыс. строк
- Повышение производительности популярного инструмента разработки на Clojure — clojure-lsp
- PA: постоянный агент для автоматизации рабочих процессов разработчика