БЛОГ · ОБНОВЛЕНИЯ ПРОДУКТА
8 октября 2026 г. Пол Семама, Хантер Хайденрайх, Викас Паручури, 9 минут чтения
Какой парсер лучше всего подходит для таких документов, как ваши? 16 288 тестов с результатом «пройдено/не пройдено» помогут вам это проверить.
Выбор парсера документов обычно начинается с таблицы лидеров: одно число на каждый парсер. Однако трудно копнуть глубже и понять, где и как парсеры терпят неудачу или добиваются успеха.
Мы хотели создать бенчмарк, который был бы:
- понятным: каждый тест — это вопрос «да/нет» по странице, каждый балл — это доля пройденных тестов, и каждый балл сопровождается количеством тестов и документов, стоящих за ним, поэтому узкая выборка показывает, что она узкая, и указывает, куда добавлять тесты в дальнейшем;
- проверяемым: каждый тест фиксирует, как был получен ответ, а система оценки представляет собой открытый код без использования моделей для оценки результатов; и
- исследуемым: каждый тест помечен тегами в зависимости от того, что он проверяет, поэтому любая часть бенчмарка, например, рукописные таблицы или текст на тайском языке, получает свою собственную оценку.
Сегодня мы выпускаем OmniParseBench: 16 288 тестов «пройдено/не пройдено» на 2 937 страницах из 2 343 документов на 92 языках, где ответ на каждый тест прослежен до источника. dataset и code открыты.
olmOCR-bench показал, что модульные тесты «пройдено/не пройдено» — это простой и гибкий прокси-показатель качества парсинга, который может проверить каждый. Но после использования с момента выхода мы заметили, что он стал насыщенным, и теперь лучшие системы разделяет в основном соглашение о выводе и переобучение, а не качество чтения. Кроме того, каждый из его тестов находится в одной категории, определяемой тем, откуда взялась страница, поэтому слабость в смешанном контенте, например, рукописная таблица или уравнение в ячейке таблицы, усредняется в той категории, в которую попала страница.
Другой популярный бенчмарк, ParseBench, разделяет парсинг на пять возможностей и дает каждой свою специфическую метрику. Их оценки не имеют общей единицы измерения, поэтому их нельзя корректно сравнить или объединить, а теги описывают страницы целиком, а не контент. Множество способов оценки создали проблемы со справедливостью и надежностью оценок ParseBench.
Наш бенчмарк
Мы следуем примеру olmOCR-bench в том, что используем модульные тесты для обеспечения прокси-показателя производительности парсинга в реальных условиях. Тест — это вопрос «да/нет» об одном или нескольких фрагментах контента на странице. Существует три концепции более высокого уровня, описывающие тест:
- Его происхождение: как он был верифицирован.
- Его тип: как он оценивает контент.
- Его теги: какой тип контента он оценивает.
Дизайн
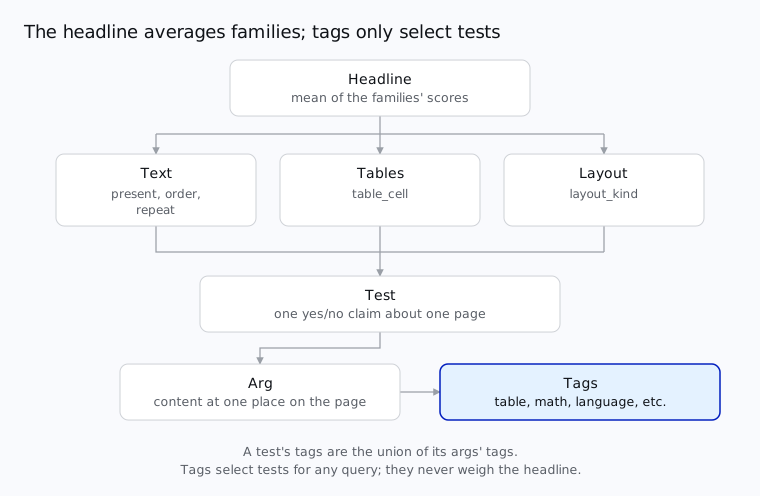
Заголовок — это среднее арифметическое трех семейств оценок: текст, таблицы и макет. Семейства — это просто естественная группировка типов тестов:
Тест проверяет один или несколько аргументов, каждый из которых является контентом в определенном месте на странице. Каждый аргумент помечен тегами:
- структура: таблица, математика, форма и многоколоночный текст;
- рендеринг: рукописный текст, мелкий шрифт, повернутый текст и деградировавший текст;
- роль: заголовок, подпись, сноска, список, код, рисунок и верхний/нижний колонтитул;
- скрипт: коды ISO 15924 (Latn, Hani, Deva, …); и
- язык: коды ISO 639-3 (eng, fra, tha, …).
Теги никогда не определяют основную метрику или результат прохождения теста. Теги создаются после того, как тест готов, и предназначены для поиска интересующих вас тестов.
Данные
Набор данных состоит из 16 288 тестов на 2 937 страницах из 2 343 исходных документов из 22 наборов.
Теги комбинируются. Здесь мы показываем пример подсчета для пар тегов, отмечая, что тест может иметь произвольное количество тегов.
Результаты
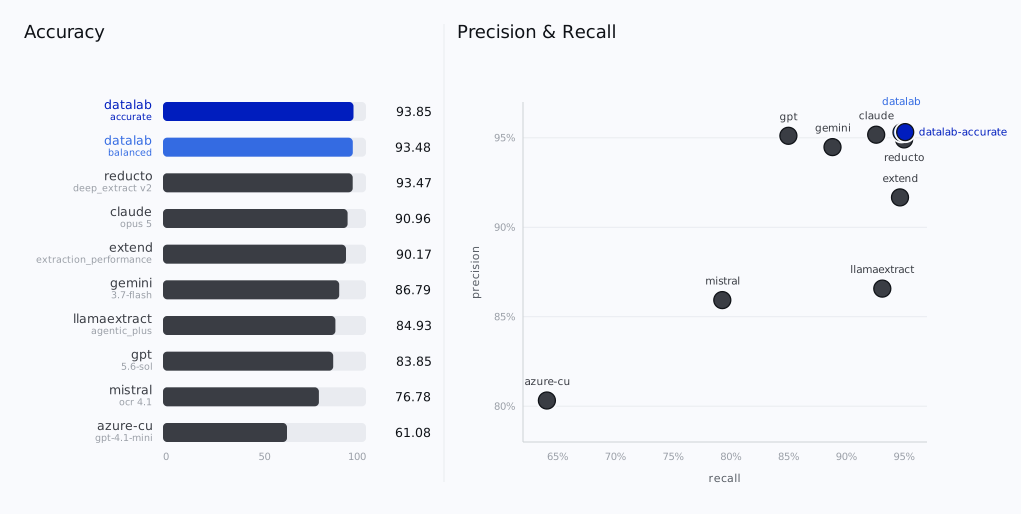
Каждая оценка здесь приведена для версии набора данных 175cc91.
* Используется при создании и проверке по крайней мере некоторых тестов.
Изучение результатов
Выберите типы тестов и теги ниже, и каждый парсер будет оценен по выбранным вами тестам так же, как в заголовке: среднее значение его показателей прохождения в каждом семействе. Оценки получены из результатов таблицы лидеров.
Загрузка тестов…
Чтобы выбрать тесты и агрегировать оценки по-своему на своих собственных запусках, см. руководство репозитория по запросу результатов.
Точность в зависимости от задержки и стоимости
Задержка — это время, которое клиент ждет одну страницу: загрузка, очередь, обработка и опрос. Мы измерили ее на 200 страницах, выбранных из бенчмарка, отправляя по 8 страниц за раз каждому парсеру, при этом каждый парсер работал в своем собственном запуске.
Стоимость — это цена за 1000 страниц. Для поставщика, который выставляет счета в кредитах, это количество кредитов, указанное в ответах, умноженное на цену за кредит. Для модели общего назначения мы рассчитываем стоимость на основе выставленных токенов.