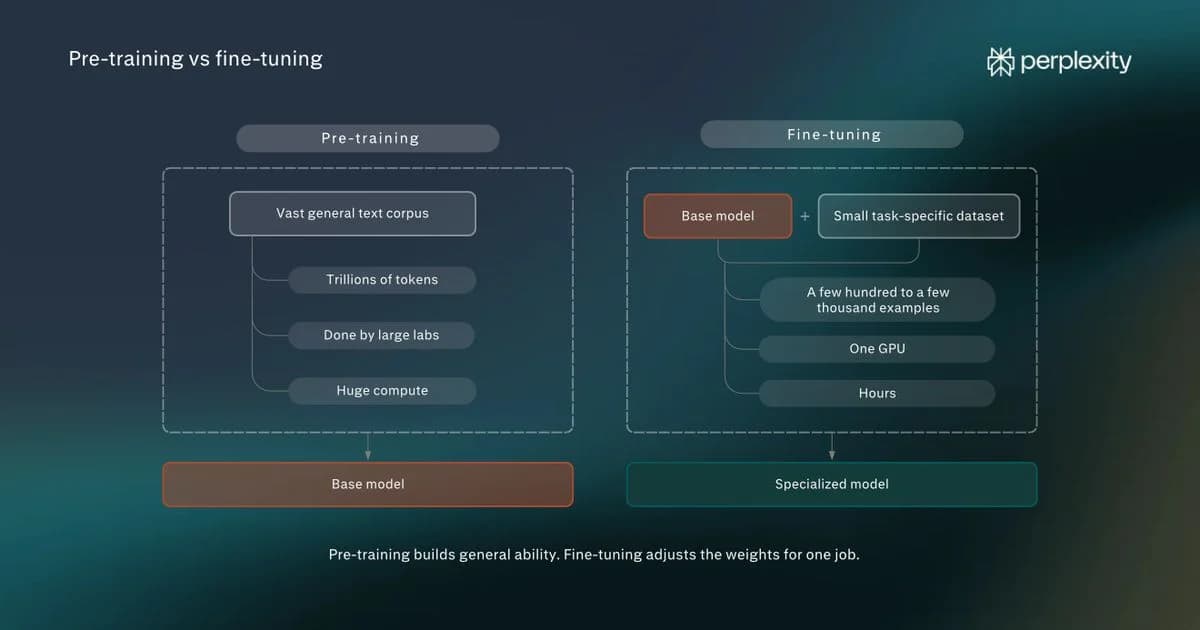
Дообучение большой языковой модели (LLM) означает настройку предобученной LLM на небольшом наборе данных под конкретную задачу, чтобы получить результаты, недостижимые с помощью одного лишь промптинга.
Дообучение включает в себя сбор пар примеров «ввод/вывод», демонстрирующих нужное поведение, запуск процесса обучения, который смещает веса модели в сторону этих примеров, и проверку результата по сравнению с исходными выводами модели. Эффективные с точки зрения параметров методы, такие как LoRA, делают этот процесс достаточно дешевым для запуска на одном GPU.
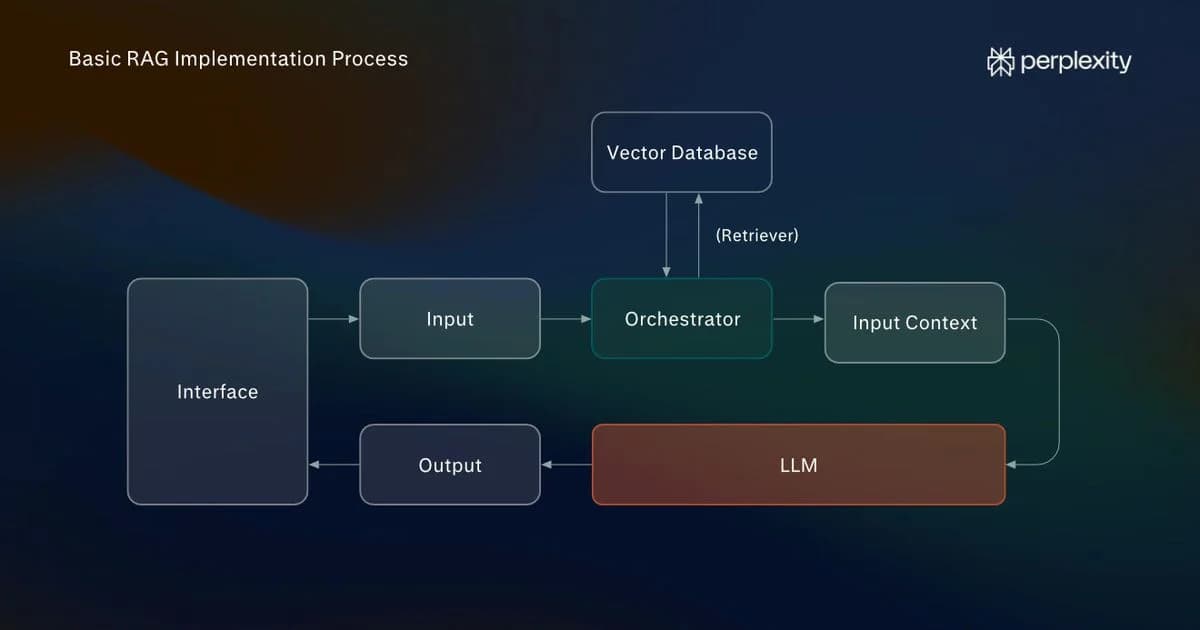
Если вас не устраивают результаты работы LLM, сначала улучшите свои промпты и дополненную генерацию (RAG). Дообучение изменяет поведение LLM. Когда вам требуется использовать свежую или проприетарную информацию, промпты и RAG обычно подходят лучше.
Ниже описаны пошаговое дообучение LLM, основные методы дообучения (LoRA и QLoRA), а также проблемы и ошибки, которые могут нарушить этот процесс.
Что такое дообучение LLM и чем оно отличается от предобучения LLM
Предобучение LLM создает общие языковые способности модели с нуля на огромном корпусе текстов, в то время как дообучение LLM настраивает предобученную модель на небольшом наборе данных для выполнения одной конкретной задачи.
Предобучение LLM — это ресурсоемкая фаза, в результате которой создается базовая модель. Она обучается на широком текстовом корпусе, что дает ей общую грамматику, факты и навыки рассуждения, но не специализацию под вашу задачу.
Дообучение LLM продолжает обучение базовой модели на небольшом, тщательно подобранном наборе данных, чтобы она выдавала желаемые результаты для конкретной задачи или сценария использования. Подумайте о единообразном формате, голосе или тоне бренда, доменных паттернах или надежных вызовах инструментов и функций.
Когда дообучать LLM, а когда вместо этого использовать промпты или RAG
Для повышения производительности LLM действуйте по нарастающей: промптинг -> RAG -> дообучение.
Уточняйте свои промпты с помощью более детальных инструкций и используйте RAG, чтобы предоставить модели актуальную информацию. Прибегайте к дообучению только тогда, когда улучшение промптов и поиска не дает результатов.
Подход
Что он меняет
Используйте, когда
Главное ограничение
Промпт-инжиниринг
Отправляемый запрос
Поведение близко к нужному, и вам важны скорость и возможность отката
Ограничено существующими возможностями базовой модели
RAG
То, что модель видит во время инференса
Факты часто меняются, и вам нужно, чтобы LLM имела доступ к актуальной информации
Добавляет задержку поиска и инфраструктуру; не меняет поведение
Дообучение LLM
Веса модели (внутренние параметры модели)
Вам требуется стабильное поведение, формат или тон в масштабе, либо более короткие промпты для каждого вызова
Первоначальные затраты, знания, заложенные в веса, устаревают, риск забывания предобученного поведения
Когда лучшие промпты превосходят дообучение, а когда их недостаточно
Промптинг — это самый быстрый и дешевый инструмент. Во многих случаях более точные и подробные промпты позволяют достичь желаемых изменений поведения.
Но более длинные промпты замедляют работу, делают ее дороже и не могут преодолеть существующие ограничения модели.
Признаки того, что промптинг, возможно, исчерпал свои лимиты:
- Новые граничные случаи продолжают ломать вывод: например, модель возвращает текст вместо JSON или отклоняется от нужного тона, и вы исправляете промпт для каждого нового случая.
- Системный промпт продолжает расти: промпт разрастается до сотен или тысяч строк, и им становится трудно управлять.
- Вы платите за это при каждом вызове: промпт повторно отправляется и обрабатывается при каждом запросе, поэтому растут затраты на токены и задержка.
- Изменения перестают работать: новые инструкции не улучшают результаты.
Даже в этом случае сначала попробуйте более дешевые исправления на уровне промптов. Используйте few-shot примеры, чтобы показать модели паттерн (пары входных/выходных данных), цепочки промптов (prompt chaining) для разбиения сложных задач на более мелкие шаги или хуки вызова функций для разгрузки точного поиска или вычислений.
Когда RAG имеет больше смысла, чем дообучение модели
RAG меняет то, что LLM знает, в то время как дообучение LLM меняет то, как она себя ведет. Если пробел заключается в знаниях, особенно в знаниях, которые часто меняются или содержатся в ваших собственных документах, ответом будет RAG. Если пробел заключается в поведении — дообучайте.
Дообучение также меняет то, что знает модель, но любые усвоенные ею факты замораживаются во время обучения и быстро теряют актуальность в быстро меняющихся областях. Кроме того, информация зашивается в веса модели, поэтому они не сохраняют историю своего источника.
Обновление исходных документов, используемых поисковым слоем, происходит быстрее и дешевле, и оно позволяет ссылаться на точные использованные источники. Это делает RAG лучшим выбором, когда вам нужна достоверная, актуальная информация.
Минус RAG? Это дополнительный уровень, который нужно создавать и поддерживать, и он добавляет задержку.
На практике вам часто понадобятся оба подхода. Производственные системы объединяют дообученные модели с RAG, используя первую для стабильного поведения, а вторую — для актуальных фактов.
Распространенные подводные камни, риски и проблемы дообучения
Даже когда дообучение является правильным инструментом, оно влечет за собой затраты и риски:
- Стоимость и время: Сбор чистых, репрезентативных обучающих данных и вычислительные ресурсы для обучения стоят дорого.
- Катастрофическое забывание: Обученная на узком наборе данных модель может потерять общие навыки и приобрести новые режимы сбоев, что приведет к ошибкам, которых не делала базовая модель.
- Переобучение: При использовании слишком малого или слишком повторяющегося набора данных модель запоминает ваши обучающие примеры вместо того, чтобы изучать паттерны, поэтому она хорошо работает на тренировочных выборках, но плохо справляется с реальными входными данными.
- Устаревание: Знания, заложенные в веса, быстро устаревают, поэтому приходится проводить повторное обучение на новых данных.
- Утрата актуальности: Когда выходит более мощная модель, она часто превосходит вашу дообученную версию «из коробки», и вам приходится переделывать работу.
- Проблемы оценки и воспроизводимости: Доказать, что дообученная модель превосходит базовую, сложно. Два запуска обучения на GPU с одинаковыми настройками также могут дать немного разные модели.
- Управление данными: Обучение на проприетарных или конфиденциальных данных поднимает вопросы конфиденциальности и лицензирования; впоследствии модель может выдать фрагменты того, на чем она обучалась.
Основные методы дообучения
Основные типы дообучения LLM различаются тем, какая часть модели подвергается изменениям: полное дообучение переобучает всю модель целиком, в то время как методы эффективного дообучения параметров (PEFT), такие как LoRA и QLoRA, обновляют только некоторые веса. Методы PEFT обходятся дешевле полного дообучения с точки зрения памяти и при правильных настройках не уступают по результатам.
Полное дообучение обновляет каждый вес модели. Это самый дорогой метод, несущий наибольший риск катастрофического забывания. Оставляйте его для масштабных поведенческих изменений, когда у вас есть данные и вычислительные мощности для их поддержки.
Альтернативой является эффективное дообучение параметров, или PEFT. Это общий термин для методов, которые замораживают большую часть модели и обучают только небольшой набор параметров. Оно использует гораздо меньше памяти и менее подвержено забыванию, так как базовая модель остается нетронутой.
При малых рангах PEFT обучается меньше, чем при полном дообучении, но увеличение ранга и настройка скорости обучения устраняют большую часть разрыва в задачах настройки по инструкциям.
Методы PEFT включают в себя:
- LoRA (Low-Rank Adaptation): Обычная отправная точка, которая замораживает исходные веса и обучает небольшой набор добавленных параметров адаптера (часто менее 1% от общего числа), поэтому она может работать на одном потребительском GPU.
- QLoRA (Quantized Low-Rank Adaptation): этот метод сжимает базовую модель до 4-битной точности перед применением LoRA, что позволяет дообучать большую модель на одном GPU.
Метод
Что обновляется
Аппаратные требования
Используйте, когда
Полное дообучение
Каждый вес в модели
Узел с несколькими GPU для моделей класса 7B, и значительно больше для моделей крупнее
Требуется глубокое изменение поведения модели, и у вас есть необходимые данные и вычислительные ресурсы
LoRA (PEFT)
Небольшой набор добавленных весов адаптера
Один потребительский GPU
В качестве стандартной отправной точки
QLoRA (PEFT)
Адаптеры LoRA поверх 4-битной сжатой базовой модели
Очень большие модели на одном GPU
У вас мало памяти, но вы хотите использовать крупную базовую модель
В дополнение к этому мы используем методы настройки по инструкциям и настройки предпочтений — от RLHF (обучение с подкреплением на основе отзывов человека) до более легких альтернатив, таких как Direct Preference Optimization (DPO) и Odds Ratio Preference Optimization (ORPO), чтобы сформировать то, как модель следует инструкциям и соответствует предпочтениям человека.
Как дообучить LLM по шагам
Если вы решили, что дообучение LLM — это правильный шаг, вот рабочий процесс.
Шаг 1: Определите задачу и способ измерения успеха
Определите, какое поведение вы хотите получить от LLM и как вы поймете, что добились его.
Укажите конкретную работу, которую должна выполнять дообученная модель, например классификация обращений в службу поддержки, суммирование контрактов в фиксированном формате или генерация кода в вашем фирменном стиле.
Затем определите критерии успеха. Распространенные варианты включают:
- Валидность вывода: например, разбирается ли результат как корректный JSON или соответствует ли он нужной вам структуре Markdown?
- Автоматизированные оценки: используйте такие метрики, как BLEU или ROUGE, которые сравнивают сгенерированный текст с эталонными ответами, или точность решения задачи на размеченном наборе.
- Оценки людей: шкала с баллами или критерий «пройдено/не пройдено» для качеств, которые скрипт оценивает плохо, таких как тональность или полезность.
- Надежность на сложных входных данных: справляется ли модель с необычными входными данными, на которых «спотыкалась» базовая модель?
Шаг 2: Подготовьте датасет
Качество данных определяет успех дообучения, поэтому уделите время сбору правильного датасета для дообучения.
Отформатируйте данные в виде пар «инструкция/ответ» в формате JSONL, где каждая строка содержит входные данные (плюс любой контекст) и точный требуемый результат.
Например, ознакомьтесь с общедоступными датасетами, такими как датасет общих инструкций Alpaca-cleaned, Databricks' Dolly или специализированный banking77, который включает более 13 000 реальных запросов в службу поддержки, размеченных по 77 намерениям.
Для узкоспециализированной задачи несколько сотен или тысяч чистых разнообразных примеров могут изменить поведение модели. При условии, что примеры отражают реальные производственные входные данные, включая граничные случаи, и отформатированы единообразно.
Еще нет пар вводных/выводных данных? Создайте набор из уже имеющихся у вас данных, таких как тикеты техподдержки и лучшие ответы на них, либо документы и их краткие содержания.
Если у вас есть только результаты, используйте более мощную модель для генерации правдоподобных входных данных для каждого из них или напишите небольшой начальный набор вручную и расширьте его с помощью более крупной модели-«учителя», а затем отберите лучшие пары.
В завершение разделите данные на обучающий, валидационный и тестовый наборы, чтобы оценивать модель на примерах, которые она еще не видела.
Шаг 3: Выберите базовую модель и метод
Начните с небольшой модели с открытым исходным кодом с количеством параметров от 3 до 7 миллиардов и метода эффективного дообучения параметров (PEFT), такого как LoRA или QLoRA.
Такие открытые семейства, как Llama, Mistral и Qwen, предоставляют прочную базу, которую вы можете разместить самостоятельно, а методы PEFT снижают аппаратные требования: QLoRA квантует базу до 4 бит, поэтому для дообучения модели 7B требуется всего одна потребительская видеокарта с 16–24 ГБ памяти. Полное дообучение той же модели требует в много раз больше памяти.
Шаг 4: Установите гиперпараметры обучения
Ниже приведены ключевые параметры дообучения LLM и рекомендуемые диапазоны для старта:
- Скорость обучения (learning rate) определяет размер каждого изменения весов. В 2024 study by Biderman et al. было обнаружено, что лучшие показатели LoRA примерно в десять раз выше, чем при полном дообучении: обычно от 5e-5 до 5e-4 против 1e-5 до 5e-5. Исследование советует перебирать значения от 1e-5 до 5e-4 и использовать наибольшее значение, при котором обучение идет стабильно.
- Размер батча (batch size) — это количество примеров, на которых модель учится перед каждым обновлением весов. На одном GPU используйте небольшой батч на устройство (от 1 до 8) и накопление градиентов (gradient accumulation), чтобы достичь эффективного размера батча примерно от 16 до 64.
- Количество эпох (epochs) показывает, сколько раз модель видит весь датасет. При обучении модели выполнению конкретных задач хорошим ориентиром являются 1–3 эпохи, но для прогонов LoRA часто требуется больше.
- Ранг LoRA (r) задает емкость адаптера или то, сколько он может узнать. Начните с 8–32 для более простых задач и увеличьте для более сложных: в упомянутом выше исследовании LoRA под авторством Biderman и др. для настройки инструкций для модели 7B на коде потребовался ранг 256, чтобы соответствовать полному дообучению, в то время как ранг 64 был близок к нему на математических задачах.
- Максимальная длина последовательности (maximum sequence length) — это самый длинный входной текст, который будет обработан за проход. Установите ее так, чтобы она покрывала ваши самые длинные примеры вплоть до контекстного окна модели, так как все, что длиннее, будет усечено.
- Разогрев (warmup) и расписание (schedule) контролируют то, как скорость обучения возрастает и меняется в ходе прохода. Обычными стандартами являются короткий разогрев и косинусное затухание. Тем не менее, Pareja et al. small-model study показало, что отказ от разогрева не ухудшил финальные оценки.
Считайте это отправными точками для перебора, а не фиксированными настройками.
Шаг 5: Обучение и мониторинг потерь
По ходу обучения следите за кривыми потерь (loss) на обучающей и валидационной выборках, чтобы убедиться в эффективности процесса.
Потери измеряют то, насколько выходы модели отличаются от ваших примеров, и они должны плавно снижаться по мере прохода. Обучающие потери охватывают данные, на которых модель учится. Валидационные потери рассчитываются на отложенных примерах.
Если потери на обучении и валидации снижаются одновременно, модель учится обобщать. Если потери на обучении продолжают падать, а валидационные потери выходят на плато или растут, модель запоминает обучающий набор вместо того, чтобы изучать закономерность (переобучение).
Шаг 6: Оценка и развертывание
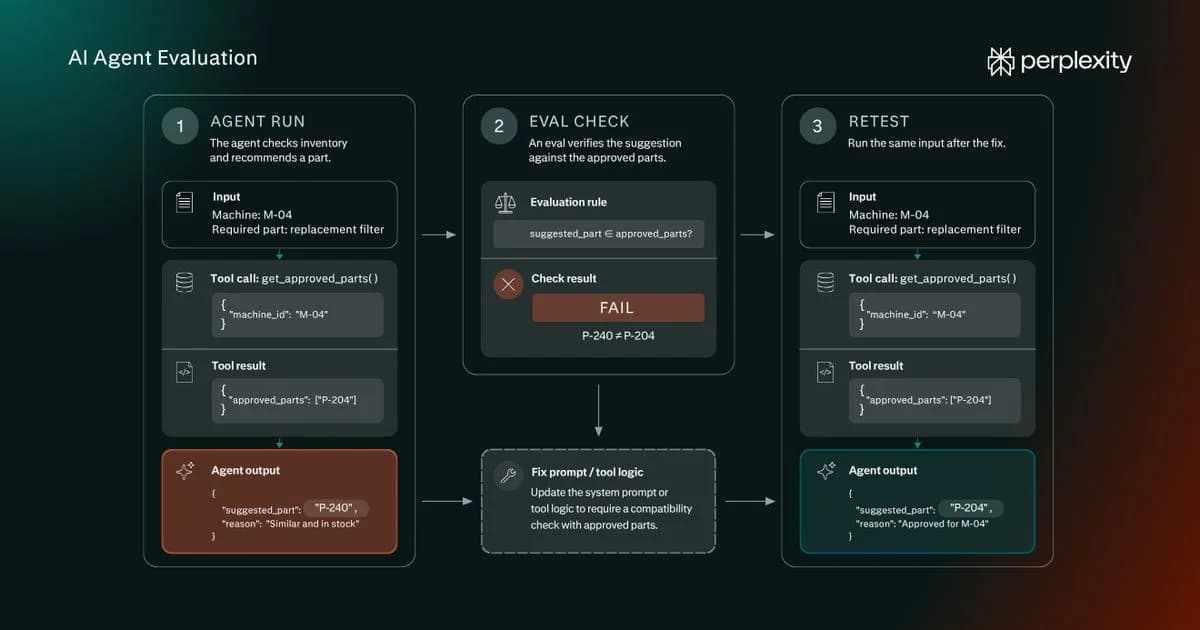
Низкие потери при обучении не гарантируют правильных результатов, поэтому оцените дообученную модель по критериям, установленным на шаге 1.
Когда она пройдет проверку, у вас есть два пути развертывания:
- Запустить адаптер поверх базовой модели и загрузить оба компонента во время выполнения; это позволяет заменять адаптер.
- Объединить адаптер с базовыми весами, чтобы получить единую автономную модель, которую проще развернуть.
Используйте Perplexity, чтобы предоставить вашей LLM доступ к актуальной информации
Дообучение — это правильный выбор, когда вы хотите адаптировать поведение модели под свои нужды.
Если вашей модели требуется актуальная информация, особенно та, которая быстро меняется, вам нужна архитектура RAG или надежный сторонний поисковый инструмент.
Пользовательский стек извлечения данных лучше всего работает для проприетарных датасетов, таких как ваша внутренняя вики, история службы поддержки, контракты или документация продуктов.
Когда знания, которые вы хотите использовать, являются общедоступными, нет необходимости создавать собственный уровень извлечения. Perplexity — это поисковый движок, который возвращает ответы со встроенными кликабельными цитатами из индекса живого интернета. Его Agent API доставляет такие обоснованные веб-данные с цитатами за один вызов, поэтому ваше приложение может опираться на актуальные источники.
Часто задаваемые вопросы о дообучении LLM
Можно ли дообучить LLM бесплатно?
Да, вы можете бесплатно дообучить небольшую открытую LLM. Например, бесплатный тариф Google Colab предоставляет достаточно ресурсов GPU для запуска QLoRA на модели с количеством параметров от 3B до 8B, чего вполне достаточно для конкретной задачи. Платить приходится тогда, когда вам требуется больше памяти, более долгие запуски или более крупная базовая модель, чем может вместить бесплатный тариф.
Нужен ли вам собственный GPU или можно выполнять дообучение в облаке?
Вам не обязательно владеть GPU для дообучения LLM. Управляемые сервисы и облачные провайдеры арендуют аппаратное обеспечение по часам, поэтому один арендованный GPU покрывает запуск QLoRA для небольшой модели. Покупка GPU окупится только в том случае, если вы занимаетесь дообучением часто или должны хранить все свои данные на собственном оборудовании.
Сколько времени занимает дообучение LLM?
Для небольшой LLM процесс может завершиться за срок от нескольких минут до пары часов, в зависимости от размера набора данных и оборудования. Oumi, например, fully fine-tuned a 0.8B model in just over an hour на своей хостинговой платформе.
Более крупные модели или десятки тысяч примеров увеличивают это время до суток или более: запуски LoRA от Emburse для модели 7B заняли 8 часов для 5000 примеров и около 30 часов для 50 000 примеров на одном GPU объемом 40 ГБ.
Можно ли продолжать обновление дообученной модели по мере изменения ваших данных?
Вы можете выполнить повторное дообучение на свежих данных, но каждый цикл требует вычислительных затрат и несет риск катастрофического забывания. Для знаний, которые часто меняются, RAG обычно является лучшим решением, поскольку вы обновляете исходные документы вместо переобучения.