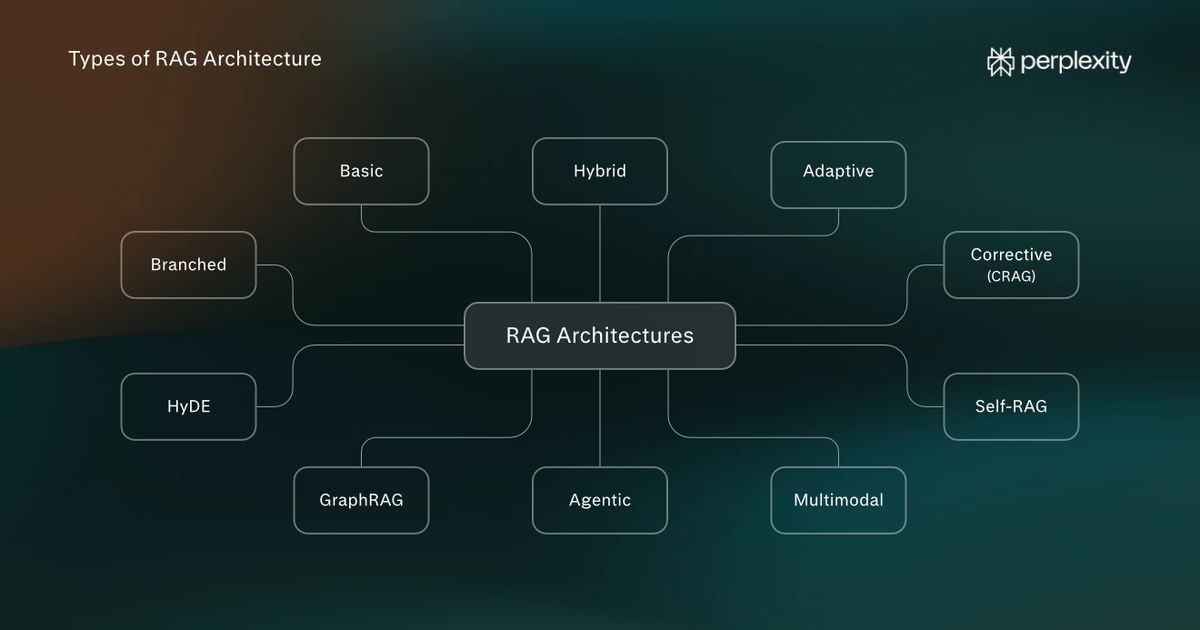
RAG (Retrieval-Augmented Generation, генерация с дополненным извлечением) — это процесс, в ходе которого большие языковые модели (LLM) используют внешнюю информацию для расширения и улучшения своих результатов. Архитектура RAG представляет собой совокупность компонентов и связей, которые делают RAG возможным.
Существует несколько различных категорий RAG, каждая из которых работает на базе своей собственной уникальной архитектуры. По сути, архитектура системы RAG определяет тот уникальный способ, которым информация хранится, извлекается и передается в LLM.
Архитектура RAG — это базовая конфигурация компонентов (и связанных с ними возможностей), которая обеспечивает работу конкретной системы RAG. Все эти архитектуры строятся на основе базового шаблона, который часто называют «простым» или «наивным» RAG.
Вот краткий обзор базовой архитектуры RAG:
- Источник информации: здесь хранится внешняя информация. Это может быть поисковый индекс, векторная база данных, представляющая большие объемы информации, или репозиторий необработанных документов.
- Компонент извлечения: это механизм, с помощью которого выполняются запросы к источнику информации. Например, система RAG может использовать простой поиск по ключевым словам для поиска релевантных фрагментов текста или более сложные векторные запросы для поиска по сходству.
- Компонент оркестрации: этот уровень представляет собой часть приложения на базе LLM, которая инициирует конвейер RAG для пользовательского промпта либо совместно с LLM, либо независимо. Он также компилирует извлеченную информацию в расширенный промпт.
Компоненты архитектуры RAG обычно организуются в два пути. Путь приема данных принимает данные и организует их в доступный для поиска источник информации. Векторные базы данных, в которых большие объемы текста преобразуются в доступный для поиска репозиторий векторных вложений, являются одним из наиболее широко используемых приложений.
Путь извлечения принимает пользовательский промпт и генерирует запрос для поиска по источнику информации. Затем оркестратор добавляет извлеченную информацию во входной контекст для LLM. Для агентных и гибридных архитектур RAG может существовать несколько путей извлечения.
Типы архитектуры RAG
Было бы заблуждением рассматривать RAG через призму совершенно разрозненных архитектур. Большинство инженеров используют модульный подход, реализуя отдельные компоненты под конкретные сценарии использования. Хотя можно провести условные границы, важно отметить наличие значительного пересечения между архитектурными моделями.
1. Базовый RAG
Базовый RAG, также называемый «наивным» или «простым» RAG, служит архитектурным шаблоном для других типов RAG.
Основной процесс относительно прост: пользователь вводит промпт, оркестратор определяет, требуется ли внешняя информация (самостоятельно или совместно с LLM), а затем формирует и отправляет соответствующий поисковый запрос.
Внешним источником информации обычно является векторная база данных, но это также может быть база данных SQL, веб-API, граф знаний или даже репозиторий «сырых» документов. Эта дополнительная информация затем добавляется во входной контекст LLM.
Помимо SQL-запросов и API, существует два основных типа методов извлечения:
- Лексический поиск (поиск по ключевым словам): это простая форма RAG, в которой ключевые слова извлекаются из пользовательского запроса и сопоставляются с отрывками текста, содержащими эти ключевые слова. В современных конвейерах оркестратор может выполнять так называемый разреженный векторный запрос, который не улавливает смысл.
- Плотный векторный поиск (семантический поиск): плотные векторные вложения улавливают смысл. Оркестратор может выполнить запрос к плотной векторной базе данных таким образом, чтобы уловить смысл как пользовательского промпта, так и исходной информации.
Использование памяти также является важной частью архитектуры RAG. Оно определяет, как LLM использует контекст из предыдущих чатов для построения поискового запроса, тем самым укореняя его в более широком контексте обсуждения (или нескольких обсуждений). Диалоговый RAG является нормой для большинства чат-ботов, хотя в некоторых сценариях использования, таких как ответы на тикеты поддержки, может применяться RAG для одного вопроса.
2. Гибридный RAG
Гибридный RAG объединяет два разных типа извлечения: обычно поиск по ключевым словам и семантический поиск. Поиск по ключевым словам находит совпадающие термины, а векторный поиск находит отрывки с близким значением.
Также могут использоваться другие формы извлечения, такие как обход графа знаний или запросы к базе данных SQL. Процесс часто управляется логикой маршрутизации в виде запрограммированных правил или классификации вопроса моделью (хотя несколько конвейеров могут работать и одновременно).
Оркестратор объединяет результаты и может выполнить их переранжирование перед передачей в LLM. Переранжирование — это процесс присвоения оценок релевантности извлеченным фрагментам, чтобы LLM расставляла приоритеты для наиболее применимой информации.
3. Адаптивный RAG
В адаптивном RAG компонент маршрутизации выбирает стратегию извлечения на основе требований пользовательского промпта, а затем оркестратор выполняет выбранный рабочий процесс.
В исходной концепции (Adaptive-RAG) небольшая модель действовала как классификатор и выбирала между отсутствием извлечения, одноэтапным или многоэтапным извлечением. Некоторые архитектуры теперь вместо этого используют генеративные модели или эвристику на основе правил.
Это популярная архитектура, поскольку она распределяет вычислительную мощность в зависимости от сложности и требований промпта, сокращая ненужные шаги извлечения для более простых промптов. Она часто применяется в ассистентах, работающих с вопросами разных типов.
4. Коррекционный RAG (CRAG)
Коррекционный RAG оценивает извлеченную информацию перед добавлением ее во входной контекст LLM. Оценщик извлечения определяет, является ли полученная информация релевантной и полезной. Уникальной архитектурной особенностью является явный этап оценки и коррекции перед генерацией ответа.
Если информация оказывается неполной или неприменимой к промпту, инициируются дополнительные запросы. Они могут включать в себя другие методы извлечения (например, поиск в Интернете или обход графа знаний), отличные от тех, что использовались для исходного запроса.
Коррекционный RAG распространен в областях, где важна точность, таких как медицина и юриспруденция. Однако для этого требуется дополнительный источник информации, который может дополнить первоначально извлеченные отрывки.
5. Саморефлексирующий RAG (Self-RAG)
В Self-RAG модель может инициировать запросы после получения первоначального контекстного ввода. Сгенерированные ответы оцениваются на основе извлеченных данных с помощью токенов рефлексии, и при необходимости через оркестратор отправляются новые запросы. И наоборот, LLM может решить, что извлечение вообще не требуется.
Он отличается от коррекционного RAG тем, что LLM сама оценивает свои собственные результаты, определяет, нужно ли извлечение и полезен ли извлеченный текст, а также отслеживает собственные ответы, изменяя их по мере необходимости. Коррекционный RAG, с другой стороны, оценивает качество извлеченной информации до генерации.
Эта архитектура особенно полезна для сложных промптов в стиле глубоких исследований. Поскольку она интегрирует оценку релевантности (извлеченной информации) в процесс генерации ответов, это отличный вариант для промптов, требующих ответов на основе фактов.
6. Агентный RAG
Agentic RAG относится к любой форме RAG, которая выполняется в контексте агентской платформы. Модель использует свои способности к рассуждению, чтобы определить тип необходимой информации и выбрать из доступных вариантов поиска.
Поиск может запускаться несколько раз по мере необходимости, и у модели есть возможность назначать агентов для более сложных запросов. Например, LLM может запросить поиск в базе данных для определения поставщика, запустить поиск по документам для нахождения соответствующих контрактов и завершить поиском в интернете для проверки контактных данных с использованием общедоступных источников.
Agentic RAG является основной реализацией архитектуры в таких популярных чат-ботах, как Perplexity, ChatGPT, Claude и т. д. Поскольку эти платформы предоставляют базовой модели доступ к нескольким инструментам и конвейерам RAG, она может выбирать, какая форма поиска лучше всего подходит для конкретного промпта.
7. Мультимодальный RAG
Мультимодальный RAG извлекает контекст из различных типов медиа. Это важная форма RAG, поскольку она делает доступной для LLM информацию, такую как графики и аудиозаписи, которая в противном случае была бы недоступна.
Базовая архитектура такая же, как и в любой другой системе. Например, конвейер индексации может подготовить изображения к поиску путем преобразования их в прямые эмбеддинги. Затем система Agentic RAG может извлекать эти изображения вместе с семантически релевантным текстом и передавать их в мультимодальную языковую модель для двойной обработки.
8. GraphRAG
GraphRAG использует графы знаний наряду с векторным поиском для извлечения информации об объектах. Как правило, оркестратор находит релевантные стартовые объекты, также называемые узлами, с помощью извлечения ключевых слов или предварительного векторного поиска. Поисковик по графу обходит граф знаний для построения более широкого контекста.
Например, в ответ на запрос о подробной разбивке категории продуктов LLM может запустить векторный поиск для выявления конкретных объектов (продуктов). Затем оркестратор инициирует поиск по графу знаний для нахождения связанных объектов, таких как поставщики, торговые точки, отзывы и т. д.
9. Разветвленный RAG
Если архитектура гибридного RAG способна использовать различные методы поиска, то под разветвленным RAG понимается процесс одновременного выполнения нескольких запросов, называемых ветвями. Каждая ветвь может запрашивать отдельный источник информации, либо ветви могут запрашивать один и тот же источник параллельно с помощью разных запросов или фильтров. Архитектура Agentic RAG часто использует разветвленный RAG.
10. HyDE (Гипотетические векторные представления документов)
HyDE — это инновационная форма RAG, в которой LLM создает гипотетический текстовый документ о том, как мог бы выглядеть оптимальный ответ. Этот «гипотетический документ» затем используется для создания запроса с целью более точного поиска. Хотя релевантные знания не представлены в параметрах LLM, предполагается, что пассаж, похожий на ответ, может соответствовать релевантным документам лучше, чем короткий вопрос или неоднозначный промпт.
Пример простой архитектуры RAG: Векторная база данных
Базовый RAG служит основой для более сложных типов архитектуры. В случае простой системы RAG, использующей векторную базу данных, исходная документация разбивается на более мелкие части (фрагменты) и преобразуется в плотные эмбеддинги. Когда пользователь вводит промпт, оркестратор генерирует запрос, кодирует его и обращается к базе данных для поиска релевантных пассажей.
Вот пошаговый разбор этого процесса:
- Большие объемы текста преобразуются в векторы с помощью автоматизированного конвейера приема данных и модели эмбеддингов, такой как BERT.
- Приложение базы данных организует, индексирует и хранит векторы для быстрого поиска.
- Пользователь вводит промпт в чат-бот (например, Perplexity).
- Оркестратор приложения кодирует промпт (с использованием модели эмбеддингов) для извлечения релевантной информации из векторной базы данных.
- Векторная база данных возвращает релевантные фрагменты, и оркестратор добавляет их во входной контекст («большой промпт»), после чего передает его в LLM.
- LLM использует дополнительный контекст для генерации ответа, опираясь на свои внутренние знания (сохраненные в ее параметрических весах).
Пример продвинутой архитектуры RAG: Agentic RAG
Agentic RAG относится к базовой архитектуре систем RAG в рамках агентской платформы. Процессы Agentic RAG, как правило, сложны, поскольку агенты ИИ могут вызывать различные инструменты и конвейеры в зависимости от характера промпта, задействуя при необходимости нескольких агентов.
Вот практический пример этого процесса:
- Пользователь вводит сложный вопрос, требующий глубокого исследования темы. Для данного примера предположим, что промпт звучит так: «Предоставьте прогноз доходов компании на следующие шесть месяцев в свете ключевых геополитических событий».
- LLM приходит к выводу, что потребуется комбинация запросов RAG по различным типам контента.
- Развертываются три разных агента для (a) векторного поиска, (b) веб-заземления (web grounding) и (c) поиска по изображениям (мультимодального поиска).
- Агенты ищут релевантную информацию, такую как новостные материалы и внутренние финансовые данные, через оркестратор, используя доступные инструменты поиска.
- LLM сопоставляет полученные результаты с исследовательским вопросом каждого агента и ранжирует их по степени релевантности.
- LLM оценивает информацию и инициирует дополнительные поиски через отдельных агентов там, где информации не хватает.
- Как только собрано достаточно информации, LLM генерирует сценарные прогнозы на основе имеющихся финансовых показателей (извлеченных из внутренней документации) и вызывает инструмент калькулятора для прогнозирования доходов по каждому из них.
- LLM генерирует финальный ответ, используя извлеченную информацию и расчеты, со ссылками на источники при необходимости.
Что ждет RAG в будущем?
Текущие инновации сосредоточены на обеспечении глубины и скорости существующих архитектур RAG, повышении точности мультимедийного поиска и создании систем, предназначенных для работы с самой актуальной информацией.
Вот три тенденции, которые в настоящее время определяют направления исследований:
- Глубокие исследования по нескольким источникам: это архитектура RAG, способная планировать поиск, запускать несколько ветвей по разрозненным источникам, оценивать извлеченные данные и самостоятельно оптимизировать генерируемые ответы. Agentic RAG, способный выполнять все эти задачи, продолжает становиться быстрее и экономичнее.
- Мультимодальные приложения: конвейеры поиска все лучше работают с изображениями и видео. Они все точнее определяют конкретные типы информации в сложных мультимодальных данных, таких как длинные видеозаписи и сложные диаграммы.
- Обоснование ответов на основе непрерывно меняющейся информации: приложения на базе LLM могут опираться на источники информации в реальном времени (например, видеопотоки и датчики) для предоставления входного контекста. Системы также могут генерировать многогранные сети информации, как в случае с GraphRAG, для интерпретации этих данных.
RAG является основой работы приложений на базе LLM. Он позволяет самым разным пользователям, от рядовых потребителей до предприятий, работающих в специализированных областях, преодолевать проблемы, связанные с галлюцинациями, неполными обучающими данными и отсутствием доступа к специализированным внутренним знаниям.
Именно поэтому системы RAG и лежащая в их основе архитектура представляют собой одну из наиболее динамично развивающихся и захватывающих областей исследований в области искусственного интеллекта.