RAG является важнейшим компонентом современной инфраструктуры на базе LLM. Позволяя моделям ИИ получать доступ к внешним данным, он помогает решать такие проблемы, как галлюцинации и неполнота обучающих данных. Это также означает, что компании могут использовать внутренние базы знаний, содержащие конфиденциальную или проприетарную информацию.
Реализация RAG может быть очень сложной. Однако базовую систему RAG построить на удивление легко. Для новичков создание простой архитектуры может пролить свет на то, как RAG работает в реальном мире, и послужить трамплином для дальнейших экспериментов.
В этой статье мы спланируем базовую реализацию RAG, рассмотрим лучшие практики, а затем создадим работающую систему с использованием Python, ChromaDB и двух моделей Perplexity для создания эмбеддингов и генерации ответов.
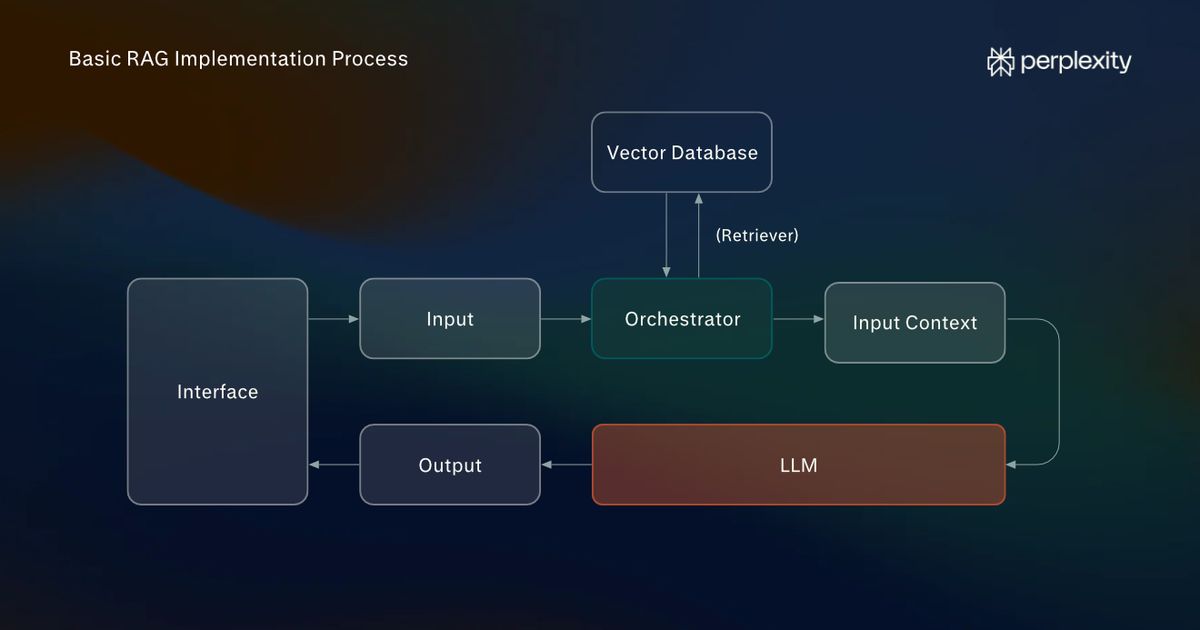
Процесс реализации базового RAG: общее представление
Базовая система RAG состоит из трех основных компонентов: оркестратора, источника информации и LLM. В типичном рабочем процессе пользователь вводит запрос, а оркестратор модифицирует его для поиска по любым подключенным источникам информации. Извлеченная информация затем добавляется к исходному контексту ввода и отправляется в LLM для генерации ответа.
Вам нужно будет учитывать следующие шаги при создании реализации RAG:
- Индексация и создание эмбеддингов: На этом этапе ваши документы конвертируются в источник информации, который может искать оркестратор. Один из наиболее распространенных способов сделать это — построить поисковый векторный индекс. Мы будем использовать специальную модель от Perplexity для преобразования фрагментов вашего документа в эмбеддинги. Затем мы сохраним эти эмбеддинги с помощью ChromaDB, популярной векторной базы данных с открытым исходным кодом.
- Оркестрация: Это приложение, которое находится между внешним источником информации (в нашем случае векторной базой данных) и LLM. Мы создадим простой скрипт на Python, который будет выполнять роль оркестратора.
- Извлечение и генерация: Когда пользователь задает вопрос через интерфейс чата, оркестратор принимает его, выполняет векторный поиск и передает расширенный ввод в LLM. Мы будем использовать командную строку для взаимодействия с нашим Python-оркестратором вместо создания специализированного фронтенда.
Лучшие практики: Что делает реализацию RAG эффективной?
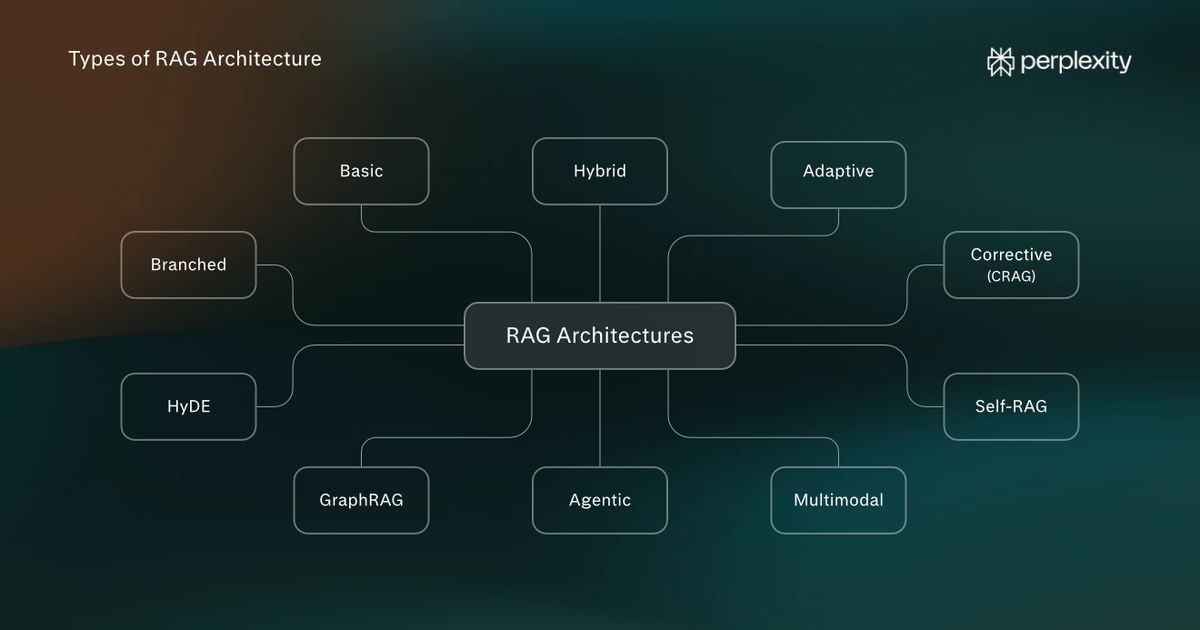
Существует несколько типов архитектуры RAG, и для конкретных вариантов использования требуются разные подходы. Тем не менее, ряд лучших практик применим во всех случаях и обеспечивает создание точных, экономичных, масштабируемых и поддерживаемых систем.
Следующие лучшие практики применимы ко всем типам реализации RAG:
- Обеспечьте чистый конвейер загрузки данных: Ваши исходные данные должны быть максимально чистыми перед индексацией. Вам также следует использовать модель эмбеддингов, подходящую для вашего контента.
- Используйте гибридный поиск: Лучшие методы извлечения (будь то поиск по векторной базе данных, веб-поиск на основе API, обход графа знаний, поиск по ключевым словам или другие методы) различаются в зависимости от варианта использования. Выбор правильного сочетания важен для минимизации затрат.
- Оценивайте вашу систему: После реализации следует провести оценку по трем основным критериям: точность, релевантность и задержка. Точность относится к фактической правильности, релевантность — к применимости извлеченной информации к запросам пользователей, а задержка — к скорости извлечения информации.
- Обеспечьте безопасность информации: Если ваша система RAG использует частную внутреннюю информацию, убедитесь, что она хранится в безопасности, а доступ к интерфейсу системы контролируется. Ключи API никогда не должны передаваться третьим лицам.
Базовая реализация RAG: руководство из 7 шагов
Для этого руководства мы создадим приложение командной строки, которое отвечает на вопросы по одному документу. Мы будем использовать Python, ChromaDB и API Perplexity.
Цель состоит не в создании готовой к продакшену системы RAG. Скорее, это удобное для новичков руководство, призванное проиллюстрировать, как зачатки архитектуры RAG работают на практике.
Шаг 1: Установка ПО
Убедитесь, что на вашем компьютере установлены следующие компоненты и у вас есть учетная запись Perplexity API:
- Python: Это язык программирования, который мы будем использовать для создания оркестратора, координирующего поток данных между моделью эмбеддингов, ChromaDB и Perplexity.
- Visual Studio: Мы будем использовать Visual Studio в качестве редактора кода. После установки откройте панель расширений и загрузите расширение Python.
- Учетная запись Perplexity API: Perplexity предоставит как модель эмбеддингов (которая преобразует ваши данные в векторные эмбеддинги), так и LLM, которая будет обрабатывать расширенный запрос. Для этого не требуется платная учетная запись, хотя потребуется небольшое количество средств на балансе.
Шаг 2: Создание папки проекта
Начните с создания папки с названием rag-project и открытия ее в VS Code, выбрав Файл > Открыть папку (File > Open Folder). Затем откройте интегрированный терминал через Терминал > Новый терминал (Terminal > New Terminal).
Введите следующее, чтобы создать виртуальное окружение Python:
bash
py -3.12 -m venv .venv
Теперь вам нужно установить четыре библиотеки Python: perplexityai, chromadb, python-dotenv и numpy. SDK Perplexity позволит вам подключаться к моделям Perplexity через API. ChromaDB строит векторную базу данных и будет работать локально. Python-dotenv надежно загружает ваши ключи API из локального файла, а NumPy необходим в процессе загрузки данных.
Установите их с помощью следующей команды:
bash
.\.venv\Scripts\python.exe -m pip install perplexityai chromadb python-dotenv numpy
Шаг 3: Настройка файлов
Добавьте следующие файлы в rag-project (корень проекта), выбрав Создать файл… (New File…) на боковой панели проводника:
- index.py: Это приложение, которое будет индексировать ваш документ. Вы можете перезапустить его, чтобы добавить дополнительный текст.
- rag.py: Это приложение на Python, которое будет выполнять роль оркестратора.
- document.txt: Здесь будет содержаться документация, которую вы преобразуете в векторную базу данных.
- .env: Здесь вы будете хранить свой ключ Perplexity API.
В файле .env введите следующее:
plaintext
PERPLEXITY_API_KEY=your_api_key_here
Замените your_api_key_here вашим реальным ключом. Для этого вам нужно зайти на главную панель консоли Perplexity API и выбрать пункт Создать ключ API (Create an API key). Держите этот ключ API в секрете.
Мы будем использовать две модели: pplx-embed-v1-0.6b от Perplexity для создания эмбеддингов нашей документации перед загрузкой в ChromaDB и GPT-5.6-Luna (доступную через API Perplexity), которая будет обрабатывать извлеченную информацию.
В файл document.txt добавьте текст, который будет извлекать ваш конвейер RAG. Если у вас нет под рукой подходящего документа, используйте произведение Уильяма Блейка Песни невинности и опыта с сайта Project Gutenberg для этого руководства. Это короткий, легкий для понимания текст, находящийся в общественном достоянии.
Шаг 4: Написание программы индексации
Скопируйте и вставьте приведенный ниже код в index.py. Каждый подзаголовок дает краткое объяснение того, что делает следующий фрагмент кода. Это программа, которая преобразует ваши исходные материалы в векторные эмбеддинги и сохраняет их в базе данных ChromaDB с использованием модели эмбеддингов Perplexity pplx-embed-v1-0.6b и библиотеки NumPy.
Вот что делает программа:
- Открывает document.txt.
- Разбивает текст на пересекающиеся фрагменты.
- Отправляет эти фрагменты в модель эмбеддингов Perplexity pplx-embed-v1-0.6b.
- Декодирует и нормализует возвращенные векторы с помощью NumPy, библиотеки Python для вычислительных функций.
- Сохраняет векторы и исходные фрагменты в базе данных ChromaDB (вы увидите, как она появится в директории вашего проекта).
Она настроена таким образом, чтобы не переиндексировать ваш документ при каждом запуске. Если вы добавите информацию в document.txt, она встроит только новый текст.
python
from pathlib import Path from collections import defaultdict, deque from hashlib import sha256 import base64 import numpy as np import chromadb from dotenv import load_dotenv from perplexity import Perplexity # 1. Подключение к Perplexity и ChromaDB load_dotenv() ai = Perplexity() db = chromadb.PersistentClient(path="./rag_database_perplexity") collection = db.get_or_create_collection( name="documents", metadata={"hnsw:space": "cosine"} ) # Преобразование закодированных эмбеддингов Perplexity в числовые векторы def decode_embedding(encoded): vector = np.frombuffer(base64.b64decode(encoded), dtype=np.int8).astype(np.float32) norm = np.linalg.norm(vector) if norm == 0: raise ValueError("Получен вектор эмбеддинга нулевой длины.") return (vector / norm).tolist() # 2. Чтение документа и разделение его на фрагменты text = Path("document.txt").read_text(encoding="utf-8") words = text.split() chunk_size = 180 overlap = 30 step = chunk_size - overlap chunks = [" ".join(words[i:i + chunk_size]) for i in range(0, len(words), step)] if not chunks: raise ValueError("document.txt пуст.") # 3. Извлечение фрагментов, уже хранящихся в ChromaDB existing = collection.get(include=["documents"]) stored_chunks = defaultdict(deque) existing_ids = set(existing["ids"]) for chunk_id, document in zip(existing["ids"], existing["documents"]): stored_chunks[document].append(chunk_id) # 4. Идентификация неизмененных и новых фрагментов new_chunks = [] new_ids = [] kept_ids = set() unchanged = 0 for chunk in chunks: if stored_chunks[chunk]: chunk_id = stored_chunks[chunk].popleft() kept_ids.add(chunk_id) unchanged += 1 else: chunk_hash = sha256(chunk.encode("utf-8")).hexdigest() chunk_id = f"chunk-{chunk_hash}" suffix = 1 while chunk_id in existing_ids or chunk_id in kept_ids or chunk_id in new_ids: chunk_id = f"chunk-{chunk_hash}-{suffix}" suffix += 1 new_chunks.append(chunk) new_ids.append(chunk_id) kept_ids.add(chunk_id) # 5. Генерация эмбеддингов пакетами до 100 фрагментов batch_size = 100 for i in range(0, len(new_chunks), batch_size): batch_chunks = new_chunks[i:i + batch_size] batch_ids = new_ids[i:i + batch_size] embeddings = ai.embeddings.create( model="pplx-embed-v1-0.6b", input=batch_chunks, encoding_format="base64_int8" ) vectors = [decode_embedding(item.embedding) for item in embeddings.data] # 6. Сохранение каждого пакета в ChromaDB collection.upsert( ids=batch_ids, documents=batch_chunks, embeddings=vectors ) print(f"Проиндексирован пакет {(i // batch_size) + 1}") # 7. Удаление устаревших фрагментов old_ids = [chunk_id for chunk_id in existing["ids"] if chunk_id not in kept_ids] if old_ids: collection.delete(ids=old_ids) # 8. Отображение результатов индексации print("Индексация завершена!") print("Неизмененные фрагменты:", unchanged) print("Новые или измененные фрагменты:", len(new_chunks)) print("Удаленные фрагменты:", len(old_ids)) print("Всего сохраненных фрагментов:", collection.count())
Шаг 5. Напишите оркестратор для RAG-системы
Скопируйте и вставьте приведенный ниже код в файл rag.py. Это полная, но минималистичная реализация RAG, использующая Perplexity SDK и функциональность локальной векторной базы данных ChromaDB.
Вот что произойдет при запуске программы:
- Подключается к Perplexity и вашей новой базе данных ChromaDB.
- Проверяет, содержит ли база данных проиндексированные документы.
- Принимает вопрос от пользователя.
- Отправляет вопрос в модель эмбеддингов Perplexity.
- Декодирует и нормализует полученный эмбеддинг с помощью NumPy.
- Ищет в ChromaDB три наиболее похожих фрагмента документа.
- Создает промпт, содержащий извлеченные фрагменты и вопрос пользователя.
- Отправляет промпт в GPT-5.6 Luna через Agent API от Perplexity.
- Выводит ответ и ожидает следующего вопроса.
python
import base64 import numpy as np import chromadb from dotenv import load_dotenv from perplexity import Perplexity # 1. Подключение к Perplexity и существующей базе данных ChromaDB load_dotenv() ai = Perplexity() db = chromadb.PersistentClient(path="./rag_database_perplexity") collection = db.get_collection("documents") # Преобразование закодированных эмбеддингов Perplexity в числовые векторы def decode_embedding(encoded): vector = np.frombuffer(base64.b64decode(encoded), dtype=np.int8).astype(np.float32) norm = np.linalg.norm(vector) if norm == 0: raise ValueError("Получен вектор эмбеддинга нулевой длины.") return (vector / norm).tolist() # 2. Проверка наличия проиндексированных документов в базе данных count = collection.count() if count == 0: raise ValueError("База данных пуста. Сначала запустите index.py.") print("Подключено к существующей базе данных ChromaDB.") print("Сохраненных фрагментов:", count) # 3. Прием вопросов от пользователя while True: question = input("\nЗадайте вопрос (или введите exit): ") if question.lower().strip() == "exit": break if not question.strip(): continue # 4. Преобразование вопроса в эмбеддинг Perplexity question_response = ai.embeddings.create( model="pplx-embed-v1-0.6b", input=[question], encoding_format="base64_int8" ) question_vector = decode_embedding(question_response.data[0].embedding) # 5. Извлечение наиболее похожих фрагментов документа из ChromaDB results = collection.query( query_embeddings=[question_vector], n_results=min(3, count) ) context = "\n\n".join(results["documents"][0]) # 6. Создание промпта и его отправка в фиксированную LLM response = ai.responses.create( model="openai/gpt-5.6-luna", instructions=( "Отвечайте, используя только предоставленные выдержки из документов. " "Не используйте внешнюю информацию. " "Если ответа нет, скажите, что вы не знаете." ), input=f"Выдержки из документов:\n{context}\n\nВопрос: {question}" ) # 7. Вывод ответа print("\nОтвет:\n", response.output_text)
Шаг 6: Запуск приложений
В терминале PowerShell VS Code введите следующее, чтобы встроить содержимое document.txt:
bash
.\.venv\Scripts\python.exe index.py
Вы должны увидеть вывод, похожий на этот, если ваш документ был успешно проиндексирован:
plaintext
Индексация завершена! Неизмененных фрагментов: 0 Новых или измененных фрагментов: 58 Удаленных фрагментов: 0 Всего сохраненных фрагментов: 58
Теперь пришло время запустить основное приложение-оркестратор. Введите эту команду:
bash
.\.venv\Scripts\python.exe rag.py
В случае успешного запуска вы увидите следующее:
plaintext
Подключено к существующей базе данных ChromaDB. Сохраненных фрагментов: 58 Задайте вопрос (или введите exit):
Теперь вы можете задавать вопросы, ответы на которые будут браться из созданной вами векторной базы данных, например:
plaintext
Задайте вопрос (или введите exit): О каких животных говорит Уильям Блейк? Ответ: В отрывках упоминаются овцы, ягнята, птицы, звери, волки, тигры и лев.
Шаг 7: Понимание того, что вы создали
Созданная вами система содержит два основных конвейера, присутствующих в любой RAG-архитектуре: конвейер индексации (или «загрузки») и конвейер поиска и генерации.
Ваша базовая реализация RAG теперь выполняет все следующее:
- Векторное хранилище: Внедрения (эмбеддинги) сохраняются в вашей базе данных ChromaDB в локальной среде на основе файла вашей базы знаний.
- Инкрементальная индексация: неизмененные фрагменты документов не подвергаются повторному созданию эмбеддингов, и вы можете обновлять документ в любое время.
- Семантический поиск: ChromaDB извлекает фрагменты на основе векторного сходства (инициируемого оркестратором).
- Генерация обоснованных ответов: LLM получает извлеченные фрагменты в качестве контекста и включает их в ответ.
- Независимая индексация и запросы: вы можете задавать вопросы без повторной обработки всего текста, содержащегося в вашем файле базы знаний.
- Подключение модели на базе API: все ответы генерируются с помощью GPT-5.6 Luna через Perplexity, а не с помощью модели, запущенной на вашем компьютере.
Дальнейшие шаги: как развивать эту реализацию дальше
Цель этого руководства — создать простую базовую реализацию. Оно охватывает некоторые из основных компонентов архитектуры RAG, присутствующих в современных системах. Если вы хотите продвинуться дальше, есть различные способы улучшить ее.
Вот несколько идей для расширения масштабов вашей реализации:
- Экспериментируйте с LangChain: LangChain — один из самых популярных фреймворков оркестрации с открытым исходным кодом. Он содержит готовые компоненты для создания приложений, способных запускать сложные конвейеры RAG.
- Расширьте функциональность поиска: объедините плотный векторный поиск с лексическим (поиск по ключевым словам), таким как BM25. Добавление веб-поиска через Perplexity Search API также позволит вам подкреплять ответы актуальными данными.
- Добавьте модель переранжирования: интегрируйте модель переранжирования, которая ранжирует извлеченные фрагменты относительно исходного промпта и выбирает наиболее релевантные для включения во входной контекст, предоставляемый LLM.
- Создайте адаптивную систему RAG: адаптивная RAG использует либо LLM, либо классификатор (компонент в составе оркестратора) для определения того, какой метод поиска использовать в модульной системе RAG. Создание такой системы — отличный способ изучить более сложные реализации RAG.
Хотя все это может звучать сложно, помните, что основные платформы ИИ, такие как Perplexity, могут предоставлять расширенную помощь в написании кода. Они отлично подходят для личных проектов и экспериментов, а затраты можно удерживать на относительно низком уровне.
Примечание: в этом руководстве используется GPT-5.6 Luna. Доступность моделей может меняться, поэтому вам может потребоваться обновить вызов API.