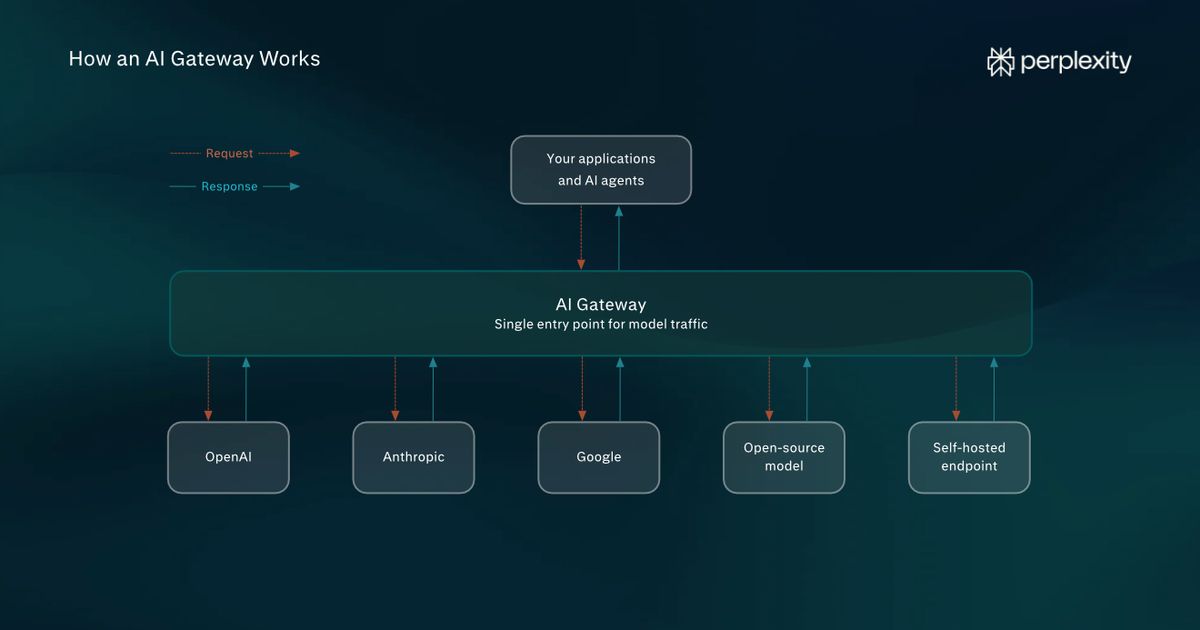
LLM-шлюз располагается между вашими приложениями и провайдерами моделей, к которым вы подключаетесь через него, предоставляя единое место для управления учетными данными и отслеживания использования.
«На данный момент это просто бардак», — написал один из инженеров на Reddit в сабреддите r/LLMDevs в сентябре 2026 года.
«У каждого свой набор ключей для Claude, OpenAI, AWS Bedrock и всех остальных провайдеров инференса, которых мы используем».
Обзор llm-proxy-tk от BigGo, легковесного шлюза на базе FastAPI, уподобляет эту настройку превращению LLM в «корпоративную водопроводную воду», где шлюз выступает в роли главного вентиля здания.
Но прежде чем возлагать столько доверия на эту систему водоснабжения, давайте разберем, что именно вы устанавливаете.
Что такое LLM-шлюз?
LLM-шлюз — это обратный прокси-сервер для вызовов моделей. Ваши приложения отправляют запросы на него, а не напрямую в OpenAI, Anthropic, Google или любым другим провайдерам LLM, которых вы используете. Шлюз пересылает эти запросы, применяя ваши правила по ходу дела.
Для каждого LLM-провайдера существует свой API: у него своя структура запросов, собственная аутентификация и собственный способ возврата ошибок. У каждого также есть отдельные лимиты запросов и режимы сбоев. Если перед ними нет общего уровня, каждое приложение, обращающееся к провайдеру, делает всё самостоятельно и немного по-своему.
Аналогия с водопроводной крановой водой имеет свои пределы, но её вполне достаточно: провайдеры подключаются один раз — на уровне шлюза. С этого момента каждое приложение получает собственное тарифицированное соединение, так что вы можете видеть, кто и что использует, а также перекрыть любую отдельную линию, не затронув остальные.
LLM-, ИИ-, MCP- и API-шлюзы: в чем разница?
Шлюз
Перед чем он находится?
Что он решает?
Ограничения его обзора
API-шлюз
Ваши сервисы и другие бэкенд-API
Прошел ли этот клиент аутентификацию и не превышен ли его лимит запросов?
Может проверять тела запросов, но учет токенов и другие специфичные для моделей элементы управления требуют дополнительной поддержки.
LLM-шлюз
Провайдеры моделей
Какая модель получает этот запрос, кто за него платит и поступил ли ответ?
Видит вызовы инструментов, предлагаемые в ответах моделей, но не их выполнение, если этот трафик также не проходит через него.
MCP-шлюз
Инструменты и источники данных, к которым агент подключается через MCP
Может ли этот агент вызывать этот инструмент с данными аргументами?
Автоматически не видит вызов модели, который привел к запросу инструмента.
ИИ-шлюз
Все, что объединил вендор: модели, потенциально инструменты и трафик между агентами
Комбинация вышеперечисленного в зависимости от продукта
Зависит от того, какие соединения он обрабатывает.
Проследите за одним запросом от вашего приложения к модели и обратно.
- Запрос поступает на шлюз: ваше приложение отправляет на эндпоинт шлюза стандартный на вид запрос чата, часто в формате, совместимом с OpenAI. С точки зрения приложения, это адрес, по которому оно обращается для связи с моделью.
- Шлюз проверяет, кто отправляет запрос и что ему разрешено делать: перед пересылкой запроса он проверяет учетные данные. Зачастую это виртуальный ключ, выданный команде или продукту. Если вы настроили защитные фильтры (guardrails), подсказки (промпты) также могут проверяться на наличие конфиденциальных данных или попыток обойти инструкции модели.
- Шлюз проверяет, есть ли у него уже ответ: если включено кеширование, на подходящий соответствующий запрос можно ответить из сохраненного ответа без повторного вызова провайдера. Некоторые шлюзы также предлагают семантическое кеширование, которое ищет запросы, считающиеся достаточно похожими, а не идентичными. Это может подойти для трафика в стиле FAQ.
- Шлюз выбирает, куда направляется запрос: в запросе может быть указана конкретная модель или псевдоним. Шлюз ищет соответствующий маршрут в вашей конфигурации. Вы также можете настроить резервный маршрут. Если провайдер А не отвечает вовремя, шлюз может попробовать провайдера Б.
- Шлюз подготавливает вызов и возвращает ответ: шлюз преобразует ваш запрос в формат выбранного провайдера и выполняет аутентификацию исходящего вызова. Как только ответ получен, он преобразуется в формат, требуемый вашим приложением.
- Шлюз записывает происходящее: при включенном логировании шлюз записывает такие данные, как автор вызова, обслужавшая его модель, количество токенов, задержка и стоимость. Это тот самый лог, которого не было у инженера с Reddit из введения.
4 вещи, которые нужно знать перед выводом шлюза в продакшен
Все, о чем говорилось в разделе выше, возможно потому, что шлюз видит каждый проходящий через него запрос. В этом и заключается суть предложения. Но это также описание поверхности атак и зависимости от вендора, которые необходимо учитывать при планировании.
Теперь шлюз — самый ценный элемент в вашем стеке ИИ
Шлюз централизует доступ. А следовательно, он также концентрирует множество учетных данных в пределах досягаемости одного сервиса. Команда безопасности Microsoft переводит список того, что может содержать или извлекать развертывание LiteLLM: ключи API провайдера, собственный мастер-ключ, записи виртуальных ключей, строки подключения к базе данных, настройки маршрутизации и политики тенантов.
В октябре 2026 года компания Check Point Research обнаружила две уязвимости высокого риска в LiteLLM:
- CVE-2026-35029 позволяла аутентифицированным пользователям, включая пользователей с правами только на чтение, получать доступ к административным функциям и захватывать экземпляр.
- CVE-2026-59823 позволяла пользователям перенаправлять запросы на контролируемый ими сервер и перехватывать ключи провайдера.
Обе уязвимости были исправлены в версии 1.83.9. Приложение, использующее шлюз, не должно иметь возможности изменять его настройки.
Для ваших защитных фильтров (guardrails) нужна политика обработки сбоев
Хук (hook) — это точка на пути запроса (обычно до отправки промпта модели или после получения ответа), в которой шлюз может передать контент внешнему сканеру для вынесения вердикта. Блокирующая проверка ожидает этого вердикта, прежде чем разрешить дальнейшее прохождение трафика. Документация Portkey называет их before_request_hooks и after_request_hooks; TrueFoundry использует четырехуровневую систему, добавляя проверки до и после вызовов инструментов MCP.
Теперь следует проверить две вещи:
- Что произойдет, если сам сканер потерпит сбой? Блокируя запрос, вы останавливаете непроверенный трафик, но можете прервать работу приложения. Пропустив его, вы позволяете приложению продолжить работу без этой проверки. Журнал сбоев впоследствии покажет вам, что проверка отсутствовала, что полезно, но не заменяет ее фактическое выполнение.
- Можете ли вы заменить сканер? Если другой провайдер не поддерживается, вам, возможно, придется обновить приложение или использовать другой прокси для подключения.
Хуки MCP от TrueFoundry расширяют возможности шлюза от вызовов моделей до вызовов инструментов. Но он может проверять только тот трафик, который проходит через него. Агент-кодер, выполняющий команду на машине разработчика, может находиться вне зоны видимости.
Open-source Numbat от Perplexity работает именно с этой частью. Numbat подключается к поддерживаемым агентам через локальные хуки и может проверять запланированные действия, такие как команды оболочки или запись файлов, до их выполнения. Функция блокировки является опциональной и по умолчанию отключена. Шлюз видит проходящий через него трафик моделей. Numbat повышает прозрачность того, что агент делает с полученным ответом.
Вам необходимо знать, где заканчивается контроль шлюза
Forkast News выделяет три направления, которые подходят к шлюзу с разных сторон:
- Шлюзы с упором на LLM: LiteLLM и Portkey начинались с вызовов моделей — перевода запросов между провайдерами, маршрутизации запросов и отслеживания токенов. Теперь они добавляют элементы управления для вызовов инструментов.
- Платформы управления API: Kong, Apigee от Google и Azure API Management начинались с аутентификации, разрешений и управления трафиком, после чего добавили поддержку моделей и правил, специфичных для ИИ.
- Инфраструктура для агентов: agentgateway, например, была создана вокруг агентов, взаимодействующих с моделями, инструментами и другими агентами, в том числе через MCP и A2A.
Вопрос классификации заключается в том, что именно вы маршрутизируете:
- Только вызовы моделей? Шлюз с первичностью LLM — хорошая отправная точка.
- Вызовы моделей на предприятии, где уже действуют правила API? Начните с имеющейся у вас платформы.
- Агенты вызывают инструменты, которые вызывают модели? Убедитесь, что эти соединения также охвачены.
Вы создаете единую точку отказа
Допустим, ваш чат-бот поддержки использует OpenAI, а ваш исследовательский инструмент — Anthropic, и оба подключаются через один и тот же шлюз. Но если этот шлюз перестает работать, оба инструмента теряют доступ к своим моделям, даже если OpenAI и Anthropic функционируют нормально.
Такое действительно происходило. AI Gateway's error rate peaked at 97% во время сбоя 12 июня 2025 года. Шлюз полагался на службу хранения Workers KV от Cloudflare для настроек, и эта служба дала сбой.
Если вы запускаете шлюз самостоятельно, держите в резерве еще одну работающую копию, которая сможет перехватить управление в случае отказа. Если ваш шлюз размещает кто-то другой, поинтересуйтесь, как они обеспечивают его работоспособность во время сбоев и что происходит с вашими запросами во время восстановления.
Ключевые функции, которые стоит искать в LLM-шлюзах
Вы собираетесь предоставить шлюзу доступ к учетным данным всех сотрудников, поэтому стоит предъявлять высокие требования к тому, что он делает взамен.
- Один API для работы с несколькими провайдерами: ваш код использует один формат, часто совместимый с OpenAI, а шлюз выполняет перевод. Провайдеры LLM идут навстречу. Например, Agent API от Perplexity поддерживает интерфейс Responses API от OpenAI, поэтому команды могут повторно использовать существующие клиентские библиотеки OpenAI.
- Виртуальные ключи с привязанными правилами: каждая команда или продукт получает собственный ключ с правилами, регулирующими разрешенные модели, лимиты запросов и расходы.
- Маршрутизация и резервное копирование: шлюз отправляет запросы к моделям на основе ваших настроек, которые могут отдавать приоритет стоимости, скорости или конкретному провайдеру. Если один вызов завершается сбоем, он может попробовать другой. Agent API от Perplexity позволяет указать до пяти моделей, включая модели от разных провайдеров, в предпочитаемом вами порядке.
- Кэширование: сохраненный ответ может избавить вас от еще одного обращения к провайдеру. Некоторые шлюзы сопоставляют идентичные запросы; другие также могут сопоставлять запросы с похожим смыслом. Проверьте, можно ли разделять кэшированные ответы по пользователям или командам, и можно ли отключать кэширование для персонализированных или чувствительных ко времени ответов.
- Потоковая передача и единообразные ошибки: ответы поступают по мере их генерации, а ошибки провайдеров преобразуются в формат, с которым ваше приложение может работать. Проверьте, что происходит при добавлении защитных механизмов ИИ.
- Ведение логов и распределение затрат: шлюз записывает, кто сделал вызов, какая модель его обслужила, сколько токенов было использовано, сколько времени это заняло и какова расчетная стоимость. Проверьте, включают ли логи промты и ответы и как долго они хранятся.
- Хуки для защитных механизмов (Guardrails): это точки на пути запроса, где шлюз может отправить контент внешнему сканеру для получения вердикта. Обычно они располагаются перед запросом к модели или после ответа на него. Проверьте, останавливаются ли запросы или продолжают выполняться при сбое сканера, и можете ли вы подключить другой сканер.
- Интерфейс администрирования с возможностью строгой защиты: шлюз управляет доступом к учетным данным провайдеров и правилами, которыми все пользуются. Убедитесь, что вы можете ограничить доступ администратора отдельно от трафика приложений и что пользователи с правами только для чтения не могут изменять настройки. Главный вентиль должен быть заперт.
Какие инструменты можно использовать для создания собственного LLM-шлюза?
Списки функций на рынке пересекаются. В одной из веток на Reddit, посвященной внутреннему доступу к моделям, пользователь задал вопрос: какой шлюз не потребует выделенного инженера?
По нашему мнению, это правильный вопрос, и на него есть четыре ответа — в зависимости от того, сколько работы вы готовы взять на себя.
Написать его самостоятельно
Минимальный шлюз выполняет короткий список задач: принимает запросы, проверяет ключ вызывающего абонента, добавляет учетные данные провайдера, пересылает вызов и записывает результат в лог. Но поддержка разных форматов провайдеров добавляет работы. Как и поддержание работоспособности всей системы.
Если вы уже используете Envoy, его фильтр внешней обработки позволяет подключить службу, которая проверяет и изменяет запросы и ответы. При этом вам все равно придется создавать и запускать эту службу.
В ветке r/LLMDevs, посвященной тому, сокращает ли шлюз расходы, пользователь u/QuanTradin рассказал, что регистрация токенов и флаг попадания в кэш при каждом вызове помогли им обнаружить две задачи, которые платили полную цену за идентичные промты.
«...исправление этого стоило больше, чем любой слой маршрутизации».
Это реальный опыт, и с него стоит начать. Выясните, за что именно вы платите, прежде чем создавать сложные способы маршрутизации.
Развернуть open-source шлюз самостоятельно
LiteLLM — распространенный выбор в данном случае: он совместим с OpenAI, поддерживает широкий спектр провайдеров и имеет большое сообщество. Bifrost — альтернатива, созданная с расчетом на низкие накладные расходы на каждый запрос. Helicone заслуживает внимания, если на первом месте в вашем списке функций стоит наблюдаемость.
LiteLLM, как и любой продукт, имеет ограничения для некоторых команд. В ветке r/aiagents об альтернативах созданию собственного решения пользователь u/Own_Bar_920 отметил, что LiteLLM отлично справляется с маршрутизацией, но не подошел им в вопросах версионирования промтов между командами и непрерывной оценки при замене моделей, что подтолкнуло их к использованию отдельного инструмента.
Это выходит за рамки базовой маршрутизации через шлюз, в чем и заключается суть: если главной потребностью является маршрутизация, LiteLLM им подошел.
Вы получаете готовый набор функций (некоторые из них зависят от редакции) и сохраняете шлюз внутри своей сети. Вы также берете на себя установку патчей (что наглядно показали недавние уязвимости от Check Point) и обеспечение доступности шлюза (о чем говорилось в разделе об единой точке отказа).
Но заложите в бюджет зарплату человека, который будет за это отвечать. Одним из опасений в ветке r/LLMDevs, посвященной шлюзам для внутреннего доступа, был вопрос обслуживания. Пользователь u/Informal-Writer9685 хотел получить решение, которое «не требует выделенного инженера для поддержки», и спрашивал, является ли нестабильность обновлений LiteLLM реальной проблемой при их масштабе или это касается только производственной среды.
Использовать управляемый шлюз
Cloudflare AI Gateway, Vercel AI Gateway, OpenRouter, а также хостинговый шлюз Portkey запускают сервис за вас. Для совместимого приложения отправка первого запроса может потребовать не больше, чем изменение URL и добавление ключа API.
Компромисс здесь заключается в том, что теперь каждый промпт проходит через сторонний сервис, прежде чем попасть к провайдеру. Это еще один обработчик данных для вашей отчетности по комплаенсу, а сбой самого шлюза — это инцидент на стороне вендора, и вы не сможете его устранить.
Например, 17 и 19 февраля 2026 года OpenRouter experienced outages lasting 38 and 35 minutes соответственно после сбоя кэширующей зависимости. Некоторые клиенты получили ошибки «Пользователь не найден» и потратили время на отладку абсолютно валидных ключей API. Ошибка заключалась в инфраструктуре шлюза.
Но, к его чести, OpenRouter опубликовал подробный разбор инцидента (postmortem) и добавил средства защиты, чтобы сбой кэша не перегружал его базу данных. Управляемый шлюз, такой как OpenRouter, может упростить доступ, но, как отмечает пользователь u/QuanTradin на r/LLMDevs, консолидация счетов не обязательно приводит к сокращению расходов.
Расширьте уже имеющийся у вас API-шлюз
Если Kong, Apigee или Azure API Management уже обслуживают ваши сервисы, каждый из них обладает специфическими для ИИ возможностями: Kong AI Gateway, политики ИИ-шлюза Apigee и ИИ-шлюз Azure API Management. Вы можете опираться на уже имеющиеся у вас аутентификацию, сетевые правила и операционные процедуры, добавляя элементы управления моделями с помощью плагинов или политик.
В крупной компании это может оказаться путем наименьшего сопротивления с точки зрения организации. ИИ-функции моложе, чем у автономных шлюзов. Обязательно протестируйте ограничение скорости (rate limiting) на основе токенов и потоковую передачу (streaming) со всем набором плагинов или политик, которые вы планируете использовать.
Так что устанавливайте главный вентиль — тот самый всемогущий шлюз. Однако у инженера из введения есть своя точка зрения. Доступ компании к моделям не должен зависеть от того, у кого в ящике стола случайно оказался правильный ключ.
Шлюз решает эту проблему, помещая такие ключи под централизованный контроль, что, впрочем, повышает ставки в случае, если ящик останется открытым. Вы должны знать, чей это ящик.
Часто задаваемые вопросы об LLM-шлюзах
Является ли LLM-шлюз бесплатным?
Если вы имеете в виду категорию в целом, некоторые LLM-шлюзы имеют бесплатные версии.
LLM-шлюзы варьируются от бесплатного ПО с открытым исходным кодом до платных тарифов стоимостью от $50 в месяц, с индивидуальным ценообразованием для корпоративных развертываний. Некоторые взимают процент в качестве оплаты; например, тариф Standard у OpenRouter добавляет 5,5% к покупкам кредитов.
Какой LLM-шлюз является лучшим?
Какую работу вы готовы выполнять сами?
- Обратите внимание на Bifrost или Helicone, если вы хотите самостоятельно развернуть систему и контролировать ее конфигурацию.
- Управляемый вариант, такой как OpenRouter или Vercel AI Gateway, подходит командам, которые хотят, чтобы сервис запускал кто-то другой.
- Если вы уже используете Kong или Azure API Management, сначала ознакомьтесь с их возможностями в области ИИ.
Протестируйте свой короткий список кандидатов с помощью собственных запросов, включая проверку того, что происходит при сбое провайдера.
Есть ли у AWS свой LLM-шлюз?
Да. Amazon Bedrock AgentCore Gateway поддерживает вызовы моделей через то, что AWS называет «целями вывода» (inference targets). Они позволяют приложениям использовать единую конечную точку для обращения к провайдерам, включая Amazon Bedrock, OpenAI и Anthropic, причем шлюз самостоятельно управляет учетными данными провайдеров и маршрутизацией.