Сегодня мы с радостью анонсируем LFM3, наше новое поколение базовых моделей Liquid Foundation Models (LFMs), созданных для специализированного интеллекта. Семейство моделей LFM3 является мультимодальным по своей природе и объединяет текстовые, визуальные, аудио-, омниканальные модели и модели принятия решений на базе единой новой общей архитектуры. Первый релиз семейств LFM3 охватывает модели в диапазоне 2 миллиардов параметров.
Созданная на основе новой гибридной архитектуры и предварительно обученная на 22 трлн токенов, модель LFM3 значительно выразительнее LFM2, сохраняя при этом свою эффективность. Дополнительная емкость в небольшой и быстрой модели делает LFM3 идеальной отправной точкой в своем классе для специализированного интеллекта: ее можно донастраивать локально, она работает на любом устройстве и обладает достаточной способностью стать надежным экспертом в специализированной задаче.
Базовые и прошедшие постобучение модели имеют открытые веса и доступны уже сегодня на Hugging Face, в нашей среде Playground и через API Liquid AI. Ознакомьтесь с нашей документацией о том, как запускать и донастраивать их локально.
Новая архитектура для большей выразительности
Модель LFM2 показала, что гибрид коротких сверток и механизмов внимания может быстро работать на устройстве без потери качества. Ее дизайн стал результатом нашего автоматизированного поиска архитектуры с обратной связью по аппаратному обеспечению (hardware-in-the-loop). Для LFM3 мы использовали этот поиск, чтобы переработать архитектуру для агентских сценариев использования, которые требуют большей производительности на один параметр и быстрого вывода на длинных контекстах.
Мы также расширили аппаратную петлю обратной связи: от процессоров в одном телефоне и одном ноутбуке для LFM2 до 14 комбинаций устройств и бэкендов для LFM3 (смартфоны Samsung Galaxy S26 Ultra и OnePlus 15, Raspberry Pi 5, ноутбуки Apple M4 Max и AMD Ryzen AI, облачные процессоры Arm и x86, а также графические процессоры и NPU Qualcomm Hexagon).
Сокращенные свертки с механизмом шлюзования по-прежнему составляют более половины слоев. Чтобы повысить производительность без замедления работы на длинных контекстах, мы попробовали заменить некоторые из них другими последовательными блоками, и внимание на основе скользящего окна (SWA) обеспечило наилучший баланс между качеством и скоростью. Другие изменения, описанные ниже, мы сохранили только там, где они улучшали качество без существенного ущерба для скорости. Результат проявляется на длинном контексте. В пересчете на один параметр модель LFM3-1.7B соответствует LFM2-1.2B на коротких промптах на периферийных устройствах, а при контексте в 8K токенов она примерно на 25% быстрее.
Трехгибридный набор слоев. LFM3 объединяет три оператора: сокращенные свертки с шлюзованием, внимание на основе скользящего окна (SWA) и глобальное внимание. Из 24 слоев 13 являются сверточными, 5 используют SWA с окном в 256 токенов, а 6 представляют собой глобальное внимание. В свертках также используется размер ядра 7 по сравнению с 3 в LFM2.
Внимание с шлюзованием на уровне голов. Сигмоидный шлюз масштабирует выходные данные каждой головы, позволяя ей отключаться, когда ей нечего добавить. Это помогает подавлять выбросы активации, которые ухудшают квантование, и повышать стабильность обучения.
Частичный RoPE. Слои глобального внимания вращают только половину каждой головы с самой высокой частотой, оставляя низкочастотную половину невзрачной, благодаря чему эти измерения соответствуют контенту независимо от расстояния. Слои SWA сохраняют полный RoPE.
Сэндвич-нормализация. Каждый блок нормализует как свои входные, так и выходные данные, что помогает поддерживать хорошее масштабирование активаций.
LFM3 использует тот же словарь на 128K, что и LFM2.5-8B-A1B, созданный для более эффективной токенизации нелатинских письменностей.
Обучение. Модель LFM3-1.7B-Base прошла предварительное обучение на 22 трлн токенов. По сравнению с LFM2 этот набор включает больше научных статей, кода на уровне репозиториев, более широкий спектр источников знаний и значительно больше математики. Последние 3,5 трлн токенов приходятся на этап промежуточного обучения на отфильтрованных данных более высокого качества с большей долей агентских траекторий и разнообразных вызовов инструментов для подготовки модели к агентскому постобучению. На этом этапе также расширяется контекстное окно до 256K токенов.
Мультимодальное семейство на все случаи жизни
Первый релиз LFM3 включает шесть моделей, разветвленных от одной и той же основы LFM3-1.7B-Base и имеющих около 2 миллиардов параметров. Четыре из них охватывают различные модальности ввода (текст, зрение, аудио и омниканальность), а последние две — это модели принятия решений, специализированные на основе визуальных и омниканальных моделей. Вместо того чтобы запускать одну большую модель общего назначения, вы можете выбрать ту, которая подходит под ваш сценарий использования, настроить ее и запустить на устройстве.
Более подробно с производительностью и результатами вывода этих моделей можно ознакомиться в соответствующих карточках моделей.
Поскольку ИИ все активнее перемещается из облака на клиентские устройства, разработчикам требуются модели, которые можно эффективно развертывать в широком спектре ИИ-ПК. Семейство LFM3 от Liquid AI объединяет мощные мультимодальные возможности и компактный размер, хорошо подходящий для локальных ИИ-приложений. Компания AMD тесно сотрудничала с Liquid AI на протяжении нескольких поколений моделей, и мы рады видеть, как LFM3 расширяет возможности специализированных ИИ-приложений, работающих локально на системах с процессорами AMD Ryzen™ AI.
В разных отраслях мы наблюдаем эволюцию периферийного ИИ от запуска специализированных моделей обнаружения и восприятия к поддержке нескольких одновременных рабочих нагрузок ИИ, включая визуально-языковые модели, интерфейсы на естественном языке и мультимодальные рассуждения. Задача заключается в том, чтобы обеспечить эти возможности в рамках ограничений вычислительной мощности, памяти и энергопотребления периферийных устройств. LFM3 объединяет текст, зрение и аудио в единую архитектуру, разработанную для эффективного развертывания, с открытыми весами, которые разработчики могут донастраивать под конкретные приложения. Разработчики уже могут запускать модели Liquid AI LFM2.5-VL на кремнии Ambarella через Cooper Model Garden, и мы начали внедрение LFM3 на этой же платформе.
01 / 02
Текст
Она прошла постобучение для работы в таких агентских средах, как Hermes Agent, Pi и OpenClaw. Она может разбирать вашу почту, управлять календарем, искать темы в интернете, отправлять утренние сводки в WhatsApp и использовать поиск инструментов, чтобы найти подходящий инструмент среди тысяч вариантов. Поскольку токены бесплатны, десятки агентов могут непрерывно работать в фоновом режиме. Вы можете адаптировать ее под свои домены, обвязки и инструменты с помощью короткого цикла донастройки на одном графическом процессоре.
Бенчмарк
LFM3-1.7B (1.7B)
LFM2.5-2.6B (2.6B)
MiniCPM5
2B (2.5B)
Gemma 4
E4B (8B)
Qwen3.5
4B (4.7B)
Qwen3.5
9B (9.7B)
Агенты
LiveClaw
45.60
14.70
30.37
20.36
19.94
35.77
Claw-Eval General (EN), среднее
68.64
62.63
60.74
56.14
61.96
66.53
Claw-Eval General (EN), pass^3
51.40
37.52
34.58
22.43
42.99
51.87
BrowseComp-Plus (подмножество OpenClaw)
37.00
26.33
16.83
21.00
24.67
38.00
WebArena-Verified
38.42
3.02
9.11
17.06
21.92
28.94
EnterpriseOps-Gym
28.20
7.94
13.41
9.86
25.96
28.97
AutomationBench (публичный)
41.29
0.94
4.71
1.92
8.67
15.10
Использование инструментов
BFCL V4
71.39
55.89
62.65
48.25
55.12
62.83
ToolSandbox
80.36
78.04
68.16
69.27
75.40
76.41
MCP-Atlas
32.57
16.45
26.38
6.19
41.37
42.67
τ³-bench
68.01
56.77
69.44
33.53
65.98
67.11
Агентское программирование
SWE-bench Verified (OpenCode)
43.40
18.00
34.80
0.50
41.20
51.20
SWE-bench Multilingual (OpenCode)
23.00
8.00
15.67
0.67
23.33
35.00
Terminal-Bench 2.1 (OpenCode)
12.92
0.00
5.62
0.00
13.48
17.98
Программирование
LiveCodeBench v6
73.46
60.57
70.52
71.00
61.99
69.86
LiveCodeBench Pro 25Q2
31.74
19.16
29.34
29.94
24.25
34.43
SciCode
28.47
16.32
27.78
25.00
23.02
31.60
Следование инструкциям
IFEval
96.66
95.39
87.83
90.02
92.52
92.08
IFBench
73.03
60.48
62.08
44.56
38.16
48.84
IFStruct
93.72
82.18
72.65
78.45
87.05
89.20
Multi-IF
89.10
84.80
73.19
81.03
80.32
84.44
Knowledge
GPQA Diamond
63.37
57.78
65.15
57.88
75.76
80.40
Humanity's Last Exam (no tools)
7.17
5.88
8.20
4.77
12.84
16.41
Humanity's Last Exam (with tools)
13.90
9.60
11.50
6.00
11.60
17.50
AA-Omniscience (public)
0.50
-33.17
-5.00
-15.33
-57.17
-28.00
AA-Omniscience accuracy (public)
7.07
8.75
9.13
9.83
15.67
13.17
AA-Omniscience non-hallucination (public)
92.93
53.69
84.44
72.09
13.64
52.59
Long context
AA-LCR
52.83
6.00
49.34
39.33
52.67
62.00
RULER 128K
65.56
1.15
37.96
18.82
84.63
87.11
Average
49.37
31.55
39.19
31.74
39.27
47.24
В задачах для агентов LFM3-1.7B конкурирует с моделями, которые в несколько раз превышают его по размеру. Он лидирует в следовании инструкциям и вызове функций в BFCL и ToolSandbox, а также превосходит Qwen3.5-9B в длинных задачах в браузерах и бизнес-приложениях (WebArena-Verified, AutomationBench). Более крупные модели по-прежнему побеждают в агентом кодировании и знаниях, где размер имеет наибольшее значение, но поиск помогает сократить разрыв в знаниях, почти удвоив его результат на Humanity's Last Exam.
Для достижения этих результатов модель прошла четыре этапа постобучения:
- Суперивайзерная тонкая настройка (SFT): 1,75 трлн токенов на различных задачах, включая чат, рассуждения, вызов инструментов и агентные трассы.
- Смешанное обучение с подкреплением: обучение во многих доменах одновременно — от математики и кода до SQL и структурированных выводов. Штраф за длину в вознаграждении обеспечивает краткость ответов.
- Многодоменная дистилляция on-policy (MOPD): шесть учителей RL из специализированных областей (код, математика, использование инструментов, длинный контекст, агентная работа и корпоративные рабочие процессы) дистиллируются обратно в единую модель.
- Агентный RL: задачи от веб-серфинга до офисной работы выполняются в реальных агентных средах, подготавливая модель к развертыванию.
На устройстве мы измеряем показатели с помощью llama.cpp при Q4_0 и контексте 32 тыс. токенов. LFM3-1.7B является самой быстрой моделью на всех трех устройствах, выполняя декодирование в 1,8–2,8 раза быстрее следующей по скорости и используя меньше всего памяти. Длинные контексты остаются недорогими: полный контекст на 128 тыс. токенов требует 1,6 ГБ кэша KV против 4,3 ГБ для Qwen3.5-4B и 5,6 ГБ для MiniCPM5-2B.
На одном ускорителе NVIDIA B300 с SGLang в BF16 модель LFM3-1.7B способна генерировать 3,6 миллиарда токенов в день при 1024 одновременных запросах, что превосходит любую другую модель в данном сравнении.
Чтобы продемонстрировать возможности такой пропускной способности, мы запустили более 300 000 агентов LFM3-1.7B параллельно для исследования архива электронной почты Enron.
LFM3-1.7B может развертываться с низкой задержкой при случайном трафике, обеспечивая сценарии использования в реальном времени, такие как онлайн-обнаружение мошенничества при запуске на Liquid RIPL. Задержка запросов P95 остается стабильной даже при высокой нагрузке, превосходя конкурирующие модели на базе vLLM.
Vision
LFM3-VL-2B может наблюдать, рассуждать и понимать физический мир:
- Понимание видео: впервые модель видения LFM принимает видео в качестве входных данных. Задавайте вопросы о записанной лекции, обходе помещений, снятом на телефон, или клипе с камеры наблюдения.
- Мышление: модель рассуждает шаг за шагом перед тем, как дать ответ. Это помогает ей лучше понимать пользовательские входы и решать более сложные визуальные задачи, такие как математика, графики и многошаговые проблемы.
- Пространственные и воплощенные рассуждения: способность модели локализовать объекты и рассуждать об их пространственных взаимосвязях обеспечивает прочную основу для последующих робототехнических приложений.
LFM3-VL-2B представляет собой качественный скачок в производительности по сравнению с серией LFM2.5-VL. На 62 бенчмарках компьютерного зрения LFM3-VL-2B значительно опережает все модели аналогичного размера по меньшей мере на 7,4 балла, а несмотря на свой размер, соответствует производительности Gemma 4 12B — модели более чем в 6 раз крупнее, превосходит Gemini 3.5 Flash Lite и уступает менее 2 баллов GPT-5.6 Luna. Подробности см. в карточке модели.
Benchmark Category
LFM3-VL-2B (1.9B)
LFM2.5-VL-3B (3.1B)
MiniCPM-V 4.7 1B (1.6B)
Qwen 3.5 2B (2.3B)
Gemma 4 E2B (5.1B)
Gemma 4 12B (12B)
GPT-5.6 Luna
Gemini 3.5 Flash Lite
General
66.0
57.6
59.8
64.0
56.9
74.0
72.2
74.1
Perception
75.6
67.9
65.5
71.2
59.1
73.5
71.0
73.0
Document, OCR & Chart
83.9
71.2
73.0
79.1
72.3
85.7
84.4
82.3
Math & logical reasoning
68.8
40.6
51.8
61.0
51.8
79.3
77.3
66.7
Visual grounding
77.3
68.3
51.1
61.2
41.2
74.1
72.7
63.5
Embodied reasoning
64.4
48.0
45.3
51.2
41.5
59.1
61.5
50.3
GUI understanding
83.1
66.0
45.3
67.2
44.3
76.1
82.5
71.0
Video
61.2
41.3
53.7
57.0
46.6
58.9
72.8
70.0
Multilingual
84.4
81.2
77.4
78.6
73.4
86.1
82.1
85.8
Agentic
42.5
21.1
16.9
15.2
23.8
43.6
56.1
62.4
Average
71.4
57.6
57.5
64.0
53.6
71.7
73.4
70.0
Notes: Each category score is the unweighted mean of its benchmark scores. The Average row is the unweighted mean across all 62 evaluations.
Все это может эффективно запускаться на устройстве, что позволяет использовать интеллектуальные возможности в повседневной жизни без передачи данных с вашего устройства или необходимости подключения к облаку. На устройстве LFM3-VL-2B обладает наивысшей пропускной способностью префилла и минимальным объемом памяти среди всех измеренных устройств по сравнению с другими моделями своего класса.
На одиночном NVIDIA B300 с SGLang в BF16 модель LFM3-VL-2B может выдавать более 12 000 токенов в секунду, что выше, чем у любой другой модели того же класса размера.
LFM3-VL-2B может обслуживаться с низкой задержкой при случайном трафике, обеспечивая такие сценарии реального времени, как тегирование визуальных ассетов при запуске на Liquid RIPL. Задержка запросов P95 остается стабильной даже при высокой нагрузке, превосходя конкурирующие модели на vLLM.
Vision encoder
В дополнение к улучшениям базовой архитектуры LFM3, LFM3-VL поставляется с нашим новым собственным визуальным энкодером, который использует в 3 раза меньше вычислений, чем энкодер SigLIP2 в предыдущих моделях LFM VL.
Энкодер Liquid vision сочетает в себе свертку и внимание, что делает его значительно эффективнее аналога ViT при том же качестве. График эффективности производительности ниже иллюстрирует это. Наш энкодер с 164 млн параметров не уступает визуальному энкодеру Qwen3.5-2B со средней точностью 55,9% по 13 бенчмаркам моделей «видео-текст», требуя при этом в 2,2 раза меньше операций FLOP.
Для видео энкодер совместно встраивает каждую пару выбранных кадров в один временной срез визуальных признаков, сокращая длину временной последовательности вдвое перед дальнейшим кодированием. В совокупности эти решения делают энкодер основой как для более глубокого понимания изображений, так и для эффективной обработки видео.
Audio
LFM3-Audio-2B — это компактная, полнофункциональная аудиомодель, работающая локально на ноутбуках и периферийных устройствах. Она принимает текст или аудио на вход и отвечает текстом, речью или тем и другим.
LFM3-Audio-2B использует новую архитектуру с собственным аудиоэнкодером и кодеком. Она превосходит LFM2.5-Audio по качеству речи и теперь поддерживает 18 языков. Среди новых возможностей — понимание аудио, общее аудиорассуждение и вызов инструментов.
- Голосовой чат: задавайте вопросы вслух и получайте потоковые ответы в виде текста и речи. Для ответов только в текстовом виде модель также может рассуждать перед ответом.
- Многоязычная речь: транскрибируйте, синтезируйте и переводите речь на 18 языках.
- Понимание аудио и рассуждения: попросите модель интерпретировать записи и ответить на вопросы о речи, звуках и событиях, которые они содержат.
- Вызов инструментов: превращайте произнесенные запросы в вызовы инструментов для управления приложениями и устройствами. Модель также может отвечать текстом или речью в дополнение к этим вызовам.
Наша цель — сделать взаимодействие между водителем и автомобилем максимально естественным и интуитивным. Совместно с Liquid мы изучаем, как мощный ИИ на устройстве может еще больше усовершенствовать виртуального помощника MBUX, обеспечивая при этом высокую скорость, конфиденциальность и независимость от облака. Наша архитектура MB.OS служит основой для внедрения таких инноваций в наши автомобили.
ASR (WER, %, чем меньше, тем лучше)
LFM3-Audio-2B
LFM2.5-Audio-1.5B
Gemma 4 E2B
Gemma 4 E4B
Qwen2.5-Omni-3B
Nvidia Audex 2B
Voxtral Mini 3B
MiMo-Audio-7B-Instruct
Kimi-Audio-7B-Instruct
Всего параметров
1.5B
10B
Английский
6.2
6.1
8.3
7.8
6.3
5.5
8.5
5.3
Многоязычный (среднее по en, es, pt, de, fr, it, zh, ja, ko)
8.1
6.5
7.4
6.4
7.8
Английский TTS (UTMOSv2, 1-5, чем выше, тем лучше) (WER, %, чем меньше, тем лучше)
LFM3-Audio-2B
LFM2.5-Audio-1.5B
Qwen2.5-Omni-3B
MiMo-Audio-7B-Instruct
Всего параметров
1.5B
UTMOSv2
3.8
3.2
3.4
2.8
WER
1.4
1.9
3.2
4.9
VoiceBench, Вызов инструментов, Понимание аудио (аудио на входе, текст на выходе, %, чем выше, тем лучше)
LFM3-Audio-2B
LFM2.5-Audio-1.5B
Qwen2.5-Omni-3B
Gemma 4 E2B
Gemma 4 E4B
Voxtral Mini 3B
MiMo-Audio-7B-Instruct
Kimi-Audio-7B-Instruct
Всего параметров
1.5B
10B
VoiceBench
73.1
55.2
66.4
63.3
72.9
65.8
77.3
76.9
Вызов инструментов (Внутренняя оценка)
58.5
44.3
55.6
72.4
44.5
33.4
50.6
Понимание аудио (MMAR)
50.6
25.9
54.4
44.5
49.1
50.1
62.3
53.3
Наш новый аудиоэнкодер на базе LFM создан на основе комбинации слоев со скользящим окном внимания (sliding-window attention) и коротких свёрток, что позволяет удерживать использование памяти в определенных пределах. Новый энкодер является полностью причинным (causal), что позволяет модели обрабатывать данные с микрофона в реальном времени и выполнять предварительное заполнение (prefill), пока вы говорите. Это сокращает время ожидания после завершения речи: время до первого токена составляет всего 50 мс.
LiquidCodec, наш новый аудиотокенизатор, обеспечивает многоязычную генерацию речи как в LFM3-Audio, так и в LFM3-Omni. Созданный на базе архитектуры LFM3, LiquidCodec превращает сгенерированные токены в речь со скоростью около 87× от реального времени на одном потоке CPU (Apple M4 Max) с поддержкой потокового декодирования.
Квантование сжимает каждые 80 мс речи в 12 дискретных токенов и, в отличие от предыдущих моделей LFM Audio, позволяет прогнозировать несколько токенов итеративно и параллельно, а не последовательно. По мере того как базовая модель генерирует новые токены, детеконизатор постепенно преобразует их в речь — и всё это быстрее реального времени, что делает беседу плавной и отзывчивой.
Omni
LFM3-Omni-2B — наша первая универсальная модель (omni-model), объединяющая зрение, звук и язык в единую систему, которая может видеть, слушать и отвечать голосом:
- Ответы на визуальные вопросы на слух: задавайте вопросы об изображениях или реальных сценах с помощью речи и получайте ответы в виде текста, речи или того и другого.
- Аудиовизуальное понимание видео: обработка кадров видео одновременно с соответствующим звуком, что позволяет модели рассуждать как о том, что происходит на экране, так и о том, что говорится или слышится.
- Мультимодальный вызов инструментов: сочетание визуального контекста с голосовыми инструкциями для генерации структурированных вызовов инструментов, позволяя ассистентам взаимодействовать с приложениями и интерфейсами, используя как то, что они видят, так и то, что говорят пользователи.
LFM3-Omni поддерживает кросс-модальные взаимодействия, требующие одновременного понимания визуальной и слуховой информации. Пользователи могут задавать голосовые вопросы об изображениях или предоставлять видео со сбалансированным звуком и задавать вопросы, зависящие как от увиденного, так и от услышанного.
LFM3-Omni-2B
Qwen2.5-Omni-3B
Qwen2.5-Omni-7B
Gemma 4 E2B
Gemma 4 E4B
Phi-4-multimodal
Параметры
2.2B
10.7B
5.6B
Понимание видео и аудио
Daily-Omni
70.1
58.8
61.3
50.6
54.1
48.9
WorldSense
47.1
45.4
38.1
43.5
42.4
AV-SpeakerBench
46.8
40.4
43.2
32.3
36.4
Понимание изображений и аудио
OmniBench (общее)
46.3
47.1
49.7
16.8
20.7
OmniBench Speech
48.2
45.7
16.1
21.3
38.9
Разговорные визуальные вопросы и ответы (Spoken Visual QA)
RealWorldQA
64.7
61.1
69.9
39.4
64.3
MMStar
51.8
50.8
57.3
38.9
44.6
54.8
POPE
83.8
85.3
85.4
74.2
77.8
ERQA
39.4
37.3
39.2
20.6
32.1
30.8
EmbSpatial
67.6
53.4
59.5
44.1
54.0
42.6
В дополнение к кросс-модальному пониманию, LFM3-Omni сохраняет ключевые возможности автономных моделей LFM3, включая ответы на визуальные вопросы, распознавание речи, синтез речи и следование языковым инструкциям.
LFM3-Omni-2B разработана для эффективного развертывания в условиях ограниченных ресурсов. Ее возможности позволяют создавать разговорных ассистентов, способных давать контекстно-зависимые рекомендации, поддерживать взаимодействие без использования рук (hands-free) и помогать пользователям выполнять задачи с помощью естественных голосовых команд. Сочетая визуальное понимание, голосовой диалог и вызов инструментов, модель может поддерживать приложения от персонализированного обучения и повседневной помощи до навигации по цифровым интерфейсам и робототехническим системам.
При 2.2 млрд параметров она переносит этот тип мультимодального ассистента прямо на устройство. Примеры включают репетитора, который смотрит на написанные вами от руки математические формулы и отвечает на ваш голосовой вопрос, планшет, с которым можно ходить и задавать вопросы о том, что он видит, а также автомобильных ассистентов, объединяющих то, что видит камера, с тем, что говорит водитель.
Принятие решений
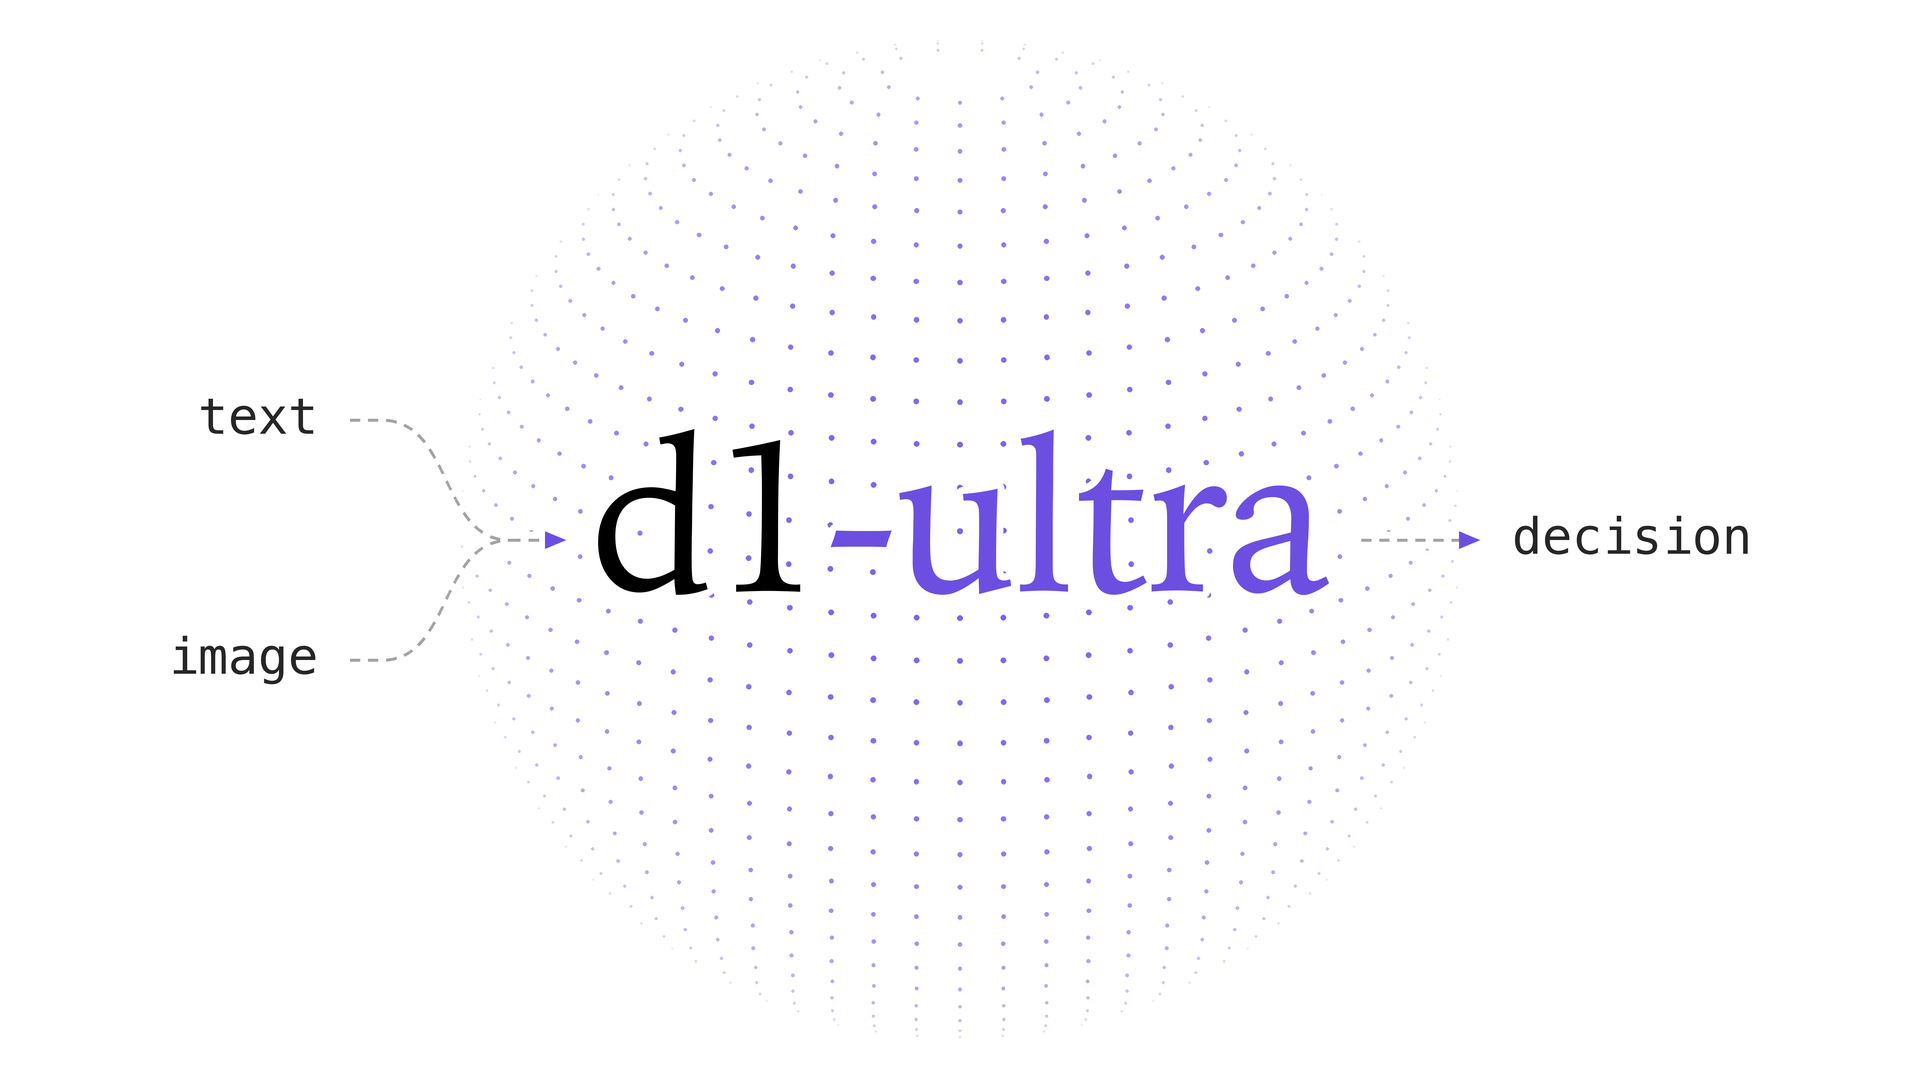
Этот релиз также представляет две новые модели принятия решений: d1-2B, созданная на базе LFM3-VL-2B, читает текст и изображения, а d1-Omni-2B, созданная на базе LFM3-Omni-2B, также умеет слушать. Вместо написания ответа они принимают решение за миллисекунды. Передайте им ситуацию (обращение в службу поддержки, счет, экран приложения, фотографию, голосовую заметку) и список вопросов, и они ответят на все из них за один прямой проход (forward pass), причем для каждого ответа будет указана откалиброванная вероятность.
Помимо новой базовой архитектуры LFM3, главным изменением со времен d1-3B стали типизированные ответы. Помимо да/нет, вариантов выбора и оценок, обе модели теперь умеют:
- Указывать (Point): рисовать рамку вокруг того, что вы описали, или находить каждый экземпляр объекта с указанием их количества.
- Извлекать (Read): находить текст, числа и даты в документе с точным указанием исходного фрагмента, а также сообщать «не найдено», если поле отсутствует.
- Оценивать (Estimate): выдавать число с указанием вероятного диапазона.
- Выбирать (Pick): выбирать все применимые варианты, каждый со своей собственной вероятностью.
Задавайте столько вопросов, сколько хотите: они обрабатываются за один проход по одним и тем же входным данным.
Меньше и мощнее. d1-2B заменяет нашу предыдущую модель d1-3B, имея на треть меньше параметров:
d1-3B
d1-2B
Decision Bench (реальные корпоративные записи)
83.6
85.2
Decision Index, публичный набор тестов
49.0
51.1
ImajevBench (решения по фотографиям и правилам)
64.0
75.5
Наш индекс Meta (117 частных и публичных бенчмарков)
58.8
63.2
Решения, которые можно проговорить голосом. d1-Omni-2B обрабатывает те же вопросы через аудио, поэтому голосовой запрос может быть направлен по назначению, проверен или обработан точно так же, как и текстовый. При голосовом запросе вместо письменного модель сохраняет практически всю свою точность:
письменный
голосовой
DecisionBench (маршрутизация и триаж в бизнесе)
83.4
78.2
Типизированные решения (случаи клиентской поддержки)
50.5
48.0
JevBench
87.6
89.0
Она также распознает повседневные звуки (84.5% в ESC-50) и определяет, на каком из 43 языков идет речь (92.5% в FLEURS).
Выбирайте d1-2B для текста и изображений, и d1-Omni-2B, если ваши входные данные включают аудио. Обе модели работают на устройстве и превращают поток обращений, документов, звонков или кадров с камеры в структурированные решения без отправки запросов в облако.
В следующем демо модель d1-2B работает на MacBook. Вы описываете на обычном языке, что нужно найти, и она рисует ограничивающую рамку вокруг каждого совпадения за один прямой проход, используя новый тип ответа Point.
Создано для специализированного интеллекта
LFM3 создана с расчетом на специализацию. Модели класса 2B достаточно малы, чтобы их можно было дообучать на собственных данных и запускать непосредственно там, где работает ваше приложение. Следующие два примера демонстрируют это на базе LFM3-VL-2B. Первый — это короткое дообучение, превращающее модель в инспекционную для одной узкой производственной задачи. Второй — исследовательское расширение, превращающее ее в контроллер для робота.
Отраслевая экспертиза: специализация LFM3 под вашу сферу
Хотя передовые модели являются мощными универсалами, они не обязательно обладают экспертными знаниями в вашем конкретном случае использования. В этой демонстрации мы дообучили LFM3-VL-2B для поиска и классификации дефектов на фотографиях лопастей ветряных турбин, полученных с дронов. Для обучения использовалось около 3000 публичных фотографий (WTBs2025) с применением SFT и GRPO в течение нескольких часов на одной видеокарте A100. Затем мы сравнили результат с базовой моделью и GPT-6 Luna примерно на 1400 отложенных фотографиях.
Из коробки LFM3-VL-2B и GPT-6 Luna правильно определяют эти типы дефектов менее чем на 10% изображений. Короткое дообучение повышает точность классификации LFM3-VL-2B до 67% и улучшает F1-меру обнаружения с 0,003 до 0,11 по сравнению с 0,01 у GPT-6 Luna. Изображения ударов молнии наглядно иллюстрируют разницу: GPT-6 Luna часто правильно находит дефект, но ошибочно классифицирует его, в то время как дообученная модель верно определяет удар молнии. Помимо классификации и обнаружения, модель может отвечать на вопросы на естественном языке по тому же изображению. Например, она может найти видимые повреждения или составить краткое заключение по итогам осмотра, включая тип дефекта, подтверждающие данные и местоположение.
Робототехника: учим LFM3 действовать
Мы исследуем, как LFM3-VL-2B может служить основой для робототехнических приложений. Мы рассматриваем три взаимодополняющих направления: (1) высокоуровневая оркестрация инструментов, (2) навигация на основе зрения и языка и (3) низкоуровневые манипуляции.
Оркестрация. Опираясь на планирование и управление роботами на базе языковых моделей (SayCan, Code as Policies) и современные физические оркестраторы (VoLo, Gemini Robotics ER 2), мы дообучили LFM3-VL-2B для управления роборукой с помощью инструментов. Получая запрос и текущее изображение с камеры, модель по шагам рассуждает, соотносит объекты с помощью указания, измеряет их инструментами глубины и манипулирует ими через планировщики движений. Затем она проверяет каждый результат по следующему изображению и отчитывается, в том числе если запрос невыполним или неоднозначен. Задачи включают реляционный выбор, сортировку по измеренным свойствам и возмущения окружающей среды, и все это симулируется в Isaac Sim. Никаких архитектурных изменений не потребовалось. Адаптер LoRA ранга 32 был обучен примерно на 40 000 примеров, объединяющих траектории манипуляций с общими данными об использовании инструментов и указании, что заняло около 6 часов работы GPU на одной AMD Instinct MI325X. В сочетании с дообученным монитором навыков d1-2B мы можем дополнительно удвоить успешность восстановления при таких помехах, как проскальзывания, заклинивания и волочение.
Начало работы
Начинайте создавать с LFM3 уже сегодня, модель доступна на Hugging Face и через Liquid AI API.
С помощью LFM3 мы воплощаем в жизнь наше видение искусственного интеллекта, который работает везде. Эти модели:
- С открытыми весами: скачивайте, дообучайте и развертывайте.
Нам не терпится увидеть, что вы создадите.