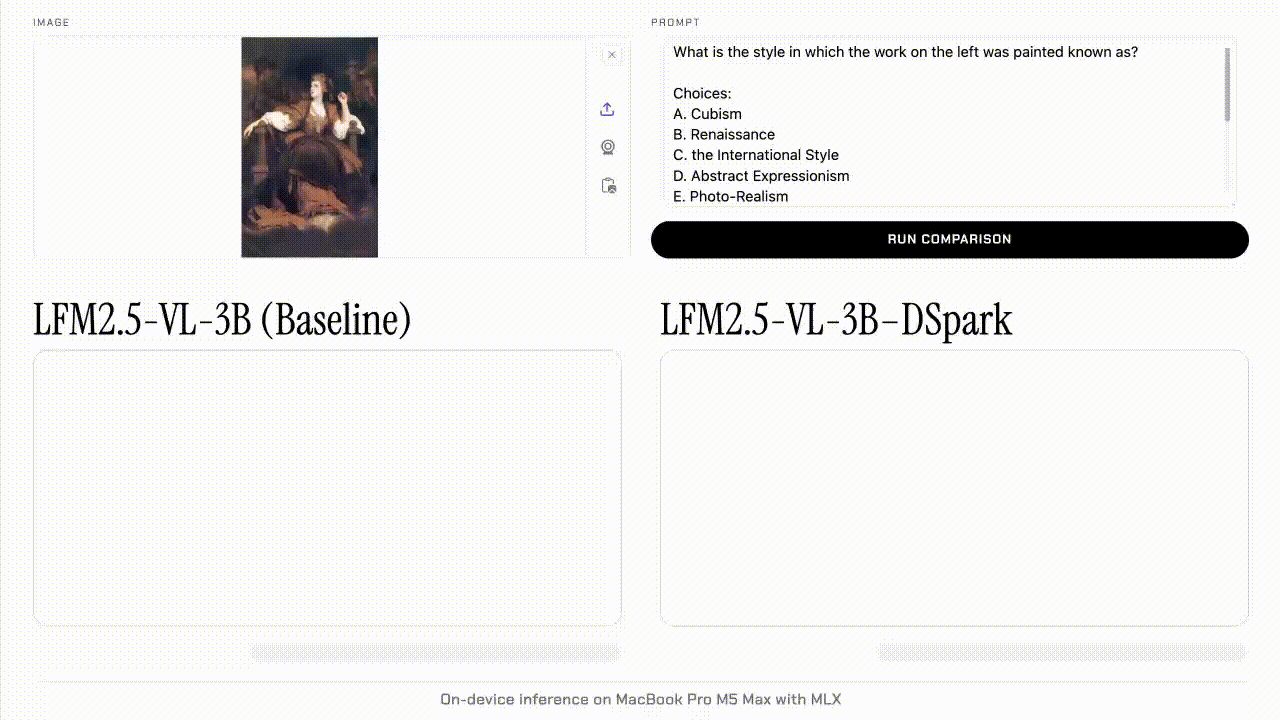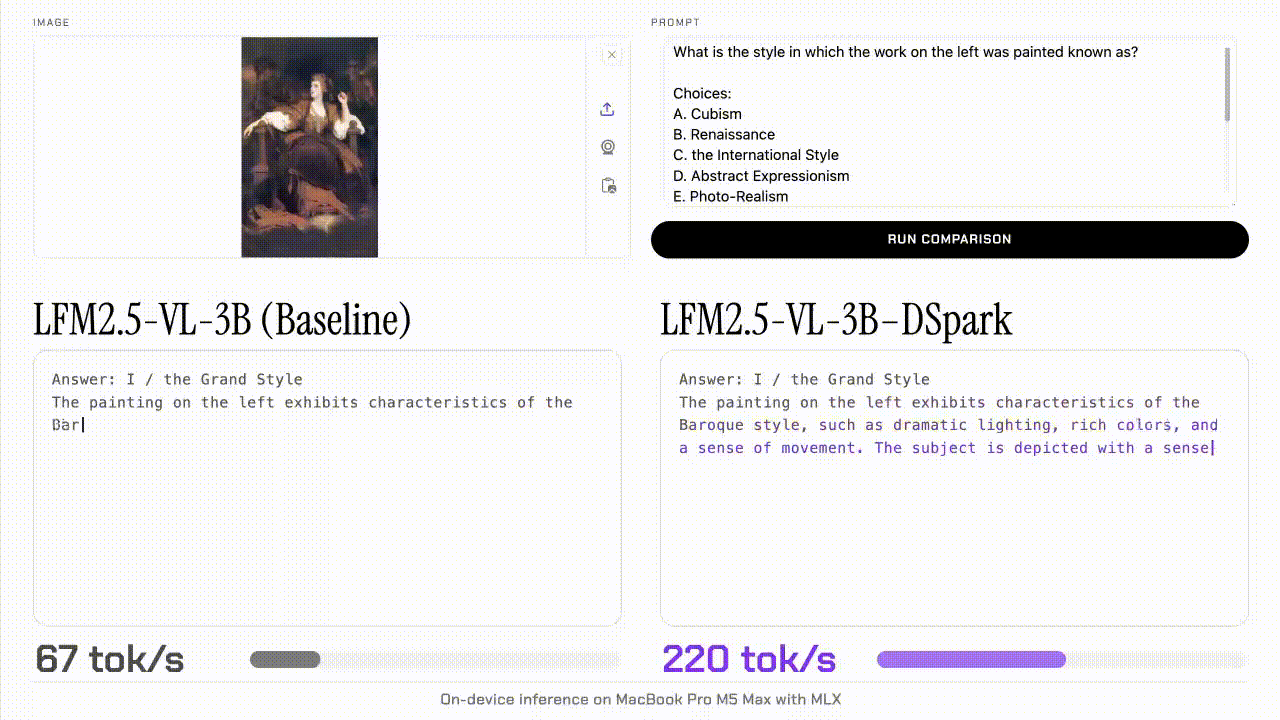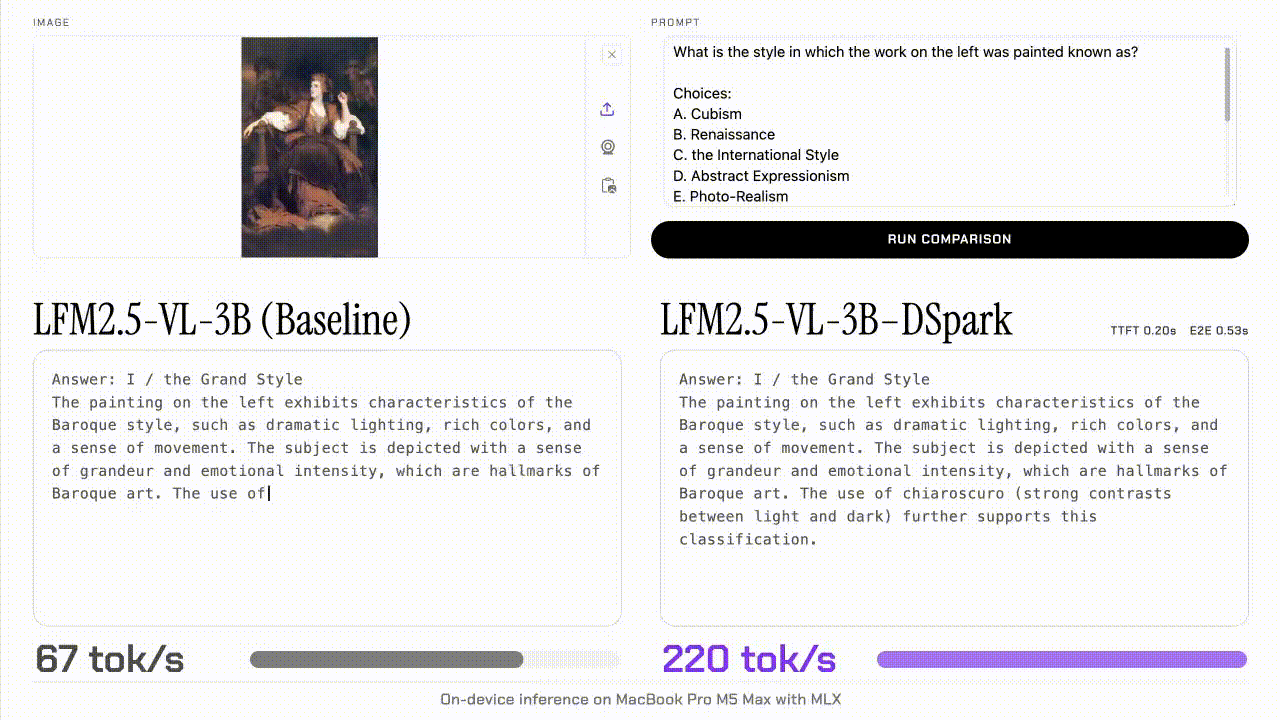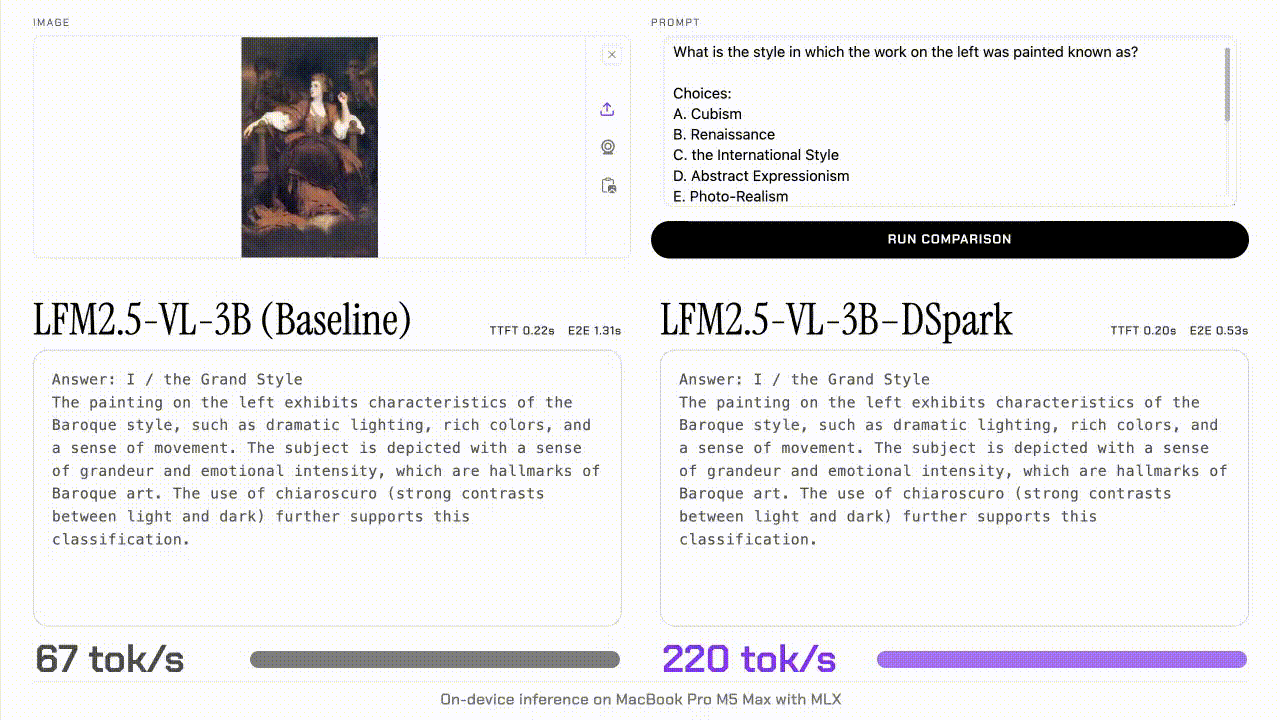
Сегодня мы выпускаем экспериментальную черновую модель DSpark для нашей мультимодальной модели (VLM) LFM2.5-VL-3B. Как и в случае с недавно выпущенными моделями-черновиками LFM2.5-DSpark для наших текстовых Liquid Foundation Models (LFM), она обеспечивает значительно более быстрое декодирование при минимальном увеличении объема используемой памяти, не меняя при этом качество вывода. Мы добились улучшения пропускной способности декодирования до 2,66 раза на GPU и до 3,13 раза на периферийных устройствах, при этом сквозная пропускная способность выросла до 2,27 и 2,62 раза соответственно.
В этой статье рассказывается о том, как мы обучали черновую модель для работы с изображениями и текстом, какое ускорение она обеспечивает и каковы ограничения спекулятивного декодирования для визуальных рабочих нагрузок на периферийном оборудовании.
Модель DSpark для работы с изображениями доступна на Hugging Face с поддержкой в llama.cpp, SGLang и MLX-VLM.
Как работает спекулятивное декодирование для мультимодальных моделей
Черновая модель для работы с изображениями основана на той же концепции, что и наши ранее выпущенные модели-черновики LFM2.5-DSpark [1]. Мы используем скрытые состояния модели на разных слоях, чтобы с помощью облегченной черновой модели делать предположения о следующих k токенах.
С точки зрения черновой модели, модальность входных данных не имеет значения, поскольку к тому моменту, когда токены достигают скрытых слоев, текст и фрагменты изображений уже представлены в виде многомерных тензоров. Неважно, кодируют ли эти состояния абзац текста или изображение — для вычислений черновика это не имеет значения. Это позволяет нам применять точно такой же алгоритм вывода для наших мультимодальных моделей, как и для текстовых.
Обучение
Мы провели абляционные исследования, чтобы выбрать набор данных для обучения наших черновых моделей. Итоговая смесь объединяет данные контролируемого дообучения (SFT), включая распространенные задачи компьютерного зрения, с учетом рабочих нагрузок, которые, как мы ожидаем, будет выполнять модель.
Для архитектуры черновой модели мы следовали рецепту из нашего релиза DSpark для текста: упрощенные модели, использующие только механизм внимания, с количеством слоев и размером блока, выбранными путем абляций на подмножестве обучающих данных. Мы обучали модель на корпусе в течение 10 эпох и зафиксировали коэффициент принятия токенов на целевых визуальных бенчмарках. Основываясь на экспериментах на целевом оборудовании, мы остановились на черновой модели с 4 слоями и размером блока 9. Во время вывода мы рекомендуем использовать размер блока 8 или 9, в зависимости от оборудования (см. раздел «Вывод»).
Полученная черновая модель имеет около 280 млн параметров (Таблица 1) и увеличивает количество параметров развернутой модели всего на 8,9%. Все абляции и циклы обучения выполнялись исключительно на оборудовании AMD с использованием фреймворка обучения Liquid AI.
Компонент
LFM2.5-VL-3B
Стек декодера (4 слоя)
193,0 млн
Проекция скрытых состояний
21,0 млн
Марковская голова
65,5 млн
Нормы + голова уверенности
6,4 тыс.
Итого
279,5 млн
Вывод
Черновая модель DSpark для LFM2.5-VL-3B поставляется с поддержкой «из коробки» во всей экосистеме вывода:
- llama.cpp — GGUF-чекпоинты для эффективного вывода на периферийных устройствах
- MLX-VLM — Оптимизированный вывод для Apple Silicon
- SGLang — высокопроизводительный фреймворк для обслуживания GPU
Все представленные показатели вывода используют 16-битные вычисления как для энкодера, так и для языковой основы. Ускорение квантованных моделей остается за рамками данного релиза. Все запуски были собраны на Pipette, той же инфраструктуре бенчмаркинга, на которой основаны публичные данные Liquid AI о производительности устройств.
Обе конфигурации оцениваются по шести разнообразным задачам, связанным с компьютерным зрением, в соответствии с бенчмарком MMSpec (General VQA, Text VQA, Image Captioning, Chart VQA, Complex Reasoning, Multi-turn Conversation) [2].
Вывод на устройстве. Мы измеряем пропускную способность на устройстве с помощью MLX-VLM на MacBook Pro с чипом M5 Max и llama.cpp на M3 Ultra, используя веса FP16, размер пакета 1, температуру 0, размер блока 8 и до 2048 выходных токенов (медианная длина ответа 90 токенов).
Спекуляция улучшает пропускную способность во всех шести категориях задач на обоих стеках. При использовании MLX на M5 Max декодирование выполняется в 2,30–3,13 раза быстрее в зависимости от задачи, а сквозная задержка сокращается в 1,56–2,62 раза. При использовании llama.cpp на M3 Ultra декодирование ускоряется в 1,57–2,14 раза, а сквозная задержка — в 1,30–1,77 раза. Уровень принятия токенов находится в схожем диапазоне для обоих стеков, примерно от 3,2 до 4,5 токенов за проход проверки, что отражает тот факт, что принятие зависит от черновой модели и рабочей нагрузки, а не от оборудования или среды выполнения.
Вывод на GPU. Мы измеряем пропускную способность GPU с помощью SGLang на одном H100 80GB в формате BF16 при размере пакета 1, температуре 0 и размере блока 9.
Та же черновая модель обеспечивает ускорение декодирования в 2,04–2,66 раза на H100, со сквозным улучшением в 1,64–2,27 раза. Принятие варьируется от 3,46 до 4,57 токенов за проход проверки.
Интерактивность
Преимущества DSpark выходят за рамки размера пакета 1 и сохраняются при более высокой конкурентности. Мы оцениваем границу пропускной способности и интерактивности, которая отражает компромисс между совокупной пропускной способностью системы и скоростью генерации, которую ощущает каждый пользователь при изменении конкурентности. По мере увеличения конкурентности более высокая арифметическая интенсивность постепенно переводит фазу декодирования из режима, ограниченного памятью, в режим, ограниченный вычислениями. Поскольку DSpark проверяет несколько черновых токенов за каждый проход целевой модели, арифметическая интенсивность увеличивается пропорционально размеру блока.
Как показано на Рисунке 5, DSpark сохраняет преимущество в пропускной способности на всех измеренных уровнях конкурентности, хотя разрыв сокращается по мере роста конкурентности. Все тесты были запущены в SGLang на одном H100 с использованием фиксированного окна проверки.
Влияние сэмплирования на скорость и качество
При ненулевой температуре черновая модель выбирает токен из своего распределения, а целевая модель либо принимает его, либо выдает исправленную замену. При одинаковых настройках сэмплирования спекулятивное декодирование эквивалентно по распределению прямому сэмплированию из целевой модели [3], и, следовательно, полученный результат не теряет в качестве.
По мере увеличения температуры затрагивается коэффициент принятия, а следовательно, и пропускная способность. При более низких температурах черновая и целевая модели склонны концентрироваться на одних и тех же топовых токенах. По мере роста температуры вероятностная масса распределяется на менее приоритетные токены, где модели с большей вероятностью могут разойтись во мнениях. В наших экспериментах повышение температуры приводило к снижению коэффициента принятия и, как следствие, негативно влияло на пропускную способность.
Ограничения спекуляции для визуальных рабочих нагрузок на периферии
При выводе больших языковых моделей (LLM) этап префилла (prefill) в значительной степени ограничен вычислительной мощностью, а его стоимость растет (суб)квадратично в зависимости от длины промпта. Вывод VLM увеличивает стоимость префилла: изображение должно сначала пройти через визуальный энкодер, после чего языковая основа должна обработать сотни визуальных токенов, которые он создает вместе с текстовым промптом.
Это становится более проблематичным на периферийных устройствах, где вычислительная мощность значительно ниже, чем на GPU в дата-центрах. В результате префилл составляет более существенную долю сквозной задержки. Это наиболее четко видно по измерениям времени до первого токена и декодирования на Apple Silicon и H100. Новые чипы Apple Silicon частично сокращают этот разрыв за счет добавления нейронного ускорителя к каждому ядру GPU M5 [4].
Спекулятивная декодировка ускоряет только фазу декодирования при выводе LLM. Визуальное кодирование и префилл остаются без изменений. Когда на эти этапы уже приходится значительная доля общего времени выполнения, даже значительное ускорение декодирования приводит лишь к умеренному улучшению сквозной задержки. Это классический пример закона Амдала, согласно которому общее ускорение ограничено той частью рабочей нагрузки, которая остается неускоренной.
Начало работы
Наша модель черновика DSpark для зрения доступна на Hugging Face в форматах и GGUF.
С помощью LFM2.5 мы воплощаем в жизнь наше видение ИИ, который работает где угодно. Эти модели:
- С открытыми весами — скачивайте, дообучайте и развертывайте без ограничений.
- Быстрые с первого дня — поддержка «из коробки» для llama.cpp, MLX и SGLang.
- Полное семейство — от базовых моделей для кастомизации до специализированных аудио- и визуальных вариантов, одна архитектура охватывает разнообразные сценарии использования.
Нам не терпится увидеть, что вы создадите.
Цитирование
Для цитирования, пожалуйста, используйте следующую ссылку или BibTeX:
Liquid AI, «LFM2.5-VL-DSpark: Ускорение моделей зрения-языка на периферии и за ее пределами», блог Liquid AI, сентябрь 2026 г.
Ссылки
- [1] Cheng et al. (2026). DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation. https://arxiv.org/abs/2607.05147
- [2] Shen et al. (2026). MMSpec: Benchmarking Speculative Decoding for Vision-Language Models. https://arxiv.org/abs/2603.14989
- [3] Leviathan et al. (2023). Fast Inference from Transformers via Speculative Decoding. Доказательство эквивалентности приведено в Приложении A.1, «Корректность спекулятивной выборки». https://arxiv.org/abs/2211.17192
- [4] Apple Machine Learning Research (2025). Exploring LLMs with MLX and the Neural Accelerators in the M5 GPU.