По мере того как рабочие нагрузки ИИ смещаются в сторону инференса и агентного ИИ, критерии производительности систем также меняются. Одной лишь вычислительной мощности уже недостаточно. То, где хранятся данные, как быстро они перемещаются и насколько эффективно обрабатываются, теперь напрямую влияет на производительность и эффективность систем ИИ.
Эта серия статей исследует трансформацию экосистемы ИИ, в которой программное обеспечение, инфраструктура центров обработки данных, полупроводники и технологии памяти работают сообща. В ней также рассматривается, почему полупроводниковая память стала фундаментальной технологией для эпохи ИИ, и излагается видение SK hynix по созданию экосистемы памяти для ИИ следующего поколения.
① Смена парадигмы в вычислениях ИИ ② Настоящее «узкое место»: данные, а не вычисления ③ Перепроектирование инфраструктуры: почему архитектура определяет производительность — профессор Онур Мутлу, ETH Zurich ④ Смена полупроводниковой парадигмы в сторону памяти ⑤ Завершение формирования ИИ: физический интеллект и роль памяти
Чтобы такая служба больших языковых моделей (LLM), как ChatGPT, Gemini или Claude, могла ответить на один вопрос, модель должна многократно обращаться к огромным объемам весов модели, предыдущему контексту и промежуточным результатам. По мере того как ответы становятся длиннее и включают больше этапов рассуждения, объем данных, которые необходимо считать, также увеличивается. Поэтому одной из ключевых задач для систем ИИ стало то, насколько быстро и надежно они могут поставлять огромные объемы данных на вычислительные устройства.
Эта задача приобрела особую важность по мере того, как центр тяжести в ИИ смещается от разработки моделей к крупномасштабным сервисным операциям. Предварительное обучение требует огромных первоначальных инвестиций, в то время как инференс происходит каждый раз, когда пользователь отправляет запрос. По мере распространения генеративных ИИ-сервисов, корпоративных помощников (copilots) и агентного ИИ количество запросов растет, а контекст, который должен поддерживать каждый запрос, становится длиннее. В результате конкуренция в области инфраструктуры ИИ выходит за рамки простого развертывания более быстрых GPU/NPU/TPU и более крупных кластеров. Основное внимание все чаще уделяется тому, насколько эффективно GPU/NPU/TPU, память, хранилища и сети могут быть совместно спроектированы и объединены в интегрированную систему, и насколько эффективно данные могут перемещаться по этой системе. Или, что более точно, как минимизировать перемещение данных между компонентами системы.
Современные вычислительные системы предоставляют очень мощную инфраструктуру, которая обеспечила работу все более важных нагрузок, таких как ИИ и машинное обучение, геномный анализ и крупномасштабная аналитика данных. Тем не менее их фундаментальная архитектура остается процессорно-ориентированной. Данные должны постоянно перемещаться по иерархии памяти — от датчиков, хранилищ, памяти и кэшей вплоть до вычислительного устройства (или устройств) и обратно — до и после обработки.
Эта архитектура долгое время была эффективной для повышения производительности вычислений общего назначения. Однако, поскольку рабочие нагрузки ИИ резко возросли как по объему данных, так и по частоте доступа, доступ к данным и их перемещение стали основными «узкими местами» в эффективности системы. Модели постоянно обращаются к огромным объемам весов и промежуточных результатов, в то время как инференс многократно считывает предыдущий контекст и недавно сгенерированные токены. Чем дальше и чем больше данных должно перемещаться, тем выше задержка, энергопотребление и аппаратные затраты.
Чтобы смягчить эти «узкие места» доступа к данным и их перемещения, проектировщики систем значительно усложнили архитектуру компьютеров. Современные вычислительные системы используют множество сложных и дорогостоящих механизмов, таких как иерархии кэш-памяти*, предварительная выборка данных до того, как они понадобятся, многопоточность для параллельного выполнения нескольких задач и внеочередное выполнение*. Эти технологии имели ограниченную эффективность в снижении задержек вычислительных устройств, но привели к значительной сложности, неэффективности энергопотребления и аппаратным затратам в системе.
* Иерархии кэш-памяти: иерархическая структура, которая временно хранит недавно или часто используемые данные рядом с вычислительными устройствами для сокращения времени доступа к памяти. Обычно состоит из нескольких уровней, таких как кэши L1, L2 и L3. * Внеочередное выполнение: метод, который сокращает время простоя вычислительного устройства за счет выполнения инструкций, готовых к запуску, раньше других, даже если это отличается от порядка, указанного в программе.
В современных вычислительных системах вычисления относительно дешевы, однако доступ к памяти и перемещение данных стоят дорого — как с точки зрения производительности, так и с точки зрения энергии. Энергия, необходимая для однократного извлечения данных из DRAM, может быть в 150–2000 раз выше, чем энергия, требуемая для простой арифметической операции. Исследования нейросетевых моделей, работающих на системах с тензорными процессорами (TPU), продемонстрировали огромное влияние этого несоответствия на энергопотребление и производительность*. Для крупных моделей машинного обучения более 90% энергии системы может расходоваться на доступ к памяти и перемещение данных, а не на вычисления*.
Несоответствие между вычислениями и памятью становится еще более выраженным в больших языковых моделях (LLM). Каждый раз, когда LLM генерирует токен, она обращается к предыдущему контексту и обрабатывает огромные объемы промежуточных данных с помощью KV-кэша* и операций внимания (attention). По мере того как модели рассуждают дольше и поддерживают более длинные контексты, их требования к емкости памяти и пропускной способности* резко возрастают. «Узкое место» памяти становится все больше по мере роста этих требований. Независимо от того, насколько быстрым становится вычислительное устройство, эффективность системы снижается, поскольку она тратит большую часть времени на ожидание поступления данных в вычислительные блоки.
По мере масштабирования рабочих нагрузок ИИ память с высокой пропускной способностью (HBM) становится все более важной для обеспечения GPU большими объемами данных на более высоких скоростях. Располагаясь рядом с GPU/NPU/TPU, HBM доставляет большие объемы данных на сверхвысоких скоростях, помогая снизить задержки вычислительного устройства. Однако для полного использования производительности HBM весь путь передачи данных должен быть спроектирован как интегрированная система — не только GPU/NPU/TPU и HBM, но также хранилища, сети и межсоединения*.
* Кэш ключей-значений (KV-кэш): область памяти, где LLM хранит результаты вычислений внимания от предыдущих токенов для использования при генерации последующих токенов. По мере увеличения длины контекста KV-кэш растет, увеличивая требования к емкости памяти и пропускной способности. * Пропускная способность памяти: объем данных, который может быть передан из памяти за определенный период времени. Более высокая пропускная способность памяти позволяет вычислительным устройствам получать и обрабатывать больше данных за один раз. * Межсоединение: путь передачи данных, соединяющий компоненты системы, такие как процессоры, память, ускорители и хранилища. В инфраструктуре ИИ межсоединения являются ключевым фактором, определяющим скорость и эффективность перемещения данных.
Фундаментальные предположения, лежащие в основе проектирования систем, также требуют пересмотра. Процессорно-ориентированные архитектуры в значительной степени работают за счет перемещения данных к вычислительным устройствам для обработки. По мере роста объемов данных и увеличения частоты доступа архитектуры, отправляющие все данные на центральное вычислительное устройство, быстро достигают своих пределов. Теперь систему необходимо перепроектировать с учетом того, где хранятся данные и какой путь они проходят для обработки.
Одной из концепций, разработанных для решения этой задачи, является memory-centric computing (вычисления, ориентированные на память)*. Решение проблемы «узкого места» памяти принципиально более эффективным способом требует сокращения перемещения данных и обеспечения возможности вычислений ближе к памяти. Это основная идея memory-centric computing. В рамках этого подхода расположение данных и затраты на их перемещение являются ключевыми факторами при проектировании системы, что позволяет оптимизировать размещение памяти и вычислительную архитектуру в комплексе*. Некоторые данные могут находиться в HBM рядом с GPU/NPU/TPU, в то время как другие данные управляются в пуле общей памяти*, при этом определенные вычисления выполняются ближе к памяти. Наилучший подход зависит от таких факторов, как архитектура модели, длина контекста, количество пользовательских запросов и конфигурация сети.
Хорошая новость заключается в том, что такие системы, ориентированные на память, уже проектируются и оцениваются не только в академической среде, но и в индустрии. Растет стремление к устранению «узких мест» при перемещении данных, и лучше всего это достигается за счет максимального сокращения перемещений.
* Memory-centric computing: вычислительная парадигма, предназначенная для обработки данных ближе к памяти, отходящая от существующей структуры, которая перемещает данные к вычислительному устройству и обратно. Она фокусируется на сокращении перемещения данных для повышения производительности и энергоэффективности * Onur Mutlu, et al., “Memory-Centric Computing: Solving Computing’s Memory Problem,” 17th IEEE International Memory Workshop(IMW) (2025) * Memory pool: ресурс общей памяти, к которому могут обращаться несколько устройств. Позволяя каждому устройству использовать емкость памяти по мере необходимости, объединение памяти в пулы может улучшить общее использование системных ресурсов
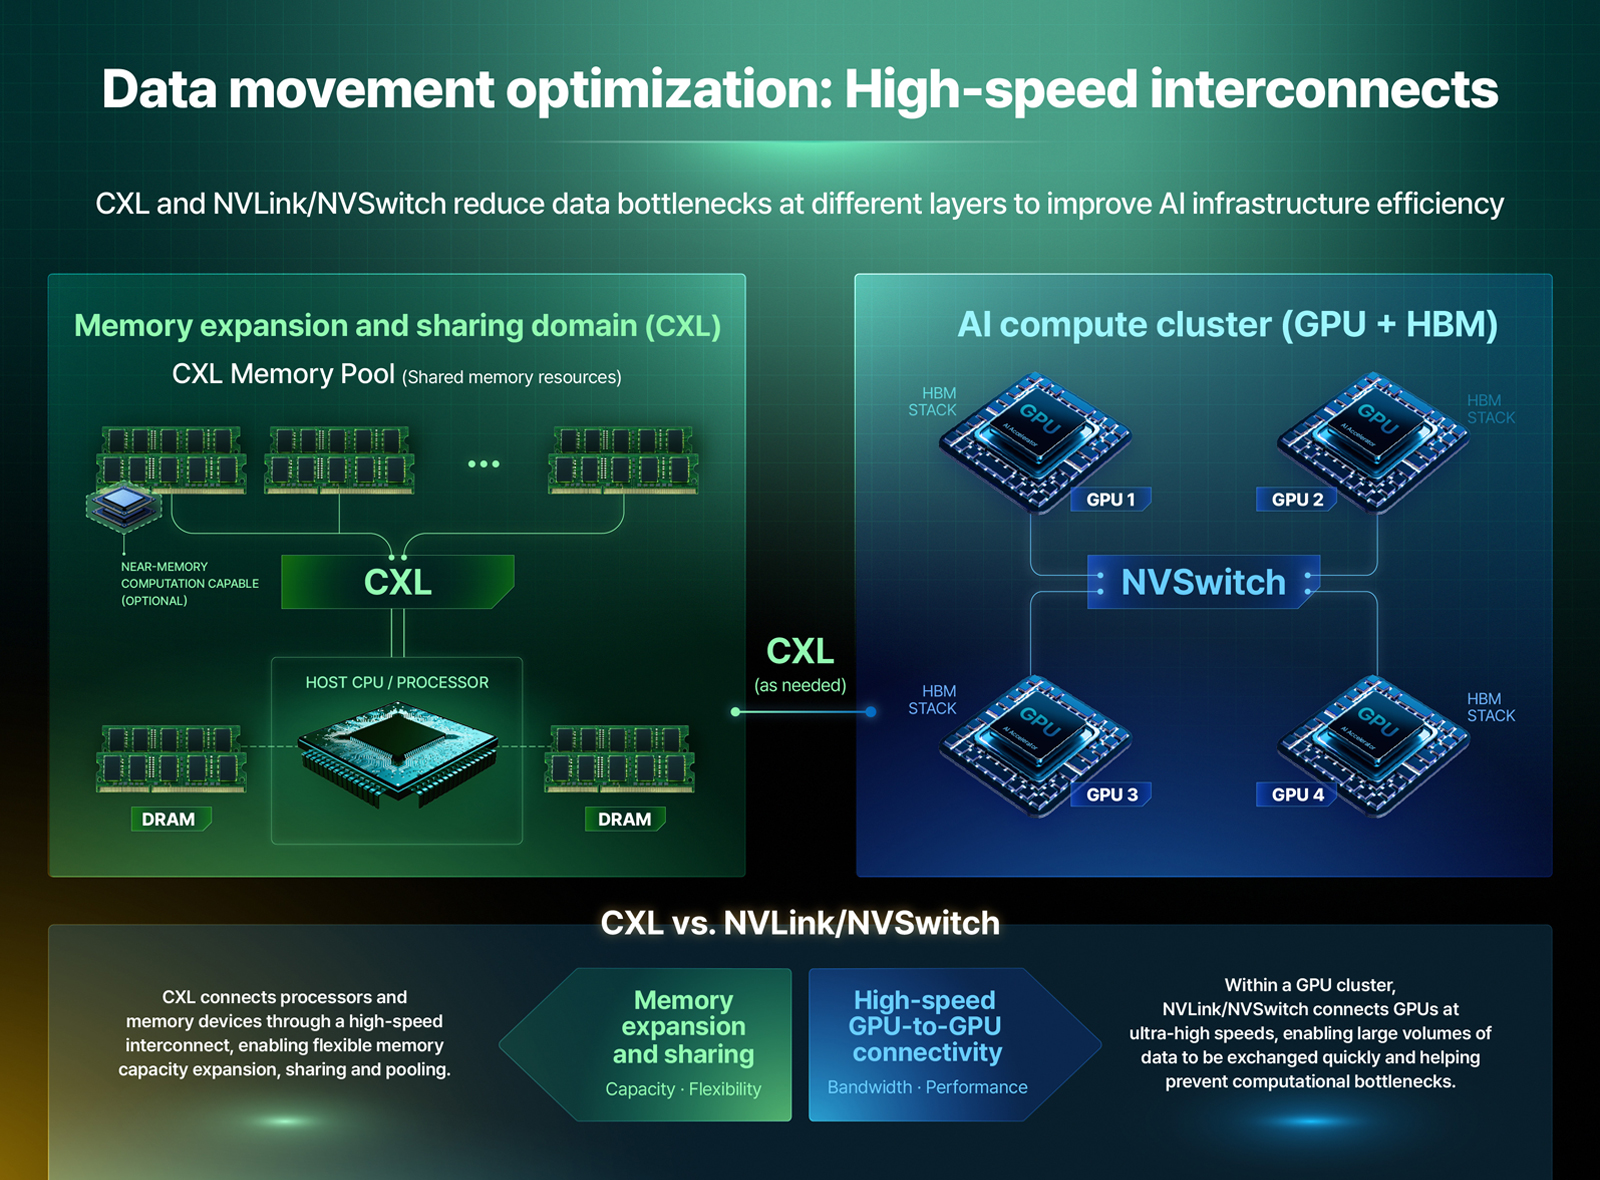
Процессоры, память и ускорители долгое время соединялись с помощью различных интерфейсов. Однако по мере быстрого роста объема данных, обрабатываемых рабочими нагрузками ИИ, традиционные архитектуры соединений с трудом обеспечивают требуемую пропускную способность связи и эффективность доступа к памяти. Следовательно, возрастает важность высокоскоростных межсоединений, которые обеспечивают более быстрые и гибкие пути передачи данных между устройствами. Сегодня CXL* и NVLink/NVSwitch* являются двумя репрезентативными технологиями, стимулирующими этот сдвиг в различных областях, и существуют различные академические работы по тесной интеграции компонентов.
* Compute Express Link(CXL): стандарт межсоединений следующего поколения, обеспечивающий высокоскоростное соединение между CPU, GPU/NPU/TPU, памятью и ускорителями. CXL — ключевая технология для обеспечения расширения и совместного использования памяти * NVLink и NVSwitch: высокоскоростные технологии межсоединений, разработанные NVIDIA. NVLink обеспечивает высокоскоростные соединения между GPU или между GPU и другими устройствами, в то время как NVSwitch расширяет эту связность, обеспечивая высокоскоростную связь между большим количеством GPU. Эти технологии используются для уменьшения «узких мест» при передаче данных между GPU в крупномасштабных кластерах ИИ
CXL — это ключевая технология межсоединений, которая обеспечивает расширение и совместное использование памяти. В традиционных серверных архитектурах память в основном функционировала как выделенный ресурс, привязанный к конкретному CPU или GPU/NPU/TPU. Даже когда у одного устройства были свободные ресурсы памяти, а другое испытывало их нехватку, гибко распределить эту емкость было сложно. CXL расширяет возможности соединения между процессорами, ускорителями и устройствами памяти, создавая основу для гибкого расширения, совместного использования и объединения памяти в пулы. С помощью CXL вычисления также могут быть перенесены на устройства или контроллеры, которые выполняют обработку рядом с памятью, в то время как устройства CXL могут взаимодействовать друг с другом через гибкий интерфейс.
NVLink и NVSwitch обеспечивают высокоскоростное соединение внутри кластеров GPU. Когда крупномасштабные модели ИИ работают на нескольких GPU и узлах, промежуточные данные, такие как параметры модели, активации и KV-кэш, должны перемещаться между GPU. Если соединение между GPU медленное или негибкое, общая производительность обработки может пострадать, независимо от того, насколько быстр каждый отдельный GPU.
CXL и NVLink/NVSwitch выполняют разные роли: CXL фокусируется на расширении и совместном использовании памяти, в то время как NVLink/NVSwitch обеспечивают высокоскоростное соединение GPU. Однако обе технологии поддерживают одну и ту же более широкую цель — устранение «узких мест» данных в инфраструктуре ИИ за счет обеспечения быстрой доставки необходимых данных туда, где они нужны. Когда такая архитектура соединений установлена, память и ускорители перестают быть фиксированными компонентами и становятся системными ресурсами, которые можно конфигурировать в соответствии с требованиями рабочих нагрузок.
Гибкая связность, обеспечиваемая высокоскоростными межсоединениями, также меняет способ размещения вычислительных устройств и памяти. По мере появления большего количества путей передачи данных между устройствами вычислительные ресурсы и ресурсы памяти могут располагаться в соответствии с требованиями рабочих нагрузок. Этот сдвиг указывает на архитектуру, которая не просто перемещает больше данных на большие расстояния, а выполняет необходимую обработку ближе к месту хранения данных.
Устранение «узких мест» при перемещении данных может выйти за рамки простого увеличения скорости соединения. В то время как CXL и NVLink/NVSwitch улучшают пути передачи данных между памятью и GPU/NPU/TPU разными способами, ускорение вблизи памяти (near-memory acceleration) сокращает объем данных, которые необходимо перемещать, за счет размещения самих вычислений ближе к данным.
Вместо того чтобы центральный GPU/NPU/TPU извлекал и обрабатывал все данные, ускорители, расположенные внутри или рядом с устройствами памяти, распределяют рабочую нагрузку между собой. Эти ускорители тесно связаны через высокоскоростные межсоединения, что позволяет сначала обрабатывать данные рядом с памятью, обмениваясь с другими устройствами только необходимыми результатами, вместо отправки всего набора данных на центральный GPU/NPU/TPU. Когда вычисления происходят рядом с 3D-стековой памятью с высокой пропускной способностью* (такой как HBM или другая память большой емкости), гораздо меньше данных должно перемещаться туда и обратно. Это позволяет снизить задержку и энергопотребление, упрощая масштабирование на несколько узлов. Эта архитектура известна как распределенная система тесно связанных ускорителей вблизи памяти*.
Потенциал этого подхода можно увидеть в Tesseract*. Tesseract — это исследовательская архитектура (опубликованная на 42-м симпозиуме ACM/IEEE по компьютерной архитектуре в 2015 году), которая применяет распределенное ускорение вблизи памяти для параллельной обработки графов. Несколько ускорителей, расположенных близко к памяти, обрабатывают назначенные им данные независимо и взаимодействуют друг с другом только при необходимости. Для различных рабочих нагрузок параллельной обработки графов исследование продемонстрировало повышение производительности на порядок, а также аналогичное снижение энергопотребления по сравнению с традиционными процессорно-ориентированными конструкциями.
Значимость этих результатов выходит далеко за рамки простых цифр. Благодаря локальной обработке данных, назначенных каждому узлу, и сокращению объема коммуникаций, данная архитектура позволяет достичь большей масштабируемости и энергоэффективности по сравнению с традиционными решениями. По мере добавления новых и разнообразных ускорителей емкость памяти, пропускная способность памяти* и вычислительные возможности масштабируются пропорционально. Иными словами, ключ заключается не просто в распределенной обработке, а в архитектуре, в которой несколько ускорителей, расположенных вблизи памяти, тесно связаны между собой и выполняют вычисления совместно с минимальным перемещением данных.
* 3D-стековая память с высокой пропускной способностью (HBM): архитектура памяти, в которой несколько кристаллов памяти расположены вертикально друг над другом для обеспечения высокой пропускной способности. HBM является показательным примером * Распределенная система тесно связанных ускорителей вблизи памяти: архитектура, соединяющая несколько ускорителей, расположенных рядом с памятью, через высокоскоростные межсоединения, что позволяет каждому ускорителю обрабатывать назначенные ему данные и обмениваться только необходимыми результатами * Tesseract: исследовательская архитектура для ускорения вычислений вблизи памяти, в которой несколько ускорителей, расположенных рядом с памятью, тесно связаны через высокоскоростные межсоединения. Каждый ускоритель локально обрабатывает назначенные ему данные и взаимодействует с другими только при необходимости * Оригинальная архитектура была опубликована на 42-м международном симпозиуме ACM/IEEE по компьютерной архитектуре в 2015 году в статье под названием «A Scalable Processing-in-Memory Accelerator for Parallel Graph Processing».
В последнее время исследования также направлены на инференс LLM. Например, исследование инференса LLM на базе CXL, представленное на ASPLOS* 2025, продемонстрировало, как архитектуры расширения памяти и вычислительные блоки, расположенные вблизи памяти, могут помочь значительно снизить ограничения по емкости и пропускной способности в инфраструктуре крупномасштабного инференса (называемой дизайном CENT)*. По мере роста требований к емкости и пропускной способности памяти архитектуры, концентрирующие все вычисления исключительно на центральном GPU/NPU/TPU, сталкиваются с растущими трудностями в повышении эффективности. Такие распределенные архитектуры вблизи памяти, как дизайн CENT, которые минимизируют перемещение данных с помощью обработки вблизи памяти и эффективных и масштабируемых межсоединений интеллектуальными и инновационными способами, могут одновременно улучшить все показатели (производительность, энергопотребление, стоимость, площадь оборудования).
* ASPLOS: сокращение от Architectural Support for Programming Languages and Operating Systems, крупная международная конференция, охватывающая компьютерную архитектуру, языки программирования и операционные системы * Юфэн Гу, Алиреза Хадем, Сумант Умеш, Нин Лян, Ксавье Серво, Онур Мутлу, Рави Айер и Ритупарна Дас, «PIM Is All You Need: A CXL-Enabled GPU-Free System for Large Language Model Inference», ASPLOS 2025
Дезагрегированная архитектура* исходит из той же фундаментальной проблемы, но использует несколько иной подход. В отличие от архитектур ускорителей вблизи памяти, которые приближают вычисления к данным, дезагрегированные архитектуры организуют ресурсы CPU, GPU/NPU/TPU, памяти, хранилища и сети в общесистемный общий пул. В этой структуре необходимые ресурсы могут гибко комбинироваться в соответствии с требованиями рабочей нагрузки. Рабочие нагрузки, требующие большой емкости памяти, могут использовать расширенный пул памяти, в то время как рабочие нагрузки, производительность которых зависит от пропускной способности, могут обрабатываться ускорителями вблизи памяти. По сути, ресурсы развертываются в соответствии с требованиями рабочей нагрузки, а не подгоняются под фиксированную конфигурацию сервера. Это полностью соответствует концепции «Асимметрия повсюду» (Asymmetry Everywhere), намеченной в 2010 году для обеспечения настраиваемой, гибкой и реконфигурируемой обработки с целью максимизации энергоэффективности и производительности*.
* Дезагрегированная архитектура: архитектура, которая разделяет ресурсы, такие как CPU, GPU, память и хранилище, на системном уровне, а не фиксирует их внутри отдельных серверов, позволяя комбинировать ресурсы по мере необходимости * Онур Мутлу, «Asymmetry Everywhere(with Automatic Resource Management»), семинар CRA по развитию исследований в области компьютерной архитектуры, 2010
Данные, требующие значительной емкости памяти, такие как KV-кэш, и операции с интенсивным использованием памяти, такие как слой внимания (attention layer)*, являются типичными примерами использования этого типа архитектуры. Благодаря высокоскоростным, гибким межсоединениям и гибким конфигурациям памяти с вычислительными возможностями, эти рабочие нагрузки могут быть назначены отдельным ресурсам памяти или доменам ускорения вблизи памяти. Это снижает нагрузку на GPU/NPU/TPU по прямому извлечению и обработке всех данных, позволяя устройствам локально и эффективно выполнять вычисления и более эффективно обмениваться результатами.
Эффективность дезагрегированной архитектуры зависит от баланса между распределением ресурсов и затратами на коммуникацию. Вопросы о том, как минимизировать коммуникацию и как обеспечить эффективный поток данных внутри и между ускорителями, остаются важными, поскольку чрезмерная коммуникация может фактически увеличить задержку и энергопотребление. Поэтому крайне важно определить, какие ресурсы и рабочие нагрузки должны быть дезагрегированы, какие должны оставаться вблизи памяти и где именно должны выполняться те или иные вычисления.
* Слой внимания (Attention layer): слой в модели ИИ, который определяет, какая информация в заданном контексте должна получить больше внимания. Он играет ключевую роль в архитектуре Transformer, лежащей в основе LLM, при этом требования к использованию памяти и доступу к данным возрастают по мере увеличения длины контекста.
Конкурентоспособность инфраструктуры ИИ зависит от того, насколько быстрый и эффективный путь к данным, необходимым для вычислений, она может обеспечить. Высокоскоростные межсоединения, такие как CXL и NVLink, архитектуры ускорителей вблизи памяти, такие как Tesseract, и дезагрегированные архитектуры, которые гибко и эффективно объединяют вычислительные ресурсы и ресурсы памяти в соответствии с требованиями рабочей нагрузки, включая пулинг памяти на основе CXL и специализированную обработку вблизи памяти, — все они движутся в этом направлении. Именно поэтому крупные технологические и облачные компании продолжают активно инвестировать в архитектуру инфраструктуры ИИ. Экономика конкуренции в сфере ИИ теперь выходит за рамки приобретения большего количества вычислительных устройств и переходит к тому, насколько эффективно можно проектировать системы ИИ на всех уровнях стека, где память является первостепенным компонентом: обеспечивая эффективное использование памяти, питания, сетей, кремния и минимизируя перемещение данных для значительного повышения производительности и эффективности инференса.
Этот сдвиг превращает инфраструктуру ИИ из статической в динамическую систему. По мере роста и развития моделей, увеличения контекстов и количества вызовов инференса инфраструктура должна становиться более гибкой и эффективной. Она должна уметь выбирать подходящий путь обработки для каждой рабочей нагрузки и модели.
По мере быстрого развития системных архитектур меняется и роль памяти. Традиционно память в основном рассматривалась как устройство для хранения и предоставления данных. Однако при работе с ИИ расстояние между местом хранения данных и местом выполнения вычислений напрямую влияет на производительность и энергоэффективность. Соответственно, память быстро эволюционирует, становясь активным первостепенным компонентом для выполнения вычислений и повышения общей эффективности системы.
Недавние результаты исследований особенно интересны: они показывают, что некоторые вычисления уже возможны непосредственно внутри существующих чипов DRAM*. Изменяя способ обращения контроллера памяти* к DRAM и активируя несколько строк одновременно, системы могут выполнять масштабные (на уровне тераопераций в секунду*) побитовые операции или копирование и инициализацию данных исключительно внутри современных чипов DRAM. Эти возможности обусловлены фундаментальными принципами работы самой схемотехники DRAM. Мы называем этот подход «обработкой с использованием DRAM», поскольку для выполнения вычислений «используются» (существующие) чипы DRAM. Это недавнее открытие обширных вычислительных возможностей реальных чипов DRAM дает лишь представление — но важное — о том, как память может взять на себя более активную роль в будущих вычислительных архитектурах, и закладывает основу для внедрения новых механизмов обработки внутри DRAM в будущие чипы и стандарты DRAM.
Производительность ИИ невозможно полностью объяснить, просто сложив технические характеристики отдельных компонентов. Будущая конкурентоспособность будет все больше зависеть от того, насколько точно спроектированы системы и как выполняются вычисления в зависимости от того, где находятся данные, какие устройства выполняют вычисления и какие пути используются для обмена результатами.
* Исмаил Эмир Юксель и др., «Functionally-Complete Boolean Logic in Real DRAM Chips: Experimental Characterization and Analysis,» 30-й Международный симпозиум по высокопроизводительной компьютерной архитектуре (HPCA) (2024) * Контроллер памяти: устройство, которое управляет командами чтения и записи данных, а также таймингами между процессором и памятью * Тераоперации в секунду (TOPS): показатель пропускной способности, измеряющий количество операций, выполняемых в секунду, в триллионах. Один TOPS представляет собой один триллион операций в секунду; здесь это относится к масштабу побитовых операций, выполняемых внутри DRAM.
Узкие места в инфраструктуре ИИ возникают не только из-за отдельных компонентов, таких как GPU или память, но, прежде всего, из-за того, как распределяются вычисления и осуществляется обмен данными, то есть из-за того, как GPU/NPU/TPU, HBM, системы хранения, сети и межсоединения обмениваются данными. Основное узкое место, с которым мы сталкиваемся сегодня, — это огромные объемы перемещения данных, вызванные процессорно-ориентированной парадигмой. Высокоскоростные межсоединения, архитектуры ускорителей, расположенных рядом с памятью, и дезагрегированные архитектуры, рассмотренные выше, — это системные подходы к снижению большой нагрузки, связанной с перемещением данных.
Теперь вопрос переходит к архитектуре самих полупроводников и памяти. Если не ограничиваться просто размещением данных ближе к вычислительным устройствам, насколько еще можно сократить перемещение данных, если выполнять некоторые вычисления внутри или вокруг самой памяти?
В следующей статье будет рассмотрено, почему центр тяжести в полупроводниках для ИИ смещается в сторону памяти, с акцентом на HBM, передовую упаковку и обработку в памяти (PIM).
Отказ от ответственности: Мнения, выраженные в этой статье, принадлежат исключительно автору и не обязательно отражают официальную позицию SK hynix.