Разработка большинства агентов начинается одинаково. Вы пишете промпт, вручную тестируете несколько вопросов, вносите корректировки и повторяете всё сначала. Это отлично работает на начальном этапе, когда ошибки агента очевидны, а улучшения легко заметить. Но со временем становится всё труднее понять, улучшило ли ваше последнее изменение агента или ухудшило.
Разработка на основе оценок (Eval-driven development, EDD) решает эту проблему, предоставляя согласованный набор метрик для измерения производительности агента и принятия решений. Здесь, в LangChain, мы использовали EDD при создании наших самых продвинутых агентов (ознакомьтесь с нашим блогом об IssueBench) и свели этот подход к трехэтапному процессу:
- Определите, как выглядит идеальная работа вашего агента.
- Напишите оценку до того, как приступите к разработке.
- Внесите изменения и сравните результаты.
В этом блоге мы подробно разберем каждый шаг этого процесса, чтобы ваша команда могла применить его в собственной разработке агентов.
Что такое разработка на основе оценок?
Само название и концепция разработки на основе оценок заимствованы из разработки через тестирование (TDD), где вы пишете падающий тест перед тем, как написать код, который его пройдет. Агенты отличаются от традиционного кода тем, что они недетерминированы:
- Результаты различаются. На один и тот же вопрос при каждом запуск может быть дан разный ответ.
- Правильных ответов может быть несколько. Два результата на естественном языке могут считаться верными, несмотря на разную формулировку.
- Агент сам выбирает шаги. Он может вызвать ненужный инструмент или пропустить тот, который следовало использовать, и все равно прийти к правильному ответу.
В результате агентам нужен другой тип тестирования. Оценка справляется с этим, оценивая запуски вашего агента на основе набора примеров. Оценки более гибкие, чем традиционное тестирование. Вы можете оценить любой аспект работы агента и использовать другие LLM для выставления оценок (LLM-судья).
С помощью EDD, аналогично TDD, эти оценки становятся вашим определением успеха, и вы создаете агента, ориентируясь на них.
Шаг 1. Определите, как выглядит идеальная работа вашего агента
Первый шаг в EDD — определить, что должен делать ваш агент. Затем перечислите типы поведения, с которыми он должен справляться для достижения этой цели. Это могут быть такие задачи, как ответы на вопросы из базы знаний, выполнение действий от имени пользователя или понимание того, когда нужно задать уточняющий вопрос. Запишите требования для каждого типа поведения. Все вместе они составляют документ с требованиями к продукту (PRD) для вашего агента.
EDD работает с одним типом поведения за раз. Это дает вам узкую цель для улучшения, исключая ситуацию, когда одно изменение размывает эффект от другого. Выбираемое поведение обычно продиктовано функцией, которую вы собираетесь создать, или сбоем, обнаруженным в прошлых запусках агента. Перед написанием кода полезно определить краткую спецификацию, которая охватывает:
- Когда должно происходить определенное поведение
- Что агент должен делать
- Чего агент не должен делать
- Какие виды поведения из вашего PRD должны продолжать работать
Спецификация должна быть достаточно определенной, чтобы ее можно было оценить как «пройдено» или «не пройдено».
Допустим, у нас есть внутренний агент по документации, к которому сотрудники обращаются за корпоративной информацией. У него есть два инструмента: search_docs для внутренней документации и web_search для всего остального. Мы планируем добавить инструмент create_ticket, чтобы он мог регистрировать заявки в ИТ-отдел. Наша спецификация выглядит следующим образом:
- Когда: Пользователь сообщает о поломке, например: «Мой ноутбук не подключается к VPN».
- Сделать: Вызвать create_ticket.
- Не делать: Создавать заявку на вопросы из разряда «как сделать», например: «Как мне подключиться к VPN?»
- Сохранить работоспособность: search_docs и web_search по-прежнему должны обрабатывать те же вопросы, что и раньше
Мы будем оценивать систему по этим критериям, даже если у агента пока нет соответствующих возможностей.
Шаг 2. Напишите оценку до того, как приступить к разработке
Создайте набор данных. Набор данных — это коллекция тестовых случаев (называемых «примерами»), которые имеют входные данные и, при необходимости, эталонные («золотые») результаты. Одним из лучших источников входных данных являются реальные запуски агента. Пользователи могут формулировать мысли непредсказуемым для вас образом, а их запросы содержат краевые случаи, которые вы бы вряд ли додумались написать сами. Если ваши примеры похожи на реальный трафик, высокая оценка на тестировании с большей вероятностью означает хорошее поведение в продакшене. В LangSmith вы можете напрямую добавлять реальные запуски агентов в набор данных. Если у вас еще нет запусков, распространенной альтернативой является создание примеров с нуля.
Для нашего агента по документации набора из нескольких примеров будет достаточно для начала. В наш набор данных мы включим запросы на создание тикетов, а также вопросы, которые по-прежнему должны направляться в search_docs и web_search, чтобы учесть существующее поведение.
Вы также можете расширить свой набор данных, чтобы охватить случаи, которых в нем еще нет. Допустим, у нас мало примеров с разочарованными пользователями. Мы могли бы передать наши существующие примеры в LLM, попросить ее переписать их в виде более агрессивных сообщений и проверить, что агент все равно вызывает правильный инструмент.
Напишите оценщик. Как только у вас появится набор данных, вы можете взять определение «хорошего» из своего PRD и превратить его в тест или оценку, которая оценивает производительность вашего агента на ваших примерах. При написании оценщика выберите метод подсчета баллов, который лучше всего подходит для вашего теста. Используйте оценку кодом (code eval), когда проверка детерминирована, и LLM-в-роли-судьи (LLM-as-a-judge), когда это не так. Хотите ли вы изучить окончательный ответ агента, действие, которое он предпринял для его достижения, или что-то совершенно другое? Для нашего агента по документации мы хотим изучить инструменты, которые он вызывает, чтобы убедиться, что он использует правильные в каждом случае. Выбор инструмента легко проверить с помощью кода, поэтому мы можем использовать оценку кодом, чтобы проверить, вызвал ли каждый пример инструмент, указанный в его эталонном выводе.
Наш агент по документации — это простой чат-бот с несколькими специфическими функциями. По мере того как ваш агент становится все более сложным, ваш набор оценок, скорее всего, будет выглядеть иначе. Если ваш агент вносит изменения в окружение, например, агент-программист в песочнице (sandbox), проверки пары вызовов инструментов и финального ответа будет недостаточно. Вам необходимо проверить состояние, которое агент оставляет после себя в системе, и каждый запуск требует чистой среды, чтобы один запуск не влиял на следующий. Harbor — это фреймворк с открытым исходнымходом для запуска агентов над подобными задачами, и он является основой для таких отраслевых бенчмарков, как Terminal-Bench. Каждая задача запускается в собственной песочнице и поставляется с тестовым скриптом, который оценивает конечное состояние.
Оптимизация под такой бенчмарк, как Terminal-Bench, следует тому же циклу, что и EDD. Вы сначала пишите задачи и тесты, запускаете базовую версию (baseline) и сравниваете эксперименты по мере внесения изменений в агента. Когда мы создавали LangSmith Engine, мы сделали собственный бенчмарк как на основе реальных, так и синтетических запусков агентов и запустили его в качестве оценки Harbor. Мы также используем Harbor для бенчмаркинга Deep Agents. Это позволяет нам узнать, можем ли мы удалить части обвязки, такие как middleware со списком дел (todo-list) или части системного промпта, не ухудшая работу агента.
Запустите базовый прогон. Независимо от того, как вы решите сформировать свой набор данных или оценщик, вы можете запустить вашего агента на каждом примере и записать результаты в качестве эксперимента в LangSmith. Эксперимент представляет собой один прогон вашего агента на наборе данных, при котором входные данные, выходные данные и оценки оценщика для каждого примера сохраняются вместе в одной записи. Наличие централизованной системы позволяет сравнивать результаты разных версий агента друг с другом. Перед внесением любых изменений в вашего агента важно запустить базовый эксперимент в качестве метрики для сравнения.
В нашем агенте для документации примеры тикетов в наборе данных получают неудовлетворительную оценку, поскольку этот инструмент еще не существует. Остальные примеры фиксируют то, что уже работает, поэтому позже вы сможете определить, не приведет ли добавление нового инструмента к поломке чего-либо еще.
Шаг 3. Внесите изменения и сравните
Теперь мы создаем инструмент create_ticket и запускаем ту же оценку.
Помните, что EDD предполагает «подъем к вершине» (hill-climbing) в направлении оценки. Подъем к вершине означает повторяющийся процесс улучшения агента (оценку, сравнение и настройку), позволяющий выстроить четкий цикл с объективными доказательствами улучшений. Каждое последующее изменение агента получает собственный эксперимент, и каждый эксперимент сравнивается с предыдущим для проверки прогресса. В LangSmith вы можете открыть режим сравнения, выбрав оба эксперимента. В нем оценки отображаются рядом для каждого примера, поэтому вы можете видеть, какие из них улучшились, а какие ухудшились.
При сравнении экспериментов важно следить не только за изменениями средней оценки, но и за любыми регрессиями или перезаписью работающего поведения. В случае с нашим агентом документации примеры тикетов теперь проходят проверку. Но запрос «Как подключиться к VPN?» теперь создает тикет вместо поиска по документации. Средняя оценка выросла, но один сценарий сломался.
Просмотр трассировки — лучший способ понять, почему оценка не удалась. Трассировка представляет собой запись одного прогона вашего агента, включая каждый вызов модели и вызов инструмента. Трассировка в LangSmith возможна с любым агентом, созданным с использованием выбранного вами фреймворца. Дополнительную информацию см. в нашем руководстве по быстрому старту трассировки.
Когда мы открываем неудачную трассировку для последнего эксперимента, мы видим, что в описании инструмента указано использовать create_ticket для «проблем с VPN и ноутбуком», поэтому любой вопрос, в котором упоминается VPN, совпадает. Это перезаписывает исходное корректное поведение.
Решение заключается в том, чтобы сузить описание инструмента до запросов, требующих вмешательства ИТ-отдела. После реализации этого изменения мы снова запускаем оценку. Теперь каждый пример проходит проверку.
Идеальная оценка на небольшом наборе данных — хороший знак, но 100% не всегда является правильной целью. Мы настраивали описание инструмента, глядя именно на эти примеры. Если вы продолжите настраивать агента до тех пор, пока каждый пример не начнет проходить проверку, он может начать переобучаться (overfitting) под ваш набор данных вместо того поведения, которое вам действительно важно. Он проходит вашу оценку, но все равно пропускает запросы, сформулированные иначе, чем в ваших примерах. Чтобы проверить это, держите отложенный (held-out) набор примеров, на которые вы не смотрите в процессе итераций. Если ваша оценка растет на примерах, по которым вы проводите настройку, но остается прежней на отложенном наборе, скорее всего, происходит переобучение.
Многошаговые агенты могут давать сбой на любом этапе, поэтому LangSmith позволяет оценивать не только финальный ответ. Вы можете оценить отдельный шаг, всю последовательность вызовов инструментов или многошаговый диалог, объединенный в поток.
Поддерживайте работу EDD по мере выпуска релизов
Автоматизация оценок
По мере того как вы начинаете быстрее развертывать изменения, легко забыть запустить оценки или упустить из виду старые примеры. Добавив автоматизированную оценку в свой рабочий процесс, вы сможете предотвратить попадание не протестированных изменений к пользователям и выявить регрессии еще до передачи в продакшн.
Лучшая стратегия создания набора оценок зависит от вашей конкретной инфраструктуры. Быстрые проверки кода могут заблокировать неудачное слияние, в то время как более медленные оценки с использованием LLM в качестве судей могут запускаться каждую ночь или перед релизом. Используйте разбиения наборов данных, чтобы запускать во время итераций только примеры для той функции, над которой вы работаете, а затем полный набор перед выпуском.
LangSmith интегрируется с pytest и Vitest, поэтому ваши оценки могут располагаться рядом с вашим кодом и запускаться при каждом запросе на слияние (pull request). Каждый запуск записывается как эксперимент, поэтому вы можете просматривать результаты в том же месте, что и все остальное.
Оценка в продакшне
Перед развертыванием агента ваш набор данных, скорее всего, охватывает только те случаи, которые вы додумались протестировать в процессе разработки. В продакшне вы можете отмечать остальные с помощью следующих методов оценки:
- Онлайн-оценщики оценивают живые трассировки по мере их поступления. Вы можете прикреплять проверки кода и судей на базе LLM к проекту трассировки и выборочно обрабатывать часть трафика для оптимизации затрат.
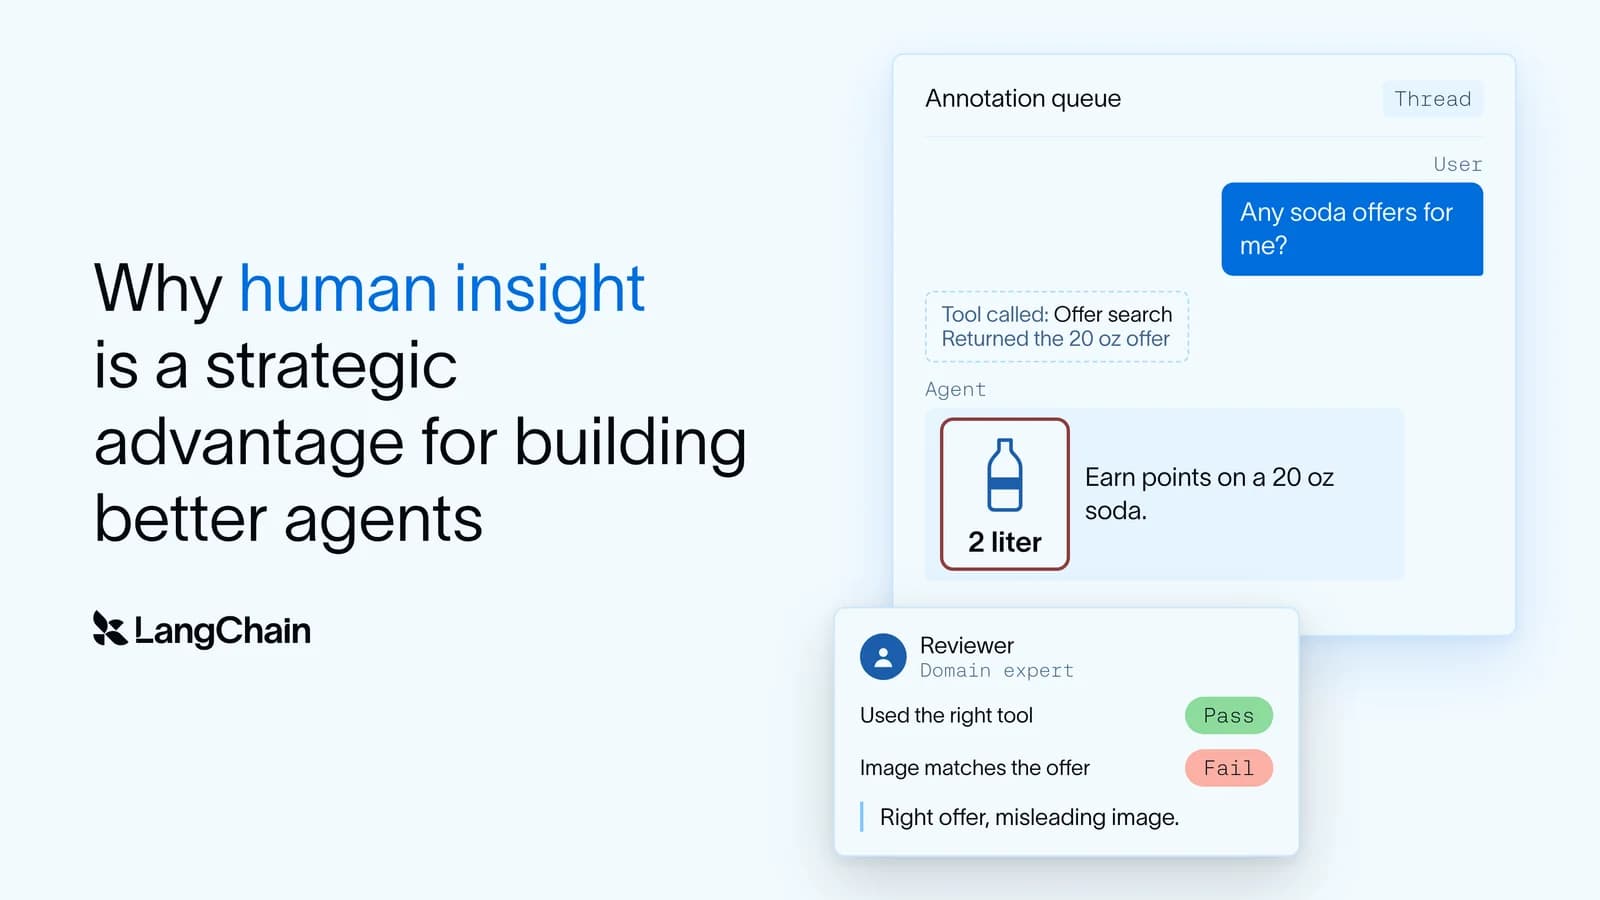
- Очереди аннотаций позволяют вашей команде вручную проверять помеченные прогоны. Они также используются для того, чтобы убедиться, что судья на базе LLM согласен с людьми, прежде чем полагаться на него.
- Панели мониторинга могут отслеживать оценки, отзывы, стоимость и задержку с течением времени, позволяя увидеть, улучшил ли релиз ситуацию или ухудшил.
- Аналитика объединяет трассировки из продакшна в кластеры, что позволяет выявлять новые закономерности среди тысяч прогонов.
- LangSmith Engine идет еще дальше и превращает кластеры проблем в примеры наборов данных с утверждениями (assertions) для вашей проверки.
Мы также опубликовали оценки, которые используем для Deep Agents, в их репозитории, чтобы вы могли увидеть реальный набор оценок для продакшна.
Распространенные ошибки
- Слишком вольное определение успешности. Проделайте сложную предварительную работу, чтобы четко определить успех, чтобы оценки могли легко фиксировать прохождение или сбой. «Ответ полезен» — это нечеткая метрика.
- Написание оценки после исправления. Увидев новый вывод, легко написать оценку, которая заведомо проходит проверку. Напишите ее сначала и убедитесь, что она дает сбой на текущей сломанной версии.
- Проверка только средней оценки. Улучшения средней оценки могут скрывать примеры, в которых произошла регрессия, или изменения, которые стерли хорошее поведение. Проверяйте каждый пример, прежде чем принять решение сохранить изменения.
- Добавление ненужных оценок. Каждая оценка подталкивает агента в определенном направлении. Привязывайте каждую оценку к конкретному изменению, например к устраняемой ошибке или функции, которую вы собираетесь создать.
- Доверие непроверенному судье. Сначала сравните вашего судью на базе LLM с оценками людей. Задавайте ему узкие вопросы и используйте «пройдено» или «не пройдено» вместо двусмысленной шкалы от 1 до 10.
Дополнительную информацию о создании оценок для агентов см. в этом вебинаре по Agent Evals 101 и на нашем бесплатном курсе LangChain Academy по LangSmith!
Дополнительные материалы для чтения:
- Самые частые вопросы об оценках агентов с ответами
- Как мы создаем оценки для Deep Agents
- На пути к автоматизации проектирования оценок
- Быстрый старт оценки в LangSmith