Браузерные агенты теперь могут выполнять многоэтапные задачи, которые для людей являются сложными и отнимают много времени. Персональные агенты, такие как Instinct и Muse от Meta, планируют автомобильные поездки по всей стране, отменяют неиспользуемые подписки и выставляют автомобили на продажу — и всё это на сайтах без публичных API. В сентябре DataDome зафиксировал рост агентских запросов к браузеру в 4,7 раза.
Использование браузера помогает в двух случаях: для выполнения действий, которые не поддерживает API (например, работа с сайтом, для которого агент не был предназначен), и для сквозного (end-to-end) тестирования веб-приложений, создаваемых агентами-кодерами. В любом случае агенту необходимы две вещи:
- Инструменты для управления браузером: открытие страниц, их чтение и выполнение действий на них. Большинство наборов инструментов управляют браузером через Chrome DevTools Protocol (CDP) — протокол, позволяющий инструментам инспектировать Chrome и управлять им.
- Браузер под управлением, локальный или размещенный на хостинге. Managed Deep Agents позволяет создавать и развертывать агентов в LangSmith без управления инфраструктурой, а также запускать браузер для вашего агента (подробнее в нашей статье о запуске). Провайдер хостинговых браузеров, такой как Browserbase, берет на себя сложную работу с открытым вебом, включая CAPTCHA, блокировки ботов и запуск множества браузеров в масштабе.
Эта статья посвящена инструментам и тому, как сделать их достаточно качественными, чтобы агент эффективно использовал браузер.
Мы решили добавить браузер в агентов в Managed Deep Agents. Мы сравнили семь наборов инструментов и выбрали лучший — Stagehand (GitHub) от . Затем мы улучшили его на основе поведения агентов в трейсах LangSmith и проверили каждое изменение с помощью оценок (evals). Главный вывод заключается в том, насколько сильно можно улучшить агента за счет проектирования инструментов.
Использование браузера создает проблемы с управлением контекстом
Инструменты для работы с браузером бывают нескольких видов: нативные инструменты, сервер MCP или CLI, который агент запускает в оболочке. Использование браузера ставит перед этими инструментами две уникальные задачи:
- Задачи выполняются долго и включают множество последовательных вызовов инструментов. В Playwright MCP выполнение одной задачи WebVoyager занимало в среднем 26 шагов модели.
- Веб-страницы содержат много контента, и лишь малая его доля обычно относится к делу. Одно обращение к хостинговому MCP-серверу Browserbase возвращает в среднем около 17 000 символов.
Все это означает, что браузерные инструменты должны эффективно управлять контекстом.
Как мы тестировали инструменты
Мы проводили итерации в рамках жизненного цикла разработки агентов: запускали агента на бенчмарке, читали его трейсы в LangSmith, чтобы увидеть, где он тратит лишние шаги или токеновые ресурсы, изменяли инструмент и запускали оценки, чтобы убедиться в эффективности изменения. Каждый запуск представлял собой эксперимент в LangSmith, поэтому мы могли сравнивать настройки бок о бок и переходить из любого числа в соответствующий трейс.
Мы использовали три бенчмарка задач на живых сайтах:
- WebVoyager: 100 повседневных задач на популярных сайтах, таких как Allrecipes, Amazon и Google Flights, запущенных с Claude Sonnet 5.5 и оцененных судьей Jev. Бенчмарк довольно насыщенный, что делает его удобным способом сравнения использования контекста, стоимости и скорости.
- HardBench: 102 более сложные задачи от Browserbase, оцененные собственным верификатором и запущенные в основном с Claude Opus 5.5.
- WebTailBench: реальные «хвостовые» задачи от Microsoft, каждая из которых оценивалась по краткой шкале. Мы запустили 150 таких задач через оценки Stagehand.
Мы настроили все тестовые окружения так, чтобы они возвращали структурированный вывод (ответ в формате JSON). Благодаря этому сбой форматирования (например, однострочный ответ на задачу, требующую таблицу) не ухудшал показатели просмотра веб-страниц. Мы upstreamed эту опцию для оценок Browserbase.
Проектирование инструментов... имеет решающее значение
Сначала мы зафиксировали модель и задачи, меняя только набор инструментов. Семь наборов инструментов различаются тем, как агент вызывает их:
- Нативные инструменты: по одному инструменту на каждое действие (например, клик или переход), которые вызываются по очереди (Playwright MCP, browser-use и Browserbase MCP).
- CLI: агент выполняет команды браузера в командной строке (agent-browser и браузерный CLI Browserbase).
- Режим кода (Code mode): агент пишет код, который управляет браузером, поэтому один вызов может выполнять множество шагов (инструменты Stagehand и вызовы Browserbase MCP из кода).
Каждый набор инструментов справился с 78%–90% задач, но стоимость и скорость существенно различались. Инструменты Stagehand показали лучший результат (90%) при общей стоимости $1.98 и медианном времени 17,4 с на задачу. Playwright MCP справился с 78% задач при стоимости $26.71 (примерно в 13 раз дороже) и выполнял каждую задачу в три раза дольше (полные результаты).
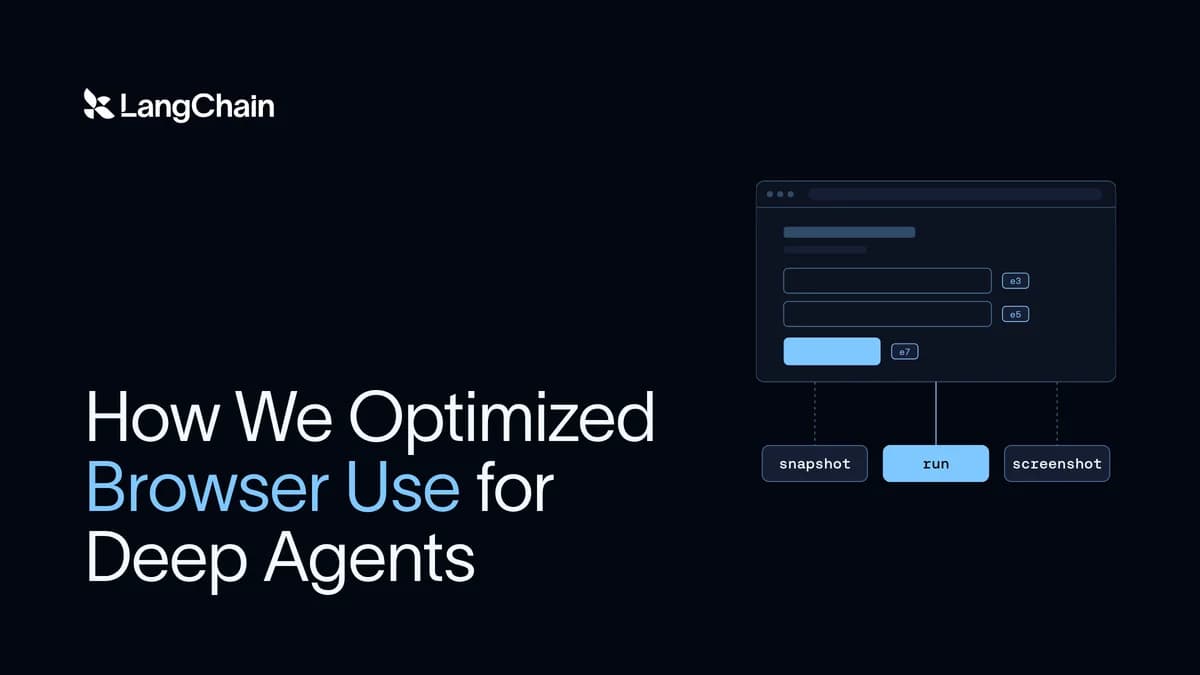
Stagehand предоставляет агенту три инструмента:
- snapshot считывает дерево доступности (accessibility tree) страницы и помечает интерактивные элементы идентификаторами.
- run выполняет действия на странице либо пакетом команд (например, клик и ввод текста), либо с помощью JavaScript, использующего объект страницы в стиле Playwright.
- screenshot делает снимок отрендеренной страницы.
Этот разрыв сохранился и на более сложных задачах. Из 38 основных задач HardBench агенты Deep Agents успешно решили 30 с помощью инструмента написания кода run от Stagehand и 21 с помощью браузерного CLI от Browserbase, при этом стоимость одной задачи оказалась втрое выше.
Stagehand создан специально для агентов
Ранние инструменты для браузера переиспользовали SDK для тестирования, такие как Playwright. Как отмечают в Browserbase, "Playwright was built for testing, we built Stagehand for your agent." Три архитектурных решения Browserbase Stagehand v4 announcement оказались наиболее важными для нас:
- Режим кода, позволяющий одному вызову инструмента выполнять множество шагов в браузере.
- Снимки (snapshots) — компактное текстовое представление интерактивных элементов страницы.
- Меньшее количество обращений (round trips) благодаря выполнению кода внутри браузера.
Режим кода позволяет экономить контекст
В режиме кода агент пишет код, вызывающий инструменты, вместо того чтобы вызывать их по одному (Browserbase обосновывает это в статьях Code mode is all you need и Evolving computer use with code). Это решает обе проблемы:
- Отсутствие необходимости ждать модель между вызовами. Шаги в браузере выполняются последовательно, поэтому с помощью run агент пишет всю цепочку (открыть страницу, заполнить поле, кликнуть, проверить) в виде единого фрагмента кода, который выполняется без промежуточных решений модели между шагами.
- Промежуточный контекст не попадает в окно контекста. Все, с чем фрагмент взаимодействует в процессе, остается в его переменных, и в контекст передается только то, что агент возвращает после завершения взаимодействия с браузером.
Мы заметили этот эффект еще до того, как выбрали Stagehand. Вызовы MCP-инструментов Browserbase из кода в интерпретаторе, а не по отдельности, снизили их стоимость в 4 раза (с $17.87 до $4.52).
Инструмент run в Stagehand нативно принимает код. Он выполнял в среднем 10 шагов на задачу по сравнению с 26 у Playwright MCP, а навигация возвращала в среднем 117 символов против примерно 17 000 у хостингового инструмента навигации Browserbase.
Кроме того, run поддерживает код в стиле Playwright. Модели обучены на огромных объемах кода Playwright, поэтому именно его они пишут лучше всего, а транслятор Stagehand преобразует его в команды Stagehand. Когда мы попробовали использовать версию run, принимающую нативный API Stagehand, количество успешно решенных задач снизилось на 5,3 пункта, а стоимость одной успешной задачи выросла на 19% — даже при наличии точного описания инструмента.
Снимки представляют интерактивные элементы
Чтение страницы — одна из самых ресурсоемких задач для браузерного агента. snapshot возвращает дерево доступности страницы, обрезанное до нужных агенту частей, с идентификатором у каждого интерактивного элемента. Это дает агенту представление о странице, которое он может понимать и использовать напрямую (например, {"op": "click", "id": "0-7"} в run), избавляя его от необходимости читать сырой HTML или писать селектор для клика по кнопке. Browserbase v4 примерно на 80% эффективнее использует токены, чем Playwright.
Чтение страниц преимущественно в виде снимков состояния, а не скриншотов, дает колоссальное преимущество для инженерии контекста. Дерево представляет собой компактный текст, с которым агент может работать, в то время как скриншот — это изображение, требующее интерпретации моделью, что в наших тестах WebTailBench в среднем составляет 89 КБ на один вызов. Однако обрезку необходимо выполнять на стороне источника. Когда мы постфактум ограничили снимки 8000 символов, агенты просто запрашивали страницу повторно, и стоимость успешно выполненного задания не изменилась.
Минимизация сетевых круговых рейсов (round trips) для браузера
Один клик в Playwright — это пять вызовов CDP: прокрутка элемента в область видимости, чтение его позиции, а затем перемещение мыши, нажатие и отпускание (source). Playwright ожидает каждого ответа перед отправкой следующего, поэтому один клик требует пяти круговых рейсов между агентом и браузером. Эти издержки возрастают по мере удаления браузера от агента — будь то ноутбук, песочница или облако.
работает внутри браузера в качестве расширения, поэтому эти низкоуровневые вызовы происходят рядом со страницей, а run передает целый пакет действий за один круговой рейс. Browserbase сообщает, что в их бенчмарках v4 работает в 2 раза быстрее, чем Playwright.
Изучение других оптимизаций
Выбрав Stagehand, мы продолжили настраивать обвязку (harness). Наибольший прирост производительности дал пересмотр того, как агенты ожидают загрузки страниц.
Изучая трассировки в LangSmith, мы заметили, что агенты используют фиксированные паузы вроде page.waitForTimeout(8000) для ожидания загрузки страницы. Большинство страниц были готовы задолго до истечения таймера, поэтому агенты тратили большую часть времени каждого запуска на бездействие.
Поэтому мы изменили run так, чтобы завершать каждую паузу, как только страница остается неактивной в течение 500 мс, но не позже времени, запрошенного агентом. В ходе одного из измерений 8-секундная пауза завершилась за 0,6 с. Затем мы проверили это изменение с помощью оценочных тестов (evals). В HardBench это изменение в сочетании со структурированными ответами и тайм-аутом вызова модели сократило медианное время работы агента со 182 с до 124 с, при этом точность осталась в пределах погрешности.
С тех пор Stagehand upstreamed это исправление.
Заключение
Задачи в браузере нагружают контекст агента сильнее, чем большинство других видов работы. Наибольший прирост производительности, обнаруженный нами, обеспечили инструменты — главным образом за счет объема данных, отправляемых обратно модели, и количества шагов (turns).
Вы можете применить тот же подход к любому агенту. Поймите, какой контекст создает ваш сценарий использования, а затем проводите итерации на основе трассировок и оценок. Трассировки показывают, где агент тратит лишние шаги и токены, а оценки подсказывают, помогло ли изменение.
Это инструменты, лежащие в основе браузера в Managed Deep Agents. Предоставьте своему агенту браузер в Managed Deep Agents, которые мы запустили на прошлой неделе.
Чтобы использовать те же инструменты в open-source Deep Agents, добавьте StagehandMiddleware из langchain-stagehand к вашему агенту:
Для агентов, которые просматривают открытый веб в больших масштабах, запускайте браузер в Browserbase с помощью browserbase.launch(). В руководстве по использованию браузера описано все остальное, включая область видимости браузера и тестирование приложения в песочнице. Попробуйте их в деле и расскажите нам, что вы создали!
Благодарности
Спасибо Байхао Ваню (Baihao Wang) за руководство над работой по HardBench, которая легла в основу оптимизаций, перенесенных в основной репозиторий Stagehand, а также Шону Макгуайру (Sean McGuire), Мигелю Гонсалесу (Miguel Gonzalez) и Кайлу Чону (Kyle Jeong) из Browserbase за помощь со Stagehand.