По мере того как агенты берут на себя выполнение более длительных и сложных задач, оценка их эффективности требует выхода за рамки простого анализа финального ответа, сгенерированного ИИ. Экспертная оценка человеком играет важную роль в разработке агентов: она помогает командам определить, что собой представляет качественный результат, оценить производительность в контексте и превратить экспертное суждение в данные, стимулирующие дальнейшие улучшения.
В этом блоге мы рассматриваем три принципа эффективных рабочих процессов human-in-the-loop: определение качества на основе экспертных суждений, оценка агентов в контексте, а также превращение обратной связи от человека в пригодные для повторного использования данные оценки, которые обеспечивают непрерывное совершенствование.
Что такое трассировка агента?
Трассировка агента — это запись всего, что агент сделал за одну попытку: сообщения пользователей, ответы моделей, вызовы инструментов и промежуточные шаги. Команды используют трассировки для отладки поведения, оценки качества и принятия решений о том, что именно нужно исправить.
Часто инженер или онлайн-оценщик фиксируют трассировку, когда что-то идет не так. Эта отметка является сигналом, а не объяснением. Обычно ее недостаточно, чтобы понять, как именно нужно изменить агента.
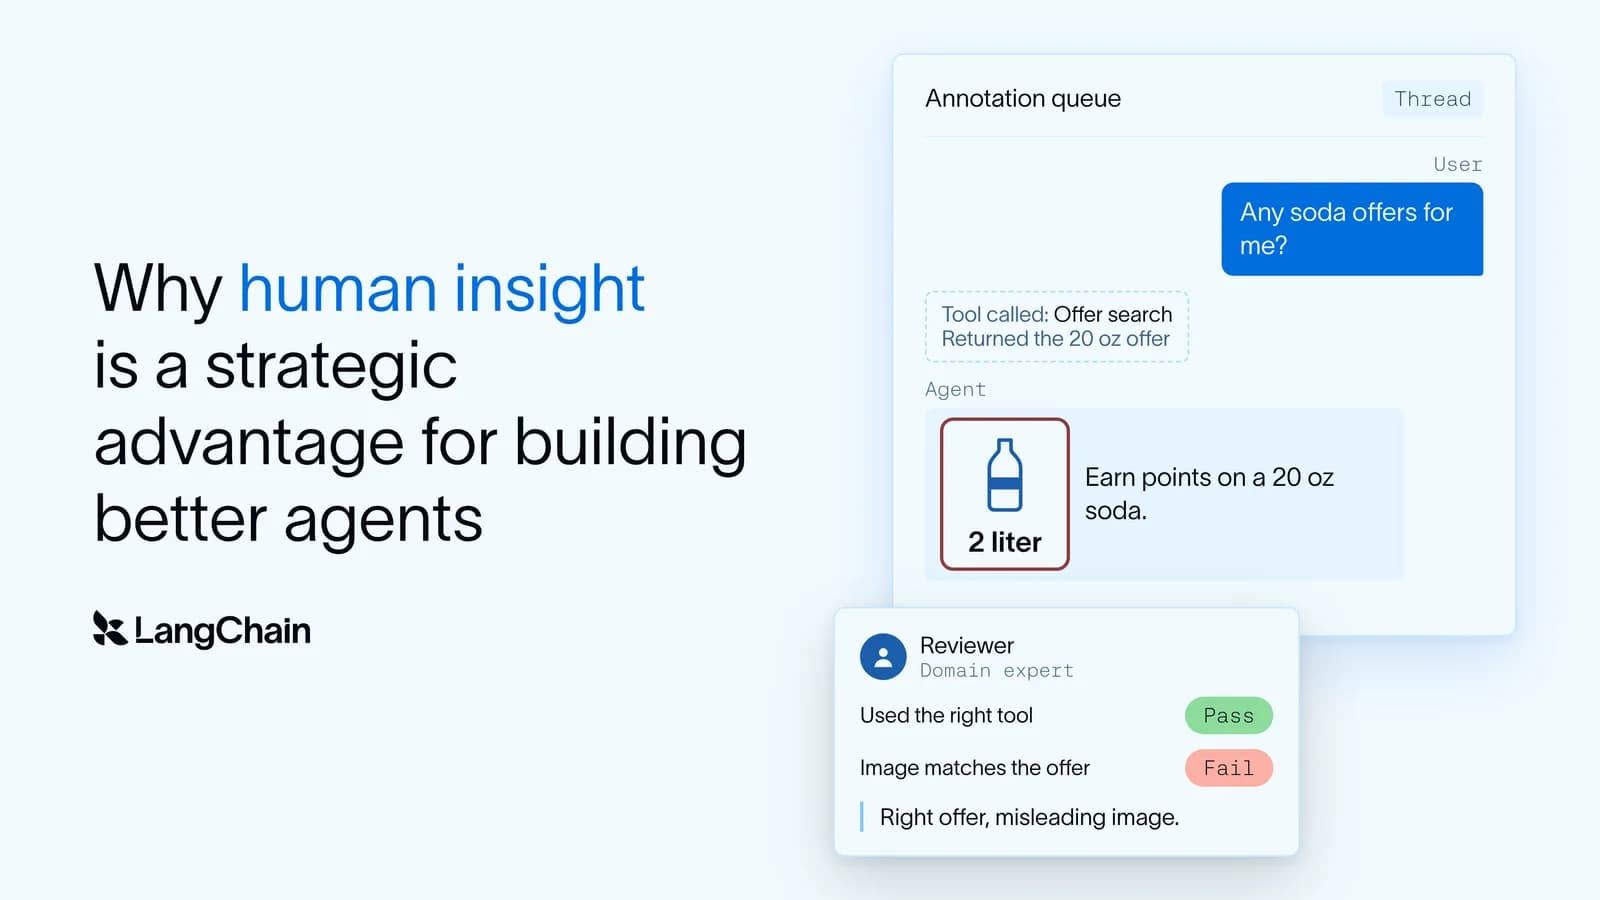
Отмеченная трассировка попадает в очередь аннотирования. Рецензент-человек открывает сеанс взаимодействия и оставляет отзыв: правильно ли поступил агент, и почему да или нет? Автоматизация выбирает, что именно подлежит проверке. Человек же обеспечивает ту самую экспертную оценку, на основе которой действуют разработчики.
В LangSmith элемент очереди может представлять собой один запуск (один шаг или интервал) или цепочку (полную многошаговую сессию). В случае с цепочкой рецензент видит всю историю общения пользователя, а не один вырванный из нее шаг.
Принцип 1: Перспектива человека определяет, что такое хороший результат
Каждый рецензент привносит предметные знания, которых нет в самой трассировке: что означает «хорошо» в данной конкретной задаче, что пытался сделать пользователь и что агент должен был сделать вместо этого. Такие экспертные суждения часто тесно связаны с конкретной компанией, ролью или опытом отдельного специалиста, и они служат ключевым элементом при создании уникальных агентов. Или, как выразился Snoop Dogg в своей приветственной речи в CSU Long Beach: «Никто не сможет быть вами так же хорошо, как вы сами».
Когда предметный эксперт анализирует трассировку, одной из самых ценных частей проверки является его обоснование. Эксперт может объяснить, почему результат был правильным или неправильным и как должен вести себя высококачественный агент.
Хотя рецензенты способны заметить то, что упускают автоматические оценки, они также выявляют проблемы, находящиеся за пределами простого ответа агента. Например, они могут обнаружить, что инструмент оценки проверяет не то поведение, или что в системе критериев есть пробел. Одна заметка в очереди может выявить более масштабную закономерность, которую стоит исправить в самом оценщике.
Эта обратная связь от эксперта меняет подходы к оценке и, в конечном счете, то, как создается агент. В очереди аннотирования эта точка зрения сохраняется для запуска или цепочки в виде оценки и пояснений рецензента, благодаря чему разработчики могут превратить единичную экспертную проверку в более четкое определение качества для следующей итерации.
Принцип 2: Контекст — это то, что позволяет суждению оставаться верным
Мнение рецензента ценно ровно настолько, насколько качественна представленная перед ним интерактивная сессия. Если он видит только один шаг из многошагового диалога, он может упустить из виду предыдущие сообщения, вызовы инструментов и решения, которые объясняют итоговый ответ. Вот почему комплексные рабочие процессы HITL предполагают просмотр всей цепочки целиком.
Цепочки в очередях аннотирования предоставляют рецензенту всю сессию полностью. Он может видеть, что пытался сделать пользователь, как агент пришел к своему ответу и насколько этот ответ обоснован. Редактирование одного предложения — это совсем не то же самое, что редактирование эссе, частью которого оно является.
Ответ может казаться правильным сам по себе, но при этом быть неверным в контексте того, что пользователь сказал ранее. Ошибка могла произойти несколько шагов назад, но проявилась она только в финальном сообщении. По мере того как агенты выполняют все более долгие задачи и совершают больше шагов, эту утерянную историю становится все труднее диагностировать вручную.
Для многошаговых агентов единицей проверки должна быть беседа. Цепочка в очереди аннотирования представляет собой такую сессию как единый элемент проверки, поэтому рецензент изучает взаимодействие целиком, а не собирает его по частям.
Принцип 3: Превратите экспертное суждение в высококачественные данные для оценки
Создание лучших агентов зависит от данных, которые отражают реальные показатели эффективности. Эксперты в предметной области (SME) задают этот стандарт, поскольку разработчики обычно не могут получить его только с помощью автоматических метрик.
Благодаря экспертной оценке этот стандарт фиксируется в форме, которую система может использовать повторно. На практике это выглядит следующим образом:
- Рецензент открывает запуск или цепочку в очереди аннотирования и оценивает его по системе критериев (прошел/не прошел, от 1 до 5, «эмпатия», «корректный инструмент» и т. д.), часто дополняя оценку кратким комментарием с обоснованием.
- Этот размеченный пример становится эталонным источником истины для данного взаимодействия: не просто «плохо», а указание на то, какое именно измерение дало сбой и как выглядел бы «хороший» результат.
- Разработчики используют эти метки несколькими конкретными способами: Настроить языкового судью (LLM judge): сравнить оценку судьи с оценкой человека на одних и тех же трассировках. В случае расхождений обновить промпт судьи или критерии оценки до тех пор, пока они не начнут совпадать чаще. Обновить онлайн-оценщики: если люди продолжают фиксировать одни и те же промахи, изменить оценщик, который должен был их обнаружить, а затем запустить его повторно на новом трафике. Создать эталонный датасет: перенести наиболее качественные размеченные человеком примеры в набор данных и проводить по ним автономные эксперименты при изменении агента или промпта.
- Настроить языкового судью (LLM judge): сравнить оценку судьи с оценкой человека на одних и тех же трассировках. В случае расхождений обновить промпт судьи или критерии оценки до тех пор, пока они не начнут совпадать чаще.
- Обновить онлайн-оценщики: если люди продолжают фиксировать одни и те же промахи, изменить оценщик, который должен был их обнаружить, а затем запустить его повторно на новом трафике.
- Создать эталонный датасет: перенести наиболее качественные размеченные человеком примеры в набор данных и проводить по ним автономные эксперименты при изменении агента или промпта.
- При следующем запуске оценка будет производиться по критериям, полученным в ходе экспертной проверки.
Когда эти данные связаны с описываемыми ими запусками и цепочками, разработчики могут использовать их для выявления сбоев, улучшения оценщиков, доработки критериев и создания датасетов для непрерывного тестирования. В результате формируется цикл обратной связи, в котором экспертные знания становятся многоразовым ресурсом для разработки агентов, а не просто оценкой в очереди на проверку.
Со временем это создает надежную основу для оценки: экспертное суждение по конкретной цепочке → структурированные оценки и примечания → лучшие оценщики и датасеты → оцененные запуски, следующие единому определению качества. Разметка служит исходным материалом для проверок, которые команда может запускать повторно, не обращаясь к эксперту каждый раз.
Почему мы создали цепочки в очередях аннотирования
Рецензент справляется со своей работой лучше, когда опирается на собственную экспертизу, имеет перед глазами весь диалог целиком и располагает удобным способом оставить отзыв, которым смогут воспользоваться разработчики. Как только агент начинает работать на протяжении множества шагов и с использованием различных инструментов, одна трассировка упускает из виду контекст, от которого зависит качество суждения.
Траектория — это альтернативный взгляд на беседу. Она отображает сообщения и вызовы инструментов в порядке их возникновения, при этом вложенное дерево запусков и прочая избыточная информация удалены для обеспечения удобства чтения. Элементом очереди по-прежнему остается цепочка, поскольку оценивается именно беседа. Рецензенты читают траекторию по мере аннотирования цепочки.
Ветки в очередчах аннотаций позволяют оставить рецензию непосредственно рядом с тем взаимодействием, которое совершил пользователь. Эксперты в предметной области могут сосредоточиться на содержимом разговора, не тратя время на изучение структуры дерева трассировки. Опробуйте эту функцию самостоятельно в LangSmith уже сегодня.
Пример из практики: Fetch Rewards
Fetch Rewards использует очереди аннотаций, чтобы превратить экспертные оценки людей в эталон для своих автоматических судей. Рецензенты оценивают отдельные шаги ИИ-ассистента Rewards Assistant (входные и выходные данные), однако стенограмма — это лишь отправная точка. Чтобы определить, является ли ответ хорошим, им часто приходится проводить дополнительное расследование. Беглый и грамотный ответ все равно может быть ошибочным, если он не опирается на реальные данные, поэтому рецензенты изучают метаданные трассировки, чтобы увидеть, какие инструменты вызывал ассистент и соответствует ли его ответ полученным результатам.
Например, когда пользователь спрашивает о каком-то предложении, они проверяют, действительно ли ассистент искал предложения и точно ли его ответ отражает возвращенное предложение. Они также сверяют изображения на карточках товаров с самими продуктами, которые те представляют: например, убеждаются, что на карточке объемом 20 унций Coca-Cola не изображена 2-литровая бутылка. Поскольку рекомендация полезна только тогда, когда получатель действительно может ею воспользоваться, рецензенты просматривают предложения пользователя, чтобы подтвердить доступность этих рекомендаций для него.
В некоторых случаях ситуация неоднозначна: изображение может быть почти правильным, предложение — технически верным, но бесполезным, а точный ответ может не соответствовать намерению пользователя. Рецензенты взвешивают все факты и документируют в комментарии к очереди аннотаций, что именно они проверили, что осталось неясным и почему они выставили ту или иную оценку. Инженеры затем используют эти рассуждения, чтобы определить, в чем логика автоматического судьи отличается от результатов проверки человеком, и соответствующим образом настраивают его.
Сделайте экспертную оценку частью жизненного цикла разработки ваших агентов
Мы ведем разработку с уверенностью, что участие человека является важной частью создания лучших агентов, и мы инвестируем в то, чтобы упростить интеграцию этого процесса в ваш рабочий процесс с помощью LangSmith.
Попробуйте оценить трассировки вашего агента с привлечением эксперта-человека. Вы можете быть удивлены теми инсайтами и полезными данными, которые удастся обнаружить! Мы будем рады услышать о ваших находках. Свяжитесь с нами в LinkedIn, чтобы поделиться своими открытиями.