Последний товар продан в магазине. Сайт все еще принимает заказы. ИИ-ассистент рекомендует самовывоз в тот же день. Один продукт. Три версии реальности.
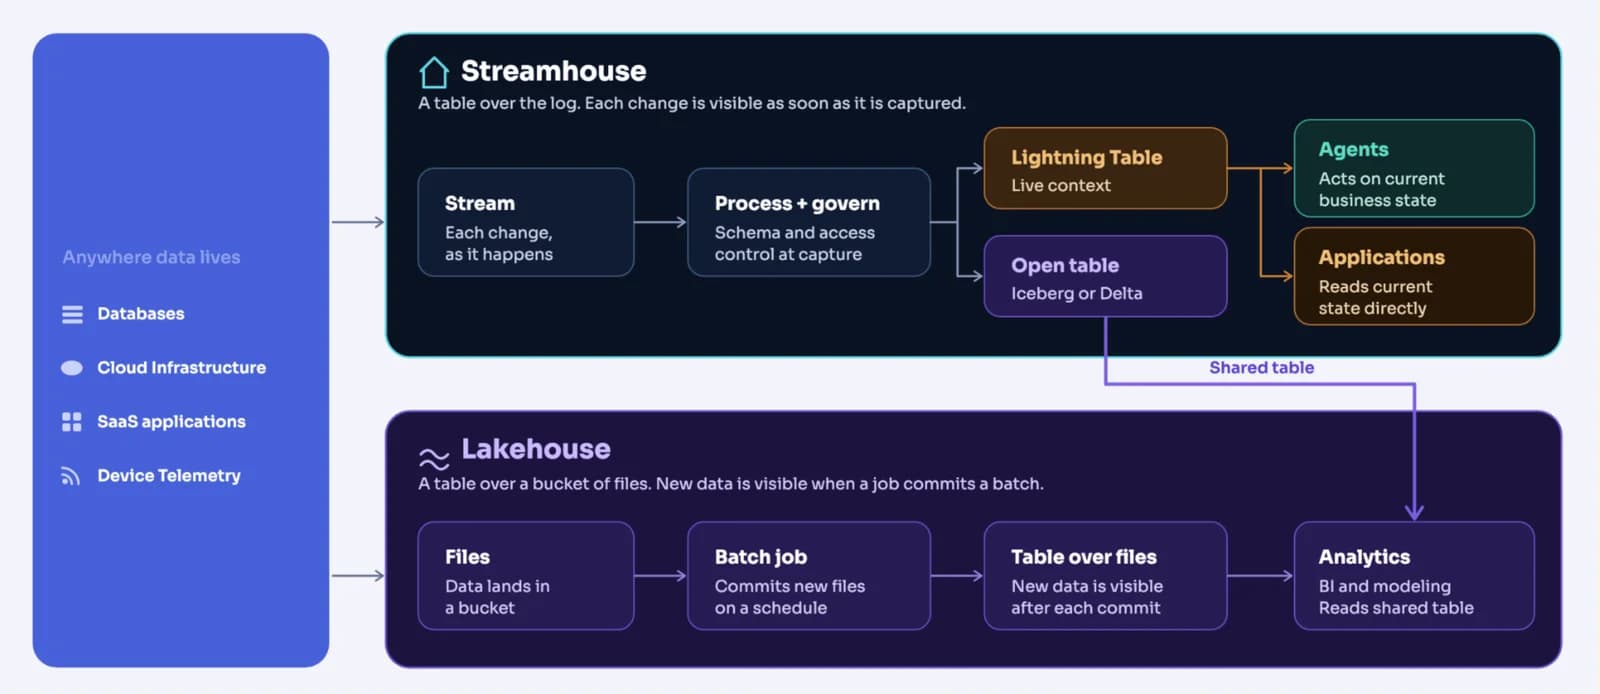
Streamhouse обеспечивает слаженную работу агентов, приложений и аналитики на основе единого актуального контекста бизнеса. Платформа потоковой передачи данных (DSP) от Confluent представляет собой наиболее полную, производительную и открытую основу для создания Streamhouse — и в этом квартале эта основа становится еще мощнее. К четырем столпам DSP (Stream, Connect, Process и Govern) присоединяется пятый — Query, который помогает командам непрерывно захватывать, обрабатывать, управлять и предоставлять надежное, всегда свежее состояние бизнеса там, где принимаются решения. В центре Query находятся таблицы Lightning Tables, которые превращают потоки Kafka в актуальное состояние бизнеса в реальном времени, позволяя агентам и приложениям запрашивать актуальные данные за миллисекунды без использования дополнительных баз данных или ETL.
Та же основа приближает ИИ к операционной деятельности бизнеса в реальном времени. Благодаря общей доступности функции Managed Model Inference команды могут быстрее начать работу без какой-либо настройки и проще создавать ИИ на основе потоковых данных. Наряду с Confluent Gateway и улучшениями Tableflow, инновации охватывают каждый столп DSP, делая создание Streamhouse проще, надежнее и эффективнее с точки зрения затрат. Ниже приведены последние новости в области ИИ, Confluent Cloud (CC), Confluent Platform (CP) и WarpStream за IV квартал 26 года.
Confluent помогает создавать полноценный Streamhouse с помощью AI, Stream, Connect, Process, Govern, Query и WarpStream.
Ключевые обновления продуктов
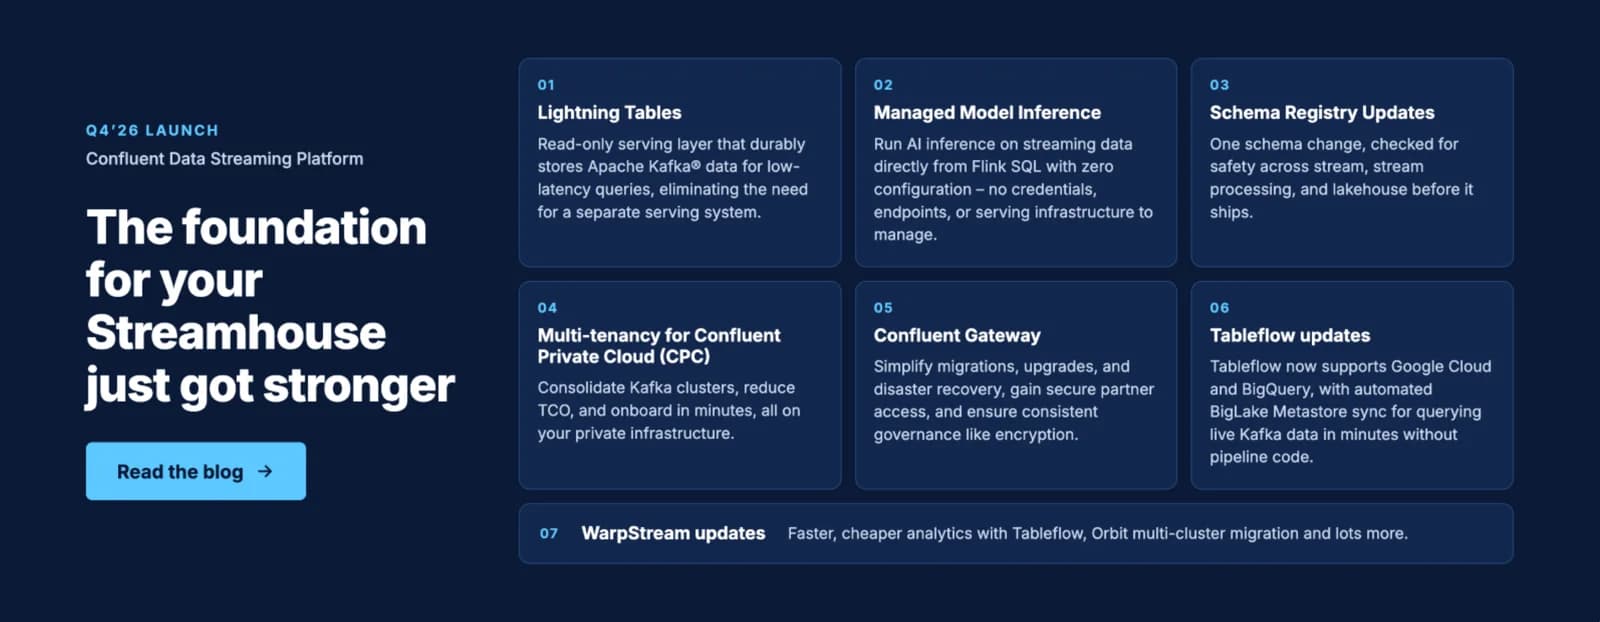
Шесть инноваций возглавляют этот выпуск, воплощая в жизнь обещание DSP стать полноценной, производительной и открытой основой, необходимой для Streamhouse.
- Lightning Tables: Lightning Tables — это полностью управляемый уровень обслуживания только для чтения, который делает данные Kafka доступными для запросов с низкой задержкой и высокой степенью параллелизма, предоставляя агентам, приложениям и аналитическим движкам свежий контекст бизнеса без отдельной базы данных обслуживания.
Lightning Tables: Lightning Tables — это полностью управляемый уровень обслуживания только для чтения, который делает данные Kafka доступными для запросов с низкой задержкой и высокой степенью параллелизма, предоставляя агентам, приложениям и аналитическим движкам свежий контекст бизнеса без отдельной базы данных обслуживания.
- Managed Model Inference: Функция нулевой конфигурации для вызова поддерживаемых моделей ИИ и МО из Flink SQL, обеспечивающая вывод в реальном времени без управления учетными данными, конечными точками или инфраструктурой обслуживания.
Managed Model Inference: Функция нулевой конфигурации для вызова поддерживаемых моделей ИИ и МО из Flink SQL, обеспечивающая вывод в реальном времени без управления учетными данными, конечными точками или инфраструктурой обслуживания.
- Обновления Schema Registry: Schema Registry превращается в базовый уровень доверия для всего вашего Streamhouse, гарантируя, что Kafka, Flink и озеро данных говорят на абсолютно одном языке. Благодаря новым логическим схемам в стиле SQL и упреждающим проверкам совместимости, он гарантирует безопасность сквозных конвейеров, выявляя и предотвращая сбои на последующих этапах задолго до отправки вашего кода.
Обновления Schema Registry: Schema Registry превращается в базовый уровень доверия для всего вашего Streamhouse, гарантируя, что Kafka, Flink и озеро данных говорят на абсолютно одном языке. Благодаря новым логическим схемам в стиле SQL и упреждающим проверкам совместимости, он гарантирует безопасность сквозных конвейеров, выявляя и предотвращая сбои на последующих этапах задолго до отправки вашего кода.
- Многоарендность для Confluent Private Cloud (CPC): консолидируйте кластеры Kafka, снижайте совокупную стоимость владения (TCO) и подключайтесь за считанные минуты, и все это на вашей частной инфраструктуре. Безопасно размещайте множество изолированных логических кластеров Kafka (LKC) на одном физическом кластере Kafka (PKC). Каждый арендатор LKC имеет собственный URL загрузчика (bootstrap URL), топики, группы потребителей, RBAC, квоты и средства наблюдения.
Многоарендность для Confluent Private Cloud (CPC): консолидируйте кластеры Kafka, снижайте совокупную стоимость владения (TCO) и подключайтесь за считанные минуты, и все это на вашей частной инфраструктуре. Безопасно размещайте множество изолированных логических кластеров Kafka (LKC) на одном физическом кластере Kafka (PKC). Каждый арендатор LKC имеет собственный URL загрузчика (bootstrap URL), топики, группы потребителей, RBAC, квоты и средства наблюдения.
- Confluent Gateway: упрощайте миграцию, обновления и аварийное восстановление, получайте безопасный доступ для партнеров и обеспечивайте единообразное управление, такое как шифрование. Получите доступ к SKU Confluent Gateway на платформах Confluent Platform, Confluent Private Cloud и Confluent Cloud.
Confluent Gateway: упрощайте миграцию, обновления и аварийное восстановления, получайте безопасный доступ для партнеров и обеспечивайте единообразное управление, такое как шифрование. Получите доступ к SKU Confluent Gateway на платформах Confluent Platform, Confluent Private Cloud и Confluent Cloud.
- Обновления Tableflow: теперь Tableflow поддерживает Google Cloud и BigQuery с автоматической синхронизацией BigLake Metastore для запросов к актуальным данным Kafka за считанные минуты без написания кода конвейеров.
Обновления Tableflow: теперь Tableflow поддерживает Google Cloud и BigQuery с автоматической синхронизацией BigLake Metastore для запросов к актуальным данным Kafka за считанные минуты без написания кода конвейеров.
ИИ: контекст в реальном времени для агентов и доступ на естественном языке к Confluent
Confluent Intelligence помогает командам создавать ИИ на основе потоковых данных в реальном времени, в то время как инструменты ИИ помогают ускорить разработку и интегрировать возможности Confluent в уже используемые ИИ-ассистенты. Обновления этого квартала укрепляют производственную основу для работы с ИИ в реальном времени.
Обновления Confluent Intelligence:
- Managed Model Inference: нулевая конфигурация позволяет выполнять вывод из Flink SQL для поддерживаемых моделей, размещенных провайдерами облачных услуг (CSP), без необходимости настройки учетных данных или конфигурации. Теперь эта функция общедоступна для больших языковых моделей (LLM) и моделей встраивания (embedding) в Amazon Bedrock, Vertex AI и Azure OpenAI. Управляемый вывод абстрагирует уровни обслуживания, учетные данные и управление оборудованием.
Managed Model Inference: нулевая конфигурация позволяет выполнять вывод из Flink SQL для поддерживаемых моделей, размещенных провайдерами облачных услуг (CSP), без необходимости настройки учетных данных или конфигурации. Теперь эта функция общедоступна для больших языковых моделей (LLM) и моделей встраивания (embedding) в Amazon Bedrock, Vertex AI и Azure OpenAI. Управляемый вывод абстрагирует уровни обслуживания, учетные данные и управление оборудованием.
- Движок контекста в реальном времени (Real-Time Context Engine): общедоступен, предоставляет свежий контекст ИИ-агентам через MCP в качестве шаблона доступа для таблиц Lightning Tables. Обновления включают использование ключей, управляемых клиентом (BYOK), используемых кластером Kafka, OAuth посредством входа в Confluent Cloud или корпоративного единого входа (SSO), видимость метрик через API в отношении объема памяти, просканированных байтов и минут CCU, а также поддержку обратно совместимых изменений схем.
Движок контекста в реальном времени (Real-Time Context Engine): общедоступен, предоставляет свежий контекст ИИ-агентам через MCP в качестве шаблона доступа для таблиц Lightning Tables. Обновления включают использование ключей, управляемых клиентом (BYOK), используемых кластером Kafka, OAuth посредством входа в Confluent Cloud или корпоративного единого входа (SSO), видимость метрик через API в отношении объема памяти, просканированных байтов и минут CCU, а также поддержку обратно совместимых изменений схем.
Инструменты ИИ: создание, эксплуатация и запросы на естественном языке
- Управляемые MCP-серверы: общедоступны для использования с ИИ-ассистентами, MCP-серверы Confluent позволяют командам исследовать среды и кластеры, проверять топики и схемы, выполнять отладку и отправлять запросы. Новые инструменты Flink SQL могут создавать, перечислять, читать и удалять выражения; отлаживать выражения; получать метрики и искать структуру таблиц. OAuth обеспечивает единый вход в Confluent Cloud — без ключа API — для глобальных и региональных MCP-серверов и движка Real-Time Context Engine. Эти инструменты искусственного интеллекта предоставляются бесплатно для пользователей Confluent Cloud, работающих с такими ассистентами, как Claude, Cursor и Copilot.
Управляемые MCP-серверы: общедоступны для использования с ИИ-ассистентами, MCP-серверы Confluent позволяют командам исследовать среды и кластеры, проверять топики и схемы, выполнять отладку и отправлять запросы. Новые инструменты Flink SQL могут создавать, перечислять, читать и удалять выражения; отлаживать выражения; получать метрики и искать структуру таблиц. OAuth обеспечивает единый вход в Confluent Cloud — без ключа API — для глобальных и региональных MCP-серверов и движка Real-Time Context Engine. Эти инструменты искусственного интеллекта предоставляются бесплатно для пользователей Confluent Cloud, работающих с такими ассистентами, как Claude, Cursor и Copilot.
- Навыки Confluent (Confluent Skills): общедоступные в качестве дополнительных плагинов для помощи в написании кода (не являются MCP-инструментами), эти управляемые рабочие процессы помогают разработчикам проектировать, создавать и отлаживать приложения Kafka Streams. Инструмент Confluent Tuning Advisor проверяет конфигурации Kafka и рекомендует настройки оптимизации, не применяя их автоматически.
Навыки Confluent (Confluent Skills): общедоступные в качестве дополнительных плагинов для помощи в написании кода (не являются MCP-инструментами), эти управляемые рабочие процессы помогают разработчикам проектировать, создавать и отлаживать приложения Kafka Streams. Инструмент Confluent Tuning Advisor проверяет конфигурации Kafka и рекомендует настройки оптимизации, не применяя их автоматически.
- Ассистент Confluent (Confluent Assistant): непосредственно в Confluent Cloud (без необходимости использования MCP или сторонних ИИ-ассистентов) этот инструмент помогает устранять неполадки в полностью управляемых коннекторах, которые перешли в состояние FAILED из-за ошибки во время выполнения. Он диагностирует первопричину, рекомендует решение и, с явного согласия пользователя, применяет исправление и проверяет, что коннектор вернулся в состояние RUNNING.
Ассистент Confluent (Confluent Assistant): непосредственно в Confluent Cloud (без необходимости использования MCP или сторонних ИИ-ассистентов) этот инструмент помогает устранять неполадки в полностью управляемых коннекторах, которые перешли в состояние FAILED из-за ошибки во время выполнения. Он диагностирует первопричину, рекомендует решение и, с явного согласия пользователя, применяет исправление и проверяет, что коннектор вернулся в состояние RUNNING.
Обновления Confluent Platform для Apache Flink AI:
Сервис локального развертывания ИИ-моделей Confluent Intelligence в CP Flink (Open Preview) позволяет запускать специализированные ИИ-модели локально (on-prem) в Confluent Platform for Apache Flink (CP Flink) без передачи данных за пределы вашей среды. Команды могут активировать готовые к промышленной эксплуатации ультралегкие специализированные ИИ-модели из курируемого каталога в Confluent Manager for Apache Flink (CMF), начиная с трех моделей временных рядов IBM Granite (TTM-R3, FlowState и PatchTST-FM). Эти модели не требуют предварительного обучения и работают исключительно на ЦП, поэтому их можно сразу применять к любым временным рядам. С легкостью реализуйте такие сценарии использования, как прогнозирование в реальном времени и обнаружение аномалий. Вызывайте их с помощью двух новых функций Flink SQL — AI_FORECAST и AI_DETECT_ANOMALIES, — либо с помощью естественного языка через блокнот SQL Assistant. В будущих выпусках каталог моделей будет расширяться.
Ассистент Confluent (NL2SQL) (Open Preview) привносит в Confluent Platform for Apache Flink (CP Flink) возможности интерактивного блокнота, позволяющие запрашивать данные Flink в реальном времени на естественном языке; опыт работы с SQL не требуется. Пользователи могут задавать бизнес-вопросы о потоковых данных в реальном времени на простом английском языке, а SQL Assistant генерирует соответствующий запрос Flink SQL, сохраняя базовый SQL видимым и доступным для контроля. Запрос и результаты отображаются вместе в ходе диалога, предоставляя пользователям удобный способ изучения живых данных. Пользователи могут задавать уточняющие вопросы, продолжать исследование с учетом контекста предыдущих сообщений и просить SQL Assistant объяснить код SQL или результаты. Опытные пользователи SQL также могут просматривать и редактировать сгенерированные выражения или писать собственный SQL в том же интерфейсе, похожем на блокнот. Каждое выражение остается видимым и доступным для выполнения через существующий путь выполнения Flink SQL.
Поток
Stream является основой Streamhouse, выступая в качестве надежной многопользовательской записи каждого изменения бизнеса, которую приложения, агенты и аналитические системы могут читать в своем собственном темпе. Одно событие заказа может обновить запасы, инициировать выполнение заказа, задействовать системы контроля мошенничества и передать данные агенту ИИ, причем производитель не должен координировать ни одно из этих действий. Streamhouse обеспечивает работу интерактивных приложений и ИИ-агентов, поэтому лежащий в его основе поток должен быть простым в освоении, управлении, мониторинге и быстро восстанавливаемым. В этом квартале Confluent реализует каждое из этих преимуществ. В Confluent Cloud вы можете беспрепятственно восстанавливаться после сбоев, мигрировать по одному топику за раз для снижения необходимости координации между командами и быстрее находить возможности платформы. На частной инфраструктуре многоарендность (multi-tenancy) в Confluent Private Cloud позволяет командам платформ запускать Kafka в качестве общего сервиса, не выбирая между изоляцией и эффективностью.
Автоматическое переключение при сбое (Automatic Failover)
Автоматическое переключение при сбое — это полностью управляемая функция аварийного восстановления (DR) в активном/пассивном режимах для Kafka в Confluent Cloud. Объединяя первичный и вторичный кластеры в пары, она позволяет операторам легко инициировать автоматическое переключение при сбое для критически важных рабочих нагрузок. Клиенты перенаправляются автоматически без изменения конечных точек или перезапуска рабочих нагрузок, в то время как репликация беспрепятственно меняет направление для возврата в исходное состояние (failback), устраняя сложную операционную рутину и обеспечивая низкие показатели RTO/RPO.
Миграция топиков без прерывания работы с помощью KCP
Миграция на основе топиков предоставляет командам платформ контролируемый пошаговый путь для переноса рабочих нагрузок Kafka в Confluent. Поддерживаемая единой конечной точкой шлюза и оркестрацией KCP, она исключает необходимость координации с командами приложений из критического пути. Это позволяет командам мигрировать и проверять рабочие нагрузки управляемыми пакетами на основе бизнес-приоритетов, кардинально минимизируя зону поражения и общие риски миграции.
Новые клиенты Kafka для Rust, Python, .NET, JavaScript и C/C++
Confluent представляет новое поколение не-Java клиентов Kafka, которые будут поддерживать паритет функций с Java-клиентом, поставляемым в Apache Kafka. Эти клиенты построены на общем ядре Rust, созданном на основе эталонной реализации Java, и предоставляют новые возможности Kafka в течение нескольких недель после их появления в Java. Они предлагают идиоматические API, улучшенную производительность и надежность.
Новая навигация и информационная архитектура
Обновленная навигация Confluent Cloud помогает пользователям быстрее находить ресурсы, делая основные объекты сразу доступными, а возможности полноценной платформы потоковой передачи данных — более простыми для обнаружения. Она включает в себя переключатель сред, по умолчанию использующий последнее рабочее пространство, и четко разделяет элементы управления администратора в главном меню и личные настройки в профиле пользователя. Эта оптимизированная, масштабируемая структура сокращает количество кликов и создает надежную основу для будущих расширений платформы.
Apache Kafka 4.4 уже доступна: более быстрое восстановление Kafka Streams, расширенные очереди и операционное укрепление
The Apache Software Foundation is releasing Apache Kafka 4.4, delivering 30 community-driven improvements to Apache Kafka. The release is led by a change that cuts Kafka Streams recovery from minutes to seconds, and by two of the most requested additions to Queues for Kafka.
Многопоточность (мультиарендность) для Confluent Private Cloud
Многопоточность для Confluent Private Cloud позволяет командам безопасно размещать множество изолированных логических кластеров (LKC) на одном физическом кластере Kafka (PKC). Каждый арендатор LKC представляет собой логический срез PKC и имеет собственный URL-адрес начальной загрузки, топики, группы потребителей, RBAC, квоты и возможности наблюдения. Благодаря многопоточности ваши команды могут объединять кластеры Kafka, снижать совокупную стоимость владения (TCO) и выполнять подключение за считанные минуты — и все это на вашей частной инфраструктуре. Для арендатора данные других арендаторов и лежащий в основе механизм изоляции невидимы, и система воспринимается как выделенный кластер. Квоты, принудительно применяемые брокером, помогают защитить арендаторов от влияния «шумных соседей».
Инновации в Confluent Control Center (C3)
- Многопоточность для CPC: Control Center эволюционирует, чтобы сделать управление частными средами Kafka еще проще. C3 теперь нативно поддерживает многопоточность CPC.
Многопоточность для CPC: Control Center эволюционирует, чтобы сделать управление частными средами Kafka еще проще. C3 теперь нативно поддерживает многопоточность CPC.
- Темный режим: теперь Control Center предлагает светлую, темную или системную темы, и вы можете переключаться между ними в любое время. Темный режим меньше утомляет глаза во время долгой работы, а стандартный светлый режим остается без изменений.
Темный режим: теперь Control Center предлагает светлую, темную или системную темы, и вы можете переключаться между ними в любое время. Темный режим меньше утомляет глаза во время долгой работы, а стандартный светлый режим остается без изменений.
- Использование собственного Prometheus: Control Center теперь может подключаться к вашему существующему развертыванию Prometheus, поэтому ему больше не нужно устанавливать и обслуживать собственный встроенный Prometheus. Команды, которые уже используют масштабируемый и высокодоступный Prometheus, могут направить на него Control Center. Это позволяет им мониторить крупные развертывания Kafka на привычной инфраструктуре Prometheus без дополнительных затрат. Это работает как для развертываний Confluent for Kubernetes, так и для Ansible.
Использование собственного Prometheus: Control Center теперь может подключаться к вашему существующему развертыванию Prometheus, поэтому ему больше не нужно устанавливать и обслуживать собственный встроенный Prometheus. Команды, которые уже используют масштабируемый и высокодоступный Prometheus, могут направить на него Control Center. Это позволяет им мониторить крупные развертывания Kafka на привычной инфраструктуре Prometheus без дополнительных затрат. Это работает как для развертываний Confluent for Kubernetes, так и для Ansible.
Обновления безопасности
- Расширенный аддон безопасности (LA): Advanced Security — это аддон корпоративного уровня для Confluent Cloud, который объединяет все расширенные средства контроля корпоративной безопасности в один пакет для всех продуктов (например, Kafka, Flink, Tableflow) независимо от уровня кластера. Вместо индивидуального управления функциями безопасности клиенты получают более согласованную систему защиты всей своей организации Confluent Cloud с меньшими эксплуатационными затратами. Функции, в настоящее время входящие в состав Advanced Security Add-on: SCIM, BYOK, повышенные лимиты IAM, прозрачность доступа в журналах аудита.
Расширенный аддон безопасности (LA): Advanced Security — это аддон корпоративного уровня для Confluent Cloud, который объединяет все расширенные средства контроля корпоративной безопасности в один пакет для всех продуктов (например, Kafka, Flink, Tableflow) независимо от уровня кластера. Вместо индивидуального управления функциями безопасности клиенты получают более согласованную систему защиты всей своей организации Confluent Cloud с меньшими эксплуатационными затратами. Функции, в настоящее время входящие в состав Advanced Security Add-on: SCIM, BYOK, повышенные лимиты IAM, прозрачность доступа в журналах аудита.
- Прозрачность доступа: Прозрачность доступа позволяет командам безопасности и комплаенса отслеживать, когда и почему персонал Confluent обращается к содержимому сообщений Kafka на выделенных кластерах в AWS, Azure и GCP. Эти подробные события, включая метки времени, затронутые кластеры и причины доступа, легко просматривать с помощью существующих интеграций ведения журналов и пользовательского интерфейса мониторинга журналов аудита.
Прозрачность доступа: Прозрачность доступа позволяет командам безопасности и комплаенса отслеживать, когда и почему персонал Confluent обращается к содержимому сообщений Kafka на выделенных кластерах в AWS, Azure и GCP. Эти подробные события, включая метки времени, затронутые кластеры и причины доступа, легко просматривать с помощью существующих интеграций ведения журналов и пользовательского интерфейса мониторинга журналов аудита.
Обработка
Потоковая обработка превращает «сырые» данные в применимые на практике бизнес-инсайты для обеспечения контекста в реальном времени. Apache Flink® обрабатывает эту рабочую нагрузку выше по потоку (Shift Left) ближе к источнику, благодаря чему приложения и AI-агенты считывают унифицированные результаты, одновременно снижая затраты на ETL на 40–60%. Этот выпуск представляет улучшения корпоративной безопасности, производительности и гибкости в Confluent Cloud для Apache Flink, а также функции искусственного интеллекта в режиме открытого предварительного просмотра для Confluent Platform.
BYOK для корпоративных кластеров (LA)
Интеграция управляемых клиентом ключей шифрования (AWS KMS, Azure Key Vault, GCP KMS) для шифрования состояния Flink и транзитных данных в состоянии покоя, обеспечивая соблюдение строгих требований суверенитета данных и политик отзыва ключей на кластерах обработки.
Поддержка CSFLE и CSPE
Flink SQL теперь может беспрепятственно обрабатывать записи Kafka, зашифрованные с помощью шифрования на стороне клиента на уровне полей (Client-Side Field-Level Encryption) и шифрования полезной нагрузки (Payload Encryption). На основе RBAC только авторизованные субъекты с правами чтения на ключи шифрования ключей (KEK) получают доступ к открытому тексту.
Потоковая начальная загрузка с пакетным выполнением (OP)
Этот новый гибридный режим выполнения автоматически запускает исторические запросы на догонку с использованием пакетных операторов с высокой пропускной способностью перед переходом к потоковой передаче с малой задержкой. Это ускоряет заполнение данных в 1,3–1,5 раза при снижении потребления CFU.
Поддержка dbt для материализованных таблиц, Tableflow, моментальных снимков (Snapshot Queries) и OAuth
Адаптер Flink dbt теперь управляет материализованными таблицами, организует синхронизацию Tableflow Iceberg, выполняет запросы моментальных снимков на определенный момент времени и выполняет аутентификацию через OAuth, позволяя инженерам данных создавать конвейеры реального времени с использованием привычных декларативных рабочих процессов.
Безлимитное хранилище состояний на AWS (LA)
За счет отделения хранилища состояний от вычислений с помощью облачного объектного хранилища Flink снимает лимит в 500 ГБ на одно выражение. Состояние соединений (stateful joins) и агрегаций теперь может масштабироваться до многотерабайтных наборов данных, сокращая время восстановления и повторного масштабирования до секунд.
SLA для выражений плоскости данных
Confluent теперь предлагает финансово обеспеченное соглашение об уровне обслуживания (SLA) по бесперебойной работе и доступности для выполнения выражений Flink, гарантируя доступность и надежность обработки для критически важных потоковых приложений.
Запрос
Новейший столп, «Запрос» (Query), представляет собой слой обслуживания: он делает текущее состояние бизнеса непосредственно пригодным для использования в любой форме, которая требуется каждому потребителю. Lightning Tables предоставляют приложениям SQL-доступ с низкими задержками к непрерывно поддерживаемым данным, в то время как Real-Time Context Engine передает актуальный бизнес-контекст ИИ-агентам через MCP. Tableflow превращает потоки в таблицы Apache Iceberg или Delta Lake для движков озер данных; Snapshot Queries выполняют нерегламентированные SQL-запросы по актуальным и историческим данным, а Streaming Queries выдают результаты по мере их изменения. Поскольку это разные способы обслуживания одного и того же потока изменений, команды могут поддерживать приложения, агентов и аналитику, не создавая отдельный конвейер данных для каждого из них.
Lightning Tables
Lightning Tables — это управляемый уровень обслуживания только для чтения, который надежно материализует данные Kafka в таблицы, доступные для запросов. Он предоставляет приложениям и агентам доступ с низкими задержками к текущему состоянию бизнеса — без использования отдельных ETL-пайплайнов, баз данных или кэшей — и общедоступен в AWS.
- Актуальность данных в масштабе: изменения доступны для обслуживания за сотни миллисекунд; запросы выполняются за 10–100 мс при скорости более 1000 запросов в секунду.
Актуальность данных в масштабе: изменения доступны для обслуживания за сотни миллисекунд; запросы выполняются за 10–100 мс при скорости более 1000 запросов в секунду.
- Несколько способов выполнения запросов: используйте SQL или API напрямую либо предоставляйте актуальный контекст ИИ-агентам с помощью Real-Time Context Engine через MCP.
Несколько способов выполнения запросов: используйте SQL или API напрямую либо предоставляйте актуальный контекст ИИ-агентам с помощью Real-Time Context Engine через MCP.
- Средства контроля для промышленной эксплуатации: Lightning Tables поддерживают BYOK, обратно совместимое развитие схем, а также метрики использования и производительности.
Средства контроля для промышленной эксплуатации: Lightning Tables поддерживают BYOK, обратно совместимое развитие схем, а также метрики использования и производительности.
Например, логистическая компания может объединить телеметрию транспортных средств, данные о погоде, трафике и посылках, чтобы ответить на вопрос: «Что происходит с нашими водителями и транспортными средствами?» на основе актуального представления об операциях, вместо того чтобы объединять разрозненные и потенциально устаревшие системы.
Это дает командам единое непрерывно обновляемое представление о состоянии бизнеса для обслуживания приложений, агентов и аналитики.
Tableflow
Интеграция с Google Cloud Platform (GCP) и BigQuery (BQ)
Tableflow в Google Cloud Platform (GCP) теперь общедоступен (GA) и обладает полной функциональной совместимостью с AWS и Azure во всех регионах GCP, поддерживающих Confluent Cloud Flink. Tableflow материализует топики Kafka в открытые табличные форматы — Apache Iceberg и Delta Lake, — устраняя необходимость в разработке пользовательских конвейеров и накладных расходах на управление схемами.
С архитектурной точки зрения организации могут хранить таблицы с использованием Confluent Managed Storage (CMS) или Bring Your Own Storage (BYOS) с бакетами Google Cloud Storage (GCS, принадлежащими клиенту) в однорегиональных или двухрегиональных конфигурациях, соответствующих региону кластера. Этот релиз представляет встроенную синхронизацию каталогов с Google BigLake Metastore (BLMS), а также с Databricks Unity Catalog и Snowflake Open Catalog. По мере потоковой передачи данных Tableflow записывает таблицы Iceberg и Delta в GCS и асинхронно регистрирует их в BLMS, обеспечивая их мгновенное обнаружение. Стандартные SQL-запросы в Google BigQuery выполняются непосредственно по потоковым данным без ручного DDL или регистрации таблиц.