Современные центры обеспечения безопасности (SOC) переходят к агентским архитектурам. Традиционно SOC полагались на жесткую автоматизацию на основе правил и значительные человеческие усилия. Мы создали агентский SOC, работающий на базе ИИ-агентов, которые не просто следуют жестким, жестко запрограммированным правилам, но и автономно расследуют, анализируют и действуют подобно аналитикам-людям.
На практике обнаружение угроз никогда не было нашим «узким местом», однако потоки оповещений с большим объемом и низкой точностью требуют огромных ручных усилий, а значит, им естественным образом уделяется меньше всего внимания. Это создает именно ту «слепую зону», в которой любят скрываться терпеливые злоумышленники. Чтобы предотвратить это, мы создали автоматизированный инструмент для расследования, а не просто средство классификации. Эта архитектура объединяет центральный координатор триажа, специализированных агентов по сбору доказательств, состязательный оценщик и самообучающуюся базу знаний.
За 30 дней наш стек обнаружения сгенерировал около 4700 оповещений. Маршрутизация на основе приоритетов направила около 3% из них дежурным специалистам. Напротив, автоматизированный конвейер проанализировал каждое оповещение, эскалировав около 5% и выявив более 250 истинно положительных результатов для проверки аналитиками.
Проблема знаменателя
Постоянно собирая сигналы безопасности и аномалии в облачных аудитах, наш стек обнаружения делал именно то, для чего был создан. Основным «узким местом» остаются возможности человека, поскольку потенциал расследования остается фиксированным, а объем оповещений неумолимо растет. Каждая команда безопасности справляется с этой реальностью одинаково: они сортируют оповещения по степени серьезности, работают вниз по очереди и игнорируют элементы с самым низким приоритетом.
Оповещения о предотвращении утечки данных (DLP) часто попадают в нерассмотренный бэклог. Поскольку эти оповещения многочисленны и по большей части безвредны, их ручная проверка редко бывает целесообразной, что дает злоумышленникам удобное место для скрытия. По мере того как корпоративные интеграции или рост организации увеличивают количество оповещений, оставление этих сигналов с низким приоритетом без внимания становится неприемлемым риском для безопасности.
Выход за рамки простой классификации
Каждый руководитель службы безопасности взвешивал стандартные варианты: нанять больше аналитиков, повысить пороги оповещений или автоматизировать процессы. Мы решили автоматизировать, но не просто прося ИИ-модель угадать, является ли оповещение вредоносным. Оповещение никогда не содержит собственного вердикта. Например, изолированный сигнал, такой как выполнение подозрительного процесса, требует глубокого контекста для разрешения. Вам нужно знать, что еще запускалось на этом хосте, каково нормальное поведение пользователя и документировал ли аналитик ранее этот шаблон как безвредный.
Этот контекст разбросан по различным инструментам безопасности и коллективной памяти команды. Следовательно, целью может быть не просто классификация, а настоящее расследование, которое формирует гипотезу и запрашивает системы для получения доказательств. Такая глубина требует нескольких минут на каждое оповещение, а не секунд, но она обеспечивает критически важное обоснование, стоящее за каждым решением.
Более интеллектуальная агентская архитектура
Интуитивно понятный подход заключается в создании отдельного ИИ-агента для каждого источника обнаружения. Хотя это быстро настраивается, это создает кошмар при обслуживании. Каждый новый источник требует нового агента, становясь постоянным бременем для вашей инженерной команды. Вместо этого мы специализировали наших агентов по доменам доказательств и рассматривали специфические особенности источников как данные, а не как код.
Основные навыки сбора доказательств стабильны, и их стоит вручную внедрять в специализированных агентов. Напротив, повседневный контекст постоянно меняется и должен находиться в динамической базе знаний, которая обновляется сама по себе. Теперь для подключения нового источника обнаружения требуется простой файл конфигурации. Через несколько оповещений база знаний автоматически изучает уникальные особенности источника, естественным образом повышая точность системы с течением времени.
Внутри процесса расследования
Наш процесс расследования структурирован так, чтобы быть эффективным и тщательным. Прежде чем запускать какие-либо ИИ-модели, мы отфильтровываем дубликаты оповещений, чтобы сэкономить ресурсы. Оставшиеся оповещения затем обогащаются существующими институциональными знаниями команды.
Центральный координатор триажа просматривает эту информацию, чтобы решить, можно ли разрешить оповещение немедленно. Если требуется дальнейшее расследование, координатор направляет специализированных агентов. Эти специалисты фокусируются на конкретных областях доказательств, таких как криминалистика конечных точек или журналы облачного аудита, что позволяет им преуспевать в своих конкретных задачах. Они выполняют глубокие запросы и возвращают координатору компактные и четкие выводы. Затем отдельный агент-оценщик проверяет полученные данные, чтобы активно искать непроверенные гипотезы или необоснованные выводы. Если существуют пробелы, дело отправляется обратно координатору для дальнейшего рассмотрения.
Наконец, система записывает полученные знания в базу знаний. Выводы встраиваются и извлекаются с помощью гибридного векторно-ключевого поиска, поэтому прошлые расследования находятся по смыслу, а не по точному совпадению формулировок. А поскольку неверная память хуже, чем ее отсутствие, записи проходят полуавтоматическую модерацию, прежде чем они смогут влиять на будущие вердикты.
Сила состязательной проверки
Самый большой скачок в качестве наших автоматизированных вердиктов произошел не благодаря лучшей модели или большему количеству инструментов. Он произошел благодаря внедрению вторичного агента, чья единственная задача — находить дыры в работе первого агента. Агенты расследования на базе ИИ часто делают поспешные выводы, которые лишь частично подтверждаются доказательствами. Хотя эти выводы звучат убедительно, они разваливаются, когда их просят доказать непроверенные гипотезы. Требуя от наших агентов прохождения этой автоматизированной экспертной оценки, мы превратили базовые мнения в строгие и надежные расследования.
Люди остаются под контролем
Автоматизация, которая безмолвно закрывает критические оповещения, является огромным риском для безопасности. По этой причине мы разработали автоматизированную систему, имеющую строгие границы. Ей разрешено автоматически закрывать только оповещения с низкой и средней степенью серьезности, которые она оценивает как полностью безвредные. Она не может заглушить ничего с высокой степенью серьезности: даже если ИИ на 100% уверен, что критическое оповещение является ложноположительным, дело остается открытым и требует подтверждения человеком. Когда человек все же вмешивается, ему предоставляется полностью сформированный тикет со всем уже завершенным расследованием, что значительно экономит время при сохранении человеческого контроля.
Отношение к оповещениям как к непрерывному потоку
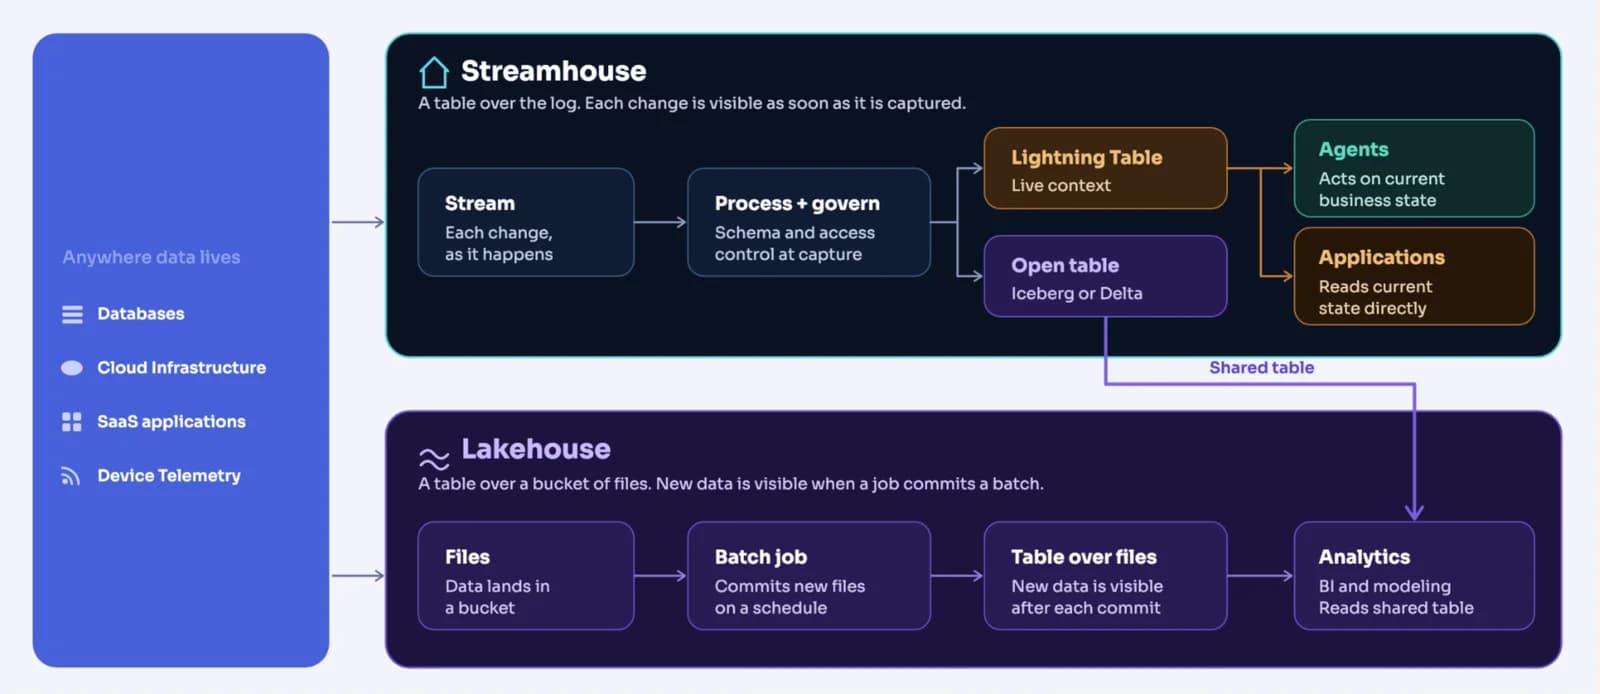
Изначально мы рассматривали нашего ИИ-агента как стандартное приложение, считывающее данные из очереди. Однако оповещения безопасности — это на самом деле непредсказуемый, непрерывный поток событий. Проблемы, такие как задержка критических оповещений из-за оповещений с низким приоритетом, по сути являются проблемами потоковой передачи данных.
Переведя наш конвейер на потоковую архитектуру, мы эффективно организовали хаос. Мы создали приоритетные полосы, чтобы критические оповещения обходили очередь, гарантируя, что объем низкоприоритетных данных никогда не монополизирует пропускную способность системы. Высокообъемная детерминированная маршрутизация построена поверх Confluent Cloud для Apache Flink®, в то время как сложная и ресурсоемкая работа по принятию решений зарезервирована для ИИ-агентов.
Замыкание цикла
Конвейер работает в обоих направлениях. Телеметрия агентов (задержка на оповещение и на модель, расход токенов и стоимость, вердикты, использование инструментов, количество циклов оценки) передается обратно в Confluent Cloud в виде отдельных тем Apache Kafka®. Real-Time Context Engine, полностью управляемая функция Confluent Intelligence, предоставляет этот оперативный контекст непосредственно AI-агентам, поэтому мы можем задавать вопросы о текущем состоянии SOC и получать ответы, основанные на событиях, произошедших несколько секунд назад, а не на данных вчерашней сборки панели мониторинга. Скачки задержки, регрессии стоимости и снижение качества выявляются, пока их еще легко исправить.
Результаты
Успех этой системы сводится к охвату. Теперь каждое оповещение проходит полное расследование, прежде чем принимается решение о его эскалации. За определенный 30-дневный период конвейер выявил более 250 истинно положительных результатов при уровне эскалации примерно в 5%, что превышает общее количество тикетов для дежурных специалистов за этот период. Это полностью изменило наш подход к обработке потоков данных, которые исторически было невозможно контролировать.
Наш штат не изменился. Вместо этого мы изменили распределение времени нашей команды: аналитики теперь тратят свои часы на критически важные расследования, которые действительно требуют человеческого суждения, в то время как огромный массив оповещений с низким приоритетом больше не остается без внимания. ИИ не заменил наших аналитиков, он расширил их возможности, превратив перегруженную очередь в четкий набор приоритетных задач.