Улучшение ИИ-агента часто связано с изменением его промптов, моделей, методов поиска или инструментов. Однако определить, действительно ли эти изменения повышают производительность, бывает непросто. Измененный промпт может давать лучшие ответы для небольшого набора тестовых примеров, но работать плохо при непредвиденных запросах пользователей. Более дешевая модель может снизить затраты на токены, но при этом привести к ошибкам вызова инструментов или увеличить время выполнения. Перед внедрением изменений командам необходимо понять, как они влияют на качество, надежность и стоимость агента в условиях реального использования.
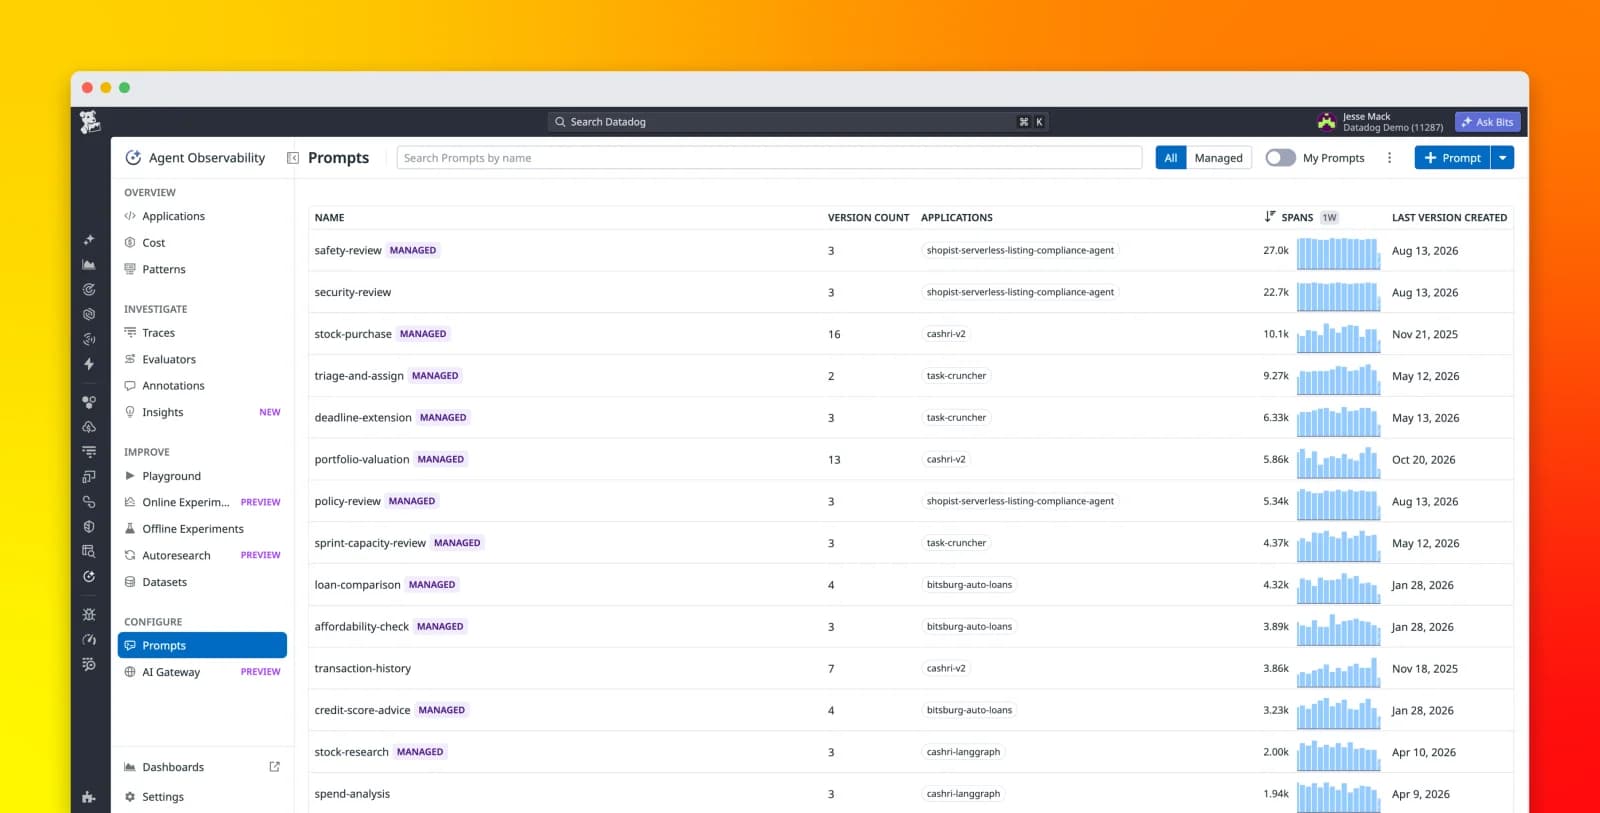
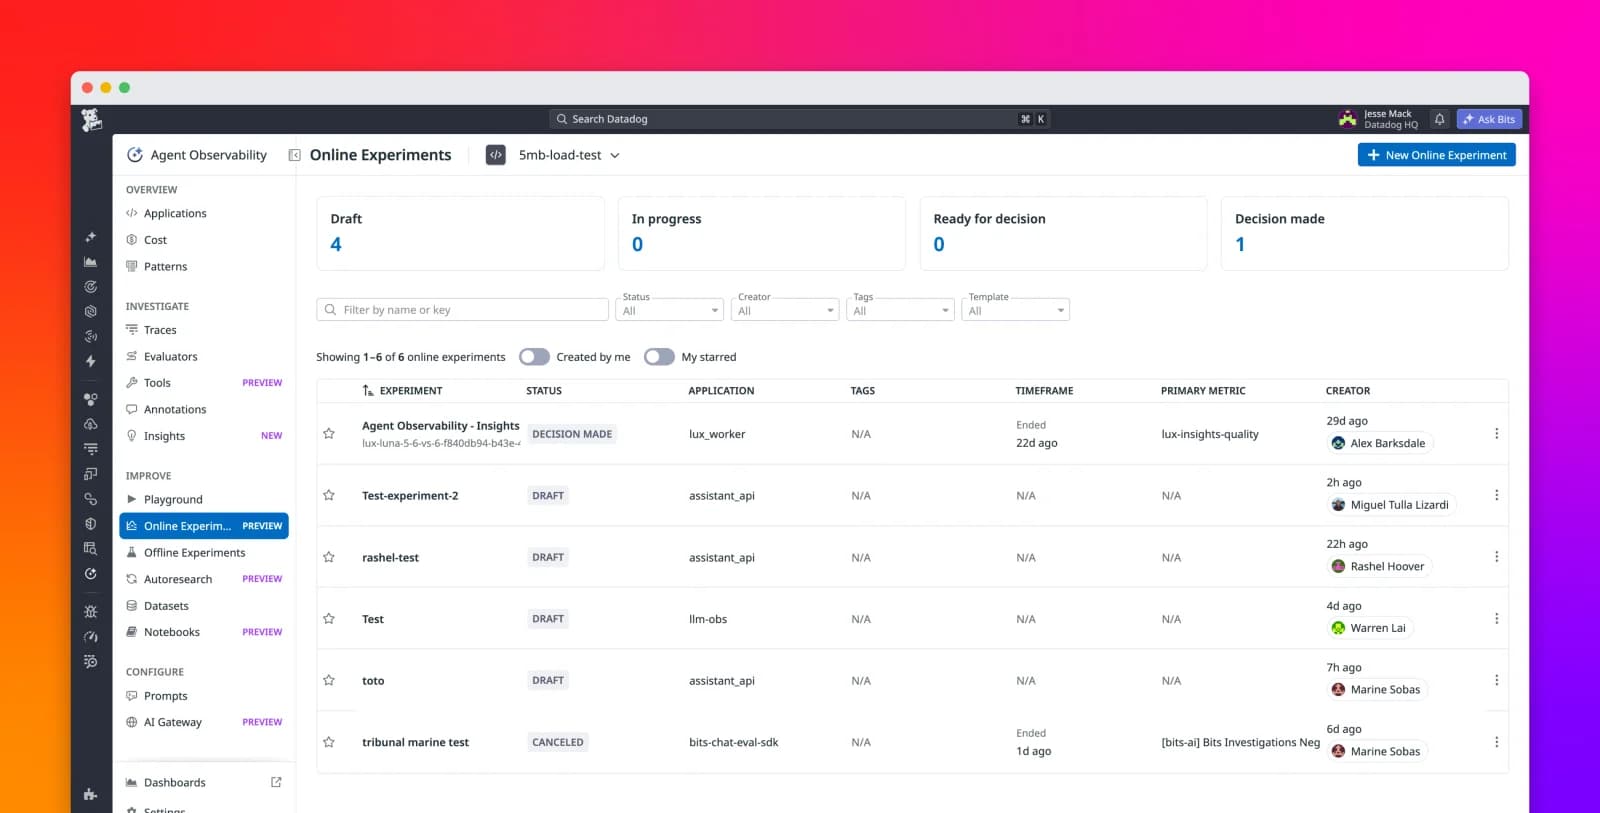
Инструмент Datadog Online Experiments, доступный в Agent Observability, позволяет командам сравнивать варианты агентов на основе реального производственного трафика и измерять влияние изменений на поведение и производительность агента. Объединяя оценку агентов с Datadog Experiments, Online Experiments помогает оценивать качество ответов наряду с такими операционными метриками, как задержка, стоимость, использование токенов и ошибки. Вы также можете исследовать базовые трейсы, чтобы понять, почему изменение в агенте привело к отклонениям в поведении.
В этой статье мы рассмотрим:
- Различия между офлайн- и онлайн-экспериментами
Различия между офлайн- и онлайн-экспериментами
- Как Datadog Online Experiments помогает сравнивать варианты агентов с использованием реального производственного трафика
Как Datadog Online Experiments помогает сравнивать варианты агентов с использованием реального производственного трафика
- Как мы использовали Online Experiments внутри компании для оценки изменений модели
Как мы использовали Online Experiments внутри компании для оценки изменений модели
Офлайн- и онлайн-эксперименты для ИИ-агентов
Офлайн-эксперименты являются неотъемлемой частью разработки агентов. Они позволяют командам запускать версии своих агентов на предварительно определенных наборах данных, сравнивать результаты и выявлять известные регрессии перед развертыванием, не дожидаясь их появления в реальном трафике. В Datadog Agent Observability офлайн-эксперименты поддерживают тестирование как отдельных компонентов, так и کاملных рабочих процессов агентов.
Однако создание комплексных наборов данных для офлайн-оценки требует времени и знаний продукта. Командам нужно выбрать репрезентативные запросы, прийти к согласию относительно того, как выглядит правильное поведение, и решить, какие проверки помогут выявить регрессию. Оценщику на базе модели требуется критерий оценки, понятный вашей команде, и человек для проверки его выводов. Эта работа продолжается по мере изменения вашего продукта: новые рабочие процессы обнажают пробелы в наборе данных, инструменты возвращают другую информацию, а оценщик, фиксирующий один тип сбоев, может пропустить другой. На ранних этапах разработки вы все еще можете находиться в процессе поиска требований, которые позволят выбрать правильные кейсы и критерии.
Онлайн-эксперименты тестируют производительность и поведение вариантов агентов на основе реальных пользовательских взаимодействий. Они опираются на онлайн-оценки, которые оценивают поведение агента в рабочей среде, а не на заранее определенные тестовые сценарии. Это позволяет сравнивать поведение различных версий вашего агента при производственных нагрузках, помогая выявлять паттерны, которые вы могли не включить в наборы данных для офлайн-оценки.
Например, рассмотрим агента поддержки, который извлекает документы для ответов на вопросы клиентов. Ваша команда может обнаружить, что его инструмент поиска часто возвращает длинные фрагменты текста, заставляя агента выполнять повторные поисковые запросы перед генерацией ответа. С помощью офлайн-оценок вы могли бы изменить инструмент так, чтобы он возвращал более короткие отрывки, и проверить, ссылается ли агент по-прежнему на релевантные доказательства. Но такие тесты могут не охватить весь спектр пользовательских запросов и не показать, помогает ли это изменение пользователям решать их проблемы.
Онлайн-оценки помогают увидеть, например, приносят ли пользователи запросы, которые ваша команда не предвидела, или задают ли они уточняющие вопросы, что позволяет лучше понять, помогает ли внесенное изменение пользователям решить их проблемы. Затем вы можете запустить онлайн-эксперименты, которые используют эти оценки для сравнения различных версий вашего агента. Вы сохраняете существующую версию в качестве контрольной и тестируете измененную версию в течение того же периода времени, используя случайное распределение для отделения эффекта ваших изменений от существующих различий в использовании (например, измененный инструмент поиска выглядит лучше, потому что на него поступают более простые вопросы). Это помогает определить, какая версия агента работает лучше всего в реальных производственных условиях, и, в свою очередь, позволяет создавать более качественные наборы данных для офлайн-оценки.
Сравнение вариантов агентов с использованием реального производственного трафика с помощью Datadog Online Experiments
Проведение онлайн-экспериментов требует от команд подключения каждого тестируемого варианта агента к соответствующим метрикам и анализа различий в производительности. Datadog Online Experiments объединяет данные Agent Observability с Datadog Experiments, чтобы помочь вам управлять этим процессом. Вы можете использовать оценщики, созданные в Agent Observability, и связывать их результаты с метриками экспериментов наряду с выбранными операционными показателями. После настройки распределения и измерений Experiments рассчитывает относительные изменения и доверительные интервалы.
Вы также выбираете степень охвата изменения. Как только варианты интегрированы в ваше приложение, Datadog Feature Flags может управлять разделением трафика и позволять регулировать охват без повторного развертывания приложения. Вы можете начать с небольшой доли пользователей, сохранив при этом контрольную группу для сравнения.
Измеряемые показатели должны отражать принимаемые вами решения. Измененный инструмент может улучшить качество доказательств, но увеличить количество дополнительных поисков. Более дешевая модель может потребовать больше попыток для выполнения задачи. Сравнение оценок с длительностью, стоимостью и ошибками помогает увидеть эти компромиссы.
По результатам экспериментов вы также можете просматривать трейсы в Agent Observability для детального изучения отдельных выполнений: какой инструмент вызвал агент, какие аргументы он передал и как отреагировал на результат. Это дает контекст, который помогает разобраться в ситуации, когда эксперимент оставляет вопросы. Например, многообещающий результат по стоимости может оправдать внедрение изменений, в то время как неопределенность относительно других эффектов требует более пристального внимания. Далее мы покажем, как мы использовали Online Experiments внутри компании Datadog для оценки именно такого типа изменений в одном из наших собственных агентов.
Как мы использовали Online Experiments для оценки изменений модели
Мы использовали Online Experiments для сравнения моделей OpenAI GPT-5.6 Luna и GPT-6 Luna в нашем агенте Insights, который исследует поведение агентов с помощью данных трейсов. Мы хотели проверить, привело ли Luna 6’s lower model prices к более дешевым расследованиям, и понять, что эти изменения означают для качества расследований и работы инструментов. Мы разделили трафик поровну между моделями, оставив Luna 5.6 в качестве эталона при оценке Luna 6 в условиях реального использования.
Нашей основной мерой было качество расследования. Судья на базе LLM оценивал расследования по шкале от 1 до 5, используя запрос, входные и выходные данные инструментов, а также выводы агента. Критерии оценивания охватывали точность, полноту и то, насколько логично выводы следовали из имеющихся доказательств, в том числе учитывалось, признавал ли агент наличие неопределенности или отсутствия данных. Мы собирали данные о продолжительности, оценочной стоимости, оценочном использовании токенов и ошибках рабочего процесса из трассировок агента в качестве отдельных метрик.
Онлайн-эксперименты объединили эти оценки и операционные показатели в единое сравнение в Agent Observability. Мы смогли оценить стоимость наряду с работой, которую агент выполнил для завершения расследования.
Оценочная стоимость Luna 6 оказалась на 44,3% ниже. Доверительный интервал — диапазон разницы, согласующийся с данными — составил от 37,5% до 51,2% снижения. Этот результат подтвердил нашу гипотезу о том, что смена модели может снизить стоимость расследования. Оценки качества были близки: 3.84 для Luna 5.6 и 3.86 для Luna 6, хотя сами по себе близкие средние значения не гарантируют эквивалентное качество.
Продолжительность и ошибки рабочего процесса оставляли больше неопределенности. Лучшие оценки показывали увеличение продолжительности на 12,8% и увеличение ошибок рабочего процесса на 13,6%. Но интервал продолжительности варьировался от снижения на 4% до увеличения на 30%, а интервал ошибок — от снижения на 16% до увеличения на 43%. Фактически это диапазон от незначительной разницы или ее отсутствия до значительного роста. Мы изучили трассировки, чтобы оценить риск, прежде чем принимать решение о дальнейших действиях.
В проанализированных нами трассировках Luna 6 передавала недействительные параметры инструментов чаще, чем Luna 5.6. Обычно она исправляла эти ошибки после повторных попыток. Наш судья качества учитывал использование инструментов, но его итоговая оценка не показывала, как часто сбоили вызовы или сколько работы требовалось для восстановления. Таким образом, мы смогли использовать трассировки для выявления конкретного поведения агента при обработке вызовов инструментов, которое можно было улучшить в версии агента на базе Luna 6. Мы устранили проблему с параметрами инструментов, обнаруженную в ходе нашего расследования, прежде чем перейти к версии Luna 6, что помогло нам снизить затраты.
Эксперимент также выявил следующие шаги, которые могут помочь нам улучшить нашего агента в будущем. Обнаруженные нами неудачные вызовы являются отличными кандидатами для автономных регрессионных тестов. Последующий онлайн-эксперимент может протестировать изменения в определениях инструментов или отчете об ошибках, продолжая измерять качество, продолжительность и стоимость.
Совершенствуйте ИИ-агентов быстрее с помощью онлайн-экспериментов в Agent Observability
Datadog Online Experiments помогает командам оценивать изменения ИИ-агентов в реальных производственных условиях, сравнивать качество и операционную производительность, а также исследовать непредвиденное поведение с помощью трассировок. Независимо от того, тестируете ли вы другую модель, оптимизируете поиск или изменяете инструмент, контролируемые эксперименты предоставляют данные, которые помогают определить, какие изменения улучшают вашего агента, а какие требуют доработки.
Результаты каждого эксперимента также могут помочь улучшить покрытие автономного тестирования. По мере того как ваша команда обнаруживает новые типы сбоев и пользовательские сценарии, вы можете превращать эти наблюдения в регрессионные тесты и использовать последующие эксперименты для оценки того, работают ли ваши исправления при реальном использовании.
Функция Online Experiments предоставляется бесплатно для клиентов Agent Observability, отправляющих до 40 000 спанов LLM в месяц. Чтобы узнать больше о начале работы с Agent Observability, см. страницу продукта и документацию.
Впервые в Datadog? Начните 14-дневную бесплатную пробную версию.
Стартап? Подходящие компании получают год бесплатных кредитов Datadog. Подайте заявку здесь.