Большинство современных организаций ведут свою деятельность в рамках двух инфраструктур. Операционная среда обслуживает повседневные потребности бизнеса: базы данных, микросервисы, приложения реального времени и потоки событий, такие как Kafka. Аналитическая среда выполняет сложные крупномасштабные агрегации исторических данных, которые обычно хранятся в хранилище данных или lakehouse.
Streamhouse находится между операционной и аналитической средами, устраняя неэффективность, присущую каждой из них. В этой статье мы сравним Streamhouse с lakehouse: что делает каждая из систем, в чем их различия и как они дополняют друг друга. Мы обратимся к реальному примеру использования Streamhouse, чтобы сделать обсуждение более предметным. В конце вы будете точно знать, когда следует выбирать Streamhouse, когда — lakehouse, а когда — обе системы.
Streamhouse непрерывно захватывает, обрабатывает и предоставляет текущее состояние бизнеса.
Что определяет Streamhouse?
Streamhouse — это архитектура, которая непрерывно захватывает, обрабатывает и предоставляет текущее состояние бизнеса. Это гарантирует, что приложения, AI-агенты и аналитика работают с самыми свежими и управляемыми данными, а не с устаревшими копиями, хранящимися в каждой системе отдельно.
Streamhouse определяется тремя свойствами:
- Всегда актуально: Данные доступны для запроса сразу после захвата породившего их события. Валидация и обогащение происходят на входе, поэтому к моменту, когда приложение или агент читают запись, эта работа уже выполнена.
Всегда актуально: Данные доступны для запроса сразу после захвата породившего их события. Валидация и обогащение происходят на входе, поэтому к моменту, когда приложение или агент читают запись, эта работа уже выполнена.
- Критически важно для бизнеса: Приложения и агенты читают данные из Streamhouse для выполнения своих задач, поэтому система должна соответствовать тем же целевым показателям времени безотказной работы, что и окружающие ее производственные системы. Сбой в Streamhouse останавливает обработку заказов. Сбой в lakehouse обычно означает задержку отчета.
Критически важно для бизнеса: Приложения и агенты читают данные из Streamhouse для выполнения своих задач, поэтому система должна соответствовать тем же целевым показателям времени безотказной работы, что и окружающие ее производственные системы. Сбой в Streamhouse останавливает обработку заказов. Сбой в lakehouse usually означает задержку отчета.
- Децентрализованность: каждое изменение фиксируется один раз и доставляется в каждую систему, которой оно необходимо, в том формате, который эта система ожидает. Микросервис может читать топик Kafka, в то время как команда аналитики читает таблицу Iceberg, и оба видят одни и те же данные. Никто не строит отдельный конвейер для каждого потребителя.
Децентрализованность: каждое изменение фиксируется один раз и доставляется в каждую систему, которой оно необходимо, в том формате, который эта система ожидает. Микросервис может читать топик Kafka, в то время как команда аналитики читает таблицу Iceberg, и оба видят одни и те же данные. Никто не строит отдельный конвейер для каждого потребителя.
Что определяет Lakehouse?
Lakehouse — это архитектура, которая хранит данные в виде файлов в объектном хранилище, таком как Amazon S3, и добавляет поверх уровень метаданных, превращающий эти файлы в таблицы, доступные для запросов, как в базе данных. Внутри lakehouse вы можете выполнять крупные исторические запросы к хранилищу вместо предварительной загрузки данных в отдельное хранилище.
Lakehouse определяется тремя свойствами:
- Открытый формат таблиц: Файлы хранятся в колоночном формате данных, таком как Parquet, в объектном хранилище. Открытые форматы таблиц, такие как Iceberg или Delta Lake, располагаются поверх них для отслеживания схемы и версионирования.
Открытый формат таблиц: Файлы хранятся в колоночном формате данных, таком как Parquet, в объектном хранилище. Открытые форматы таблиц, такие как Iceberg или Delta Lake, располагаются поверх них для отслеживания схемы и версионирования.
- ACID-транзакции: Уровень метаданных обеспечивает ACID-транзакции и соблюдение схем. Параллельные записи и изменения схем не повреждают файлы данных и не влияют на потребителей.
ACID-транзакции: Уровень метаданных обеспечивает ACID-транзакции и соблюдение схем. Параллельные записи и изменения схем не повреждают файлы данных и не влияют на потребителей.
- Пакетная обработка: Данные следуют медальонной архитектуре (слои bronze, silver и gold), переходя от «сырых» к очищенным и готовым для бизнеса данным. Эти пакетные процессы выполняются для больших объемов данных по расписанию — от каждой минуты до раза в месяц, а не реагируют в режиме реального времени.
Пакетная обработка: Данные следуют медальонной архитектуре (слои bronze, silver и gold), переходя от «сырых» к очищенным и готовым для бизнеса данным. Эти пакетные процессы выполняются для больших объемов данных по расписанию — от каждой минуты до раза в месяц, а не реагируют в режиме реального времени.
В чем их различия
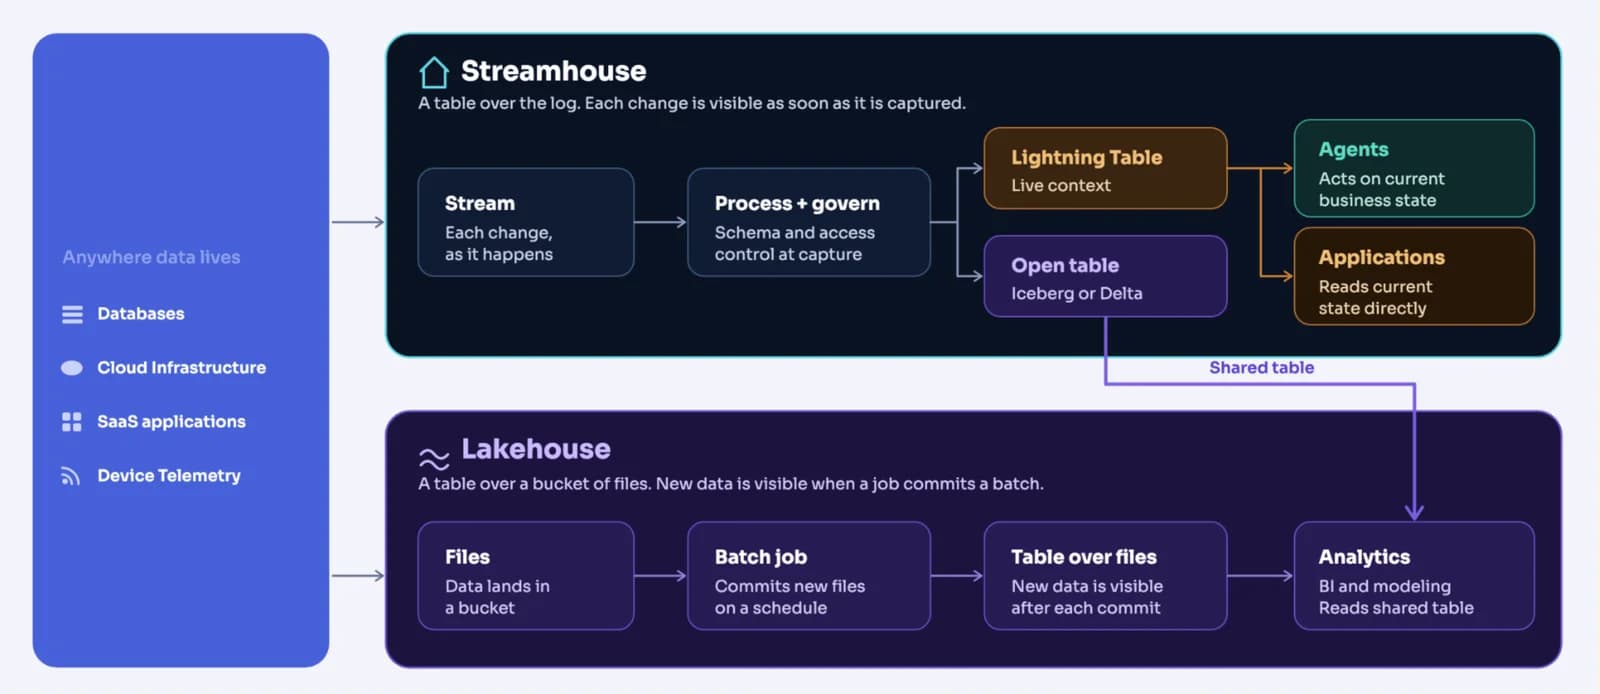
Streamhouse строит таблицу поверх лога. Каждое изменение фиксируется, обрабатывается и управляется по мере его возникновения. Lakehouse строит таблицу поверх набора файлов.
Наиболее очевидные различия между Streamhouse и lakehouse связаны с задержкой (latency) и обработкой данных. Streamhouse регистрирует каждое изменение по мере его возникновения и передает его системам, которым оно необходимо, в то время как lakehouse забирает обновления по фиксированному расписанию пакетных заданий. Микропакетирование может сократить это расписание, но lakehouse все равно забирает изменения постфактум и обрабатывает большие объемы данных за один раз.
Более тонкое различие заключается в том, как Streamhouse работает по сравнению с lakehouse. Lakehouse — это пункт назначения. Данные поступают из разных мест и оседают в lakehouse. Streamhouse не хранит данные долгосрочно. Вместо этого он распространяет изменения в каждую систему, которой они нужны, в ожидаемом ею формате.
Последствия сбоев в различных архитектурах также имеют разный вес. Когда lakehouse выходит из строя, дашборды не обновляются, отчеты не генерируются, а модели искусственного интеллекта устаревают. Streamhouse, напротив, должен соответствовать производственным целевым показателям надежности, поскольку приложения и AI-агенты выполняют критически важные для бизнеса задачи.
Как они дополняют друг друга
Streamhouse использует таблицу поверх лога, где каждое изменение видно сразу после его захвата. Lakehouse использует таблицу поверх набора файлов, где новые данные становятся видны, когда задание фиксирует (commits) пакет.
Streamhouse обслуживает рабочие приложения и агентов, управляющих бизнесом. Lakehouse обслуживает внутренний анализ и моделирование.
Обе архитектуры опираются на открытые форматы таблиц, что делает их совместимыми. Streamhouse очищает данные и управляет ими по мере их поступления, а затем материализует их в виде таблиц для агентов и приложений (Lightning Tables), а также в виде открытых таблиц Iceberg или Delta для совместного использования с lakehouse. Lakehouse читает эту общую таблицу вместо создания собственной задачи по загрузке.
Обе архитектуры требуют управления данными (governance). Streamhouse обеспечивает соблюдение схем и контроль доступа на источнике. Lakehouse применяет собственные правила позже, на уровне таблиц, с помощью собственного каталога.
Хотя скорость загрузки данных в lakehouse возросла и в некоторых случаях приближается к реальному времени, это не то же самое, что текущее, надежное и доступное для запросов состояние, которое поддерживает Streamhouse. Это особенно верно с учетом медальонной архитектуры, которая требует нескольких итераций обработки, прежде чем данные станут пригодными для использования в бизнесе.
Существуют подходящие варианты использования для Streamhouse, lakehouse или обоих вариантов, которые мы рассмотрим в следующем разделе.
Какие проблемы решает каждый из них и в чем его ограничения
Lakehouse создан для работы с большими объемами исторических данных. Обучение модели на данных за прошлые годы или выполнение запроса, сканирующего терабайты информации за один раз — это именно то, для чего он был разработан. Он также предоставляет организации единую копию своей истории для запуска бизнес-аналитики.
Lakehouse оказывается неэффективным, когда ответ требуется в реальном времени. Выявление мошеннической транзакции или предоставление клиенту персонализированной рекомендации должно происходить, пока клиент все еще находится на связи, а ежедневное пакетное задание не может этого обеспечить. Некоторые lakehouse предлагают микробэтчинг для работы в реальном времени, но это крайне неэффективно с точки зрения затрат. Большинство команд в итоге запускают базу данных или кэш рядом с lakehouse для получения быстрого доступа к тем же данным.
Streamhouse решает эту проблему. Приложение или агент, которым нужен ответ прямо сейчас, могут напрямую запросить Streamhouse. Lakehouse может считывать те же данные в виде таблиц Iceberg или Delta вместо создания собственных заданий на загрузку.
Streamhouse не предназначен для другой стороны задачи. Сканирование многолетней истории или выполнение специального анализа, с которым легко справляется lakehouse — это не то, для чего создан Streamhouse, и он никогда не задумывался как замена роли lakehouse в бизнес-аналитике.
Концепция Customer 360
Разница между этими двумя архитектурами становится очевидной, когда мы применяем этот подход к сценарию использования, с которым мы сталкиваемся во многих отраслях: созданию единого представления о клиенте (Customer 360). У организаций есть данные, распределенные по различным бизнес-системам в разных подразделениях, но им по-прежнему необходим один общий обзор клиента, чтобы обеспечить полноценный опыт для потребителя, соответствовать нормативным требованиям и управлять ресурсами и запасами.
Это может потребовать создания архитектуры, которая фиксирует обновления в CRM, активность приложений в потоке кликов, транзакции в системе учета и рыночные данные, такие как курсы обмена валют из внешних источников, поступающие из самых разных сфер бизнеса.
Период полураспада данных по мере их создания в этих системах сильно варьируется в зависимости от того, какой тип вопроса вы пытаетесь задать данным. Чтобы найти «следующего лучшего клиента», нам может потребоваться изучить многомерные данные из сотен различных источников и за много лет активности, постепенно настраивая параметры и руководствуясь необходимостью найти «почему» среди всех наших точек данных. Это область, где озеро данных имеет наибольший смысл. Команды бизнес-аналитики могут смириться с тем, что эти данные устарели на 10 минут, поскольку для многих вопросов мы запрашиваем контекст за дни, недели или годы, одновременно балансируя с важностью не прерывать бизнес-активность.
Не каждый вопрос о клиенте — это сложный вопрос «почему». Некоторые из них представляют собой простые вопросы «что», требующие быстрого и надежного ответа, потому что клиент ждет его. Что пошло не так в приложении, когда клиент создает обращение в службу поддержки? Является ли только что поступивший карточный платеж мошенническим с учетом остальной активности по этому счету? Как погода и трафик влияют на эту доставку? Каждое из этих действий требует информации о только что произошедшем событии и стоящей за ним истории, и данные должны быть точными в момент их поступления.
Именно здесь сценарий использования Customer 360 в Streamhouse становится наиболее актуальным. Виртуальному помощнику по шопингу может потребоваться одновременно запрашивать историю покупок конкретного клиента, хранящуюся в форматах открытых таблиц, и объединять ее с текущей активностью просмотров в виде ленты в реальном времени. Таким образом, он может распознать, какими продуктами клиент, скорее всего, заинтересуется, чтобы предложить ему динамическую сделку. Этому агенту-виртуальному покупателю нужен актуальный контекст точно так же, как ассистент обращал бы внимание на происходящее в торговом зале. Streamhouse не только предоставляет контекст, но и стимулирует обогащение данных в этом конвейере контекста, избавляя агента от необходимости тратить токены на дополнительный поиск, например, добавляя имя клиента и балл лояльности «на лету» к событию из децентрализованных источников. Обеспечение соответствия требованиям управления до обслуживания контекста дополнительно помогает нашему виртуальному покупателю, а это означает, что любые проблемы с данными застрахованы и могут быть устранены немедленно, когда у нашего уровня обслуживания контекста нет возможности повторно запустить пакетное задание, если поле данных определено некорректно.
В конечном итоге эта модель формирует шаблон, от которого выигрывает вся инфраструктура. Операционная среда фиксирует, передает и осуществляет многоадресную рассылку клиентской активности без ущерба для своей способности обслуживать свою платформу. Среда агентов получает обогащенный и управляемый источник бизнес-телеметрии для создания целостного и непрерывного слоя контекста о том, что происходит и как можно помочь. Аналитика и бизнес-аналитика также получают выгоду: их домен получает данные, которые подготавливаются ближе к источнику и напрямую интегрируются в их каталог благодаря доставке в формате, пригодном для потребления их существующими табличными форматами и уровнями запросов, без необходимости беспокоиться о создании еще одного конвейера.
Платформа потоковой передачи данных Confluent помогает создать Streamhouse, который обслуживает контекст Customer 360 как единую управляемую копию.
Когда использовать один подход, другой или оба
Три фактора определяют, какая архитектура вам нужна: скорость, масштаб и цель.
Streamhouse
Lakehouse
Скорость
Данные доступны сразу же после фиксации события
Пакетные задания по расписанию — от каждой минуты до одного раза в месяц
Масштаб
Текущее состояние бизнеса
Годы истории и запросы, сканирующие терабайты
Цель
Операционные решения для микросервисов, агентов и приложений, такие как проверка платежа на мошенничество по мере его поступления
Бизнес-аналитика, наука о данных и обучение моделей, такие как обучение модели на данных транзакций за три года
Выбирайте Streamhouse, когда микросервисам, агентам или приложениям необходимо реагировать на изменения по мере их возникновения. Это важнее всего, когда несколько децентрализованных систем потребляют одни и те же данные, поскольку каждой из них требуется одно и то же состояние в своем собственном формате.
Выбирайте lakehouse, когда вам требуется единое хранилище для больших объемов и длительной истории структурированных и неструктурированных данных. Типичные варианты использования — нерегламентированная бизнес-аналитика, обучение моделей на массивах данных и создание аналитических результатов уровня gold, которые отображаются на информационных панелях и в отчетах.
Любому предприятию нужны оба решения. Streamhouse управляет операционной стороной: он фиксирует данные у источника и обеспечивает их governance на раннем этапе, чтобы потребители реального времени могли использовать их немедленно. Lakehouse обрабатывает историческую аналитику. Streamhouse передает свои данные в виде открытых таблиц, поэтому lakehouse не нуждается в собственных конвейерах загрузки, а аналитические команды получают свежие, обработанные данные без ущерба для операционной производительности.
Создайте свой Streamhouse на базе Confluent
Вы можете собрать Streamhouse из инструментов с открытым исходным кодом или из отдельных облачных сервисов. Большинство команд, которые пытаются это сделать, обнаруживают, что реальная стоимость заключается в стыковке компонентов: разные модели безопасности, отсутствие сквозного отслеживания происхождения данных и отсутствие ответственных за бесперебойную работу всего конвейера. Для Streamhouse это имеет гораздо большее значение, чем для lakehouse, поскольку от него зависят работающие приложения и агенты.
Платформа потоковой передачи данных Confluent (DSP) — это лучший способ построить Streamhouse. Kafka, Flink, управление схемой и Tableflow работают вместе на одной платформе, поэтому данные собираются, обрабатываются и управляются один раз. Затем они поступают к приложениям, агентам и в lakehouse в том формате, который каждый из них ожидает, включая таблицы Iceberg и Delta. Платформа имеет соглашение об уровне обслуживания (SLA) с доступностью 99,99% и работает в AWS, Azure и Google Cloud, а также в частных дата-центрах.
Следующие шаги
Чтобы начать внедрение архитектуры Streamhouse с помощью Confluent:
- Присоединяйтесь к вебинару: Streamhouse: архитектура данных, обеспечивающая работу ИИ со скоростью машин
Присоединяйтесь к вебинару: Streamhouse: архитектура данных, обеспечивающая работу ИИ со скоростью машин
- Узнайте, как это выглядит, когда организация использует Streamhouse: скачайте описание решения
Узнайте, как это выглядит, когда организация использует Streamhouse: скачайте описание решения
- Прочитайте электронную книгу: Ваш бизнес постоянно меняется. Успевает ли за ним ваш ИИ?
Прочитайте электронную книгу: Ваш бизнес постоянно меняется. Успевает ли за ним ваш ИИ?
- Попробуйте сами: начните бесплатную пробную версию Confluent Cloud
Попробуйте сами: начните бесплатную пробную версию Confluent Cloud
- Обсудите это со специалистом: запишитесь на консультацию со специалистом по Confluent Streamhouse
Обсудите это со специалистом: запишитесь на консультацию со специалистом по Confluent Streamhouse
Предыдущий текст описывает общее направление развития нашего продукта и не является обязательством по поставке каких-либо материалов, кода или функционала. Разработка, выпуск, сроки и цены любых описанных функций или возможностей могут изменяться. Клиенты должны принимать решения о покупке на основе сервисов, возможностей и функций, которые доступны в настоящее время.
Confluent и связанные с ним знаки являются товарными знаками или зарегистрированными товарными знаками компании Confluent, Inc.
Apache®, Apache Kafka®, Kafka®, Apache Flink®, Flink®, Apache IcebergTM, IcebergTM, Apache ParquetTM и ParquetTM являются зарегистрированными товарными знаками или товарными знаками Apache Software Foundation в США и/или других странах. Использование этих знаков не подразумевает одобрения со стороны Apache Software Foundation. Все прочие товарные знаки являются собственностью соответствующих владельцев.