Более крупные модели, расширенные контексты и агентные приложения усиливают нагрузку на память GPU в условиях сокращения поставок и роста цен — эта тенденция, как ожидается, сохранится в ближайшем будущем.
NVIDIA тесно сотрудничает с партнерами по производству памяти для быстрого внедрения новейших технологий. NVIDIA первой внедрила технологии HBM3e и HBM4 в стек ускоренных вычислений.
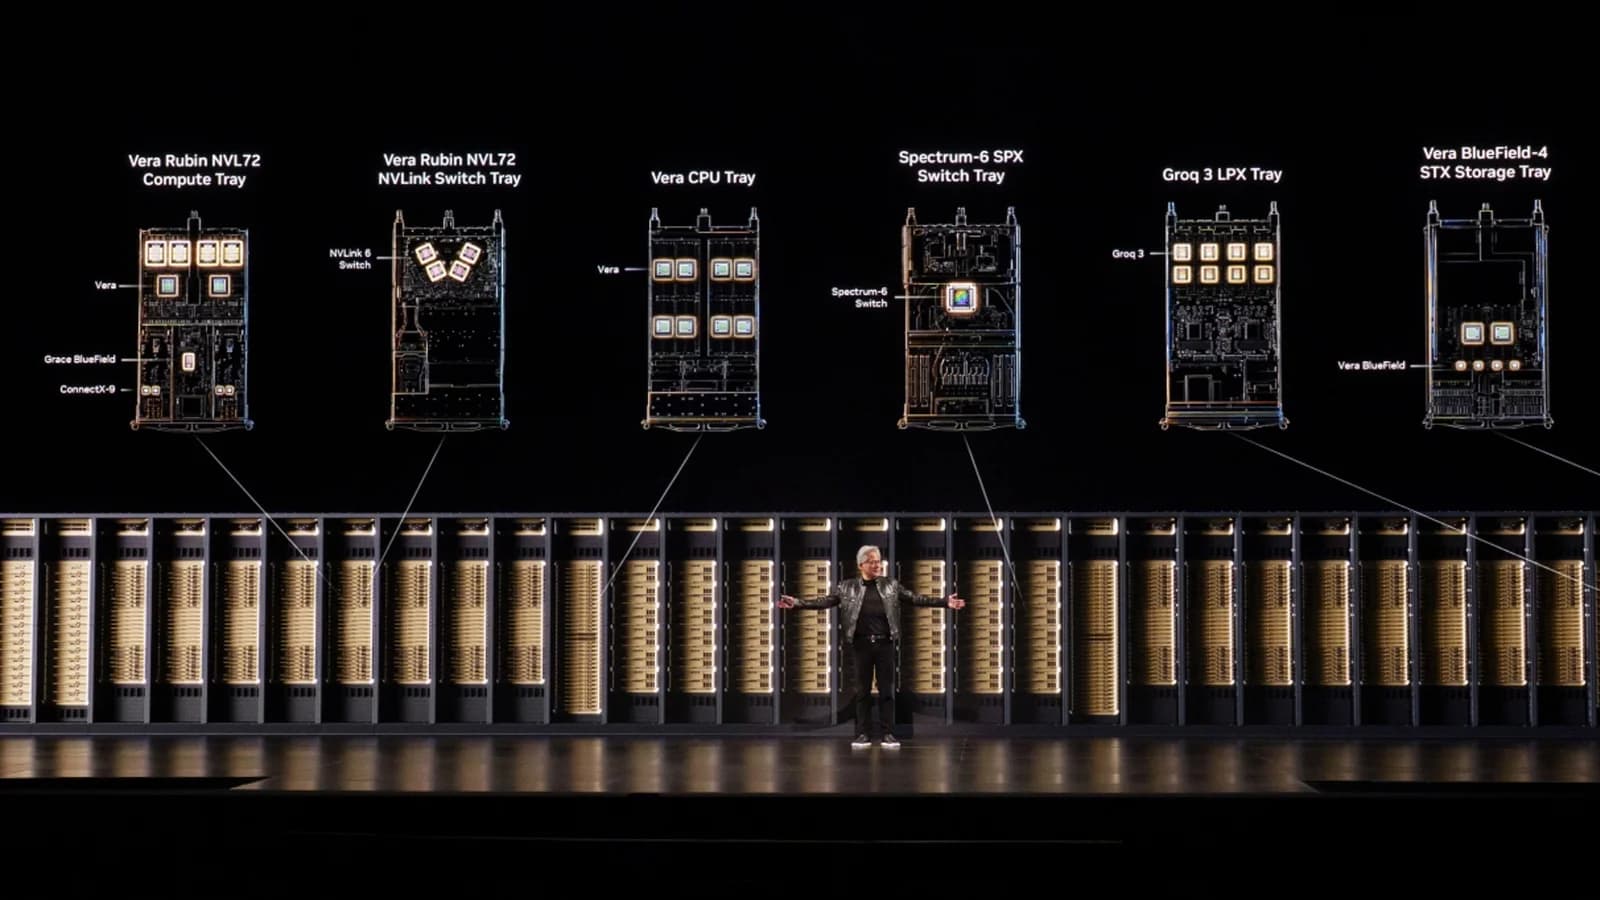
Но подход заключается не просто в том, чтобы добавить больше памяти на GPU. Это полностековое совместное проектирование (codesign). NVIDIA намеренно проектирует GPU, CPU, сетевые решения, системы хранения данных и программное обеспечение как единое целое, чтобы получать больше полезной работы от памяти на каждом уровне ИИ-фабрики.
Это важно, потому что ИИ-фабрика работает на основе иерархии памяти и систем хранения данных. Память с высокой пропускной способностью (HBM) GPU — это самый быстрый, дорогой и востребованный уровень, где веса моделей и KV-кэш конкурируют за ограниченный объем. Ниже находятся память CPU, локальные SSD и общее хранилище, каждое из которых жертвует скоростью ради увеличения емкости при меньшей стоимости за бит.
То, сколько полезной работы выполняет байт, зависит от того, насколько эффективно используется вся иерархия: сокращение объема хранимых данных, их размещение на нужном уровне и возврат в GPU до того, как они потребуются.
Байт за байтом NVIDIA обеспечивает наиболее эффективное использование памяти на каждом уровне, и результаты это подтверждают. От NVIDIA Blackwell Ultra до платформы Vera Rubin емкость HBM на GPU выросла примерно на 3%, в то время как агентная пропускная способность на доллар выросла до 30 раз согласно SemiAnalysis AgentX.
Агентный вывод создает дополнительную нагрузку на HBM
Современные передовые модели имеют триллионы параметров — значений, которые хранят то, что ИИ-модель усвоила в процессе обучения.
KV-кэш, который хранит контекст, необходимый модели для понимания каждого активного запроса без повторной обработки той же информации, также расширяется. Агентные траектории переносят предыдущий контекст через повторяющиеся вызовы моделей и инструментов, в некоторых случаях обрабатывая до 3 миллионов токенов, поэтому рабочая память каждого запроса со временем растет.
RAG (генерация с дополнением поиском) добавляет релевантную корпоративную информацию к промптам, создавая еще больше контекста для обработки и хранения.
Во время вывода HBM в основном содержит как параметры модели, так и KV-кэш. Результат: повышенная нагрузка на HBM.
Почему ИИ-фабрикам нужна иерархия памяти
Увеличение емкости HBM на GPU — очевидный ответ на эту нагрузку, но емкость дает лишь то, что может обеспечить пропускная способность.
Представьте HBM как склад, а пропускную способность памяти — как его погрузочные платформы. На большом складе помещается больше товаров, но платформы определяют, сколько можно переместить за раз. Как только платформы загружены на полную мощность, перемещение товаров занимает больше времени и замедляет отклик. Если задержки превышают требуемый уровень обслуживания, дополнительное пространство нельзя использовать эффективно, даже если оно увеличивает затраты и потребление энергии.
Именно поэтому ни одно предприятие не хранит все свои запасы в самом близком и быстром месте. То, что находится в движении, остается рядом с производственной линией. То, что ожидает, перемещается в более крупное и дешевое место поблизости и возвращается до того, как потребуется.
ИИ-фабрика сталкивается с тем же ограничением.
Больше HBM может вместить больше KV-кэша и поддерживать больше одновременных пользователей. Каждый добавленный пользователь делит те же вычислительные мощности и пропускную способность памяти. Но когда каждый пользователь ожидает быстрого отклика, в конечном итоге пропускная способность памяти не может поставлять данные так быстро, как их могут использовать вычисления: это ограничение инженеры называют «стеной памяти».
После этой точки дополнительная емкость HBM не может быть задействована, но она по-прежнему увеличивает расходы и потребляет энергию. Данным все еще нужно место для хранения, но не всем из них нужен самый быстрый и дорогой уровень. Вот почему ИИ-фабрика управляет данными через иерархию памяти и систем хранения.
Максимизация ценности каждого байта с помощью полностекового совместного проектирования
Полностековое совместное проектирование NVIDIA заставляет каждый байт HBM работать, снижая нагрузку от весов моделей, KV-кэша и данных RAG. Это достигается с помощью методов, каждый из которых нацелен на отдельный источник неэффективности:
Сокращение весов моделей и их распределение по домену NVL72.
- Формат NVFP4 уменьшает пространство, необходимое для весов, по сравнению с FP8, минимально возможной точностью на платформе NVIDIA Hopper. Недавние модели, включая FLUX.2 [klein] от Black Forest Labs, Inkling от Thinking Machines Lab, Beam 1.0 от Reflection, Meta Muse Spark от Meta, Step 5 Preview от StepFun и NVIDIA Nemotron 3.5 Super VL, были выпущены с чекпоинтами NVFP4, что демонстрирует растущее внедрение разработчиками моделей 4-битной точности для более быстрого и эффективного с точки зрения памяти вывода.
- В системе NVL72 веса модели могут быть распределены между 72 GPU, поэтому каждый GPU хранит меньшую часть модели, оставляя больше HBM для KV-кэша и одновременных пользователей.
Сокращение KV-кэша и выгрузка неактивного контекста на более дешевые уровни хранения.
- Применение NVFP4 to the KV cache уменьшает его объем по сравнению с FP8, поэтому больше контекста может оставаться в HBM.
- NVIDIA Vera CPU помогает двумя способами. Более быстрое выполнение инструментов сокращает время, в течение которого KV-кэш остается неактивным во время вызовов инструментов, а его большая память LPDDR, подключенная к GPU NVIDIA Rubin через интерконнект NVIDIA NVLink-C2C, дает приостановленному контексту место поблизости, чтобы подождать и быстро вернуться.
- Когда контекст не используется активно, программное обеспечение для вывода NVIDIA Dynamo перемещает его в хранилище контекстной памяти NVIDIA CMX — уровень, созданный для емкости при гораздо более низкой стоимости за бит, чем HBM, — и возвращает его перед повторным использованием. В отличие от локальных SSD, CMX является общим для серверов, и в отличие от корпоративных систем хранения, он исключает накладные расходы на долгосрочную защиту данных, которая не нужна для кратковременного контекста. Партнеры NVIDIA по хранилищам контекстной памяти CMX включают Cloudian, DDN, Dell Technologies, Everpure (ранее Pure Storage), HPE, IBM, NetApp, VAST и WEKA.
- Функция KV Cache Reuse в Dynamo связывает уровни вместе, управляя KV-кэшем как единым системным ресурсом между памятью GPU, памятью CPU и хранилищем, чтобы контекст, вычисленный один раз, мог быть повторно использован во всей системе.
Компактные RAG-эмбеддинги и хранение индекса вне HBM.
- RAG превращает корпоративные документы в эмбеддинги — числовые представления, которые позволяют системе искать по смыслу, а не по ключевым словам, — организованные в индекс с возможностью поиска. Модели NVIDIA Nemotron Retriever создают меньшие эмбеддинги с более высокой точностью поиска, в то время как библиотека NVIDIA cuVS позволяет создавать этот индекс и обслуживать его с использованием CPU и хранилища. База знаний никогда не занимает HBM, и в контекст попадают только те фрагменты, которые нужны модели.
Результат — меньше HBM используется для весов моделей, меньше HBM занято простаивающим контекстом и больше доступно для обслуживания одновременных пользователей.
Больше полезного результата на доллар с каждым поколением
В последующих поколениях платформ NVIDIA количество токенов в секунду на доллар росло гораздо быстрее, чем емкость HBM.
В рабочей нагрузке SemiAnalysis AgentX DeepSeek V4 Pro система NVIDIA GB300 NVL72 обеспечивает до 10 раз более высокую пропускную способность на доллар, чем платформа NVIDIA H200 при 100 токенах в секунду на пользователя, при этом емкость HBM на GPU примерно удваивается. При 125 токенах в секунду на пользователя Vera Rubin NVL72 обеспечивает до 30 раз более высокую пропускную способность на доллар, чем GB300 NVL72, при увеличении емкости HBM на GPU примерно на 3%.
Для операторов фабрик искусственного интеллекта важнейшей метрикой является то, сколько полезных токенов фабрика может выдать в рамках своего энергопотребления при соблюдении требований к времени отклика пользователя. Больше токенов в секунду на ватт означает больше работы и дохода от той же мощности и более низкую стоимость каждого токена. Полностековая совместная разработка NVIDIA снижает стоимость токенов за счет увеличения объема полезной работы, которую приносит каждый байт памяти.
Узнайте больше из видеообзора и технического обзора о том, как полностековая совместная разработка NVIDIA снижает нагрузку на память при инференсе.