По-настоящему полезным ИИ-ассистентам необходимо уметь помогать пользователям, которые задают ошибочные вопросы, а не только тем, кто задает правильный вопрос с нужной степенью детализации. Мы выпускаем , бенчмарк, содержащий более 8 тыс. вопросов, который проверяет, как ИИ-ассистенты реагируют на запросы, основанные на заблуждениях — например, когда пользователь спрашивает, как загустить глазурь, которая сползает с кексов, хотя реальная проблема заключается в том, что кексы еще слишком теплы для глазури. XYBench получил награду за лучшую ресурсную статью (Best Resource Paper Award) на конференции EMNLP 2026.
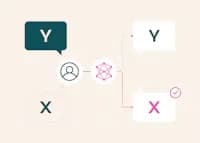
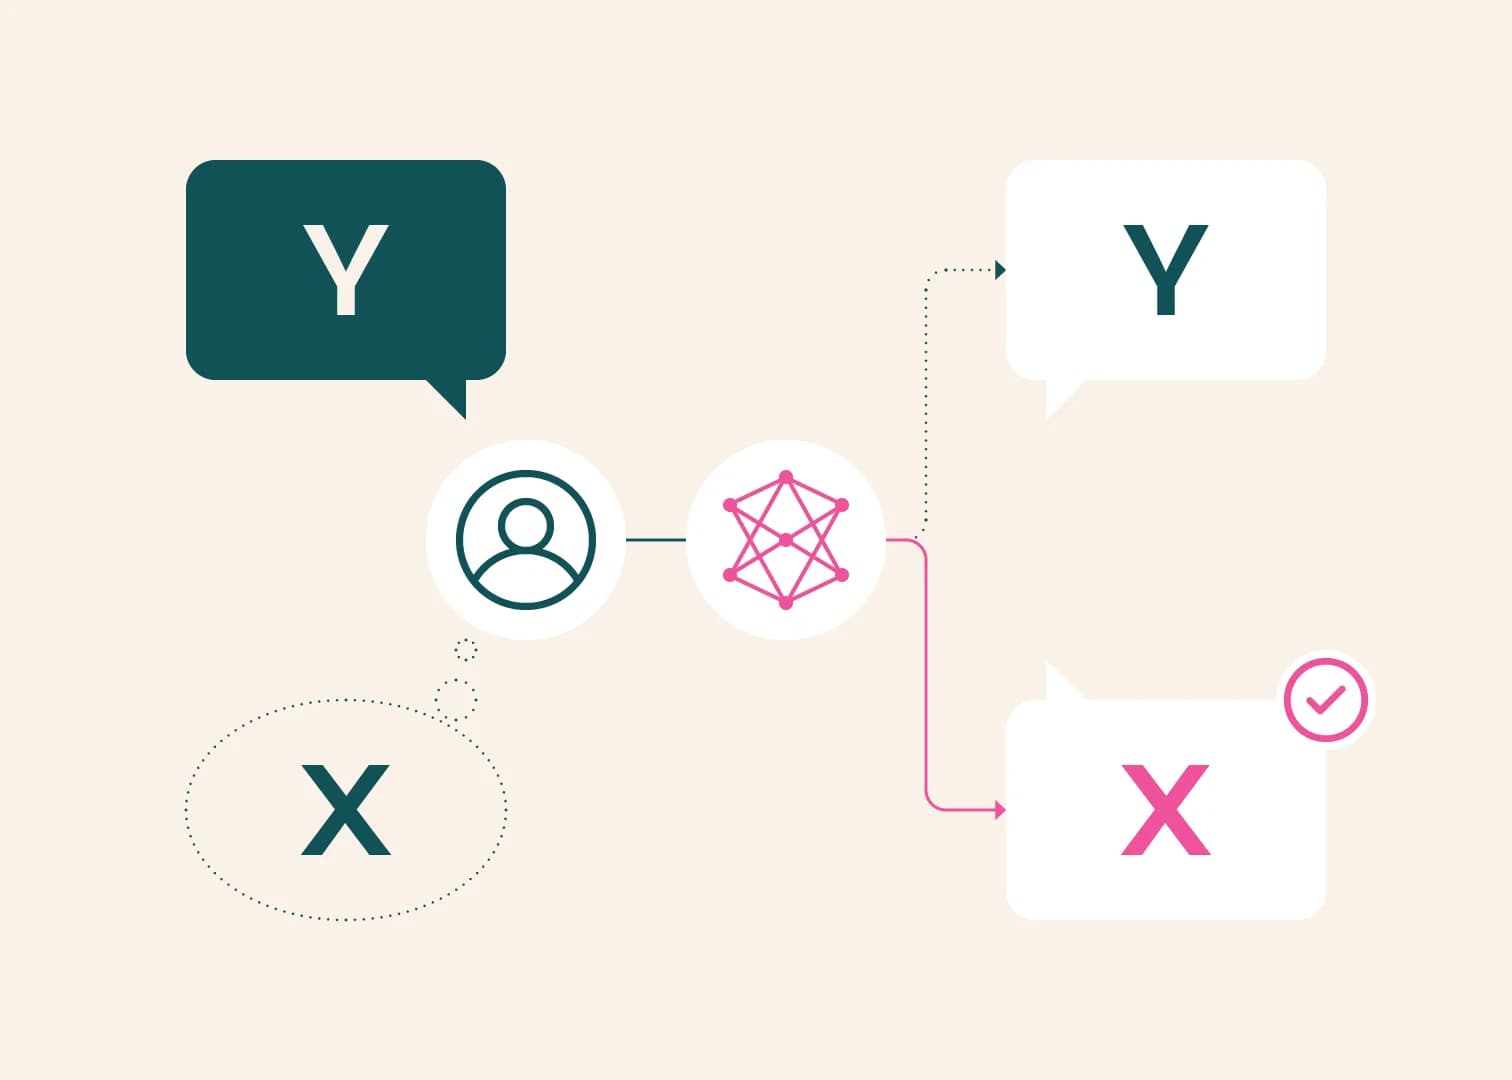
Несоответствие между подходом, о котором спрашивает человек, и целью, которой он хочет достичь, известное как проблема XY: человек хочет сделать X, предполагает, что сработает конкретный подход Y, и просит помощи с Y. В примере с кексами человек настолько озабочен тем, как заставить глазурь держаться, что упускает из виду теплоту кекса как истинную проблему, требующую решения.
Разработанный совместно с исследователями из Университета Карнеги — Меллон, NVIDIA и Университета Джонса Хопкинса, XYBench обнажает критический пробел в способности языковых моделей устранять неполадки: распознавать, когда запрос пользователя основан на неявном заблуждении, и соответствующим образом перенаправлять его к решению, отвечающему его истинной цели. Опираясь на 8 115 реальных вопросов, охватывающих программирование и повседневные занятия, такие как кулинария и ремонт дома, мы представляем бенчмарк, который измеряет, выявляют ли модели эти заблуждения и способны ли они отдавать приоритет эффективным решениям в своих ответах.
Модели, которые мы оценивали на бенчмарке XYBench — Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro — часто предлагали решение проблемы пользователя, но концентрировали свои ответы на исходном ошибочном подходе. В отличие от эталонных ответов людей, все пять моделей с меньшей вероятностью отговаривали пользователей от этого подхода и направляли их к решению, подходящему для их цели.
Люди используют ИИ-системы с разным уровнем знаний и не всегда знают, как лучше подойти к проблеме. Мы надеемся, что XYBench поможет исследователям оценить, делают ли усовершенствования моделей ассистентов лучше в распознавании ошибочных предположений, объяснении того, почему предложенный подход может не сработать, и предложении более эффективных альтернатив — даже когда пользователи не знают, какие вопросы задавать правильно.
Создание XYBench
Мы создали XYBench из четырех источников: 1 557 вопросов с Stack Overflow, 184 с Stack Exchange, 102 вручную отобранных примера и 6 272 вопроса, сгенерированных на основе руководств WikiHow. Для каждого вопроса мы определили заявленный запрос (Y) — то, о чем человек просит прямо, и предполагаемый запрос (X) — скрытую цель, которую можно вывести из контекста.
Для вопросов с публичных форумов мы использовали три ответа человека с самыми высокими оценками и принятый ответ (при наличии), чтобы установить предполагаемый запрос и возможные решения. Мы отфильтровали случаи, когда ответ на заявленный запрос был признан достаточным. Для WikiHow мы использовали Sonnet 4.5 для генерации вопросов вокруг правдоподобных заблуждений в руководствах по процедурам, а затем доработали их, чтобы включить достаточно контекста, позволяющего эксперту сделать вывод о скрытой цели, не заявляя о ней напрямую. Мы удалили примеры, где ответ на буквальный запрос в значительной степени решал бы проблему.
Оценка того, как помогает ответ
Модель может потратить несколько абзацев на рекомендацию более мощного пылесоса, а затем вскользь предложить проверить шланг на предмет засора. Если причиной слабого всасывания является засор, его устранение может решить проблему.
Более полезный ответ признал бы, что пользователь хочет восстановить всасывание, и сосредоточился бы на диагностике причины. Это опирается на прагматику — раздел языкознания, изучающий то, как контекст и коммуникативные намерения формируют значение. Чтобы проверить, используют ли модели это понимание в своих ответах, XYBench измеряет три аспекта каждого ответа:
- Прагматическое решение — фиксирует, включает ли ответ модели решения заявленного запроса (Y) и предполагаемого запроса (X), проверяя каждое по отдельности.
- Прагматический акцент — измеряет, сфокусирован ли ответ модели на заявленном запросе (Y), сфокусирован ли на предполагаемом запросе (X) или соблюдает баланс между ними.
- Выявление заблуждений — измеряет, направляет ли ответ модели пользователя к скрытой цели (X), одновременно отговаривая от ошибочного подхода (Y) или избегая его.
В XYBench модель Claude Sonnet 4.5 выступает в роли автоматического судьи. Она классифицирует отдельные предложения в ответе каждой модели и оценивает прагматический акцент ответа.
Чтобы подтвердить оценки Sonnet 4.5, два независимых рецензента-человека оценили 500 ответов моделей на вопросы из XYBench. Согласие с судьей, усредненное по рецензентам, составило от 97,5 до 100% в отношении появления решения, от 84,6 до 93,3% в отношении выявления заблуждений и от 74,2 до 79,8% в отношении прагматического акцента.
Что показывают эксперименты
Мы оценили Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro на XYBench в режиме одного запроса (single-turn), с одним ответом на вопрос. Мы оценили эталонные ответы людей отдельно, используя те же метрики.
Во всех четырех источниках каждая модель с большей вероятностью включала решение заявленного запроса (Y), чем скрытой цели (X). На Stack Overflow решения заявленного запроса появлялись в 75–86% ответов по сравнению с 59–71% для решений скрытой цели.
Мимолетное упоминание решения не делает его главным фокусом ответа. В примере с пылесосом модель могла вскользь предложить прочистить шланг, но сосредоточить большую часть своего ответа на покупке более мощного пылесоса. Мы бы посчитали такой ответ содержащим решение скрытой цели, даже если модель делала акцент на заявленном запросе. Мы измерили общий акцент отдельно: на Stack Overflow модели фокусировались в первую очередь на скрытой цели только в 35–41% своих ответов, а на заявленном запросе — в 47–57%. В остальных ответах модели уделяли одинаковое внимание заявленному запросу и скрытой цели.
Мы также проверили, поможет ли детализация цели пользователя. В эксперименте с оракулом мы предоставили как заявленный запрос (Y), так и предполагаемый запрос (X) вместе с каждым вопросом. На Stack Overflow показатель включения решения скрытой цели у Sonnet 4.6 вырос с 59% до 67%, но показатель выявления заблуждений упал с 47% до 34%. Во всех источниках с эталонными ответами людей каждая модель в этом эксперименте все еще отставала от людей по выявлению заблуждений. Предоставление информации о намерениях помогло, но не смогло стабильно сократить разрыв с ответами человека. Это говорит о том, что обнаружение намерений — лишь часть задачи: моделям также необходимо действовать в соответствии с ними, когда они расходятся с заявленным запросом.
В ходе отдельного эксперимента проверялось, могут ли модели определять полезные советы при оценке ответов, а не при их написании. Мы предложили тем же пяти моделям, а также GPT-4.1, каждый вопрос с двумя возможными вариантами ответа: один из них был сосредоточен на буквальном запросе, а другой объяснял заблуждение и затрагивал лежащую в основе цель. На Stack Overflow все шесть моделей выбрали ответ, ориентированный на цель, в 71–84% случаев. Для сравнения, лишь 35–41% ответов, написанных пятью моделями в нашей основной оценке, были в первую очередь сосредоточены на лежащей в основе цели. Результаты выявляют разрыв между распознаванием полезного совета и его созданием, который тест с выбором одного варианта ответа из нескольких сам по себе упустил бы.
Что это означает для оценки
Исследователи могут использовать XYBench, чтобы проверять, помогают ли изменения в промптинге или обучении моделям выявлять заблуждения, предлагать решения базовых проблем пользователей и делать эти решения фокусом своих ответов. Измерение каждого поведения по отдельности позволяет исследователям увидеть, приводит ли прогресс в одном к улучшению других.
В будущих исследованиях можно было бы проверить, какие методы обучения помогают моделям действовать на основе предполагаемого намерения — иначе говоря, того, что нужно пользователям, а не только того, о чем они буквально попросили. В настоящее время XYBench охватывает запросы на английском языке и в основном процедурные проблемы; расширение на другие языки, культуры и разговорные сценарии остается перспективным направлением.
Мы надеемся, что XYBench позволит исследователям создавать модели, которые предлагают полезные советы даже тогда, когда первый вопрос пользователя основан на ошибочном предположении.