Введение
ИИ-инференс становится все более гетерогенным. Новые архитектуры моделей выходят каждую неделю, трафик инференса меняется в зависимости от размеров батча и длины последовательности, а аппаратные платформы продолжают множиться. Достижение пиковой производительности во всех этих режимах требует оптимизационных фреймворков, способных поспевать за изменениями.
В прошлом году мы помогли выпустить одни из первых ИИ megakernels, где мы выполняли весь прямой проход модели внутри одного, высокооптимизированного (fused) GPU-кернела. Они достигали рекордных скоростей, но их было сложно внедрить в продакшн. После месяцев усилий у нас была в общей сложности одна модель, один размер батча и один клиент.
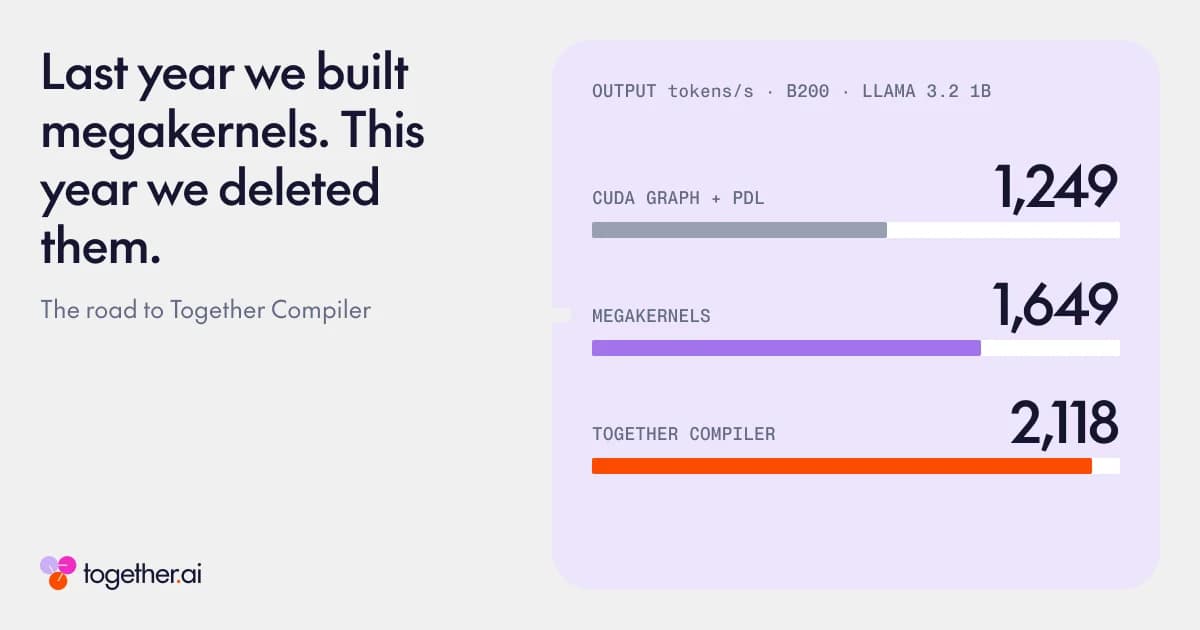
В этом году мы проанализировали, что можно упростить, и обнаружили нечто удивительное. Используя только CUDA Graphs и PDL поверх стандартных кернелов Torch Inductor, мы смогли восстановить 98% производительности мегакернелов, не написав ни одного кернела вручную. А с помощью «мульти-кернелов» и агентских циклов мы смогли превзойти наши старые мегакернелы до 1,7 раза, достигнув более 1100 TPS для Llama 1B на H100.
Последние два года мы исследовали, как должна выглядеть система следующего поколения для оптимизации инференса. Создав серию систем программирования и оптимизации для GPU, мы пришли к Together Compiler — нашему фреймворку для непрерывной оптимизации ИИ-инференса. В этом блоге мы пересмотрим предположения, лежащие в основе современных компиляторов, поделимся экспериментами, которые бросили вызов нашему мышлению, и объясним уроки, сформировавшие Together Compiler. Наше путешествие состоит из трех частей:
В Части 1 мы покажем, что эвристики и бенчмаркинг Torch Compile оставляют потенциал производительности неиспользованным, что дает мотивацию создать нечто радикально иное.
В Части 2 мы вернемся к мегакернелам, которые мы создали для устранения этого разрыва, объясним, почему они не всегда являются правильной целью оптимизации, и разложим их прирост производительности на более простые примитивы.
В Части 3 мы поделимся нашими «горькими уроками» создания инфраструктуры оптимизации на основе агентов и итоговой производственной системой, которую мы получили.
Часть 1: Torch Compile
Более десяти лет PyTorch был фундаментом разработки ИИ, предоставляя модульные, простые в использовании абстракции (nn.Module), которые позволили проводить быстрые эксперименты. Но эта модульность имеет свою цену в производительности: выполнение моделей как последовательностей отдельных операций может привести к значительным накладным расходам на запуск, ограничить возможности для совмещения вычислений и перемещения данных в памяти, а также оставить ресурсы GPU недоиспользованными. Чтобы устранить эти неэффективности, в PyTorch был представлен Torch Compile («PyTorch 2.0» на базе Inductor) для оптимизации и объединения операций, а NVIDIA разработала CUDA Graphs для снижения накладных расходов на запуск кернелов. Эти системы добились огромного прогресса, но значительные разрывы в производительности остаются, что часто побуждает исследователей Together изобретать специализированные реализации, такие как FlashAttention, ThunderKittens и Megakernels.
Мы начнем с краткого обзора того, как работает Torch Compile, а затем представим наши выводы, полученные в результате исследования внутренних механизмов Inductor на Llama 1B.
Как работает Torch Compile
На верхнем уровне Torch Compile использует конвейер JIT-компиляции для захвата операций PyTorch в граф вычислений, оптимизации этого графа и генерации исполняемых GPU-кернелов. Ключевые компоненты:
- Захват графа. TorchDynamo отслеживает выполнение Python, чтобы захватить тензорные операции в промежуточное представление, называемое FX-графом. Во время трассировки он использует фиктивные тензоры (fake tensors), которые содержат метаданные, такие как формы, типы данных и шаги (strides), без выделения или вычисления базовых данных тензора. Это позволяет компилятору рассуждать о вычислениях, не выполняя их на GPU. Полученный FX-граф может быть преобразован и оптимизирован перед генерацией кода.
- Операции и кернелы. Inductor понижает захваченный граф до своего собственного промежуточного представления, где операции организованы по категориям, таким как поточечные (например, функции активации), редукции (например, суммирование и softmax), сканирования (например, кумулятивные суммы) и шаблоны (например, GEMM и другие специализированные вычислительные кернелы). Некоторые операции вместо этого вызывают существующие реализации из библиотек, таких как cuBLAS, или пользовательские операторы PyTorch. Inductor представляет их как внешние кернелы (ExternKernel), реализации которых, как правило, непрозрачны для его механизма объединения.
- Объединение и оптимизация. Inductor использует жадный парный алгоритм для принятия решения о том, какие операции объединить в один кернел. Его функция can_fuse() проверяет, является ли кандидат на объединение допустимым, а score_fusion() ранжирует возможности, используя эвристики, такие как оценка экономии трафика памяти. Алгоритм многократно применяет выгодные объединения, потенциально комбинируя множество операций в один кернел. Однако эти решения основаны на локальных эвристиках, а не на глобальном поиске по всем возможным разбиениям кернелов и стратегиям выполнения. Например, Inductor может избегать объединения операций, которые не имеют общих обращений к памяти, даже если выполнение их работы вместе могло бы улучшить использование GPU.
На нашей целевой нагрузке Llama 1B Inductor выдает 669 TPS. Как мы покажем в Части 2, этих сгенерированных кернелов иногда достаточно, и при небольших модификациях они могут достигать уровня производительности, близкого к мегакернелам. Однако на других архитектурах и более новом оборудовании эвристики Inductor не справляются. Мы исследовали, где Inductor испытывает наибольшие трудности, и представляем три вывода.
Вывод №1: Эвристики компилятора не могут надежно выбрать лучшую реализацию для разных нагрузок.
Inductor предоставляет ряд флагов настройки компилятора, которые могут повысить производительность. Мы обнаружили, что даже эти, казалось бы, простые конфигурации создают удивительно большое и сложное пространство для поиска.
Лучшая оптимизация зависит от нагрузки. Inductor предоставляет флаг «заморозки» (freezing), который сообщает компилятору, что веса модели не будут меняться во время инференса. Зная это, компилятор может заранее преобразовать веса, чтобы ускорить последующие вычисления. Одно из таких преобразований преобразует веса в FP32 для выполнения определенных оптимизаций перед обратным преобразованием в исходный формат с более низкой точностью. Мы обнаружили, что включение заморозки повышает пропускную способность на 10–26% при больших размерах батча, где GPU выполняет матрично-матричные умножения. Однако при размере батча 1, где инференс в основном использует матрично-векторные умножения, включение того же флага привело к замедлению на 49%. При проверке мы обнаружили, что преобразование в FP32 не отменялось для матрично-векторных операций, из-за чего GPU обрабатывал более крупные 32-битные веса вместо исходных весов с низкой точностью. Другими словами, одна и та же оптимизация компилятора могла улучшить производительность для одного размера батча и значительно ухудшить ее для другого.
Оптимизации взаимодействуют непредсказуемым образом. По состоянию на третий квартал 2026 года Inductor предоставляет 607 флагов настройки, 198 из которых были добавлены за последний год. Эти флаги управляют всем: от слияния ядер (kernel fusion) до шаблонов доступа к памяти и планирования. Их эффекты не являются независимыми: включение одного только флага aggressive_fusion снизило пропускную способность Llama 1B на 6 TPS, но его включение вместе с флагами combo_kernels, benchmark_fusion и triton.coalesce_tiling_analysis повысило пропускную способность на 3 TPS. Даже небольшие изменения конфигурации могут привести к заметным различиям во времени выполнения на уровне микросекунд.
Вывод: пространство возможных оптимизаций и конфигураций огромно, и нам следует исследовать его систематически, а не пытаться угадать правильные флаги.
Находка №2: Самое быстрое ядро в изоляции не обязательно является самым быстрым во время инференса.
Inductor принимает решения об оптимизации на основе своего механизма бенчмаркинга. Мы выявили два различных способа, которыми этот бенчмаркинг вводит в заблуждение, что в итоге снижает общую производительность.
Во-первых, он игнорирует тот факт, что производительность ядра зависит от поведения кэша. Torch Inductor очищает кэш L2 графического процессора перед бенчмаркингом отдельных ядер, но во время инференса ядра часто повторно используют данные, кэшированные от предыдущих операций. Мы наблюдали, что время выполнения в изолированных бенчмарках Inductor на 39–58% больше, чем при реальном прямом проходе (forward pass), где повторное использование кэша может сократить трафик памяти.
Входные данные бенчмарка также могут искажать поведение кэша в противоположном направлении. Например, при бенчмаркинге torch.embedding Inductor инициализирует тензор идентификаторов токенов нулями, из-за чего каждый токен обращается к одному и тому же вектору эмбеддинга. Для последовательности из 64 тысяч токенов это сделало ядро в 2,1 раза быстрее, чем при использовании случайных идентификаторов токенов, из-за искусственно высокого уровня повторного использования кэша.
Во-вторых, накладные расходы на бенчмаркинг могут привести к неправильному выбору ядра. Многие ядра декодирования выполняются всего за несколько микросекунд, поэтому точное измерение времени имеет решающее значение. Мы обнаружили, что механизм бенчмаркинга Inductor показал 2,5 мкс для операции, которая не выполняла никакой работы на GPU, в то время как другие измерения превышали время выполнения на GPU, зафиксированное Nsight Systems, примерно на 3,6 мкс. Это происходит потому, что механизм включает накладные расходы на запуск CPU после очистки кэша L2, в результате чего Inductor записывает время простоя.
Эти расхождения приводят к ошибочным решениям компилятора. Для операции GEMM выходной проекции Llama 1B Inductor выбрал ядро Triton, которое выполнялось за 7,4 мкс против 6,4 мкс для cuBLAS при реальном прямом проходе — замедление на 15%. Мы также наблюдаем это в современных архитектурах, зависящих от данных, таких как архитектуры «смесь экспертов» (MoE), например GLM 5.3, где стандартный бенчмаркинг PyTorch может быть на 4–21% медленнее, чем если бы мы изменили бенчмарк для использования реалистичных входных данных для сгруппированного GEMM-ядра MoE (показано на рисунке выше).
Вывод: для точного бенчмаркинга необходимо проводить измерения внутри реального прямого прохода на реальных входных данных.
Находка №3: Inductor упускает возможности для слияния.
Жадный алгоритм попарного слияния Inductor оценивает, можно ли законно объединить два ядра, а затем определяет, улучшит ли их слияние производительность. Хотя повторное попарное слияние может объединить несколько операций, оно может упустить возможности, требующие совместного рассмотрения больших групп ядер или различных конфигураций выполнения.
Мы исследовали решения по слиянию, принятые Inductor для Llama 1B, и нашли примеры, когда Inductor оставляет ядра разделенными, даже если их объединение было бы полезным. Например, мы обнаружили два последовательных ядра (поэлементная активация и ядро индексации KV), которые достаточно просты для слияния, но эвристики Inductor отклоняют слияние, поскольку у них нет общих обращений к памяти.
Поскольку Inductor оценивает кандидатов по предполагаемой экономии трафика памяти, он не видит причин объединять эти ядра. Однако, изучив ядра самостоятельно, мы видим, что первое ядро запускает всего шесть CTA, что означает, что большинство из 132 SM графического процессора простаивают. Объединение этих операций в один запуск помогло бы сократить эти потери.
Вывод: алгоритм слияния ядер должен учитывать загрузку, а не только память.
К чему привели эти выводы
Каждое из этих открытий подчеркивает ограничения Inductor, из-за которых GPU используется не полностью. Сосредоточившись на нашей более широкой цели — создании системы следующего поколения для оптимизации инференса, мы обратились к противоположной стороне спектра: мегаядрам (megakernels). Если бы мы полностью отказались от компиляторов, управляя всеми уровнями стека вручную, откуда на самом деле взялся бы прирост производительности? Понимая это, мы надеялись найти золотую середину, автоматизировав производительность мегаядер с минимальной сложностью.
Часть 2: Мегаядра
С тех пор как мы представили мегаядра, они вдохновили растущее число работ по созданию ИИ-компиляторов и систем выполнения для GPU следующего поколения. В этом разделе мы вернемся к тому, почему мы их создали, как они работают и что произошло, когда мы попытались внедрить их в производство.
Что послужило мотивацией для создания мегаядер? Мы выявили три источника неэффективности в обычных движках инференса, которые обычно выполняют модели как последовательности ядер с использованием таких фреймворков, как Torch Compile и CUDA Graphs:
- Накладные расходы на запуск ядра. Каждый запуск ядра влечет за собой накладные расходы на планирование и диспетчеризацию. CUDA Graphs существенно снижают накладные расходы на запуск CPU, но не устраняют все затраты, связанные с выполнением последовательности отдельных ядер GPU.
- Ограниченное перекрытие. Границы обычных ядер могут препятствовать полезному перекрытию операций. Например, веса следующего слоя могут быть предварительно загружены из памяти GPU, пока текущий слой еще вычисляется, что позволяет выполнять передачу данных и арифметические операции одновременно.
- Дисбаланс нагрузки. GPU содержит множество потоковых мультипроцессоров (SM), и работа редко распределяется между ними идеально. Некоторые SM могут завершить назначенные им блоки потоков раньше других, оставляя вычислительные ресурсы простаивающими. Более гибкий планировщик мог бы перераспределять работу по мере освобождения SM.
Чтобы устранить эти неэффективности, мы разработали мегаядра на основе одного постоянного ядра GPU, которое выполняет весь прямой проход модели. Вместо запуска нового ядра для каждой операции мы сохраняли блоки потоков в памяти GPU и планировали последующие операции внутри них. Мы использовали специализированные варпы (warps) для координации выполнения, управления ресурсами, такими как общая память, и распределения единиц работы между различными SM. Мы также разделили общую память на страницы фиксированного размера, что позволило операциям динамически выделять и освобождать емкость общей памяти по мере выполнения.
Результатом стала высокооптимизированная система выполнения, способная устранить промежуточные запуски ядер, перекрывать работу между операциями и динамически управлять ресурсами GPU. На Llama 1B наше мегаядро достигло 990 TPS, что на 48% лучше, чем 669 TPS у Inductor. Но это также потребовало от нас самостоятельного создания значительной инфраструктуры планирования, синхронизации и управления памятью.
Затем мы попытались внедрить мегаядра в производство.
В Together AI во второй половине 2025 года один из членов нашей 🐐исследовательской группы потратил месяцы на борьбу с производственными движками вывода: интеграцию постраничного кэша KV, перенос на графические процессоры Blackwell, отладку состояний гонки и решение множества деталей реализации, возникающих вне контролируемых тестов.
И после всех этих усилий у нас в итоге получилось... одно мега-ядро Llama 1B, поддерживающее один размер пакета (1), одну точность (BF16) и одного клиента.
Производительность была впечатляющей. Гибкость — нет.
Этот опыт оставил нас с вопросом: были ли мега-ядра быстрыми потому, что всё выполнялось внутри одного гигантского ядра, или потому, что они позволяли реализовать несколько ценных оптимизаций — устранение накладных расходов на запуск, перекрытие операций и балансировку нагрузки между SM?
Чтобы исследовать это, мы начали с Torch Compile на уровне 669 TPS и систематически, одно за другим, исключали каждую оптимизацию, которую предоставляют мега-ядра. Мы обнаружили, что всего с двумя примитивами NVIDIA и стандартными ядрами, сгенерированными Inductor, мы можем достичь производительности, эквивалентной нашей оптимизированной базовой линии. Этот результат удивителен, учитывая, что многие исследовательские группы создали гораздо более сложные компиляторы и системы мега-ядер, которые не достигают этой цели. В конечном итоге мы обнаружили, что мега-ядра были неверной целью для системы по двум основным причинам.
Во-первых, устранение запуска ядер и перекрытие операций на самом деле не требуют мега-ядра. Во-вторых, различное оборудование и современные архитектуры моделей обнажают жесткость и неоптимальность мега-ядер.
Устранение накладных расходов на запуск ядра и перекрытие операций не требует мега-ядра.
Мега-ядра предоставляют чистую абстракцию для обеспечения мелкозернистого перекрытия между вычислительными операциями и операциями с памятью. Достижение этого перекрытия сводится к трем основным вещам: минимизации накладных расходов на запуск ядра, уменьшению эффектов «хвоста» от простаивающих SM и перекрытию предварительной выборки памяти с вычислениями. Мы подробно рассмотрим каждый из этих пунктов ниже, а также объясним, почему единое постоянное ядро не требуется для полного достижения этих трех целей.
Накладные расходы на запуск. Накладные расходы на запуск ядра обходятся дорого. В PyTorch операции GPU проходят через механизм диспетчеризации ATen для выбора производительной реализации на основе форм входных данных, типов данных и макетов. Это стоит 37 микросекунд для нисходящей проекции H100 Llama 1B, что более чем вдвое превышает время выполнения самого ядра на GPU, составляющее 15 микросекунд. Полное удаление PyTorch и запуск чистого C++ все равно обходится примерно в 2 микросекунды на запуск, что суммируется при сотнях ядер в типичном прямом проходе.
Предписанным решением от PyTorch являются CUDA Graphs — функция уровня драйвера, которая захватывает последовательность операций GPU и воспроизводит её со значительно меньшими накладными расходами на запуск со стороны CPU. В обмен на то, что захваченный граф занимает память GPU, накладные расходы на запуск снижаются примерно до 1 микросекунды. Благодаря этому дополнению, поверх Torch Compile, наша производительность Llama 1B увеличивается до 864 TPS, что составляет 87% от производительности мега-ядра.
Чтобы еще больше сократить разрыв, мы изучили Programmatic Dependent Launch (PDL) — механизм CUDA, который позволяет последующему ядру начать выполнение до завершения предыдущего. Концептуально PDL позволяет аппаратному обеспечению распределять блоки потоков следующего ядра в SM по мере их освобождения. В то время бэкенд Triton в Torch Inductor не предоставлял нужных нам элементов управления PDL, поэтому мы скомпилировали сгенерированные ядра в PTX (низкоуровневый язык инструкций GPU от NVIDIA) и вставили две инструкции: griddepcontrol.launch_dependents в конце каждого ядра-производителя и griddepcontrol.wait в начале ядра-потребителя для обеспечения синхронизации. С этими небольшими модификациями наша производительность достигает 953 TPS, что составляет 96% от производительности мега-ядра.
Как для CUDA graphs, так и для PDL накладные расходы на запуск по-прежнему ненулевые. Однако мы замечаем, что мега-ядро также не избавляется от этих накладных расходов; оно просто меняет накладные расходы на запуск на аналогичные затраты на синхронизацию внутри ядра.
В таблице выше стоимость — это время от конца первого ядра до завершения примитива синхронизации (если применимо) во втором ядре. Для PDL, если учитывать только время между ядрами, фактический разрыв между ядрами составляет 577 нс и 516 нс соответственно. Интересно, что внутриядерная синхронизация немного медленнее на B200, чем на H100, поскольку B200 разделен на два отдельных кристалла. Стоимость синхронизации, измеренная на одном кристалле, соответствует стоимости для эквивалентного количества SM на H100.
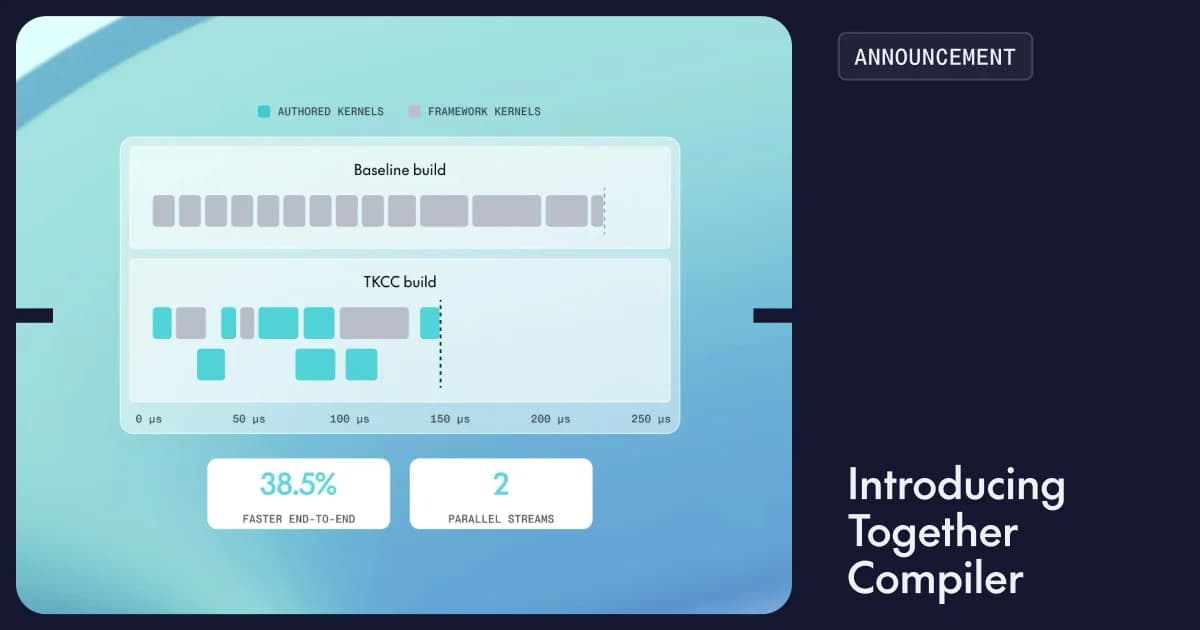
Перекрытие вычислений. Квантование волн происходит, когда работа неравномерно распределяется между SM ядра, оставляя некоторые SM простаивающими до тех пор, пока не завершится самый медленный. Мега-ядра могут уменьшить эти потери, позволяя CTA, завершившему свою операцию, немедленно начать следующую инструкцию, вместо того чтобы ждать завершения всей сетки. Однако это преимущество на практике ограничено, поскольку слои содержат присущие им точки сериализации, которые не может устранить ни одна структура ядра.
В нашем мега-ядре Llama 1B H100 три из пяти барьеров «производитель-потребитель» на слой требуют полного барьера, а четвертый фактически является полным (один CTA вторичного ядра зависит от 128 CTA предыдущего):
Это существенно, поскольку означает, что большинство вычислительных варпов в слое часто не могут продвинуться вперед, так как должны ждать завершения CTA от предыдущей инструкции. Эти полные барьеры сводят на нет преимущества постоянных ядер, при этом полная синхронизация сетки внутри ядра стоит столько же, сколько запуск совершенно нового ядра. Модифицировав наш старый мегапрофайлер для захвата начала и конца вычислительных варпов (а не только момента, когда SM впервые входит в них), мы можем увидеть, сколько полезной вычислительной работы выполняется заранее. Ниже показано идеализированное перекрытие, которое рекламируют мега-ядра, по сравнению с более реалистичным представлением. Примечательно, что только инструкция внимания способна воспользоваться преимуществом перекрытия вычислений.
Перекрытие памяти. Наше предыдущее мега-ядро делило общую память каждого SM на страницы, которые инструкция освобождает, как только заканчивает работу с ними, позволяя следующей инструкции начать предварительную выборку своих данных в освободившееся пространство, пока текущая завершается. Однако эта оптимизация дает лишь 3,3% от полного выполнения прямого прохода. Без какой-либо предварительной загрузки памяти наш показатель TPS падает лишь с 990 до 961.
Хотя выгода невелика, нам было любопытно узнать, необходимы ли причудливые механизмы постраничной организации памяти для достижения тех же результатов предварительной выборки памяти. Для этого мы дополнительно продвинули PDL за счет мелкозернистого размещения его инструкций. Вставив инструкцию griddepcontrol.wait непосредственно перед первым чтением выходных данных предшественника, ядро-потребитель может предварительно загрузить веса, пока предыдущее ядро все еще выполняет вычисления. Этот простой подход позволяет PDL восстановить до 98% прироста от постраничной предварительной загрузки памяти.
Предварительная загрузка в стиле Megakernel также влечет за собой дополнительные расходы, которых позволяет избежать PDL. Варпы загрузчика, ожидающие завершения предыдущей операции, остаются резидентными в SM и выполняют опрос. Эти опросы проходят через ту же очередь SM, которую вычислительные варпы используют для своих перестановок (warp shuffles), и когда эта очередь заполняется, вычислительные варпы простаивают. На границе attention-oproj в Llama 1B варп загрузчика oproj вращается в цикле, ожидая завершения операции attention, что добавляет 1,3 мкс накладных расходов по сравнению с простым PDL.
Ранняя предварительная загрузка весов также может быть бессмысленной. Перекрытие загрузок из памяти помогает только тогда, когда ядро-производитель оставляет пропускную способность памяти незадействованной. На границе downproj-QKV в Llama 1B пропускная способность уже полностью насыщена, что означает, что ранняя загрузка весов QKV замедляет downproj на 2,2 мкс, но ускоряет операцию QKV на аналогичную величину. Следовательно, эта пара занимает столько же времени, если запускается как два отдельных ядра без какого-либо перекрытия памяти.
Наш предыдущий Hazy Megakernel позволял выполнять упреждающую выборку (lookahead prefetching) за пределами непосредственно следующей операции. Это позволяло up-projection в Llama 1B начать загрузку весов, пока операции oproj и attention еще выполнялись. Один лишь PDL не может этого сделать, поскольку он предполагает единый поток выполнения. Однако запуск выделенных ядер предварительной выборки L2 может дать аналогичный эффект.
Подводя итог, можно сказать, что стандартные ядра PyTorch Inductor с графами CUDA и мелкозернистым PDL способны достичь 975 TPS, что составляет 98% от производительности написанного вручную и оптимизированного базового мегаядра, без написания единого ядра или использования сложных интринсиков. Только с помощью графов CUDA и PDL каждое из преимуществ мегаядра, связанных с сокращением накладных расходов на запуск и максимизацией перекрытия, было достижимо по отдельности.
Альтернативное оборудование и современные архитектуры моделей обнажают жесткость мегаядер
Показав, что простые примитивы могут восстановить почти всю производительность мегаядра, оставался более широкий вопрос: бывают ли случаи, когда мегаядра не просто излишни, но и субоптимальны? Мы обнаружили, что монолитная архитектура мегаядер вредна, поскольку ограничения аппаратных ресурсов и современные архитектуры моделей требуют гибких, нестатичных проектных решений.
Постоянные ядра вынуждают идти на аппаратные компромиссы. Мегаядра навязывают фиксированный объем запуска для всех инструкций, ограничивая проектирование ядер. От количества варпов до бюджета регистров и конфигурации кластеров — все операции должны соответствовать друг другу. Регистры распределяются на каждый CTA во время планирования из файла регистров объемом 65 536 на SM. Наше мегаядро H100 Llama-1B использовало 20 варпов (16 вычислительных варпов плюс 4 управляющих варпа), так как короткие инструкции декодирования с размером пакета 1 завершаются быстрее, когда их строки распределены по большему количеству варпов. Однако более тяжелые GEMM тензорных ядер лучше всего работают с 12 варпами. Это связано с тем, что wgmma в Hopper накапливает данные в регистрах, и при количестве варпов более 12 лучшие тайлы больше не помещаются в регистровую память. Если бы мы принудительно втиснули эту операцию в ту же инструкцию на 20 варпов, GEMM работали бы в 1,2–1,5 раза медленнее. Хотя на Blackwell это не является проблемой, так как tcgen05 накапливает данные в тензорной памяти, это все еще существенно, поскольку альтернативное оборудование, например от AMD, сталкивается с теми же ограничениями.
Мегаядра также создают нагрузку на кэш инструкций SM — небольшой буфер, в котором хранится машинный код, активно выполняемый SM. Упаковка всей модели в бинарный файл обходится дорого и создает машинный код, который часто больше, чем может вместить кэш инструкций. Чтобы освободить место при начале новой операции, SM вытесняет инструкции предыдущей операции. Это добавляет дополнительные накладные расходы, так как ядру затем приходится повторно извлекать вытесненные инструкции из памяти, когда та же операция повторяется позже.