Рабочие нагрузки инференса ИИ динамичны. Существуют тысячи режимов, охватывающих новые модели, аппаратные платформы, клиентов, сценарии использования и профили трафика. Оптимизация каждого из этих режимов вручную больше не масштабируется.
- Архитектуры крайне вариативны: прошло около 11 лет с момента появления Transformer. Можно было ожидать большей консолидации, но ни одна из 10 лучших моделей с открытым исходным кодом на OpenRouter не использует одинаковую архитектуру!
- Рабочие нагрузки крайне вариативны: Together обслуживает множество триллионов токенов в день для тысяч клиентов, каждый из которых имеет свой собственный профиль трафика (размер батча, длина последовательности, дисбаланс экспертов MoE, разреженность внимания, продолжительность сеанса, домен).
- Оборудование крайне вариативно: H100, B200, B300, NVL72, VR, Groq и другие требуют собственных уникальных стратегий.
Теоретически агенты отлично подходят для этой задачи. Они могут адаптироваться к новым рабочим нагрузкам и осуществлять поиск по пространству возможных оптимизаций, не полагаясь на фиксированные правила или эвристики, от которых страдают эксперты-люди и традиционные компиляторы машинного обучения. Однако современные агентские системы упираются в бутылочное горлышко скорости экспериментов.
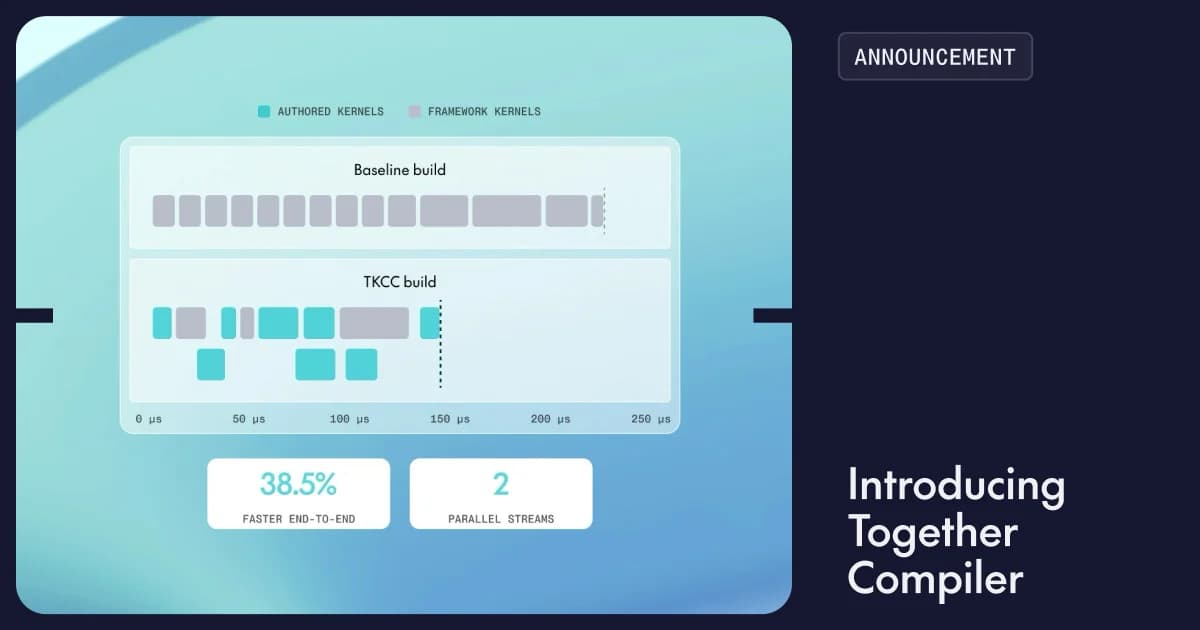
Мы представляем Together Compiler (TKCC) — первую по-настоящему непрерывную RSI-систему, которая использует высокопроизводительные агенты для оптимизации под разнообразные рабочие нагрузки инференса. Менее чем за 24 часа TKCC достигает в 1,3–3 раза более высокого показателя TPS для передовых моделей с открытым исходным кодом (Kimi K3, GLM 5.3, MiniMax M3.1-Flash, DeepSeek v4.1-Flash), устанавливает рекорд производительности в бенчмарке InferenceX от SemiAnalysis для сценариев с низкой задержкой, показывая 1111 TPS на MiniMax M3.1-Flash и 1205 TPS на DeepSeek v4.1-Flash, а также превосходит доступные мегаядра с открытым исходным кодом в 1,7 раза на их базовой рабочей нагрузке Llama 1B при размере батча 1. Кроме того, TKCC масштабируется на домены за пределами инференса языковых моделей (моделирование погоды, уравнения в частных производных, временные ряды и биология). Такой прирост производительности обеспечивается тем, что пропускная способность экспериментов TKCC в 252 раза выше по сравнению с базовыми системами оптимизации производительности на основе агентского RSI. Together Compiler обслуживает триллионы токенов уже сегодня.
Трафик постоянно меняется
Как провайдер инференса, мы наблюдаем разнообразие пользовательского поведения, зависящее от региональных паттернов, релизов новых моделей и скачкообразности.
- Региональные паттерны: у пользователей по всему миру могут быть разные предпочтения в отношении моделей. Мы заметили, что в рабочие часы в одной стране промты на 1,4 раза длиннее, чем в другой (97 тыс. против 70 тыс.).
- Релизы моделей: пользователям требуется время, чтобы разобраться, как интегрировать релизы новых моделей в свои рабочие процессы. Сначала они склонны выбирать чат-взаимодействие и оценку. За этим быстро следует увеличение длины промтов на 80% всего через две недели после релиза, поскольку пользователи переходят к агентским рабочим нагрузкам.
- Скачкообразность: клиенты могут отправлять всплески запросов в случайные моменты в течение дня. Длина промтов может внезапно удвоиться, а коэффициенты попадания в кэш упасть, если не подойти к этому вопросу с осторожностью.
Очевидно, что мы должны адаптироваться к постоянно меняющемуся поведению пользователей с помощью специализированных оптимизаций для каждого нового развертывания.
Обзор Together Compiler
TKCC принимает на вход профиль трафика, модель и аппаратное обеспечение. TKCC использует агенты для генерации серии оптимизаций для движка инференса.
Основные идеи, заложенные в TKCC, заключаются в следующем:
1. TKCC максимизирует пропускную способность экспериментов и минимизирует время простоя GPU во время оптимизации агентами
Большинство существующих агентских RSI-систем инференса требуют, чтобы агенты запускали и завершали работу таких движков, как VLLM, SGLang или TRT-LLM, для тестирования каждого нового эксперимента. Однако время запуска движков составляет десятки минут, что существенно снижает пропускную способность экспериментов (см. таблицу ниже). Вместо этого TKCC предлагает новую парадигму «персистентных движков», где движок запускается один раз и может «на лету» перезагружать любой кандидатный проход вперед (forward pass) без каких-либо перезапусков. Чтобы гарантировать постоянное наличие новых оптимизаций для тестирования в персистентных движках, TKCC порождает несколько агентов, которые непрерывно генерируют идеи и общаются через доску объявлений для распараллеливания своих усилий.
Таблица 1: Запуск движка требует больших затрат
2. TKCC балансирует компромисс между пропускной способностью измерений и их точностью (фиделити)
Существующие системы оптимизации движков либо итеративно перезапускают движок инференса, страдая от низкой пропускной способности экспериментов, либо оптимизируют изолированные ядра отдельно от движка инференса, страдая от низкой точности измерений. Системы, оптимизирующие автономные ядра, часто оценивают их с использованием случайных входных данных. Однако в современных архитектурах, использующих зависящие от данных примитивы, такие как MoE и разреженное внимание (sparse-k attention), распределения входных данных оказывают прямое влияние на то, какие стратегии оптимизации окажутся выигрышными (см. рисунок ниже). Высокоточные входные данные важны для эффективной оптимизации. TKCC использует уровень персистентных движков для балансировки компромисса между пропускной способностью и точностью: «быстрые движки» загружают несколько слоев и идеально подходят для быстрой итерации и замеров с низким разбросом, в то время как «более медленные движки» загружают много слоев и идеально подходят для тестирования того, сохраняются ли оптимизации на реальных распределениях данных.
3. TKCC использует пользовательскую модель стоимости для выбора стратегий параллелизма (например, TP, EP, DCP и т. д.) для агентов с целью достижения наивысшей производительности
Существующие системы имеют сложные методы выбора конфигураций инференса в соответствии с требованиями соглашений об уровне обслуживания (SLA). Тем не менее, выбор идеальной конфигурации сталкивается с тем же компромиссом между пропускной способностью и точностью: измерение каждой конфигурации параллелизма является непрактичным, особенно из-за незрелости программных реализаций. Наивный подход заключается в выборе стратегии параллелизма на основе «сырых» спецификаций оборудования или микробенчмарков. Однако это недостаточно хорошо отражает зависящие от данных свойства трафика, такие как дисбаланс экспертов MoE или неравномерное распределение длины промтов. Мы разработали модель стоимости, которая использует многоуровневую стратегию измерений, включающую спецификации оборудования, микробенчмарки и измеренные проходы вперед, для создания высокоточной репрезентации при одновременном быстрой отсечке пространства поиска конфигураций для поддержки постоянного дрейфа трафика.
Результаты
Мы оцениваем TKCC по трем различным типам базовых показателей (базовых линий): настроенные вручную мегаядра, конфигурации движка InferenceX и популярные ИИ-кодовые базы из различных доменов, таких как моделирование погоды, уравнения в частных производных, временные ряды и биологические модели.
Рабочие нагрузки MegaKernel
Мы начинаем с оценки канонической рабочей нагрузки MegaKernel: Llama 1B при размере батча 1. Эта архитектура модели хорошо оптимизирована как экспертами-людьми, так и традиционными компиляторами машинного обучения. TKCC генерирует в 1,7 раза более высокий TPS и продолжает демонстрировать высокую производительность по мере увеличения длины последовательности.
Рабочие нагрузки InferenceX AgentX
Мы оцениваем TKCC на бенчмарке AgentX от SemiAnalysis. Мы отталкиваемся от наилучших заявленных конфигураций с открытым исходным кодом для передовых моделей на различных движках инференса и аппаратных платформах. TKCC стабильно задает планку производительности во всех режимах, превосходя высоко оптимизированные базовые линии в 1,3–3 раза по показателю TPS.
Мы также проводим специальную оценку для сценария использования с низкими задержками при размере батча 1 и устанавливаем передовой уровень производительности: 1111 TPS на MiniMax M3.1-Flash и 1205 TPS на DeepSeek v4.1-Flash. Для получения этих результатов мы используем нашу модель стоимости для выбора конфигурации параллелизма вместо конфигурации InferenceX. При таком подходе мы наблюдаем ускорение.
В различных нагрузках ИИ
Мы выбираем популярные кодовые базы с открытым исходным кодом в области моделирования погоды, уравнений в частных производных (PDE), временных рядов и биологии. Мы демонстрируем среднегеометрическое ускорение TKCC по сравнению с простым использованием Claude Code с командой /goal, что иллюстрирует обобщаемость принципов TKCC в различных предметных областях. Мы используем TKCC в качестве универсального компилятора ИИ, выходящего за рамки инференса LLM.
Полиморфные ИИ-системы — это следующий рубеж
Для Together AI самой захватывающей системной задачей стал полиморфный инференс (Polymorphic Inference). Инференс больше не сводится к оптимизации под единый профиль трафика для одной аппаратной платформы и модели: трафик постоянно и динамично меняется, во многом напоминая финансовые рынки, и эта динамика породила целый ряд новых исследовательских задач.
Ознакомьтесь с нашей научной статьей, чтобы узнать больше.
И если эти рубежи ИИ-систем вызывают у вас интерес, смело обращайтесь к нам!
Trainium2 запускался на синтетическом многошаговом датасете (70 тыс. входных токенов, 3,5 тыс. новых входных токенов, кэшированных на 95%, 700 выходных токенов) вместо AgentX, так как наша реализация пока не поддерживает более высокую степень параллелизма при ограниченном объеме HBM.