Резюме
В Together AI мы стремимся сделать искусственный интеллект общедоступным для каждого пользователя и организации. Наша исследовательская команда — исследователи, создавшие FlashAttention, ThunderKittens, ThunderAgent и многое другое — стала главным драйвером нашего превосходства в области инференса. По мере экспоненциального роста рынка инференса мы сосредоточились на том, как масштабировать наш исследовательский потенциал для обеспечения всеобщего изобилия интеллекта.
Это потребовало смены парадигмы мышления со статического инференса на полиморфный, что является нашей реакцией на скорость выхода новых моделей, разнообразие их архитектур, быстро меняющиеся рабочие нагрузки и аппаратные платформы. В этом блоге мы расскажем о нашей исследовательской повестке на эпоху полиморфного инференса и о том, как мы непрерывно используем ИИ-агенты для оптимизации собственного процесса вывода с помощью Continuous Compilation.
Что такое полиморфный вывод?
За последний год произошел заметный качественный сдвиг в разнообразии моделей с открытым исходным кодом и в способах их развертывания в производственных средах. Мы считаем, что этот сдвиг требует нового подхода, который мы называем полиморфным выводом (Polymorphic Inference).
Полиморфный вывод (инференс во «множестве форм» от греческого) — это ответ на ряд изменений, которые мы наблюдаем в индустрии, и для нас они определяются прежде всего схождением нескольких тенденций:
- Растущая скорость выпуска моделей. Модели с открытым исходным кодом выходят быстрее и отличаются гораздо большим разнообразием, чем когда-либо прежде. 80% трафика на OpenRouter приходится на модели, выпущенные за последние три месяца.
- Растущее разнообразие архитектур моделей. Все десять самых популярных OSS-моделей, используемых сегодня, применяют разные архитектуры (не говоря уже о множестве закрытых архитектур, обслуживаемых нашими партнерами).
- Постоянно эволюционирующие формы трафика. Мы ежедневно обслуживаем новых пользователей, организации и регионы в рамках широкого спектра форм рабочей нагрузки и соглашений об уровне обслуживания (SLA). Продуктовые или алгоритмические изменения в инфраструктуре и постретрейнинг моделей с открытым исходным кодом могут приводить к изменениям профиля трафика (например, новый этап постретрейнинга увеличивает количество токенов, которые модель тратит на «размышления» в обмен на более высокое качество).
- Аппаратное обеспечение меняется все быстрее и чаще. Мы наблюдаем серьезные изменения в возможностях обслуживающего инференс оборудования от B200 до GB300 и находимся на пороге первых развертываний Vera Rubin (не говоря уже об оптимизациях на уровне CPU, продвинутых системах хранения и альтернативных чипах для инференса).
Полиморфный вывод — это наш ответ на данные изменения; это инференс, который меняется и адаптируется к столь стремительно развивающимся средам.
Мы противопоставляем это положению дел до взрыва популярности OSS-инференса — периоду, который мы задним числом называем эпохой «статического инференса». Если современный полиморфный вывод принимает бесконечное множество различных форм, то статический вывод определяется закрытыми моделями, традиционными архитектурами Transformer, а также инференсом для одного пользователя и одной аппаратной платформы.
От статического инференса к полиморфному
Одна из причин написания этого поста в блоге заключается в том, что дискуссии об инференс-системах по-прежнему во многом сосредоточены на устаревшей парадигме статического инференса.
- Например, типичный рецепт vLLM, SGLang или InferenceX / AgentX в интернете запускается со статической конфигурацией движка вывода с настроенными гиперпараметрами. Конфигурация, оптимизированная для одной обстановки, не обязательно будет лучшей для другой.
- Оптимизированные ядра с открытым исходным кодом часто выпускаются в предположении определенных статических форм трафика и проектных решений, которые могут не соответствовать реальному производственному трафику. Классический пример — ядра MoE; ядро MoE, хорошо работающее со случайными токенами, может не подойти для реальных рабочих условий.
Мы отчасти берем вину на себя! Долгое время была возможность создавать ядра, оптимальные для самых разных условий. FlashAttention, близкий и дорогой нашему сердцу, по-прежнему остается одним из лучших инструментов для запуска тренировочных рабочих нагрузок и многих задач префилла.
Почти два года назад мы писали о мегаядрах для ИИ-инференса — едином ядре, тщательно спроектированном под одну статическую форму (например, размер батча один для Llama 1B). Но на основе опыта внедрения одних из первых мегаядер в продакшн для наших клиентов в прошлом году мы вынесли интересный урок: слияние мегаядер на самом деле не является правильной целью проектирования для современного полиморфного вывода! В эпоху полиморфного инференса каждая вариация — от архитектуры модели (например, MoE) до рабочей нагрузки (динамические нагрузки при размере батча больше 1) — требует разных технических подходов.
Оптимизация полиморфного вывода для разнообразных и быстро меняющихся условий
В Together мы в душе системные исследователи и исследователи в области ИИ, поэтому мы считаем это невероятно захватывающим временем для пересмотра нашей исследовательской повестки ради этого светлого нового будущего.
Итак, каково же решение, когда ваш производственный трафик становится все более разнообразным? Заставьте ИИ-агентов оптимизировать самих себя. Это момент RSI для OSS-моделей!
Достижение полиморфного вывода требует решения ряда технических задач, связанных с тем, как мы обслуживаем модели. Идеальный полиморфный инференс — это тот, который реагирует на стремительно меняющийся ландшафт архитектур моделей и рабочих нагрузок.
Например:
- Если форма вашего трафика меняется — будь то из-за изменения продукта или поведения пользователя — вы должны ожидать, что ваша инференс-система быстро адаптируется.
- Если вы развертываете рабочие нагрузки на новой модели, вы должны ожидать, что ваш провайдер инференса в кратчайшие сроки приблизится к идеальным базовым показателям ручной настройки.
- Если у вас есть существующий продукт со стабильным пользовательским трафиком и вы развертываете его на новой аппаратной платформе, вы должны ожидать, что производительность максимально быстро приблизится к аппаратным пределам.
Это высокие цели, но мы верим, что к ним стоит стремиться. Для нас один из ключей к достижению этих целей — заставить ИИ-агенты помогать в собственной оптимизации. Цикл RSI уже здесь для OSS-моделей!
Continuous Compilation вместе с Together Compiler
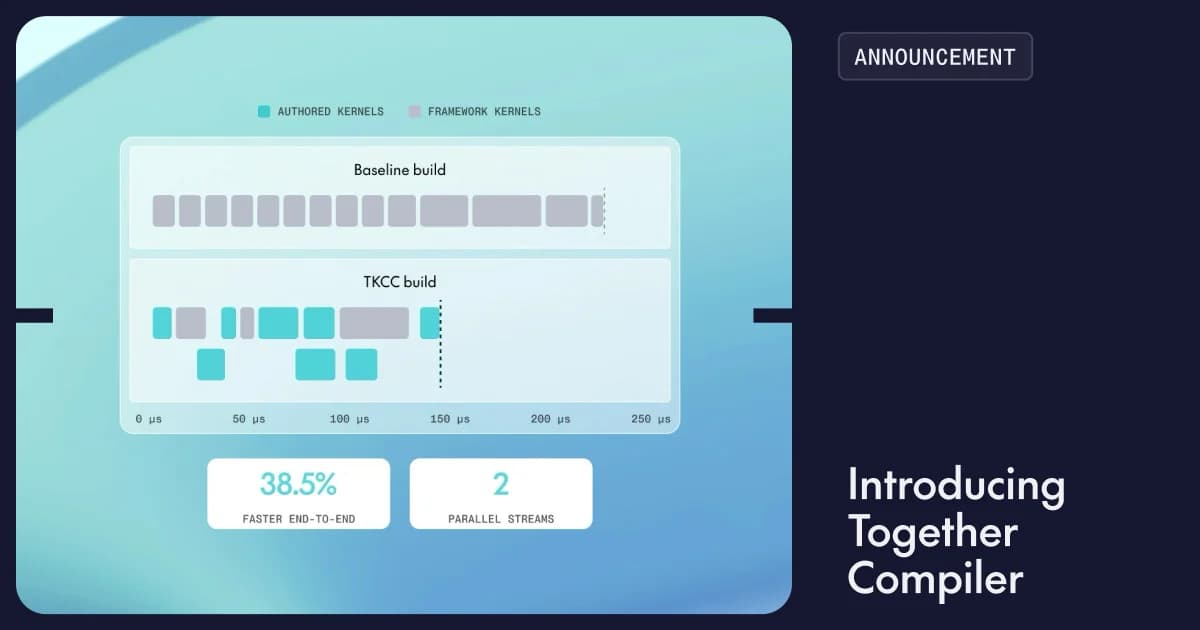
Один из проектов, о запуске которого мы объявляем сегодня в качестве первого шага к достижению наших целей в области полиморфного инференса, — это Together Compiler, быстрый цикл RSI для оптимизации производительности на базе ИИ. Сегодня Together Compiler обеспечивает работу циклов оптимизации Continuous Compilation для многих из наших основных производственных нагрузок инференса.
Together Compiler берет классическую задачу оптимизации рабочих нагрузок инференса и переосмысляет ее, переводя из традиционной проблемы компиляторной трансляции в проблему агентного поиска. Together Compiler определяет базовый набор ключевых паттернов оптимизации и объединяет рой агентов с высокоточной постоянной средой для быстрых итераций. Эта работа стала результатом многомесячного труда команды Frontier Performance в Together, особенно Реи Абхьянкар (Reyna Abhyankar) и Дилана Лима (Dylan Lim)!
Together Compiler уже работает в продакшене на некоторых из наших самых популярных бессерверных эндпоинтов, где он обеспечил дополнительный прирост производительности поверх и без того высоко оптимизированного кода.
Удивительно, но Together Compiler дает нам возможность быстро адаптироваться к стремительно меняющимся архитектурам моделей и нагрузкам трафика. Мы называем эту возможность непрерывной компиляцией (Continuous Compilation). Если раньше для новых рабочих нагрузок требовались новые наборы написанных вручную ядер и оптимизаций, то непрерывная компиляция на базе Together Compiler означает, что мы можем автоматически адаптироваться к новым профилям трафика и нагрузкам.
Что дальше ждет исследовательскую команду Together AI
Мы многое узнали, масштабируя Together AI для обработки триллионов токенов в день (а в начале октября впервые даже обработали больше токенов, чем лаборатории закрытых моделей на OpenRouter!). Это сформировало наше видение и план исследований для эпохи полиморфного инференса (Polymorphic Inference). Вот небольшой предварительный обзор некоторых направлений из нашего исследовательского плана:
Самостоятельная непрерывная компиляция с Together Compiler
Оптимизация производительности должна зависеть от развертывания рабочей нагрузки: модели, движка, профиля трафика и вариантов использования клиентом. Скоро наши клиенты смогут использовать Together Compiler для оптимизации своих выделенных эндпоинтов под уникальные рабочие нагрузки всего одним нажатием кнопки.
Together Compiler доступен конечным клиентам в режиме ограниченной бета-версии уже сегодня — свяжитесь с нами, если хотите получить ранний доступ!
Динамическая спекулятивная декомпиляция (Shape-shifting speculative decoding)
Конфигурации инференс-движков, предлагаемые в репозиториях с открытым исходным кодом, VLLM, InferenceX, AgentX, запускают движок с фиксированной вспомогательной моделью спекулятивного декодирования и параметром опережения. Спекулятивное декодирование должно адаптироваться для каждого домена, каждого запроса, каждого токена и в зависимости от нагрузки трафика.
Маршрутизатор ThunderAgent Router: маршрутизация между гетерогенными развертываниями
Бессерверные эндпоинты инференса обслуживают огромное количество пользователей, каждый из которых предъявляет свои собственные требования к профилям трафика и соглашениям об уровне обслуживания (SLA). Эта гетерогенность требует от нас динамической маршрутизации запросов между воркерами и конфигурациями развертывания в наших кластерах. Мы выпустили ThunderAgent в качестве докладной статьи (Spotlight) на ICML 2026, чтобы поделиться первыми выводами, и развили эти основы в продакшене.
Постобучение Together (Together Post-Training)
Несколько клиентов теперь хотят внедрить бэкенды моделей с открытым исходным кодом в свои ИИ-приложения. Это требует выбора модели с открытым исходным кодом, выбора и настройки обвязки (harness) под конкретные вызовы инструментов и варианты использования клиентом, а также постобучения модели для эффективного взаимодействия с этой обвязкой. Наши тесные партнерские отношения с такими лабораториями моделей, как Moonshot, Minimax и другими, позволяют нам помогать нашим клиентам настраивать модели с открытым исходным кодом под их собственные варианты использования и действительно владеть своим стеком интеллекта.
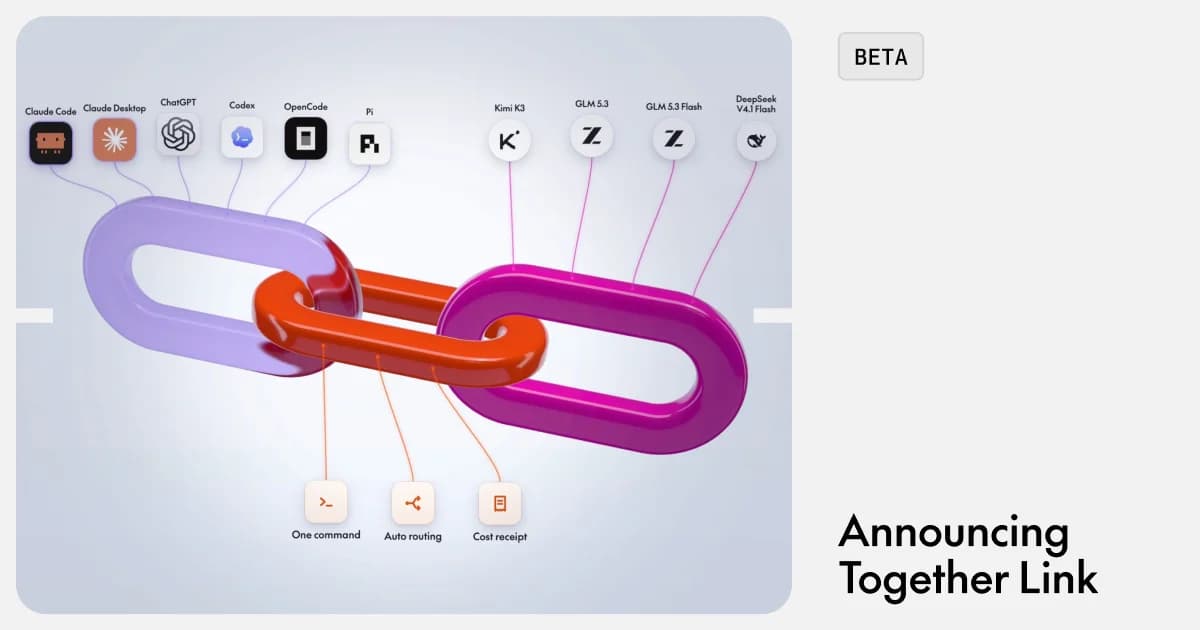
TogetherLink: маршрутизация моделей с учетом рабочей нагрузки
По мере совершенствования моделей с открытым исходным кодом ключевой задачей становится донесение их до каждого. Распространенно мнение, что модель с закрытым исходным кодом, такая как Opus 5.5, всегда лучше. Но, как неоднократно показывала нам история ИИ, ансамблирование нескольких довольно хороших моделей может определенно превзойти использование одной великолепной модели, если их объединить правильным образом. Это опирается на наши корни в области слабого контроля (weak supervision) в лаборатории Hazy Research Lab в Стэнфорде (Ask Me Anything) и на нашу собственную работу по объединению моделей (Mixture-of-Agents, ICLR 2025).
Изобилие интеллекта для всех
Инференс — одна из самых увлекательных проблем в ИИ-системах, и мы открыли множество новых инсайтов благодаря масштабу, на котором осуществляем обслуживание. Чтобы достичь нашей цели — сделать ИИ доступным для каждого, — наши системы инференса должны непрерывно настраиваться под каждого пользователя и каждую рабочую нагрузку в эпоху полиморфного инференса. Мы рады помочь замкнуть этот круг и сыграть небольшую роль в том, чтобы сделать ИИ-системы по-настоящему рекурсивно самосовершенствующимися.
Если идеи, лежащие в основе полиморфного инференса, близки вашей организации или вашему сценарию использования, пожалуйста, свяжитесь с нами для получения раннего доступа — мы будем рады помочь вам разобраться в этих новых сложностях.
И напоследок: если вы хотите помочь нам вместе решить задачу полиморфного инференса, пожалуйста, загляните на нашу страницу вакансий — мы нанимаем сотрудников!