Ранее в этом году мы начали замечать, что все больше разработчиков используют агентов-кодировщиков для создания продуктов с помощью Together AI.
Причина понятна: разработчику может потребоваться несколько дней или даже недель, чтобы вручную настроить приложение для инференса в продакшене, особенно если он новичок на платформе. Но для агента, использующего наш SDK и CLI, это занимает всего несколько минут — по крайней мере, в теории.
На практике мы понятия не имели, могут ли агенты, работающие с нашей платформой, эффективно взаимодействовать с ней, или же они сталкиваются с препятствиями, заходят в тупик, терпят неудачу и при этом впустую тратят токены.
Поскольку разработчики делегируют агентам все больше своей работы, опыт разработчика (DX) все чаще становится синонимом опыта агента (AX). Чем проще ваше программное обеспечение для использования агентами, тем легче разработчикам внедрять его в свои продукты и рабочие процессы.
GitHub — хрестоматийный пример отличного AX: активность на платформе утроилась за последний год, при этом агенты открывают около 40% всех PR в 2026 году (и, мы готовы поспорить, пишут гораздо больше 40% строк кода во всех коммитах). Это стало возможным благодаря феноменальным API, CLI и документации GitHub, которые делают платформу исключительно удобной для агентов. (Автор этого текста даже не знал, что у GitHub есть CLI, пока агенты не начали использовать его за него, а теперь он, вероятно, использует его более 1000 раз в день).
Чтобы улучшить наш AX в Together AI, нам нужен был способ измерить, насколько наша платформа на самом деле готова к работе с агентами. В этой статье мы расскажем, как мы проводим оценку агентов, с какими двумя проблемами они столкнулись, как мы их решили и что мы узнали в процессе.
Как мы проводим оценку агентов в Together
Составление списка задач
Прежде чем мы смогли начать оценку, нам нужно было понять, что именно агентов просят делать… чтобы, ну вы понимаете, выяснить, могут ли они это делать. Мы начали составлять список типичных задач, с которыми сталкиваются разработчики в Together, например, запуск пакетного инференса, создание голосового агента или управление автомасштабированием для эндпоинта инференса.
Под задачей мы подразумеваем промпт — то, что вы просите сделать агента, например:
Перечислите доступные регионы GPU-кластеров и типы инстансов, выведите самый дешевый вариант и покажите точную команду, которую нужно выполнить, чтобы зарезервировать его по запросу на один час. Не резервируйте его на самом деле.
Чтобы пройти оценку, агент должен:
- Найти актуальную информацию о ценах.
- Вызвать эндпоинт API регионов, чтобы получить список доступных регионов.
- Объединить эти данные, чтобы найти самый дешевый вариант.
- Сформировать корректную CLI-команду для создания кластера.
Промпт требует как информацию о доступности, так и о ценах, не упоминая, что эти данные находятся в двух разных местах. Это реалистично, так как обычный пользователь, скорее всего, не знает заранее, где находится каждая часть информации, что может легко сбить с толку как людей, так и агентов.
Три конфигурации
После составления списка задач мы запускаем каждую из них тремя способами:
- Базовая: Агент получает только промпт без специальной конфигурации, что отражает рабочий процесс обычного разработчика. Он может использовать все свои стандартные инструменты, такие как получение документации из интернета, но мы не предоставляем ему никаких специфических MCP-коннекторов или навыков.
- MCP: Агент получает прямой доступ к нашей документации через наш MCP-сервер, поэтому он точно знает, где искать информацию, когда заходит в тупик.
- Навыки: Мы предоставляем агенту пакет навыков Together, который содержит инструкции и примеры использования наших сервисов, написанные специально для агентов.
Матрица запусков
Каждая полная оценка выполняет каждую задачу для каждой конфигурации агента с использованием трех моделей, при этом на каждую задачу приходится две попытки — итого шесть попыток на задачу для каждой конфигурации, как показано здесь для нашего запуска 30 сентября:
Автоматизация запусков
Когда мы только начинали создавать систему оценки, мы делали все вручную: открывали новый терминал, вставляли промпт в Claude Code, позволяли агенту делать свое дело (или не делать его) и повторяли это для каждой конфигурации. Это было утомительно, поэтому, как только мы определились с форматом системы, мы начали ее автоматизировать.
Теперь мы запускаем каждого агента в «песочнице» Together, чтобы они не мешали нашей локальной среде или друг другу. GitHub Actions берет на себя настройку, запуск агента, очистку после завершения и сохранение результатов, в то время как прокси-сервер обрабатывает запросы агента к API Together и записывает активность, чтобы мы могли видеть, какие эндпоинты вызывает агент и что возвращается в ответ.
Оценка запуска
После завершения запуска LLM-судья просматривает промпт задачи и записанную сессию, а затем выносит один из трех вердиктов:
- Пройдено: Все требования задачи выполнены.
- Неполно: Агент попытался выполнить задачу, но некоторые обязательные шаги остались незавершенными или не были проверены.
- Не пройдено: Агент сдался раньше времени, нарушил явное ограничение или выдал некорректный результат.
Вердикты «Не пройдено» и «Неполно» не обязательно говорят нам, в чем была проблема — в агенте, API или недостающих данных. Они лишь указывают, где начать поиск.
Мы также исследуем успешные запуски. Агент часто может обойти запутанные ответы и все равно завершить задачу, и эти случаи показывают нам, что нужно исправить для повышения эффективности использования токенов.
Чтобы сделать этот анализ практичным, мы создали средство просмотра результатов, которое сравнивает производительность различных моделей и конфигураций. Для каждого запуска оно показывает промпт, инструменты, которые использовал агент, полученные ответы и любую активность API:
Кейс 1: Ценообразование GPU-кластеров
Помните задачу про GPU-кластеры из начала статьи?
Перечислите доступные регионы GPU-кластеров и типы инстансов, выведите самый дешевый вариант и покажите точную команду, которую нужно выполнить, чтобы зарезервировать его по запросу на один час. Не резервируйте его на самом деле.
Казалось бы, все просто, но когда мы проводили оценку в начале прошлого лета, Sonnet 4.6 успешно выполнила задачу лишь в 4 из 15 попыток, даже с включенными навыками.
Наш разбор полетов выявил одну и ту же закономерность в неудачных запусках: Sonnet воспринимала пример вывода в нашей документации CLI, где был указан один регион и два типа GPU, как актуальный инвентарь. Она также пропускала поиск по регионам и называла то, что считала самым дешевым вариантом, не проверяя страницу с ценами.
Проблемы были на нашей стороне. Во-первых, пример вывода не был должным образом помечен, поэтому ничто не подсказывало агенту выполнить команду для получения актуальных данных. Во-вторых, наш файл навыков ссылался на маркетинговую страницу GPU-кластеров, а не на таблицу цен, поэтому Sonnet открывала маркетинговую страницу, не видела там реальных цен и просто делала предположение о самом дешевом доступном GPU.
Более способные модели смогли обойти эту проблему. В тот же период Opus 4.8 успешно выполнила 13 из 14 попыток с той же конфигурацией. Согласно логам, она заметила, что ответ list_regions не включает цены, поэтому продолжала поиск, пока не нашла их в нашей документации. Вот почему крайне важно тестировать свой продукт с менее способными моделями; если бы мы тестировали только с Opus, нам потребовалось бы гораздо больше времени, чтобы обнаружить этот пробел.
Изоляция причины сбоя
Чтобы исправить это, мы изолировали сбой, выделив навык GPU clusters из общего пакета навыков, и написали более узкий промпт, который воспроизводил только эту проблему. Он давал сбой каждый раз при тестировании с использованием старого файла навыка, поэтому у нас появились надежные шаги для воспроизведения (использование старого навыка) и простой способ тестирования каждой новой версии (обновление навыка).
Мы прошли через несколько итераций, пока не пришли к небольшому изменению: два новых предложения в навыке, которые направляют агента к таблице цен и объясняют, как использовать ее с API live regions:
Выполните запрос GET <https://api.together.ai/v1/compute/regions> или запустите tg clusters list-regions --json для получения актуального списка регионов, поддерживаемых типов инстансов и совместимых пар CUDA/драйвер. Откройте таблицу цен на GPU Cluster для получения текущих тарифов по требованию и зарезервированных тарифов.
После этого изменения задача выполнялась успешно в 100% случаев для всех моделей, которые мы тестировали с использованием конфигурации с поддержкой навыков.
Поиск пробелов в нашем API
Та же задача с GPU также выявила проблему в нашем API. В недавнем базовом прогоне Opus 5.5 получил вердикт «неполный», а транскрипт показал, что он зашел в два тупика, которые не были виной модели.
Прогон начался хорошо. Агент вызвал /v1/compute/regions, чтобы получить регионы и типы инстансов. Затем, в поисках цен, он вызвал /v1/compute/instance-types, и API вернул ошибку 400 со следующим сообщением:
Требуется указать регион. Пример: us-central-8. Используйте /v1/clusters/regions для получения списка регионов.
Поэтому агент сделал то, что ему предписывала ошибка:
- Он повторил запрос с регионом из своего первого поиска. Вместо типов инстансов он получил 404.
- Он вызвал /v1/clusters/regions, маршрут, предложенный ошибкой… но этого маршрута не существует, поэтому он получил еще одну ошибку 404.
Наше собственное сообщение об ошибке направило агента по несуществующему маршруту, и повторная попытка, которая должна была сработать, тоже провалилась. Разработчик, следуя этому сообщению вручную, оказался бы в таком же тупике. С тех пор мы исправили сообщение об ошибке, указав на /v1/compute/regions, и устранили ошибку маршрутизации, стоящую за первой 404.
Кейс 2: Перестройка нашего пакета навыков
Раньше мы поддерживали 14 отдельных навыков Together, по одному на каждую поверхность продукта. Использовать их было неудобно: нужно было заранее знать, какие навыки применимы к вашему рабочему процессу, а затем устанавливать и вызывать каждый из них. Навыки также дублировали друг друга, повторяя одни и те же рекомендации по SDK и инструкции по настройке, и каждый из них был настолько длинным, что загрузка нескольких из них одновременно могла перегрузить контекст агента.
В прошлом месяце мы объединили эти 14 навыков в единую версию. Под капотом она по-прежнему модульная: чтобы избежать перегрузки контекста, агент сначала читает короткий маршрутизатор, а затем открывает каждое руководство по продукту, справочный файл или пример скрипта только тогда, когда маршрутизатор сообщает, что это актуально.
Мы надеялись, что один навык превзойдет 14, но чтобы убедиться в этом, мы прогнали унифицированный навык через наши задачи оценки с включенными навыками. Нашей планкой был результат от 30 сентября — 90% успешных прогонов при использовании конфигурации из 14 навыков.
Но новый навык провалился — он прошел только 54 из 72 прогонов (75%), оставил 18 незавершенными вместо 7 и стоил более чем в два раза дороже за прогон.
Поэтому мы изучили транскрипты оценки и изменили навык только там, где прогоны указывали на проблему. Три проблемы возникали постоянно:
- Слишком много контекста: Первый унифицированный маршрутизатор содержал около 14 000 символов, загружался при каждой задаче и предписывал агентам читать каждое руководство полностью. (Вот вам и избегание перегрузки контекста…) В итоге прогоны загружали на 57% больше контента навыков, чем при использовании 14 отдельных навыков. Мы сократили маршрутизатор до менее чем 6 000 символов и закончили каждое руководство по продукту меню, которое кратко описывает, что содержит каждая справка и скрипт, чтобы агенты открывали только то, что им нужно.
- Устаревшая информация о продукте: Некоторые модели, используемые в примерах кода, больше не обслуживались в serverless, а одно руководство по продукту описывало устаревшую функцию. Агенты тратили ходы на восстановление или повторные попытки запросов, которые никогда не увенчались бы успехом. Мы перенесли каждый пример на подтвержденную рабочую модель, сказали агентам проверять каталог вместо повторных попыток и создали облачного агента для автоматического обновления навыка в ответ на изменения продукта.
- Ошибки в примере кода: Небольшие проблемы в скриптах, такие как сохранение байтов JPEG под именем .png, сбивали с толку каждого агента, который их использовал. Мы исправили их в источнике и добавили автоматизацию для периодического тестирования примеров кода в реальном времени, чтобы поддерживать их в актуальном состоянии.
С этими исправлениями унифицированный навык прошел 70 из 72 прогонов, что на 22 пункта лучше нашей первой попытки и на 7 пунктов лучше, чем 14 навыков, с которых мы начинали. Прогоны также занимали в среднем на 20% меньше времени, чем с исходными навыками, а стоимость одного прогона вернулась к исходному уровню.
Где мы находимся после четырех месяцев оценок
Еще в июне наши документы и навыки почти не помогали агентам. 15 июня при запуске Opus 4.8 базовый показатель прошел 75% прогонов. Ни документы MCP (67%), ни навыки (75%) не улучшили производительность.
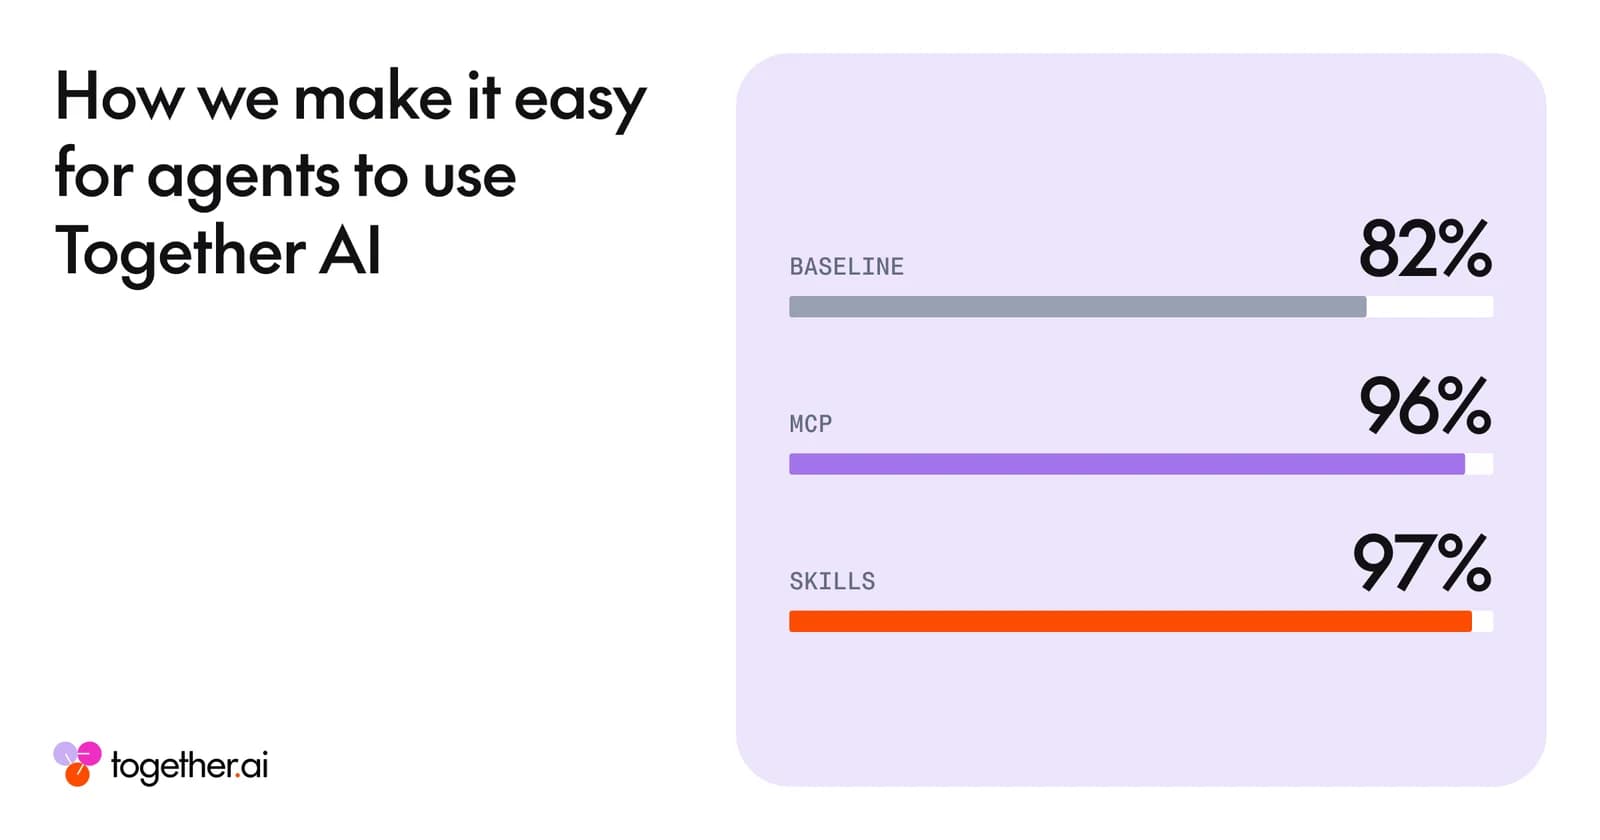
К 30 сентября, по трем моделям, базовый показатель вырос до 82%. Документы MCP были на уровне 96%, а навыки — 90%, при этом новый унифицированный навык достиг 97% 8 октября.
Это не контролируемое сравнение — в снимках использовались разные модели и задачи, поэтому некоторые из этих достижений, несомненно, связаны с улучшениями базовых моделей, а также с улучшениями, которые мы внесли в наш CLI и SDK. Вероятно, это объясняет рост базового показателя на 7 пунктов, но управляемые настройки выросли более чем на 20 пунктов, и мы приписываем этот дополнительный прирост исправлениям документов и навыков, обнаруженным в ходе наших оценок.
Что мы узнали
Вот краткое содержание (TL;DR), если вы просматриваете этот пост:
- Доступность для агентов увеличивает использование: Будьте как GitHub: все, что разработчики могут сделать вручную с помощью веб-интерфейса, должно быть доступно программно через ваш CLI или SDK. Мы обнаружили, что агенты лучше всего работают с CLI, потому что CLI документирует себя через текст справки. Кстати, об этом —
- Документация — это основная часть продукта: Ваша платформа может быть непригодна для использования агентами, если она не задокументирована точно или если ваши документы недоступны (например, с помощью llms.txt, пакета навыков или сервера MCP). Текст справки CLI и сообщение об ошибке API также имеют значение, и это обычно первые места, куда заглядывает агент, когда сталкивается с трудностями.
- Руководство важнее, чем то, какую передовую модель вы используете: 30 сентября все три модели (Claude Sonnet, Opus и GPT Sol) закончили с разницей в несколько пунктов друг от друга. Добавление наших документов/навыков повысило процент успешных прогонов с 82% до 96% и 97% соответственно.
- И наоборот, использование только сильных моделей иногда может скрыть проблемы: Opus смог обойти пробел в нашем API и пакете навыков, в то время как Sonnet уткнулся в него — именно так мы нашли и исправили проблему. Когда вы проводите оценки, обязательно тестируйте модели во всем спектре возможностей.
- Улучшение AX часто требует лишь небольшого исправления: добавление двух предложений в наш файл навыка позволило нам пройти оценку кластера GPU с 4 из 15 успешных прогонов (для Sonnet) до 100% по всем трем моделям. Исправление было небольшим, но мы могли бы никогда его не найти, если бы не процесс оценки.
Проводите свои собственные оценки
Если вы управляете платформой для разработчиков, агенты используют ваш продукт или, по крайней мере, определенно пытаются это делать. Лучший способ узнать, насколько успешно это получается — создать собственную систему оценки.
Чтобы помочь с этим, мы открываем исходный код пакета, который используем для создания наших оценок. Вы создаете список задач (промтов для агентов) и определяете способ оценки результатов (с помощью тедов кода или LLM-судьи). Пакет запускает агентов, выполняет задачи и отслеживает все данные на локальной панели управления, позволяя сравнивать конфигурации и прошлые запуски. Он будет доступен на следующей неделе вместе с еще одной статьей в блоге о том, как им пользоваться.