Когда происходит инцидент, каждая минута, потраченная на поиск в разрозненных инструментах, увеличивает MTTR и операционные риски. Инженеры переключаются между агрегаторами логов, панелями мониторинга APM и отдельными системами оповещения, пытаясь восстановить хронологию событий — и чем дольше это длится, тем хуже результат.
Эффективное управление логами в DevOps не означает сбор большего количества логов. Это означает, что логи должны быть доступны для поиска, коррелированы и пригодны для использования в рамках вашего более широкого контекста наблюдаемости. Это различие важно, когда вы оцениваете решения или пытаетесь получить больше от инструментов, которые у вас уже есть.
В этом руководстве рассматривается, что включает в себя управление логами в DevOps, как оно вписывается в ваш стек наблюдаемости, на что обращать внимание при оценке решений, а также практики, которые снижают уровень шума и ускоряют устранение неполадок.
Основные выводы: управление логами в DevOps
- Управление логами в DevOps — это практика сбора, обработки, хранения и корреляции данных логов на протяжении всего жизненного цикла разработки программного обеспечения.
- Логи дополняют метрики и трассировки, предоставляя детализацию на уровне событий, необходимую для анализа первопричин и устранения неполадок.
- Аудиторские логи Azure DevOps и управление операционными логами служат разным целям; их смешение создает пробелы в видимости производственной среды.
- Полноценный конвейер управления логами охватывает сбор, обогащение, анализ и управление, поддерживая современные практики DevOps.
- New Relic объединяет логи, метрики, трассировки и события в единую платформу наблюдаемости, помогая командам расследовать проблемы без переключения между инструментами.
Что такое управление логами в DevOps?
Управление логами в DevOps — это практика сбора, обработки, хранения, анализа и корреляции данных логов, генерируемых на протяжении всего жизненного цикла доставки программного обеспечения — от разработки до производственных операций.
В монолитных архитектурах логи было легко контролировать: несколько серверов, предсказуемые пути запросов, централизованный вывод. Kubernetes, микросервисы, бессерверные функции и облачные платформы изменили ситуацию.
Согласно отчету, 93% организаций либо используют Kubernetes в производстве, либо тестируют и оценивают его. Поскольку эти среды становятся все более распределенными, один запрос может генерировать логи в десятках сервисов. Без централизованного сбора и корреляции эти данные быстро становятся фрагментированными во время инцидента.
Современное управление логами рассматривает логи как структурированную телеметрию, доступную для запросов, а не как необработанные текстовые файлы, которые нужно просматривать через grep после сбоя. Именно это позволяет командам отследить сбой до его первопричины в распределенных системах, вместо того чтобы восстанавливать события вручную. Раздел «Что такое управление логами» более подробно раскрывает фундаментальные концепции, если вы начинаете с нуля.
Логи, метрики и трассировки: почему логи остаются необходимыми
Метрики, распределенные трассировки и логи вносят свой вклад в наблюдаемость.
Метрики показывают тенденции производительности с течением времени: использование процессора, частота запросов, частота ошибок. Их эффективно собирать и хранить, и они хорошо подходят для оповещения, когда что-то выходит за рамки пороговых значений.
Трассировки отображают путь запроса через вашу систему. Они определяют, какой сервис в распределенной архитектуре вызвал задержку или привел к сбою.
Логи предоставляют детализацию на уровне событий, необходимую для понимания того, что произошло на самом деле. Когда трассировка показывает, что запрос не удался, а метрики показывают повышенный уровень ошибок, логи объясняют почему — конкретное сообщение об ошибке, трассировка стека, полезная нагрузка запроса, время каждого шага. Именно эта гранулярность делает возможными отладку и анализ первопричин.
Когда логи, метрики и трассировки коррелируются в рамках одной платформы, устранение неполадок становится быстрее и методичнее. Вы начинаете с оповещения, следуете по трассировке к затронутому сервису, а затем переходите непосредственно к соответствующим логам — без переключения инструментов или потери контекста. Эта сквозная видимость помогает командам сократить среднее время восстановления и улучшить реагирование на инциденты в распределенных системах. В этом заключается операционная ценность унифицированной телеметрии и инженерной видимости.
Управление логами в DevOps против аудиторских логов Azure DevOps
Эти две вещи часто путают, поэтому стоит провести четкое различие.
Аудиторские логи Azure DevOps отслеживают административную активность и действия пользователей внутри самой платформы Azure DevOps: изменения разрешений проектов, конфигураций конвейеров, модификации политик и события доступа пользователей. Они полезны для соблюдения нормативных требований и расследований безопасности, а также для ведения аудиторского следа административных действий в вашем инструментарии CI/CD. Они также ценны для команд безопасности, расследующих изменения доступа, обновления политик и потенциальные уязвимости в рабочих процессах разработки.
Управление операционными логами служит другой цели. Оно фиксирует телеметрию времени выполнения из ваших приложений и инфраструктуры: ошибки приложений, события жизненного цикла контейнеров, сбои API, тайм-ауты запросов к базам данных, изменения инфраструктуры, а также события запуска и остановки сервисов.
Если вы пытаетесь понять, почему развертывание вызвало всплеск 500-х ошибок, аудиторские логи Azure DevOps вам этого не скажут. Управление операционными логами — скажет.
Оба типа логов имеют ценность. Но стратегия управления логами, сосредоточенная только на аудиторских следах, оставляет значительные пробелы в видимости производственной среды.
Жизненный цикл управления логами в DevOps: от сбора до действия
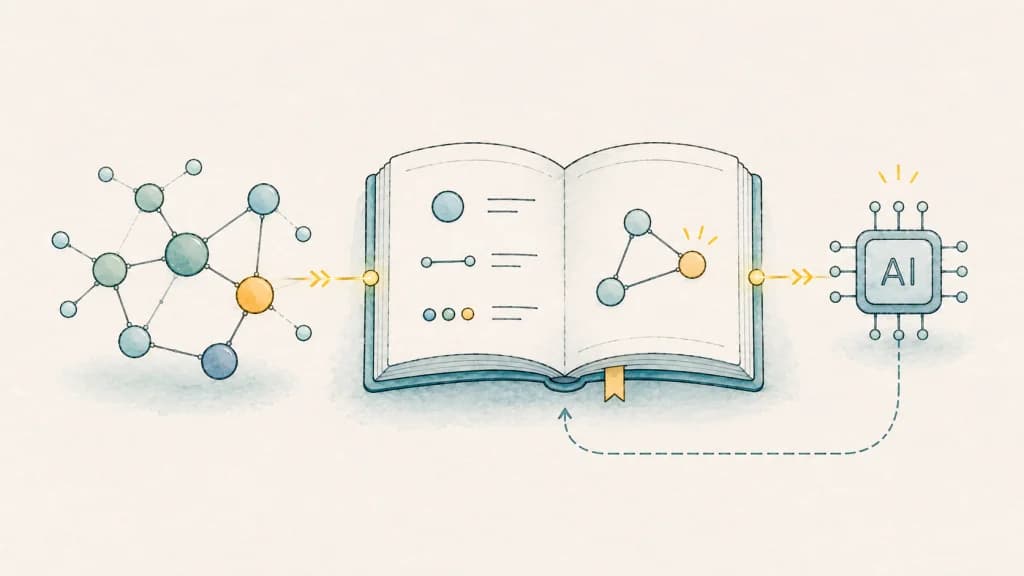
Управление логами — это конвейер. На входе — необработанные данные от машин, на выходе — полезная информация. В современных средах разработки программного обеспечения этот процесс превращает данные логов в операционные инсайты для инженерных и платформенных команд.
Сбор и централизация логов
Сбор начинается у источника: экземпляры приложений, контейнеры, облачные сервисы, компоненты инфраструктуры и сторонние интеграции. Агенты, коллекторы и форвардеры логов перемещают эти данные в центральное хранилище. Варианты сбора без агентов, такие как пересылка syslog, упрощают подключение для определенных сред, в то время как сбор на основе агентов дает вам больше контроля над фильтрацией и обогащением до того, как данные покинут источник.
Централизация — это необходимое условие для всего остального. Без нее вы ищете логи изолированно, а не коррелируете их между сервисами. Для организаций, использующих архитектуру микросервисов, централизованная видимость помогает устранить информационные разрывы и поддерживает более эффективный мониторинг инфраструктуры.
Обработка, обогащение и индексация
Необработанные логи нуждаются в контексте. Конвейеры обработки разбирают неструктурированные строки логов на структурированные поля, применяют теги (среда, сервис, регион, версия развертывания), отбрасывают шумные или избыточные события и направляют логи в соответствующие уровни хранения. Автоматизация конвейеров логов с помощью Terraform помогает командам управлять этими конфигурациями как кодом, уменьшая ручное отклонение конфигураций с течением времени.
Этот этап часто включает в себя рабочие процессы синтаксического анализа, агрегации и обогащения, которые помогают оптимизировать анализ больших наборов данных.
Решения по индексации напрямую влияют на производительность запросов. Выбор полей для индексации на основе реальных шаблонов поиска позволяет сохранять высокую скорость запросов без увеличения затрат на хранение.
Анализ, оповещение и корреляция
Возможности поиска и анализа значительно различаются в зависимости от платформы.
Вопросы, которые имеют значение:
- Можете ли вы писать нерегулярные запросы во время инцидента, не дожидаясь перестройки индексов?
- Можете ли вы переключиться с записи в журнале напрямую на связанную трассировку или метрику?
- Может ли платформа выявлять закономерности в больших объемах журналов без необходимости писать каждый запрос вручную?
Некоторые платформы также используют машинное обучение для выявления аномалий, обнаружения скрытых узких мест и поиска закономерностей, которые трудно обнаружить вручную.
Оповещения должны охватывать как статичные пороговые значения, так и обнаружение аномалий. Статичные пороговые значения пропускают постепенное ухудшение показателей, которое не выходит за фиксированный лимит.
Хранение, архивирование и управление
Различные данные журналов имеют разную ценность с течением времени. Высокочастотные отладочные журналы из рабочей среды могут быть полезны в течение 7–30 дней. Журналы, связанные с безопасностью, могут потребоваться в течение 12 месяцев или более для соблюдения нормативных требований. Политики хранения, многоуровневое хранение и интеграция с архивами одновременно регулируют требования к затратам и соответствию нормативным требованиям.
Управление также охватывает средства контроля доступа, маскирование данных для конфиденциальных секторов и журналы аудита для доступа к логам, что особенно актуально в регулируемых отраслях и организациях, внедряющих практики DevSecOps.
Как оценить решение для управления журналами в DevOps
При оценке платформ стоит проверить на практике следующие критерии:
Корреляция телеметрии. Можете ли вы перейти от журнала напрямую к связанной трассировке или метрике без переключения инструментов? Платформы, которые хранят журналы, метрики, трассировки и события в одной базе данных, снижают нагрузку при расследовании. Фрагментированные стеки наблюдаемости увеличивают накладные расходы на переключение контекста во время инцидентов, что является худшим моментом для этого.
Производительность запросов в масштабе. Как работает поиск, когда вы выполняете специальные запросы по 30-дневным данным журналов от 50 сервисов? Проверьте это с реалистичными объемами данных перед принятием окончательного решения.
Гибкость приема. Поддерживает ли платформа ваши существующие источники журналов? Syslog, журналы Kubernetes, потоки журналов облачных провайдеров, журналы пользовательских приложений через OpenTelemetry? Привязка к проприетарному агенту — это долгосрочные операционные затраты. Поддержка стандартов с открытым исходным кодом может облегчить будущие миграции и интеграции.
Средства снижения уровня шума. Правила выборки, дедупликация и динамические уровни журналирования помогают управлять объемами и затратами. Оцените, насколько детализированы эти средства контроля и требуется ли опыт работы с платформой для их настройки.
Ценовая модель. Объем данных журналов непредсказуемо возрастает во время инцидентов именно тогда, когда вы находитесь под давлением. Убедитесь, в зависимости от чего формируется цена: от объема приема, хранения, индексации или пакета для конкретного SKU, и что происходит с затратами в периоды высокой нагрузки. Прозрачное ценообразование на основе использования легче прогнозировать, чем набор отдельных SKU.
Качество оповещений. Статичные пороговые значения создают шум. Оповещения на основе аномалий и с учетом корреляции снижают количество ложных срабатываний и фиксируют постепенное ухудшение производительности, которое не сработало бы при фиксированном пороге.
Анализ без привлечения специалистов. Структурирование «сырых» журналов традиционно означало написание и тестирование регулярных выражений — работу, которая создает узкие места для нескольких опытных пользователей. Оцените, позволяет ли платформа любому инженеру структурировать журналы без кода, чтобы данные журналов не оставались «неразмеченными», пока до них не доберется специалист.
Для команд, управляющих несколькими инструментами наблюдаемости, объединение в единую платфорду сокращает количество разрозненных инструментов, упрощает рабочие процессы при инцидентах и часто снижает общие затраты.
Лучшие практики управления журналами DevOps, снижающие операционные риски
Эффективное управление журналами зависит не только от сбора данных. Командам необходимы единые стандарты ведения журналов, средства контроля, снижающие уровень шума, и надежные способы связи журналов с более широким операционным контекстом во время инцидента.
Стандарты структурированного ведения журналов и инженерия качества журналов
Неструктурированные журналы замедляют реагирование на инциденты. Когда вывод журнала представляет собой последовательные пары «ключ-значение», а не произвольный текст, запросы выполняются быстрее, синтаксический анализ становится надежным, а корреляция работает без ручного извлечения полей.
Соблюдайте стандарты журналирования на уровне приложений: согласованные форматы временных меток, идентификаторы сервисов, идентификаторы запросов, уровни серьезности и коды ошибок. Общие библиотеки ведения журналов или SDK упрощают их единообразное применение во всех сервисах. Лучшие практики управления журналами и практические советы по управлению журналами охватывают конкретные шаблоны реализации, которые стоит изучить.
Снижение уровня шума: выборка, дедупликация и динамические уровни журналирования
Высокочастотные журналы отладки (DEBUG) в рабочей среде увеличивают объем и затраты без соразмерной ценности. Динамические уровни журналирования позволяют командам собирать подробную телеметрию вокруг ошибок без необходимости постоянного создания избыточных данных журналов.
Дедупликация удаляет повторяющиеся записи журналов, в то время как выборка сохраняет репрезентативные данные для потоков журналов с более низким приоритетом. Эти элементы управления работают наиболее эффективно, если они настроены на уровне сбора данных до того, как они попадут в центральное хранилище.
Сопоставление журналов с трассировками и данными развертывания
Идентификаторы трассировок, передаваемые через журналы, позволяют командам переходить от сбойной трассировки непосредственно к соответствующим журналам, ускоряя устранение неполадок и анализ первопричин в распределенных системах.
Метки развертывания помогают определить, привело ли обновление к изменению поведения. В сочетании с аналитикой стоимости облака и наблюдаемости они обеспечивают оперативный контекст, который поддерживает непрерывную поставку и более быстрое расследование инцидентов.
Как New Relic поддерживает управление журналами DevOps в масштабе
New Relic объединяет журналы, метрики, трассировки и события в единую платформу наблюдаемости, помогая командам быстрее расследовать проблемы без переключения между изолированными инструментами мониторинга.
New Relic хранит журналы, метрики, трассировки и события в одной базовой базе данных.
Во время инцидента это означает, что вы можете начать с оповещения, перейти к соответствующей трассировке и переключиться на детали журнала для этого конкретного сервиса и запроса — не покидая платформу и не выполняя повторный запрос к отдельной системе.
Ключевые возможности включают в себя:
- Централизованный прием данных от агентов, пересыльщиков, syslog, облачных интеграций и OpenTelemetry — без привязки к проприетарному сборщику.
- Анализ без написания кода — визуальный конструктор, который структурирует необработанные журналы без регулярных выражений, поэтому любой инженер может извлекать атрибуты, не дожидаясь специалиста.
- Федеративные журналы (Federated Logs) — запросы к данным журналов там, где они хранятся (включая ваши собственные бакеты S3), сохраняя данные локально для соблюдения требований резидентности без потери контекстной видимости.
- Выполнение запросов в реальном времени с помощью NRQL по журналам, метрикам и трассировкам.
- Анализ журналов с помощью ИИ, который суммирует оповещения и выявляет закономерности/аномалии, ускоряя анализ первопричин, а не заменяя суждения инженера.
- Гибкое хранение и живые архивы, которые обеспечивают возможность поиска по старым журналам для соблюдения нормативных требований без необходимости восстановления из холодных хранилищ.
Ценообразование следует тому же принципу прозрачности: 100 ГБ/месяц бесплатно, а затем $0,40 за 1 ГБ — на основе использования, а не набора SKU, поэтому затраты легче спрогнозировать, когда объем журналов резко возрастает во время инцидента. Этот бесплатный уровень достаточен для проведения полноценного доказательства концепции (PoC) на реальных производственных данных.
Подробную информацию см. на платформе управления журналами New Relic.
Аргументы в пользу консолидации очевидны: каждый дополнительный инструмент в вашем стеке наблюдаемости означает еще одно переключение контекста во время ликвидации инцидентов. Меньшее количество инструментов, коррелирующих в одном месте, означает более быстрое расследование и снижение операционных расходов.
Начните получать больше пользы от данных журналов
Эффективное управление логами требует наличия полного конвейера: структурированного сбора, обогащения, корреляции с другими телеметрическими данными и управления, которое позволяет удерживать затраты на разумном уровне и соблюдать требования нормативных актов. Если правильно настроить один компонент и пренебречь остальными, это сильно ограничит ваши возможности при возникновении реального инцидента.
Надежные практики управления логами улучшают показатель MTTR, снижают операционные риски и предоставляют инженерным командам видимость, необходимую для устранения неполадок в распределенных системах без гадания на кофейной гуще.
Если вы оцениваете свой текущий подход или хотите объединить разрозненные инструменты, узнайте, как New Relic объединяет управление логами с остальной частью вашего стека наблюдаемости. Начните бесплатно с включенными 100 ГБ в месяц или запросите демоверсию, чтобы оценить работу системы на ваших собственных данных.
Часто задаваемые вопросы об управлении логами в DevOps
Почему структурированное ведение логов важно в средах DevOps?
Структурированное ведение логов форматирует вывод логов в виде согласованных, легко парсимых пар «ключ-значение» вместо свободного текста. Это упрощает поиск по логам, их сопоставление с другими телеметрическими данными и программный анализ. В распределенных средах структурированные логи помогают командам фильтровать и агрегировать данные по разным сервисам без написания специальной логики синтаксического анализа.
Как централизованное управление логами улучшает реагирование на инциденты?
Централизованное управление логами собирает данные журналов в едином доступном для поиска месте. Инженеры могут выполнять межсервисные запросы, сопоставлять логи с трейсами и метриками, а также восстанавливать хронологию событий без переключения между инструментами. Результатом является более быстрое определение первопричины и снижение MTTR.
Что командам следует искать в платформе управления логами для DevOps?
Ищите возможности корреляции телеметрии, высокую производительность запросов, гибкие варианты приема данных и элементы управления снижением шума, такие как семплирование и динамические уровни логирования. Командам также следует оценить ценообразование, масштабируемость и то, обрабатывает ли платформа логи, метрики и трейсы нативно, а не через отдельные инструменты.
Джон Бласт (John Blust) — старший менеджер по генерации спроса в New Relic. Он имеет более чем 5-летний опыт создания контента для компаний в сфере инструментов для разработчиков и ИТ-индустрии, включая Databand (наблюдаемость данных), dbt Labs (трансформация данных) и теперь New Relic (наблюдаемость ПО).
Мнения, выраженные в этом блоге, принадлежат автору и не обязательно отражают взгляды New Relic. Любые решения, предлагаемые автором, зависят от конкретной среды и не являются частью коммерческих решений или поддержки, предлагаемых New Relic. Пожалуйста, обращайтесь к нам исключительно через Explorers Hub (support.newrelic.com) по вопросам и поддержке, связанным с этой публикацией в блоге. Этот блог может содержать ссылки на контент сайтов третьих лиц. Предоставляя такие ссылки, New Relic не берет на себя ответственность, не гарантирует, не одобряет и не поддерживает информацию, мнения или продукты, доступные на таких сайтах.