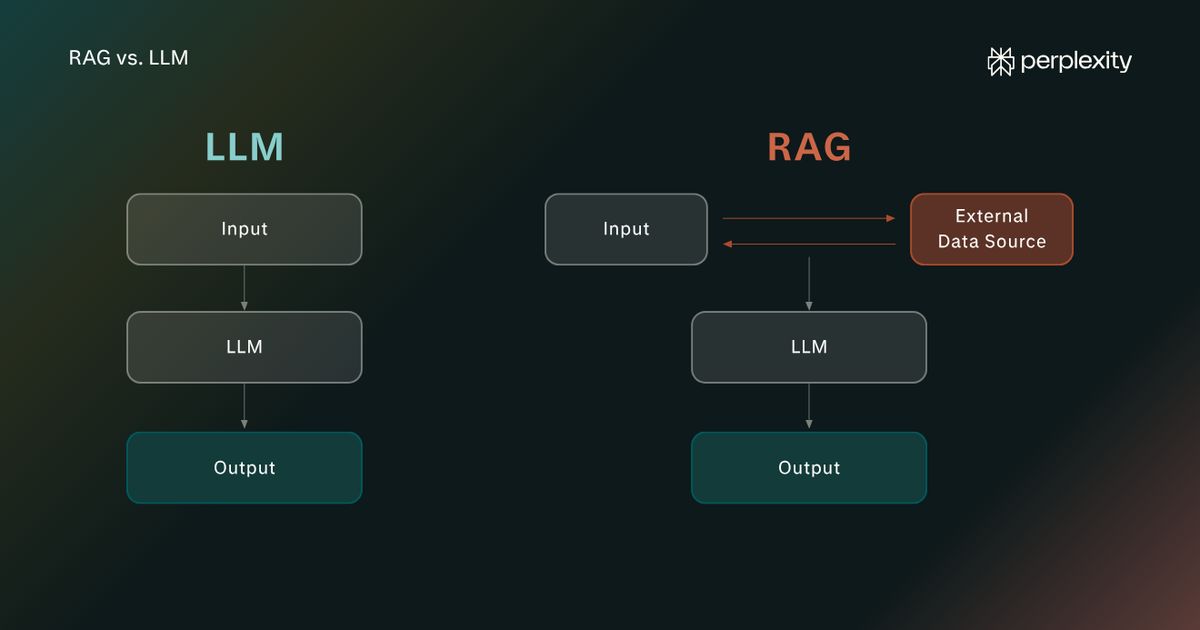
LLM генерируют ответы, используя параметры, полученные на основе закономерностей в обучающих данных. Поскольку эти параметры могут не отражать актуальную или полную информацию, RAG (retrieval-augmented generation — генерация с дополненным поиском) дополняет этот процесс, добавляя данные из внешних источников в контекст ввода LLM. ИИ-инструмент извлекает стороннюю информацию для улучшения процесса генерации LLM.
На самом деле ваш выбор заключается не в том, что выбрать — RAG или LLM. Выбор стоит между гибридным подходом и подходом, использующим исключительно LLM.
RAG необходим, когда LLM требуется доступ к корпоративной документации, базам данных или быстро меняющейся информации. Подход только на базе LLM подходит для определенных административных задач, обработки данных и создания контента, где все входные данные могут быть предоставлены пользователем.
RAG против LLM: каковы основные различия?
- RAG и LLM — это взаимодополняющие системы. Вы можете использовать ИИ-модель без RAG (в таком случае она полагается исключительно на свои существующие параметры), но вы не можете использовать систему RAG без модели.
- RAG была внедрена для решения трех основных проблем LLM: устаревшей информации, галлюцинаций в ответах и отсутствия верификации по сторонним источникам.
- RAG делает ИИ гораздо более эффективным в реальных бизнес-задачах, поскольку связывает LLM с проверенной внутренней документацией, базами данных и конечными точками API.
- К числу основных сценариев использования RAG относятся чат-боты для службы поддержки, запросы на основе быстро меняющихся данных (например, отраслевых новостей) и специализированные области, такие как медицина и юриспруденция, где важны точность и проверка фактов по источникам.
- Существует три основных типа RAG: базовый RAG (naive RAG), модульный RAG (modular RAG) и продвинутый RAG (advanced RAG). Базовый RAG лучше всего понимать как прямолинейное извлечение информации, в то время как модульный и продвинутый RAG добавляют дополнительные функциональные возможности, такие как переписывание запросов и оптимизация фрагментов.
Что такое большая языковая модель (LLM)?
LLM, или большая языковая модель, — это система, которая генерирует контент с использованием дообученных параметров. Эти параметры определяют вероятности, присваиваемые всем токенам в словаре LLM, указывая, какой токен с наибольшей вероятностью появится следующим в заданной последовательности.
Чтобы лучше понять, как работает RAG (и чем он отличается от LLM), полезно рассмотреть принципы работы генеративного ИИ на базовом уровне:
- Токенизация: запрос пользователя разбивается на токены, которые могут быть словами, частями слов или отдельными символами.
- Эмбеддинг: токены преобразуются в эмбеддинги — числовые представления (строки чисел), называемые векторами, которые может обрабатывать нейронная сеть, включающая декодер.
- Декодирование: слои декодера (которые составляют большую часть нейронной сети LLM) манипулируют этими векторами, используя процесс, называемый механизмом внимания (attention), для улавливания смысла. Этот процесс определяет, насколько сильно каждый токен должен быть связан с другими токенами в последовательности.
- Оценка: модель присваивает вероятность совместимости каждому токену в своем существующем словаре и выбирает наиболее вероятный следующий токен для последовательности.
Важный момент заключается в том, что LLM может выдавать результаты только на основе своих существующих параметров и токенов в своем контекстном окне. Во время обучения LLM миллиарды раз получает запрос завершить части незаконченного текста, и ее параметры настраиваются до тех пор, пока она не начнет надежно присваивать вероятности токенам (и, таким образом, завершать текст).
Представьте, например, вы задаете ИИ-модели вопрос: «Что говорится в политике возврата нашей компании на 2026 год?». LLM может прогнозировать следующие токены только на основе своих существующих параметров, которые не были дообучены с использованием вашей документации службы поддержки. Если вы зададите ей этот вопрос без какого-либо дополнительного контекста, она просто не сможет ответить осмысленным образом или выдаст галлюцинацию с неверным ответом.
Что такое генерация с дополненным поиском (RAG)?
RAG (retrieval-augmented generation) — это процесс, при котором информация из внешних систем включается в промпт (запрос) LLM.
Базовый процесс LLM, включающий создание эмбеддингов и вероятностное сопоставление токенов, остается прежним. RAG добавляет предварительный этап, на котором запрос пользователя дополняется дополнительными данными.
Ниже приведен обзор того, как работает RAG:
- Подготовка знаний: подготавливается источник знаний. Это может быть набор документов, векторная база данных, граф знаний или живой индекс (например, для ИИ-поиска).
- Формирование промпта: пользователь вводит запрос, например: «Стоит ли мне сегодня пойти на прогулку в Лондоне?»
- Поиск (Retrieval): к внешнему источнику информации обращается модуль поиска (retriever) ИИ-инструмента. Он может создать эмбеддинг запроса, превратив его в вектор, а затем выполнить запрос к векторной базе данных. В качестве альтернативы он может использовать другой метод, такой как вызов API, сопоставление ключевых слов или обход графа знаний.
- Вставка: эта информация добавляется к исходному запросу пользователя. В примере с вопросом о прогулке в Лондоне это может включать информацию о погоде в Лондоне и текущую доступность популярных пешеходных маршрутов.
- Генерация ответа: LLM генерирует ответ обычным способом, используя расширенный промпт.
За кулисами извлеченный текст добавляется во входной контекст, токенизируется и преобразуется в эмбеддинг. Затем модель обрабатывает этот дополнительный контекст через свой декодер, что изменяет вероятности выходных токенов.
В целом RAG можно разделить на три подтипа. Базовый RAG следует стандартному процессу RAG, извлекая информацию и передавая ее в промпт. Продвинутый RAG добавляет дополнительные функции, такие как переписывание запросов и многократные проходы по запросам. Модульный RAG относится к типу архитектуры, в которой различные продвинутые функциональные возможности могут рассматриваться как компоненты и комбинироваться по мере необходимости.
RAG против LLM: обзор сценариев использования
RAG предоставляет пользователям доступ к актуальным данным. Это приводит к тому, что результаты работы LLM содержат меньше галлюцинаций и пробелов в информации. Если вам необходимо видеть источники информации, используемой в ответе, RAG также необходим, поскольку неподтвержденные ответы LLM не сопровождаются указанием авторства/источников.
Сценарии использования RAG
- Запросы информации, чувствительной ко времени: любые запросы информации, которая быстро устаревает (это может быть что-то столь простое, как прогноз погоды, или столь сложное, как подробный анализ развивающейся новости), должны основываться на проверенных сторонних источниках.
- Корпоративная документация: внутренние или ориентированные на клиентов ИИ-чат-боты, в которых пользователи задают вопросы, связанные с документацией компании или продукта, должны быть оснащены функцией RAG, особенно если документация часто обновляется.
- Поддержка клиентов: чат-ботам службы поддержки необходим доступ к актуальной, подробной документации поддержки для предоставления точных ответов.
- Специализированные области (медицина, юриспруденция, финансы и т. д.): LLM, которые не обучались на доменных корпусах (особенно массовые модели), как правило, испытывают трудности с пониманием нюансов специализированных промптов.
Сценарии использования LLM
- Административные задачи: LLM могут выполнять базовые задачи с минимальной задержкой. RAG не нужен для базовых задач письма и администрирования, таких как проверка орфографии или суммирование, где внешняя информация не требуется.
- Творческие задачи: некоторые творческие задачи, такие как написание рассказа или создание изображения, требуют только информации, предоставленной в исходном промпте.
- Задачи на основе рассуждений и данных: Если вы работаете с большим набором данных, LLM не нуждается в доступе к внешней информации для применения функций рассуждения и анализа.
- Общее программирование: Хотя рабочий процесс программирования может требовать доступа к закрытой кодовой базе или документации, LLM отлично справляются с выполнением общих задач программирования, таких как исправление ошибок и создание функций, без обращения к внешним источникам.
RAG против LLM с большим контекстом, агентный ИИ и граундинг
Существует три связанных понятия, имеющих отношение к различению RAG и LLM. Это LLM с большим контекстом, агентный ИИ и граундинг.
LLM с большим контекстом иногда могут использоваться вместо систем с поддержкой RAG, в то время как агентный ИИ и граундинг синонимичны им или работают вместе с ними.
LLM с большим контекстом
Это модели с большими контекстными окнами, причем некоторые широко доступные коммерческие модели поддерживают до одного миллиона токенов.
Если соответствующий материал помещается в контекстное окно модели и доступен в текстовом формате, использование подхода, основанного исключительно на LLM, дает определенные преимущества. Это может снизить вероятность ошибок извлечения, обеспечить более полный контекст и устранить необходимость настройки сложной архитектуры RAG.
Агентный ИИ
Агент — это система, которая использует множество инструментов, включая возможности RAG, для выполнения сложных задач. RAG является одним из компонентов агентного ИИ, и агент часто использует различные типы методов извлечения (например, поиск в Интернете против векторного поиска) в зависимости от содержимого промпта.
Граундинг
Граундинг относится к более широкому процессу использования фактических данных или информации для повышения точности (или обоснования) ответа LLM. RAG — это одна из форм граундинга, но добавление технического документа в контекстное окно также будет считаться граундингом.
RAG против LLM: Примеры из реального мира
Чтобы лучше понять, как работает RAG по сравнению с использованием LLM без RAG, мы можем рассмотреть простой реальный пример с использованием Perplexity и гипотетический корпоративный случай, когда задействована векторная база данных.
RAG против LLM с простым промптом
Вот результат (ограниченный двумя предложениями), когда у Perplexity спрашивают: «Стоит ли мне сегодня пойти на прогулку в Лондоне?» при отключенном веб-поиске с использованием ИИ (форме RAG):
Да — если погода относительно сухая и у вас есть время, сегодняшняя прогулка по Лондону может стать освежающей сменой обстановки. Выберите маршрут вдоль Саут-Бэнк, Риджентс-канала или через Гайд-парк и на всякий случай захватите легкий дождевик.
Сравните это с промптом, когда LLM может проверять внешние источники:
Да, сегодня отличный день для прогулки по Лондоне: прогноз обещает мягкую температуру около 19–21°C с солнечными интервалами и лишь очень низкой вероятностью дождя. При переменной облачности и легком ветерке условия комфортны для исследования парков или прибрежных маршрутов, таких как Саут-Бэнк.
Между ними есть сходства, так как LLM использует тот же базовый процесс токенизации и оценки. Однако второй пример включает подробную информацию о погоде, что делает его гораздо более полезным.
RAG против LLM с корпоративной векторной базой данных
Представьте, что пользователь задает внутриприложенческому чат-боту банковского приложения следующий вопрос: «Где я могу скачать свою последнюю выписку?»
Банк, управляющий приложением, создал базу данных, содержащую вложения (эмбеддинги) актуальной документации по продуктам, и подключил ее к конвейеру RAG чат-бота. Документация состоит примерно из 1 000 исходных документов, которые разбиты на более мелкие фрагменты и преобразованы в векторы для извлечения.
Запрос пользователя отправляется в модель эмбеддингов, а приложение отправляет этот вектор в базу данных, которая возвращает соответствующие фрагменты.
Модель эмбеддингов получит запрос следующего вида:
json
Модель эмбеддингов возвращает следующее векторное вложение:
json
Затем векторная база данных получает примерно следующий запрос:
json
В этом (сильно упрощенном) примере база данных возвращает пять фрагментов, наиболее релевантных запросу пользователя, которые отправляются в приложение и включаются в промпт LLM.
Когда выбирать RAG, когда LLM, а когда их комбинировать
LLM и RAG — это взаимодополняющие системы. Таким образом, вопрос «Когда мне следует выбрать LLM, а когда RAG?» неуместен. Скорее, следует спросить: «Когда будет достаточно LLM, а когда оптимален RAG?»
Когда использовать LLM без включенного RAG
- Выбранная вами модель ИИ имеет большое контекстное окно: Если проще включить всю информацию или данные, необходимые для получения точного ответа, в ваш промпт, например, загрузив документ, это может снизить задержку и предотвратить проблемы, связанные с извлечением.
- Рабочие процессы рассуждений и анализа данных: Рабочие процессы анализа и рассуждений, которые ссылаются только на данные, предоставленные в промпте, не нуждаются в возможностях RAG.
- Генерация кода: RAG обычно не требуется для общей работы с кодом, хотя он обычно применяется для задач, специфичных для проекта, таких как извлечение предыдущих исправлений или API и документации вендоров.
Когда использовать LLM с включенным RAG
- Вам необходим доступ к актуальной информации: Если для генерации точного ответа ИИ-приложению требуется доступ к внешним источникам актуальной информации, всегда убедитесь, что возможности RAG включены.
- Вы работаете в специализированной области: Для таких областей, как медицина, юриспруденция, образование и т. д., где важны точность, детализация и проверка источников, использования только LLM часто будет недостаточно.
- Выходные данные должны ссылаться на внутренние файлы компании: Если вы используете ИИ (внутри компании или в приложении для клиентов) для генерации контента на основе внутренних документов компании, будь то данные, брендбук, документация или файлы, RAG обеспечивает доступ к этой информации.
RAG и LLM — это взаимодополняющие развивающиеся технологии
RAG ознаменовал собой крупную инновацию в эволюции ИИ. Он решает три основные проблемы: устаревшая информация, ограниченная память модели и пробелы в информации из-за отсутствия релевантных обучающих данных, что часто приводило к галлюцинациям. Конечно, LLM не преодолели их полностью, но с появлением RAG их частота значительно снизилась.
RAG — это не статичная технология. Ожидается, что она улучшится в ряде областей, включая переранжирование, задержку при извлечении и использование токенов, защитные меры безопасности против опасных источников данных, интеграцию извлеченных данных из нескольких источников и многое другое. По мере дальнейшего развития LLM и агентного ИИ будут развиваться и поддерживающие их системы RAG.