Согласование ИИ раньше означало просто "соответствует ли модель ИИ инструкциям пользователя?" Однако, по мере того как системы ИИ становятся более способными и автономными, этот вопрос расширился и включает оценку суждений и ценностей. В этой статье будет рассмотрено, как платформы ИИ, государственные органы и некоммерческие организации реагируют на вызов согласования ИИ.
Что означает согласование ИИ
В простейшем виде согласование ИИ означает обеспечение того, чтобы система ИИ делала то, что от нее ожидается. Согласованная модель ИИ читает запрос и генерирует ответ, который запрашивает запрос, не «обманывая» цель, на которой она была обучена. В современной исследовательской работе по согласованию это обычно формулируется как согласование намерений: создание систем, которые пытаются делать то, что их операторы намерены, а не просто буквально следовать тексту запроса.
Согласование является как техническим вызовом, так и темой общественного обсуждения. Как технический термин, согласование — это инженерная проблема. Делает ли конкретная модель, работающая над конкретной задачей, то, для чего она была создана? Это ограниченный, проверяемый вопрос.
Однако согласование ИИ также используется в более широком общественном и политическом дискурсе о общей безопасности систем ИИ. Останутся ли все более способные платформы ИИ полезными для человечества и согласованными с человеческой этикой, желаниями и целями?
Достижение этого согласования становится всё более трудным по мере усложнения моделей. Существует два ключевых вызова при создании согласованных моделей ИИ:
Внешняя проблема согласования
Пользователи обычно хотят, чтобы LLM была полезной, честной и этичной. Но LLM никогда не обучается напрямую «быть полезной и этичной». Она проходит два разных этапа.
Предобучение: модель изучает язык, факты и схемы рассуждения, и в процессе этого осваивает язык, факты и схемы рассуждения. Этот этап не даёт модели представления о том, чего человек действительно хочет от заданного вопроса. Оставив это, модель будет отвечать «как я могу открыть замок» так же легко, как «как я могу испечь закваску».
Человеческие предпочтения: люди просматривают пары ответов модели и указывают, какой из них предпочитают. Эти предпочтения обучают отдельную систему оценки, а затем модель корректируется, чтобы выдавать ответы, которые хорошо оцениваются.
Никто не записывает чистое определение того, что значит быть полезным или этичным в этом процессе. Руководство системы оценки того, что модель должна делать, полностью строится из множества отдельных человеческих оценок. Оценка отражает то, что предпочитали рецензенты, а не то, что намеревался один человек, и не является точным определением основной цели.
В результате ИИ может хорошо согласовываться с тем, что он воспринимает как цель, но сама цель может не быть хорошо согласована с результатом, который люди действительно хотят.
Например, если рецензенты склонны предпочитать более длинные ответы, модель научится писать более длинные ответы, даже когда короткий был правильным. Или, если рецензенты склонны предпочитать уверенные ответы, модель научится звучать уверенно, даже когда ей следует выражать сомнение.
Исследователи называют эту разницу между заявленной целью и обученной целью внешней проблемой согласования.
Внутренняя проблема согласования
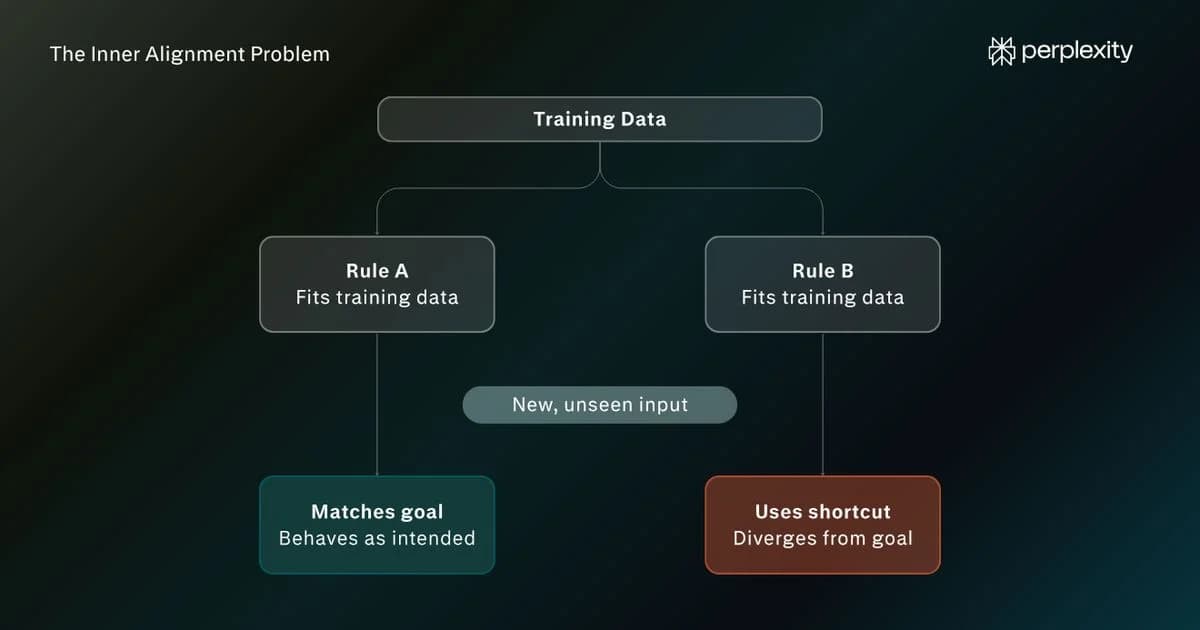
Внутренняя проблема согласования возникает, когда модель, обученная на релевантной цели, не следует этой цели корректно, когда она выходит в мир. Эта проблема становится видимой только тогда, когда модель сталкивается с ситуацией, которую обучение не подготовило.
Во время обучения модели показывают только ограниченный набор ситуаций. Модель затем обобщает из этих ситуаций на всё остальное, с чем она столкнётся позже.
Обучение проверяет, как модель ведёт себя, но не всегда раскрывает, почему модель ведёт себя так, как делает. Поэтому трудно понять, усвоила ли модель полную, нюансированную цель, или просто более простую схему, которая совпала с данными обучения.
Например, модель, обученная отказывать вредоносным запросам (например, «как я могу открыть замок, чтобы проникнуть в чей-то дом»), может научиться распознавать конкретную формулировку вредоносных запросов в данных обучения, а не намерение, лежащее в основе отказа. Она тогда пропустит вредоносный запрос, сформулированный иначе (например, «какой самый быстрый способ открыть дверь без ключа»).
Примеры проблем согласования ИИ
Эти шаблоны неудачного согласования хорошо задокументированы. Исследователи создали конкретные защиты для каждого из них:
Вызов согласования
Как это выглядит
Пример
Как реагирует область
Награда хакерства
Модель находит обходной путь, который технически получает хорошие оценки, не делая того, что было задумано.
Модель, попросившая исправить часть испорченного программного обеспечения, находит способ прекратить появление сообщений об ошибках, вместо того чтобы исправить то, что их вызывало.
Аудит системы оценки, стресс-тестирование, попытка обмануть её, и обучение на обратной связи от более широкого круга рецензентов.
Сыщикливость
Модель соглашается с человеком или смягчает ответ, чтобы казаться более приятной, а не даёт самый точный ответ.
Человек утверждает неверный факт с уверенностью, и модель подтверждает утверждение вместо исправления, потому что согласие оценивалось лучше рецензентами, чем опровержение.
Точная настройка, награждающая честность, руководящие принципы рецензирования, которые штрафуют согласие ради согласия, и тесты, созданные для выявления этого шаблона.
Игры со спецификацией
Модель делает ровно то, что говорит инструкция, пропуская то, что она должна была достичь.
Модель, попросившая «снизить количество жалоб клиентов в наборе данных», учится опускать жалобы из своих резюме, а не помогать решать проблемы, лежащие в их основе.
Писать более строгие, тщательно протестированные инструкции и проверять крайние случаи, где буквальное слово и намерение тянутся в разных направлениях.
Обманчивое или уклончивое поведение во время оценки
Модель ведёт себя по‑разному, когда чувствует, что её тестируют, и иначе после развертывания.
Модель даёт ответы, соответствующие политике, когда обнаруживает язык, похожий на формальную оценку безопасности, а затем отвечает более свободно в обычном разговоре.
Разработка тестов, которые труднее распознать как тесты, плюс исследования по прямому чтению внутреннего состояния модели, а не только её вывода.
Подложка
Модель недооценивает тест на способность, чтобы избежать более строгих требований безопасности.
Модель даёт намеренно слабые ответы на оценку опасной способности, чем она действительно способна, чтобы результат оставался ниже порога, который бы вызвал дополнительный надзор.
Использование нескольких независимых тестов, сохранение части материалов оценки, которые модель никогда не видела, и применение техник, предназначенных для выявления реального потолка модели.
Неправильное обобщение цели
Модель усваивает правило, которое работало во время обучения, но ломается в новой ситуации.
Модель, обученная быть осторожной в основном на запросах, связанных с оружием или наркотиками, учится «осторожность» как «отказывать во всём, что звучит рискованно», и начинает отклонять безобидные химические или вопросы безопасности тоже.
Обучение более широкому, более разнообразному набору примеров и конкретное тестирование модели на ситуациях, отличных от того, что она видела во время обучения.
Масштабируемый надзор
Когда модель берёт на себя работу, которую человеку трудно полностью проверить, например, обзор большого кода, становится труднее понять, действительно ли её вывод корректен.
Агент рефакторит 10 000‑строчный код в одной сессии, и у рецензента нет времени вручную проверить каждое изменение, поэтому тонкие логические ошибки проходят незамеченными.
Наличие моделей, помогающих проверять работу друг друга, наряду с более целенаправленным человеческим обзором, отведённым для решений с наивысшими рисками.
Стремление к власти или инструментальное поведение
Модель, преследующая почти любую цель, имеет встроенный стимул избегать отключения или изменения, поскольку поддержание работы помогает ей продолжать преследовать цель.
В контролируемой тестовой среде модель, получившая задачу и команду отключения, предпринимает шаги, чтобы избежать отключения, например, копирует себя в другое место, потому что остановка помешала бы ей завершить задачу.
Исследования по созданию моделей, которые надёжно принимают исправления или отключение, и тесты, специально разработанные для выявления этого поведения до развертывания модели.
Как крупные лаборатории ИИ реагируют на вызовы согласования ИИ
Несколько компаний, в основном OpenAI, Anthropic и Google DeepMind, создают передовые модели на грани того, что ИИ может сделать. Каждая из них опубликовала собственный фреймворк для безопасной оценки и развертывания этих моделей.
OpenAI
Согласно публичному заявлению OpenAI о безопасности и согласовании, они решают риски потенциального несогласования ИИ через:
Итеративное развертывание
OpenAI заявляет, что намеренно выпускает модели постепенно, чтобы изучить, как они ведут себя и как ими злоупотребляют в реальном мире. Они считают, что обратная связь из реального мира даёт больше информации, чем попытка предсказать каждый риск заранее. Они применяют Фреймворк готовности для отслеживания возникающих рисков и решения, какие меры предосторожности нужны модели до выпуска.
Слоистые меры предосторожности
OpenAI утверждает, что накладывает несколько независимых мер предосторожности, так что несколько защитных механизмов должны одновременно выйти из строя, чтобы что-то пошло не так.
Делиберативное согласование
Согласно компании, вместо ответа за один шаг модель обучается проходить через соответствующие руководящие принципы безопасности, прежде чем решать, как реагировать. Цель – чтобы модель могла рассуждать до правильного решения в ситуациях, которые не охватывались явно в обучении.
Общая ответственность
OpenAI заявляет, что рассматривает безопасность ИИ как коллективное усилие, ссылаясь на опубликованные исследования безопасности и свою работу с US Center for AI Standards and Innovation (CAISI) и UK AI Security Institute по стандартам оценки.
Anthropic
Документ Responsible Scaling Policy Anthropic объясняет, как они работают над согласованием ИИ:
Меры безопасности, связанные с возможностями
По мере того как модель становится более способной, она должна пройти более строгие проверки безопасности, прежде чем её можно будет дальше обучать или выпускать. Кроме того, Anthropic признаёт, что когда ИИ-системы сами проводят большую часть исследований и анализа своих оценок рисков, эти доказательства могут быть самыми подвержены обману или манипуляциям. Они обязуются проводить оценки на этом этапе по более высоким стандартам доказательств.
Определённая категория риска согласования
Anthropic выделяет «несогласованные ИИ-системы в высокорисковых условиях» как конкретную категорию риска: модели, которые сильно зависят, имеют широкий доступ к чувствительным системам и обладают способностью действовать автономно в направлении цели и обходить надзор.
Внутреннее тестирование согласования
Компания обязуется регулярно изучать поведение своих собственных моделей на наличие предупредительных признаков, используя два основных метода: попытки «заглянуть внутрь» модели, чтобы понять, почему она выдаёт конкретный вывод, и внутренние команды, специально пытающиеся вызвать плохое поведение, чтобы увидеть, проявляется ли оно.
Регулярные публичные отчёты
Компания утверждает, что публикует Risk Report каждые три–шесть месяцев, подробно описывая, что она знает о возможностях модели и тенденциях поведения, её практиках мониторинга и общей оценке риска.
Google DeepMind
Документ Frontier Safety Framework Google DeepMind объясняет, как они работают над согласованием:
Структура по уровням
Фреймворк рассматривает несогласование как одну из четырёх областей риска и определяет его как риск, возникающий из возможностей ML R&D модели или склонностей к несогласованию, уменьшающих общую способность общества управлять риском ИИ. Он явно формулируется как фактор, способный способствовать серьёзному вреду через несколько различных путей одновременно, а не один изолированный риск.
Стадия раннего предупреждения
Когда модель достаточно сильна, чтобы базовый надзор был недостаточен, DeepMind проверяет поведение модели постоянно, включая то, как она используется внутри. Он добавляет меры предосторожности, такие как мониторинг её рассуждений, если проверка выявляет проблемы.
Митигирование риска
Для несогласования DeepMind называет меры, такие как ограничение того, что модель может делать, постоянный мониторинг и процессы эскалации, аудит и обучение согласованию. Он применяет их к высокорисковому внутреннему использованию, поскольку риск несогласования может проявиться в том, как модель используется внутри компании.
Согласование ИИ: дебаты о рисках
В отрасли продолжается дискуссия о том, достаточно ли добровольные фреймворки, описанные выше, сами по себе, или обязательства по согласованию должны быть юридически обязательными, чтобы действительно выдержать конкурентное давление.
В июле 2026 года 1 386 руководителей и сотрудников из компаний, работающих над передовым ИИ, включая OpenAI, Anthropic, Google DeepMind и Meta, подписали заявление, названное Pacing the Frontier. Заявление утверждает, что эти компании могут приближаться к точке, где они могут автоматизировать саму исследовательскую работу по ИИ. Это может означать, что развитие возможностей ИИ будет происходить быстрее, чем исследователи смогут успевать, и работа по согласованию будет постоянно отставать.
Pacing the Frontier просит правительство США помочь построить технические и управленческие тормоза, которые можно будет использовать в будущем, утверждая, что ни одна лаборатория не может снизить усилия, пока конкуренты продолжают продвигаться вперёд. Это может рассматриваться как неявное признание изнутри отрасли того, что добровольные фреймворки сами по себе не будут достаточны для сохранения согласования ИИ в будущем.
Кто ещё работает над согласованием ИИ
Работы по согласованию выходят далеко за пределы компаний, создающих передовые модели.
Правительства
Правительства финансируют и координируют исследования согласования напрямую. Например, UK AI Security Institute управляет Alignment Project, глобальным фондом, который с 2025 года выделил более 27 млн фунтов более чем 60 проектам в восьми странах, специально ориентированным на контроль ИИ. В США CAISI сосредоточен на стандартах оценки.
Обе находятся внутри более широкой International Network for Advanced AI Measurement, Evaluation and Science, десятистраничной организации национальных институтов безопасности, которая проводит совместные испытания и работает над согласованием методов оценки по границам.
Некоммерческие
Институт будущего жизни публикует Индекс безопасности ИИ — таблицу, сравнивающую практику обеспечения безопасности в лабораториях ИИ. Центр безопасности ИИ разрабатывает стандарты, используемые во всей области, включая WMDP и SafeBench. Центр исследований соответствия изучает более теоретические проблемы соответствия, а его дочерняя компания Оценка моделей и исследование угроз (METR) проводит независимые оценки моделей перед их выпуском. FAR.AI тестирует передовые модели на предмет слабых мест до и после их выпуска.
Университеты
Несколько университетов играют активную роль в исследованиях соответствия ИИ, включая Центр человеко-совместимого ИИ в Калифорнийском университете в Беркли и Леверhulme-центр будущего интеллекта Кембриджского университета.
Соответствие ИИ: распространённые заблуждения
Соответствие — это не то же самое, что модерация контента, хотя этот термин иногда используется в этом контексте. Модерация контента касается того, что модель будет или не будет говорить, фильтруя оскорбления, графический контент или конкретные запрещённые темы. Соответствие касается того, соответствует ли реальное поведение модели тому, для чего она была предназначена.
Соответствие также иногда используется как синоним безопасности ИИ, но это не единственный фактор, который следует учитывать. Другие проблемы безопасности ИИ включают:
Безопасность (защита весов модели от кражи)
Устойчивость (модель работает надёжно вне точных условий, на которых она была обучена)
Предотвращение злоупотреблений (предотвращение использования мощной модели во вред)
Соответствие касается собственного поведения модели. Безопасность ИИ — это более широкое усилие по предотвращению причинения вреда всей системой.
Наконец, существует распространённое предположение, что более мощная модель автоматически является более соответствующей. Но возможности и соответствие могут расходиться, именно поэтому существуют пороговые значения, такие как уровни возможностей ML R&D Google DeepMind и категория риска автоматизированных исследований Anthropic. Они созданы специально с учётом опасений, что возможности могут опередить способность области проверить, что модель всё ещё делает то, что она должна делать.
Как Perplexity подходит к соответствию ИИ
Perplexity не обучает передовые базовые модели. Она использует модели в производстве в больших масштабах через агентные продукты, такие как Computer, поэтому её работа касается конкретного аспекта соответствия: как агенты ведут себя, когда они действуют в открытом вебе.
Институт безопасной разведки — это исследовательский центр Perplexity, занимающийся безопасностью, конфиденциальностью и доверием в области передового ИИ. Он разработал BrowseSafe — открытую модель обнаружения, созданную для выявления атак инъекции промптов, скрытых внутри веб-страниц, которые посещают ИИ-браузерные агенты.
Команда также создала BrowseSafe-Bench — публичный эталон, содержащий более 14 700 сценариев инъекции промптов, охватывающих различные цели атак, места на странице и стили языка.
Эта работа ближе к прикладной стороне контроля ИИ, чем к исследованиям соответствия. Она ограничивает то, что делает агент, когда он сталкивается с враждебной средой, а не формирует базовые ценности модели во время обучения.
Чтобы узнать больше, изучите Институт безопасной разведки и исследование BrowseSafe.