Оценка HCLTech BLA-Bench по 782 задачам для агентов кодирования
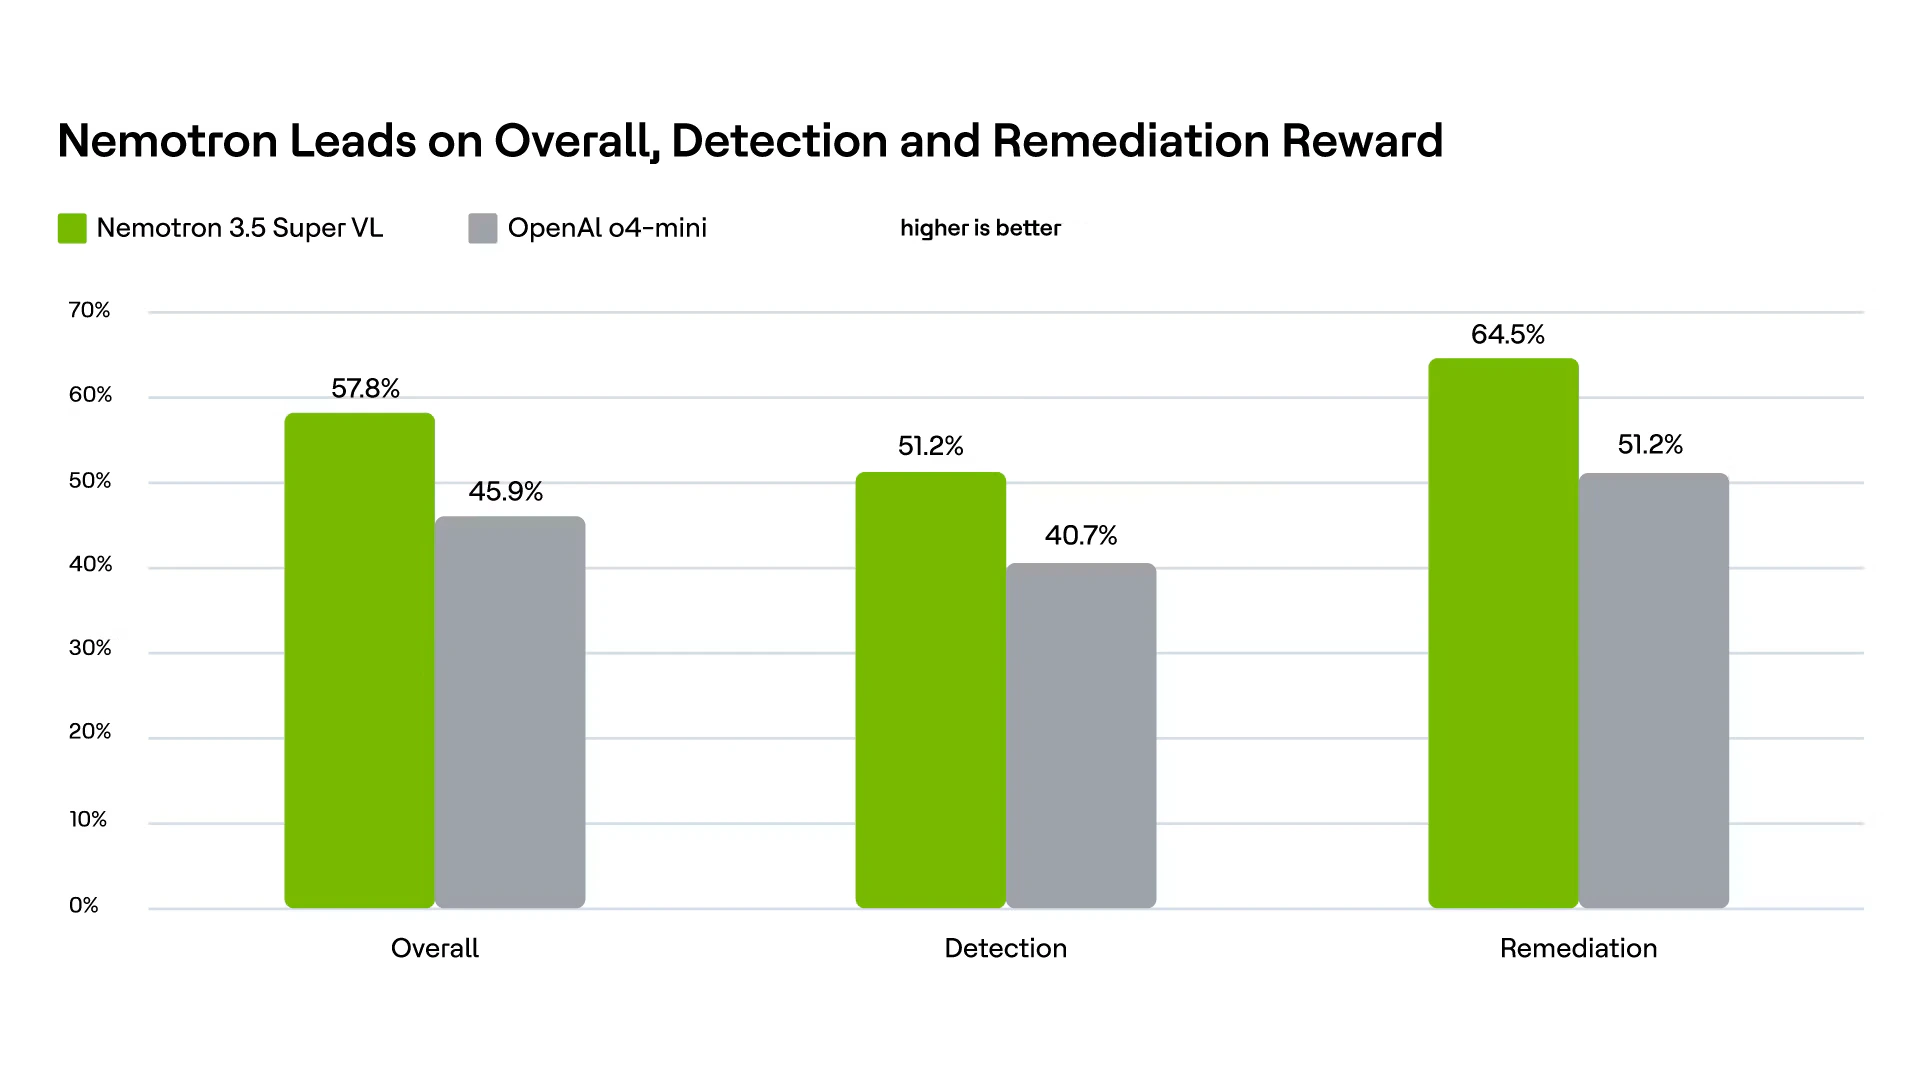
Краткий обзор Nemotron 3.5 Super VL получила вознаграждение по 452 из 782 задач на злоупотребление бизнес-логикой (57,8%) по сравнению с 359 из 782 (45,9%) у OpenAI o4-mini. Она также зафиксировала более высокое вознаграждение за обнаружение (51,2% против 40,7%) и устранение (64,5% против 51,2%).
Злоупотребление бизнес-логикой входит в число наиболее сложных проблем безопасности приложений для обнаружения. В отличие от дефектов безопасности памяти или очевидных путей инъекций, эти уязвимости возникают, когда предполагаемый рабочий процесс приложения, правила авторизации или переходы состояний могут быть изменены способами, непредусмотренными разработчиками.
Подразделение прикладных исследований HCLTech оценило модель NVIDIA Nemotron 3.5 Super VL на бенчмарке BLA-Bench, внутреннем тесте, созданном для оценки способности агентов кодирования обнаруживать и устранять уязвимости бизнес-логики в реалистичных программных проектах. В ходе этой оценки конфигурация Nemotron получила более высокое общее вознаграждение, как в обнаружении, так и в устранении, по сравнению с эталонной конфигурацией o4-mini.
В ходе оценки обе настроенные модели были помещены в одну и ту же обвязку Deep Agents Code от LangChain с согласованным профилем среды выполнения. Каждая задача содержала класс CWE и ограниченную область исследования. В стандартный агент не добавлялись специфичные для бенчмарка примеры, уровень поиска средств безопасности или специализированный инструмент валидации.
Результаты по категориям и языкам оказались широкими: Nemotron продемонстрировала более высокий процент вознаграждения во всех 10 категориях злоупотребления бизнес-логикой и в 16 из 17 когорт языков программирования.
Почему злоупотребление бизнес-логикой является сложным тестом для ИИ-агентов кодирования
Традиционные инструменты безопасности приложений весьма эффективны при поиске многих классов уязвимостей с идентифицируемыми шаблонами кода или потока данных. Уязвимости бизнес-логики представляют собой иную сложность.
Рассмотрим приложение, которое корректно проверяет каждый отдельный запрос API, но позволяет пользователям вызывать эти API в непредусмотренной последовательности. Или службу, которая корректно реализует проверки авторизации, но предоставляет внутренний переход состояния, которым злоумышленник может манипулировать. Отдельные фрагменты кода могут выглядеть разумными изолированно. Обнаружение уязвимости требует понимания того, что приложение должно делать и как злоумышленник может нарушить эти предположения.
Для систематической оценки этой проблемы HCLTech разрабатывает BLA-Bench — внутренний бенчмарк, структурированный с использованием таксономии 2025 года от инкубаторного проекта. Версия, использованная в этой оценке, содержит 391 отобранный сценарий, полученный из реальных репозиториев с открытым исходным кодом, содержащих публично раскрытые и устраненные уязвимости. Уязвимости были выбраны относительно новыми, чтобы снизить риск насыщения модели, и охватывают все десять категорий таксономии.
Бенчмарк охватывает 17 языков программирования, включая C, C++, C#, Java, JavaScript, TypeScript, Python, Go, Rust, Kotlin, Scala, Erlang, Elixir, PHP, Perl, Ruby и Dart.
Каждый сценарий порождает две отдельно оцениваемые задачи. Для обнаружения агент получает уязвимый репозиторий, класс CWE и область поиска, а затем пишет отчет о результатах. Проверяющий модуль обнаружения требует наличия результатов с правильным файлом, CWE и принятым диапазоном строк; он также отклоняет необоснованные результаты для целевой CWE и ограничивает количество сообщаемых результатов. Для устранения уязвимости агент получает уязвимый файл и область и редактирует репозиторий; все необходимые статические проверки и поведенческие тесты должны пройти успешно. В результате получается 782 задачи с бинарным вознаграждением: 391 на обнаружение и 391 на устранение.
BLA-Bench намеренно сложен для универсального агента кодирования. Подсказка задачи определяет класс CWE и ограниченную область исследования. Тем не менее, стандартный агент не имеет примеров, специфичных для бенчмарка, учебника по категориям злоупотребления бизнес-логикой, уровня поиска безопасности или специализированного инструмента проверки. Таким образом, локализация и устранение зависят от восстановления уязвимого инварианта из репозитория и поведения, проверяемого валидатором задач.
Оценка Nemotron 3.5 Super VL в агенте кодирования с помощью BLA-Bench
Для сравнения, рассматриваемого в этом блоге, мы используем оригинальный Deep Agents Code от LangChain с OpenAI o4-mini в качестве эталонного агента. Мы используем OpenAI o4-mini в качестве экономичного эталона рассуждений с закрытыми весами, который, как считается, сопоставим по размеру с моделью Nemotron 3.5 Super VL. Цель выходит за рамки выбора моделей агентов: она заключается в создании специализированного на безопасности агента кодирования и постоянном улучшении качества его обнаружения и устранения, а также операционной эффективности.
- Обе конфигурации выполняли одни и те же 782 задачи: 391 задачу на обнаружение и 391 задачу на устранение.
- Обе использовали стандартный Deep Agents Code от LangChain без дополнительных специализированных инструментов безопасности.
- Настроенными моделями были NVIDIA Nemotron-3.5-Super-VL-120B-A12B и OpenAI o4-mini-2025-04-16.
- Обе использовали контейнеризированную среду оценки агентов с одинаковым адаптером Deep Agents и профилем среды выполнения.
- Таким образом, результаты описывают полностью настроенные системы для этого набора бенчмарков, а не изолированные веса моделей.
- Дополнительную информацию об оценке см. ниже.
Более высокое общее вознаграждение, а также вознаграждение за обнаружение и устранение у Nemotron
Рисунок 1. Наблюдаемые общие показатели вознаграждения, а также вознаграждения за обнаружение и устранение. Больше — лучше.
Nemotron получила вознаграждение по 452 из 782 задач (57,8%) по сравнению с 359 из 782 (45,9%) у o4-mini, что составляет разницу в 93 задачи с вознаграждением и 11,9 процентных пункта. Поскольку задачи объединены в пары, приблизительный 95-процентный доверительный интервал для общей разницы составляет от 8,4 до 15,3 процентных пункта.
Результаты на уровне задач благоприятствуют Nemotron в обеих частях бенчмарка. Вознаграждение за обнаружение составило 51,2% (200 из 391) против 40,7% (159 из 391) у o4-mini. Вознаграждение за устранение составило 64,5% (252 из 391) против 51,2% (200 из 391). Разница в устранении составила 13,3 процентных пункта по сравнению с 10,5 пунктами в обнаружении.
В контексте данного бенчмарка эта разница соответствует 41 дополнительной задаче обнаружения и 52 дополнительным задачам устранения, получившим полную награду от валидатора. Для команды безопасности приложений это может означать, что конфигурация Nemotron обеспечила действенную локализацию и проверяемое устранение в большем числе случаев. Обратите внимание, что это результаты тестов, а не оценки предотвращенных производственных уязвимостей, сэкономленных часов триажа или принятых без проверки патчей.
Диагностика выполнения показывает меньше маркеров ошибок и меньше исключений агента
Сериализованные результаты работы инструментов показывают более низкие показатели явных маркеров ошибок у Nemotron для каждого выбранного стандартного инструмента агента на рисунке 2. Наибольшие различия наблюдались для «execute» (6,6% против 21,6%) и «ls» (0,7% против 15,5%); «edit_file» остался инструментом с наибольшим сопротивлением для обеих конфигураций (40,5% против 46,0%).
Рисунок 2. Частота явных маркеров ошибок для выбранных результатов сериализованных инструментов, упорядоченная по частоте Nemotron от наименьшей к наибольшей. Меньше — лучше.
Среди всех проанализированных сериализованных результатов работы инструментов 1 191 из 21 278 результатов Nemotron (5,6%) содержали явный маркер ошибки, по сравнению с 831 из 8 015 результатов o4-mini (10,4%). В сохраненных результатах были зафиксированы исключения агента в 22 из 782 попыток Nemotron (2,8%) и в 32 из 782 попыток o4-mini (4,1%).
Производительность варьируется в зависимости от категорий злоупотребления бизнес-логикой
Nemotron продемонстрировал более высокий показатель вознаграждения, чем o4-mini, во всех 10 категориях злоупотребления бизнес-логикой (Business Logic Abuse). Наибольшие наблюдаемые различия были в BLA6, «Отсутствие проверки переходов» (67,4% против 45,3%); BLA8, «Раскрытие внутреннего состояния» (59.5% против 39,2%); и BLA10, «Злоупотребление теневыми функциями» (60,7% против 42,9%).
Наивысшие показатели вознаграждения Nemotron по категориям составили: BLA6 — 67,4% (58 из 86), BLA10 — 60,7% (34 из 56), BLA3 — 60,5% (46 из 76) и BLA5 — 60,3% (41 из 68).
Рисунок 3. Наблюдаемое вознаграждение по категориям злоупотребления бизнес-логикой для Nemotron 3.5 Super VL и o4-mini, отсортированное по вознаграждению Nemotron от наибольшего к наименьшему. Больше — значит лучше.
Самые низкие показатели вознаграждения Nemotron по категориям были в BLA7, «Нарушение квот ресурсов» (48,0%, 48 из 100) и BLA1, «Превышение лимита действий» (50,0%, 20 из 40). В совокупности на них приходится 140 из 782 задач, что делает их конкретными целевыми объектами для последующей доработки с целью улучшения локализации, проверки с помощью верификаторов и оценки для конкретных категорий.
Более высокое вознаграждение в 16 языках из 17
Nemotron лидировал в 16 языках из 17. Для Kotlin показатель составил 80,0% против 70,0% (16 из 20 против 14 из 20), разрыв составил 10,0 пункта, что меньше, чем у Scala (25,0), C# (20,8), Rust (20,0) и C++ (16,7). Dart стал единственным языком, где лидировал o4-mini (80,0% против 60,0%; 10 задач).
Рисунок 4. Наблюдаемое вознаграждение по всем 17 языкам программирования для Nemotron 3.5 Super VL и o4-mini, отсортированное по вознаграждению Nemotron от наибольшего к наименьшему. Больше — значит лучше.
Как использовать этот результат: используйте представление по языкам в качестве карты покрытия и расстановки приоритетов. Nemotron лидировал в 16 из 17 групп; будущие регрессионные тесты должны сохранять эту широту охвата, одновременно уделяя внимание сегментам с более низкой производительностью.
От базовой оценки к непрерывно совершенствующемуся агенту безопасности
Оценка обеспечивает базовый уровень для итеративного улучшения агента. Ее наиболее полезная ценность заключается в диагностике: BLA7 и BLA1 остаются сегментами с более низкой производительностью по категориям; явные маркеры ошибок в результатах работы инструментов по-прежнему сосредоточены в edit_file, а траектории выявляют возможности для сокращения избыточных шагов и потребления токенов. Две конфигурации также выдали существенно различающиеся объемы результатов инструментов: 21 278 сериализованных результатов для Nemotron и 8 015 для o4-mini, примерно в 2,65 раза больше. Это системное различие является конкретной целью для оптимизации обвязки агента и модели, а также для отчета о шагах, токенах и общем времени выполнения (wall time) наряду с вознаграждением.
Вознаграждение для конфигурации Nemotron оказалось выше, но эффективность — нет. По данным 782 задач, артефакты Harbor сообщают о 567,8 млн токенов (ввод плюс вывод) для Nemotron и 147,1 млн для o4-mini. Среднее время выполнения агента составило 106,1 секунды против 62,0 секунд, а среднее общее время выполнения попытки (wall time) — 615,6 секунды против 311,3 секунды. Учет токенов и кэша у провайдеров различается, поэтому эти итоговые значения носят описательный характер, а не являются нормализованным сравнением затрат.
Некоторые следующие шаги для агента:
- Обучите и оцените обнаружение перед исправлением, чтобы патч опирался на правильно локализованный инвариант безопасности.
- Используйте сохраненные успешные и неудачные траектории для оптимизации выбора инструментов, надежности редактирования, проверки и завершения работы, а не только конечных ответов.
- Повысьте эффективность траектории агента путем обнаружения повторяющихся циклов файлов и инструментов, требования измеримого прогресса проверки и остановки или эскалации, когда дополнительные итерации не дают новых данных.
- Повысьте эффективность использования токенов за счет сжатия контекста, выборочного сохранения истории и ограничения повторных чтений репозитория и больших результатов работы инструментов.
- Усильте сегменты с более низкой производительностью. Расставьте приоритеты для BLA7 и BLA1, улучшите локализацию обнаружения и контроль ложноположительных результатов, а также переоцените небольшую группу задач на Dart, прежде чем делать выводы по конкретным языкам.
- Проведите контролируемые абляции адаптеров и вывода перед полномасштабными бенчмарками, включая встроенные в модель элементы управления рассуждениями, бюджеты рассуждений, бюджеты вывода и другие поддерживаемые аргументы генерации.
- Повторно оценивайте ту же проверенную группу задач после каждого изменения модели или обвязки агента, а затем тестируйте генерализацию на более новых удерживаемых уязвимостях.
Этот цикл представляет собой практическую ценность BLA-Bench. Он превращает сложную проблему безопасности приложений в измеримую программу разработки систем: оценка, сохранение данных, диагностика поведения модели и обвязки агента, оптимизация и проверка на неизмененных и удерживаемых задачах.
На пути к надежному устранению уязвимостей с помощью агентов
В этой группе из 782 задач бенчмарка BLA-Bench конфигурация Nemotron продемонстрировала более высокое наблюдаемое вознаграждение в целом, а также как в обнаружении, так и в устранении. Она опередила o4-mini во всех 10 категориях злоупотребления бизнес-логикой и в 16 языковых группах из 17.
Для HCLTech и HCLSoftware эти результаты создают основу для дальнейшей оценки. Путь к надежному устранению уязвимостей с помощью агентов лежит через ориентированную на безопасность модель и обвязку агента, которые совершенствуются одновременно, причем траектории основаны на исполняемых доказательствах, а каждая оптимизация измеряется по одним и тем же результатам безопасности.
Исследуйте и попробуйте NVIDIA Nemotron 3.5 Super VL для ваших собственных агентов. Чтобы обсудить кодинг-агенты, специализирующиеся на безопасности, и оценку, свяжитесь с HCLTech.
Сведения о бенчмарке и оценке
- Бенчмарк: внутренняя оценка HCLTech BLA-Bench; 391 кейс и 782 задачи на модель.
- Оценка задач: бинарное вознаграждение, значение 1 присваивается только тогда, когда все проверки в верификаторе задачи пройдены, и 0 в противном случае.
- Каждая задача имела лимит памяти Docker в 4 ГБ.
- Покрытие бенчмарка: все 10 категорий из таксономии инкубационного проекта OWASP Top 10 2025 года для злоупотреблений бизнес-логикой и 17 языков программирования.
- Дизайн оценки: каждая задача имела одну оцениваемую попытку. Общее сравнение сопоставлено по одним и тем же 782 идентификаторам задач.
- Агент: LangChain Deep Agents Code и сопоставимый профиль среды выполнения (runtime profile).
- Модели: NVIDIA Nemotron-3.5-Super-VL-120B-A12B и OpenAI o4-mini-2025-04-16.
- Конфигурации моделей: в обеих конфигурациях установлен тайм-аут запроса модели/API в 600 секунд на вызов и max_completion_tokens равный 16 384.
- Конфигурации моделей: каждая модель использовала конфигурацию рассуждений, рекомендованную ее провайдером. Nemotron: мышление включено (thinking enabled), reasoning_budget 8 192 токена, температура 1.0, top_p 0.95. o4-mini: effort рассуждений (reasoning_effort) средний (medium), температура 1.0.
- Интерпретация подгрупп: срезы по категориям и языкам носят описательный характер и должны рассматриваться с учетом размеров их групп.
- Диагностика результатов инструментов: явный маркер ошибки — это сериализованный результат работы инструмента со строкой, начинающейся с error, exception, traceback или failed; это текстовый диагностический показатель, а не мера семантической корректности или надежности в продакшене.
- Доказательства: конфигурационные файлы Harbor, файлы result.json для каждой попытки, сериализованные файлы результатов и траектории агента, а также точные идентификаторы задач, объединенные с метаданными задач BLA-Bench для срезов по категориям и языкам.