Сервер llama.cpp теперь поддерживает модели принятия решений через эндпоинт /v1/systemone. Вы передаете состояние (текст, JSON, скриншот) и типизированные вопросы. Модель возвращает вероятность для каждого варианта за один проход вперед.
API следует формату System One, представленному в модели Jev от TypeSafe, поэтому существующим клиентам нужно лишь изменить базовый URL. Детали реализации приведены в PR #29818.
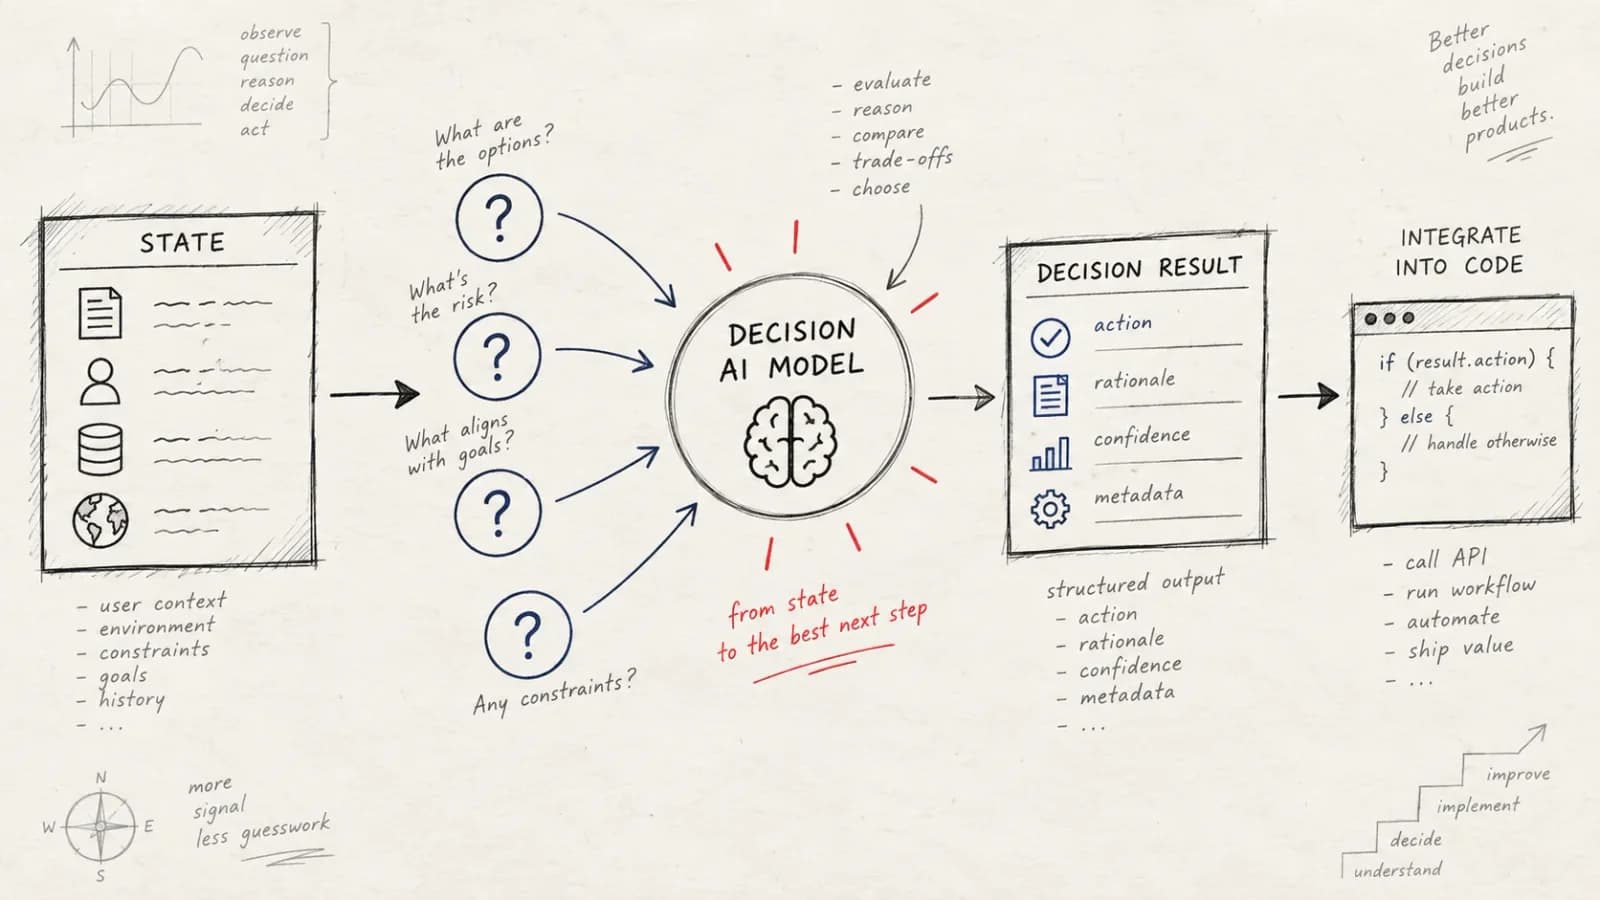
Что такое модель принятия решений? Это модель, которая отвечает путем оценки предоставленных вами вариантов, а не генерации текста. Чат-модель тратит один прямой проход на каждый токен вывода, и ее вывод все равно приходится парсить. Модель принятия решений считывает входные данные один раз, и ее ответом всегда является один из ваших вариантов с привязанной к нему вероятностью. Типичные варианты использования включают маршрутизацию запросов, модерацию контента, проверку успешности выполнения шага агента или выбор его следующего действия.
Что такое модель принятия решений? Это модель, которая отвечает путем оценки предоставленных вами вариантов, а не генерации текста. Чат-модель тратит один прямой проход на каждый токен вывода, и ее вывод все равно приходится парсить. Модель принятия решений считывает входные данные один раз, и ее ответом всегда является один из ваших вариантов с привязанной к нему вероятностью. Типичные варианты использования включают маршрутизацию запросов, модерацию контента, проверку успешности выполнения шага агента или выбор его следующего действия.
Поддерживаемые модели
*Медианное время ответа на один вопрос на одной видеокарте NVIDIA RTX PRO 6000.
Найдите эти модели в коллекции Decision models, в дальнейшем их станет больше. В сообществе Decision Index показано их сравнение.
Быстрый старт
Получите последнюю версию llama.cpp из llama.app (или запустите llama update), затем запустите модель:
Запрос содержит состояние и один или несколько вопросов. Существует три типа вопросов:
Отправьте запрос с вашим состоянием и вопросами:
Ответ (значения округлены):
Полная справочная информация находится в документации сервера.
Изображения
Некоторые модели (на момент написания статьи — OpenJev) также могут читать изображения, такие как документы или скриншоты. Визуальный проектор загружается автоматически:
Например, для классификации загруженного документа:
Состояние также может представлять собой список сообщений чата. Любая часть image_url (data URL) считывается как изображение, так же как и в чат-завершениях (chat completions).
Несколько моделей, один сервер
В режиме маршрутизатора модели загружаются по требованию, и вы выбираете одну для каждого запроса:
/v1/models выводит список идентификаторов. Если загружена только одна модель, поле model игнорируется.
Советы
- Попробуйте несколько моделей разного размера. Маленькие модели работают быстрее, большие знают больше. В Decision Index приводится их сравнение.
- Опишите свои варианты. Julia-1 направила запрос «С меня списали деньги дважды» в службу доставки при наличии только названий, и в биллинг (0.99), когда у каждого варианта появилось описание.
- Выберите порог уверенности для каждой модели. Распространенный паттерн — обрабатывать уверенные ответы, а остальные отправлять человеку. Правильный порог зависит от модели: расплывчатый тикет («Привет, быстрый вопрос по поводу моего аккаунта») получил оценку 0.25 с Julia-1, но 0.80 с Kev-4B. Протестируйте на собственных примерах перед выбором.
- Пакетная обработка вопросов. Они обрабатываются независимо друг от друга, а Kev-4B, lev и OpenJev обрабатывают состояние только один раз.
- Попробуйте разные квантования. Как и любые GGUF, эти модели поставляются в нескольких вариантах точности, например: llama serve -hf ggml-org/Kev-4B-GGUF:Q8_0.
Что дальше
Новые открытые модели принятия решений выходят каждую неделю, и мы продолжим добавлять лучшие из них. На очереди Clef от Cloudflare. Есть ли модель, которую вы ждете особенно? Расскажите нам в комментариях.