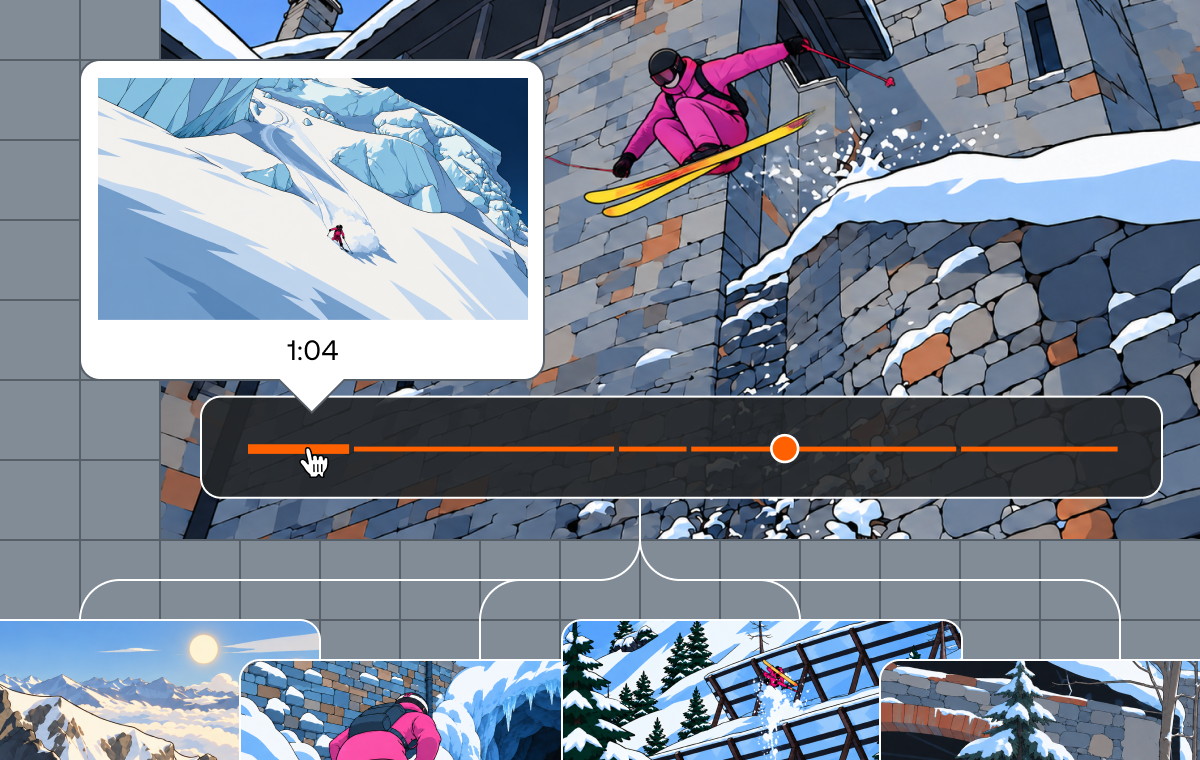
Я вырос на лыжах, и каждую осень начинаю смотреть вперёд на зиму. Я думаю о том, где мог бы покататься, какие поездки могу осуществить и как скоро выпадет снег. Это ожидание возвращает меня к лыжным фильмам, на которых я вырос, а также к любимым, которые я нашёл с тех пор. Кандид Товекс всегда был где-то в ротации. Один из тех, к кому я возвращался в последнее время, — «The Ultimate Run» Маркуса Эдера.
Это десять минут катания, смонтированных так, чтобы выглядеть как один невероятный спуск. Эдер движется от высокогорного пухляка через ледники, скалы, сноу-парк, замок и в кузов грузовика, прежде чем достигнуть дна долины. Это выглядит как единый лыжный спуск.
Я провёл большую часть этого года, работая над Mux Robots, размышляя о том, как AI-системы работают с видео. Когда лыжный сезон снова начал занимать мои мысли, эти две темы столкнулись. «The Ultimate Run» оказался хорошим способом объяснить то, что мы строили. Одно и то же видео выглядит совершенно по-разному в зависимости от вопроса, на который должен ответить рабочий процесс.
Для AI-системы, анализирующей «The Ultimate Run», ни один отдельный метод разбиения видео не подходит для каждого вопроса. Чтобы найти момент, когда Эдер получает максимальную высоту, используйте кадр. Чтобы определить переход от одного ракурса к другому, используйте план. Чтобы найти полную последовательность ледника, используйте сцену.
Это строительные блоки, которые мы используем в Mux, чтобы сделать AI-рабочие процессы для видео более сфокусированными и эффективными. Используя «The Ultimate Run» как постоянный пример, мы рассмотрим, что захватывает каждый блок, когда его использовать и как они работают вместе.
LinkНачните с вопроса
Одночасовое видео при 30 кадрах в секунду содержит 108 000 кадров. Передача каждого изображения в модель компьютерного зрения была бы медленной и дорогой. Большая часть работы уходила бы на многократный анализ кадров, которые не добавляют ничего нового к ответу.
Это была одна из первых проблем, которые нам пришлось решить при создании Mux Robots. Прежде чем модель сможет ответить на вопрос о видео, мы должны решить, какую часть видео ей нужно увидеть. Выбор полезного фрагмента видео сначала уменьшает проблему. Кадры и планы дают рабочим процессам сфокусированные визуальные входные данные. Сцены группируют отрезки, которые связаны по смыслу, а не только по внешнему виду. Моменты и главы превращают это понимание в результаты, предназначенные для зрителя.
Цель — дать модели как можно меньший фрагмент видео, сохраняя при этом достаточно контекста для ответа на вопрос.
Вот как это выглядит на примере «The Ultimate Run»:
Вопрос
Используйте
Что это даёт
Какое изображение показывает Эдера в момент максимальной высоты?
Кадр
Одно изображение в одной временной метке
Где монтаж переключился на новый ракурс?
План
Непрерывный дубль между склейками
Где начинается и заканчивается последовательность с ледником?
Сцена
Полный визуальный или повествовательный отрезок
Какая часть убедит моих друзей забронировать поездку?
Момент
Выборочный отрывок, предназначенный для зрителя
К какому разделу я хочу вернуться?
Глава
Именованный раздел более длинного видео
В какой части он катается через ледяной туннель?
Поиск на основе эмбеддингов
Результат, полученный по смыслу
LinkКогда достаточно одного мгновения, используйте кадр
Один кадр может ответить на многие вопросы. Кто на экране? Виден ли логотип? Какой текст появился? Какое изображение показывает Эдера в момент максимальной высоты?
Mux Robots использует кадры для задач, где одно изображение содержит ответ. Find Best Thumbnails оценивает кандидатные кадры по композиции, чёткости, лицам, видимому действию и другим сигналам, которые помогают изображению работать самостоятельно. Модерация анализирует отдельные кадры по всему видео на предмет визуальных сигналов, таких как нагота или насилие.
Творческие интерпретации того, что могло бы получиться из Mux Robots, потому что, ну, авторские права.
«Лучший» также зависит от того, кто увидит изображение и что вы хотите им добиться. Лыжнику может быть важен масштаб прыжка, сложность трассы или положение тела Эдера в воздухе. Тот, кто не катается на лыжах, может больше откликнуться на пейзаж или общую композицию. Find Best Thumbnail поддерживает управление выходом для аудитории и цели (как и все наши рабочие процессы), поэтому процесс может учитывать эти предпочтения при оценке кандидатов.
Кадр становится плохим выбором, когда ответ зависит от последовательности или времени. Одно изображение может показать Эдера на полпути вращения, но не может сказать нам, приземлился ли он. Кадр может показать его внутри ледника, но не то, как он попал туда или откуда выходит. Сэмплирование большего количества кадров покрывает некоторые из этих пробелов, но стоимость и задержка растут с каждым изображением. Меньший набор кадров, выбранных осознанно, обычно даёт модели более сильный вход, чем большая равномерная выборка.
LinkКогда картинка меняется, используйте план
План — это непрерывный дубль между двумя склейками. Он отвечает на узкий вопрос: когда изменилось визуальное состояние?
Функция Shots в Mux Video находит вероятные склейки, сравнивая последовательные кадры с помощью недорогих визуальных сигналов. Гжегож написал подробный разбор алгоритма обнаружения планов, так что я оставлю механику там. Для рабочего процесса важен результат — упорядоченный список границ и репрезентативное изображение для каждого плана.
«The Ultimate Run» — это плотный, быстро смонтированный визуальный контент. Фиксированный интервал сэмплирования может пропустить короткий ракурс, прыжок или смену рельефа. Сэмплирование с учётом планов сохраняет эти различные визуальные состояния, не заставляя модель проверять каждый кадр. Если мы возьмём фиксированную выборку в начале этого плана, мы даже не узнаем, что Эдер делает сальто по всему городу.
План всё ещё не может сказать нам, что Эдер вернулся к очереди на подъёмник. Он даёт следующей системе карту визуальных изменений. Другие сигналы решают, что означают эти изменения.
Это различие важно для разных типов контента. Десять минут подкаста могут содержать лишь несколько визуальных состояний, в то время как динамичный контент, подобный этому, постоянно переключается между ними. Полезный вход зависит от контента не меньше, чем от вопроса.
LinkКогда нужен полный раздел, используйте сцену
Поиск склейки в ледник — это вопрос плана. Поиск всей последовательности ледника — это вопрос сцены.
Сцена группирует соседние планы, которые связаны визуально или повествовательно. Её границы требуют больше контекста, чем могут дать одни лишь изменения пикселей. Где начинается и заканчивается эта повествовательная последовательность? Какой отрезок охватывает сноу-парк? Какие изображения, звуки и действия объединяются в одну узнаваемую часть видео?
Мы уже писали о том, как Find Scenes создаёт эту структуру. Если коротко: визуальные границы дают начальные окна, доступные подсказки из транскрипта добавляют звуковой контекст, а рассуждения модели группируют соседние окна, описывающие одну и ту же часть видео.
В «The Ultimate Run» мало закадрового текста; именно здесь мультимодальность Robots действительно проявляется и позволяет визуальным изменениям выполнять большую часть этой работы. Планы вокруг ледника могут быть сняты с разных позиций камеры, но вместе они описывают более крупную последовательность, которую зритель узнаёт как одну часть спуска.
Сцены дают вашему приложению компактную карту видео, предоставляя синхронизированные по времени разделы с достаточным контекстом для просмотра, поиска, таймлайнов редактора, навигации или рассуждений агента. Для The Ultimate Run это означает, что приложение может вернуть последовательность ледника как один связный результат вместо кучи соседних кадров.
Link Моменты и главы отвечают на продуктовые вопросы.
Кадры, шоты и сцены описывают то, что находится в медиа. Моменты и главы идут на шаг дальше. Их границы зависят от того, что кто-то хочет сделать с результатом.
В The Ultimate Run один шот может запечатлеть Эдера в воздухе. Хотя это отличный геройский кадр, хайлайты выходят за рамки одного момента. Ключевой момент захватывает самостоятельный фрагмент, который стоит выделить. Весь трюк — от подхода до взлета и приземления — имеет достаточно контекста, чтобы работать как отдельный клип.
Find Key Moments начинается с шотов, добавляет перекрывающийся контекст транскрипта, когда он доступен, и оценивает непрерывные диапазоны. После выбора кандидата он сэмплирует кадры внутри этого диапазона, чтобы описать, как развивается действие. Границы шотов обеспечивают четкие визуальные края; транскрипт и кадры помогают определить, является ли фрагмент самостоятельным. Результат создан для зрителя, а не как еще один низкоуровневый вход.
Главы отвечают на навигационный вопрос. Они делят более длинное видео на именованные разделы, которые помогают зрителям перейти к нужной части.
Главы The Ultimate Run следуют основным фазам спуска Эдера: «Высокогорье», «Ледник и ледяной туннель», «Скалы и снежный парк», «Замок» и «Финальный спуск». Вместе они образуют оглавление всего фильма. В отличие от ключевых моментов, главы не ограничены самыми примечательными фрагментами. Каждая часть видео принадлежит какому-то месту.
The Ultimate Run делает эти главы легко узнаваемыми для зрителя, потому что окружение резко меняется на протяжении всего спуска. Generate Chapters, однако, получает большую часть доказательств из транскрипта, а в фильме очень мало речи. Даже без дорожки субтитров наши мультимодальные рабочие процессы все еще функционируют, но с меньшим контекстом Generate Chapters имеет меньше материала для работы, чем для подкаста или лекции. Find Scenes лучше подходит для определения визуальной структуры этого конкретного видео.
Короче говоря, сцена описывает отрезок медиа, который принадлежит вместе, а глава дает этому отрезку место в ориентированной на зрителя навигационной структуре.
Один отрезок фильма может быть сценой, принадлежать главе и содержать ключевой момент. Эти ярлыки не взаимозаменяемы. Каждый отвечает на другой продуктовый вопрос.
Link Рабочие процессы объединяют эти строительные блоки.
Выбор точки старта не означает, что рабочий процесс остается на этом уровне детализации. Большинство полезных рабочих процессов начинаются с самого дешевого сигнала, который может сузить поиск, а затем добавляют детали там, где они могут изменить ответ.
Для выбора миниатюр шоты делят видео на отдельные визуальные состояния. Кадры предоставляют фактические изображения, которые могут стать миниатюрами. Использование обоих предотвращает трату фиксированного бюджета кандидатов на почти идентичные кадры из одного шота.
Во время обнаружения ключевых моментов шоты создают диапазоны кандидатов и помогают избегать клипов, которые начинаются или заканчиваются на середине склейки. Сигналы транскрипта объясняют, что было сказано, когда присутствует речь. Кадры внутри перспективных диапазонов показывают, как развивается действие. Эти входные данные создают момент с редакционным значением.
Обнаружение сцен в в основном визуальном фильме о лыжах опирается на смену шотов и репрезентативные изображения, чтобы выполнять большую часть работы. В подкасте сигналы транскрипта могут нести смену тем, пока камера почти не движется.
Один урок, к которому я постоянно возвращаюсь, работая над этими рабочими процессами, заключается в том, что больший контекст не автоматически означает лучший контекст. Рабочий процесс улучшается, когда получает информацию, которая может изменить его ответ, и пропускает остальное.
Link Эмбеддинги сталкиваются с тем же выбором.
Через несколько недель после просмотра спуска Эдера кто-то может вспомнить ледяной туннель, не зная, где он появляется в видео. «В какой части он катается внутри ледника?» — это поисковый вопрос.
Эмбеддинги превращают текст, изображения или мультимодальные входные данные в векторы, которые система может сравнивать по смыслу. Они решают другую часть проблемы, находя релевантный контент, а не определяя, где заканчивается шот или сцена.
Однако вопрос гранулярности никуда не исчезает. Должен ли этот поиск возвращать весь фильм, сцену ледника, шот внутри туннеля или один точный кадр? Результат по всему видео может быть достаточен для рекомендации связанного контента. Он недостаточно точен, чтобы перейти непосредственно к одному визуальному событию.
Эмбеддинг может представлять актив, диапазон транскрипта, визуальный отрезок, описание или мультимодальный фрагмент. Реализация может меняться в зависимости от модели. Полезный результат все равно должен быть достаточно широким, чтобы иметь смысл, и достаточно точным, чтобы его можно было использовать.
Не существует единственной универсально правильной гранулярности поиска для видео. Если вы думали о той же проблеме, напишите нам. Наша продуктовая команда с радостью покажет вам, над чем мы работаем.
Link Используйте наименьший фрагмент видео, содержащий ответ.
«Используйте ИИ для анализа этого видео» звучит как одна задача. На практике полезный рабочий процесс делает несколько выборов, прежде чем модель ответит на что-либо.
Он выбирает самый дешевый сигнал для сужения поиска. Он добавляет речевую или визуальную детализацию, когда этого требует вопрос. Он адаптируется к контенту, а не относится к подкасту как к лыжному фильму. И он держит машинно-ориентированные входные данные отдельно от концепций, которые вы показываете зрителю.
Эти выборы окупаются во всех рабочих процессах, которые мы запускаем сегодня, и в любых потенциальных будущих рабочих процессах: выбор миниатюр, модерация, анализ вовлеченности, автоматическое рефреймирование, поиск, обнаружение клипов и навигация. Та же основа может поддерживать таймлайны редактора, размещение рекламы, сборку трейлеров, описания доступности, проверку соответствия и рабочие процессы, которые анализируют только релевантный фрагмент актива.
Спуск Эдера воспроизводится как одна непрерывная линия вниз по горе. Для рабочего процесса это также 18 000 кадров, 159 шотов и 7 сцен, которые могут дать нам 5 глав и 2 ключевых момента. Все эти описания верны одновременно. Какое из них важно, зависит от того, что вы пытаетесь сделать.