При расследовании проблем со службой Kubernetes инженеры SRE и платформы должны понимать, что происходит в поддерживающей ее инфраструктуре. Например, запущен ли еще процесс? Перезапускался ли он? Испытывает ли планировщик трудности с размещением подов? Поиск ответов на эти вопросы часто требует от инженеров поиска по инвентарю процессов, изучения метрик ресурсов и запроса телеметрии плоскости управления Kubernetes. Агенты ИИ могут помочь в таких расследованиях, но им нужен доступ к правильным данным и достаточно контекста для их интерпретации. В противном случае они могут потратить слишком много времени на обнаружение доступных метрик и составление запросов либо в итоге работать с неполной информацией.
Datadog MCP Server соединяет ИИ-помощников с данными наблюдаемости в Datadog через протокол Model Context Protocol (MCP). Мы расширили возможности нашего MCP Server по исследованию инфраструктуры с помощью инструментов проверки работоспособности плоскости управления Kubernetes, поиска Live Processes и навыка работы с процессами, который направляет агентов к соответствующему источнику данных для каждого вопроса. Вместе эти возможности помогают агентам исследовать проблемы инфраструктуры, используя наблюдения за процессами, метрики ресурсов и сигналы работоспособности плоскости управления, собираемые Datadog.
В этой статье мы покажем, как вы можете:
- Проверить работоспособность плоскости управления Kubernetes за один вызов
- Предоставить агентам доказательства на уровне процессов с помощью поиска Live Processes
- Ответить на более широкие вопросы о процессах с помощью навыка процессов
Проверка работоспособности плоскости управления Kubernetes за один вызов
Проблемы с плоскостью управления Kubernetes могут влиять на рабочие нагрузки, даже когда базовые узлы выглядят работоспособными. Например, поды, которые остаются в состоянии Pending, могут указывать на проблемы планирования, в то время как медленные ответы kubectl могут указывать на задержку API-сервера или борьбу за ресурсы. Диагностика этих проблем требует изучения различных метрик в зависимости от того, какой компонент плоскости управления затронут.
Datadog MCP Server предоставляет четыре инструмента только для чтения, которые позволяют агентам ИИ оценивать работоспособность кластера Kubernetes, извлекая набор соответствующих метрик работоспособности для конкретного кластера за один вызов:
- API server: изучение частоты ошибок запросов, запросов клиентов с ограничением частоты (rate-limited) по глаголу и ресурсу, максимального количества запросов в полете (in-flight), запросов, отклоненных API Priority and Fairness, и поставленных в очередь запросов по уровню приоритета.
API server: изучение частоты ошибок запросов, запросов клиентов с ограничением частоты (rate-limited) по глаголу и ресурсу, максимального количества запросов в полете (in-flight), запросов, отклоненных API Priority and Fairness, и поставленных в очередь запросов по уровню приоритета.
- Scheduler: просмотр попыток планирования, длительности попыток планирования, длительности алгоритма планирования и длительности планирования подов для выявления задержек при размещении рабочих нагрузок.
Scheduler: просмотр попыток планирования, длительности попыток планирования, длительности алгоритма планирования и длительности планирования подов для выявления задержек при размещении рабочих нагрузок.
- Controller manager: проверка глубины очереди задач, добавления задач в очереди, длительности обработки, времени ожидания в очередях, количества горутин и количества потоков.
Controller manager: проверка глубины очереди задач, добавления задач в очереди, длительности обработки, времени ожидания в очередях, количества горутин и количества потоков.
- etcd: проверка доступности лидера, смен лидера, неудачных предложений записи, длительности фиксации бэкенда, длительности fsync журнала упреждающей записи (WAL) и времени кругового пути (RTT) между пирами.
etcd: проверка доступности лидера, смен лидера, неудачных предложений записи, длительности фиксации бэкенда, длительности fsync журнала упреждающей записи (WAL) и времени кругового пути (RTT) между пирами.
Каждый инструмент принимает имя кластера Kubernetes через параметр kube_cluster_name и необязательное временное окно. Окно по умолчанию составляет последние 10 минут, а запросы могут охватывать до 4 часов. Перед запросом метрик инструмент проверяет, распознает ли Datadog указанный кластер.
Например, предположим, что поды в кластере checkout-cluster оставались в состоянии Pending в течение 20 минут. Вы можете спросить у своего ИИ-помощника: «Поды застряли в статусе Pending на checkout-cluster в течение 20 минут. Справляется ли планировщик?» Агент может вызвать инструмент проверки работоспособности планировщика, чтобы получить метрики попыток планирования и длительности для этого кластера. Изучив возвращенные сигналы, он может помочь определить, требуют ли задержки планирования дальнейшего расследования. Вы также можете спросить, происходили ли в etcd смены лидера или медленные фиксации за последний час, или запросить более широкую оценку работоспособности плоскости управления.
С помощью этих инструментов агенты могут исследовать проблемы плоскости управления без предварительного поиска по каталогу метрик или составления индивидуальных запросов для каждого сигнала. Каждая метрика, предоставляемая инструментами, включает в себя:
- Описание простым языком
Описание простым языком
- Индивидуальный статус OK, no data или error, чтобы помочь агентам отличать отсутствующую телеметрию от успешных результатов запроса, и чтобы отсутствие одной метрики не приводило к сбою всего вызова инструмента
Индивидуальный статус OK, no data или error, чтобы помочь агентам отличать отсутствующую телеметрию от успешных результатов запроса, и чтобы отсутствие одной метрики не приводило к сбою всего вызова инструмента
- Точный запрос Datadog, использованный для получения метрики, который инженеры могут повторно использовать в дашбордах, блокнотах (notebooks) или мониторах для изучения метрики во время будущих инцидентов
Точный запрос Datadog, использованный для получения метрики, который инженеры могут повторно использовать в дашбордах, блокнотах (notebooks) или мониторах для изучения метрики во время будущих инцидентов
Инструменты работают с данными телеметрии, уже собранными Datadog. Они не выполняют команды внутри кластеров Kubernetes и не изменяют ресурсы кластера. Доступ регулируется в соответствии с правами вызывающего пользователя, включая Timeseries Query, Metrics Read и Hosts Read.
Инструменты плоскости управления дополняют наши существующие инструменты Kubernetes MCP, которые помогают агентам находить и проверять ресурсы Kubernetes. Агент может использовать эти инструменты для исследования затронутых рабочих нагрузок, а затем запросить инструменты плоскости управления, чтобы определить, может ли поведение на уровне кластера объяснить эти симптомы.
Предоставьте агентам доказательства на уровне процессов с помощью поиска Live Processes
Инструмент search_datadog_live_processes предоставляет агентам ИИ доступ к недавним наблюдениям за процессами, собранным с помощью Live Processes в Datadog. Агенты могут искать процессы по исполняемому файлу, командной строке, тегам или времени наблюдения, чтобы выяснить, запущен ли процесс, когда он запустился и какому пользователю он принадлежит.
Доказательства на уровне процессов полезны, когда метрики службы указывают на проблему, но не объясняют поведение отдельного процесса. Например, в службе могут происходить периодические сбои из-за перезапуска процесса, или инженеру может потребоваться подтвердить, какие аргументы командной строки получил процесс при запуске.
Инструмент поиска Live Processes возвращает информацию, включая:
- Имя исполняемого файла и командную строку
Имя исполняемого файла и командную строку
- Идентификатор процесса (PID) и идентификатор родительского процесса (PPID)
Идентификатор процесса (PID) и идентификатор родительского процесса (PPID)
- Владелец процесса и хост
Владелец процесса и хост
- Время запуска процесса и время последнего наблюдения
Время запуска процесса и время последнего наблюдения
- Теги процесса
Теги процесса
Агенты могут фильтровать наблюдения, выполняя поиск по именам исполняемых файлов или командным строкам, либо используя точные теги, такие как хост, сервис, окружение (env), метаданные Kubernetes и user:<name> для указания владельца процесса. Инструмент выполняет поиск за период по умолчанию, составляющий 15 минут. Live Processes хранит наблюдения в течение 36 часов, а отдельные запросы могут охватывать интервал до 1 часа.
Предположим, инженер подозревает, что процесс PostgreSQL перезапустился на хосте базы данных в producción. Он может задать вопрос: «Перезапускался ли процесс Postgres на db-prod-03 за последний день?»
Агент может выполнить поиск наблюдений процессов для указанного хоста и исполняемого файла, а затем сравнить время запуска процессов, чтобы найти признаки перезапуска. Аналогичным образом инженер может узнать, какие процессы запущены пользователем deploy на хосте или какие аргументы командной строки использует NGINX на хостах checkout.
В ходе внутренней оценки на реальных производственных данных Datadog протестировала инструмент поиска Live Processes в 10 сценариях на естественном языке (по три запуска на каждый сценарий). Правильность ответов возросла с 10% без использования инструмента до 96.7% с ним — то есть в 96.7% запускeв возвращенные записи процессов совпадали с публичным API. Эти результаты показывают, как прямой доступ к наблюдениям за процессами может улучшить ответы агента на оцениваемые вопросы.
Ограничение результатов поиска процессов в рамках бюджета контекста агента
Один процесс в среде Kubernetes может содержать более ста тегов своего хоста, контейнера, кластера и облачной среды. Возврат каждого тега для каждого процесса может исчерпать значительную часть доступного контекста агента до того, как он проанализирует результаты. Инструмент поиска Live Processes ограничивает размер ответа, помогая агентам работать с данными процессов из инфраструктуры с большим количеством тегов.
По умолчанию инструмент ограничивает объем ответа 10 000 токенов. Он также предоставляет курсоры пагинации и указывает, когда результаты были усечены. Агенты могут использовать эту информацию, чтобы распознавать неполные ответы и уточнять свои поисковые запросы.
Для общих вопросов об инвентаризации процессов или их подсчете агенты могут установить параметр include_tags: false, чтобы исключить подробную информацию о тегах. Это уменьшает размер каждой записи процесса и позволяет поместить в ответ больше процессов. Для целенаправленных расследований агенты могут сохранять теги, чтобы идентифицировать процессы, связанные с конкретным сервисом, хостом или рабочей нагрузкой Kubernetes.
Кроме того, Datadog удаляет секретные данные из возвращаемых командных строк перед передачей их агенту. Инструмент поиска работает только в режиме чтения и использует разрешение Hosts Read пользователя, выполняющего запрос.
Ответы на более общие вопросы о процессах с помощью навыка процессов
Поиск Live Processes предоставляет данные об отдельных процессах. Для вопросов, связанных с обнаружением процессов, покрытием инструментированием или потреблением ресурсов с течением времени, агентам необходимо выбирать из дополнительных источников данных Datadog.
Навык datadog/infrastructure/processes помогает агентам ИИ выбирать подходящий источник данных Datadog для вопросов, связанных с процессами. Навык предоставляет рекомендации по обнаружению процессов, наблюдениям Live Processes и метрикам процессов, включая то, какие данные запрашивать и как интерпретировать результаты.
Datadog предоставляет три взаимодополняющих источника информации о процессах, каждый из которых подходит для определенных задач расследования:
- Обнаруженные процессы: используйте DDSQL для исследования идентичности сервисов, языков программирования, стороннего ПО, интеграций, обнаружения трассировщиков APM и размещения процессов на хостах, в контейнерах и ресурсах Kubernetes. Функция обнаружения предоставляет почасовые снимки и не требует включения Live Processes.
Обнаруженные процессы: используйте DDSQL для исследования идентичности сервисов, языков программирования, стороннего ПО, интеграций, обнаружения трассировщиков APM и размещения процессов на хостах, в контейнерах и ресурсах Kubernetes. Функция обнаружения предоставляет почасовые снимки и не требует включения Live Processes.
- Live Processes: используйте search_datadog_live_processes для исследования наблюдаемых процессов, командных строк, владельцев, времени запуска и признаков перезапусков.
Live Processes: используйте search_datadog_live_processes для исследования наблюдаемых процессов, командных строк, владельцев, времени запуска и признаков перезапусков.
- Метрики процессов: запрашивайте использование ЦП для каждого процесса с помощью process.stat.cpu.total_pct и использование резидентной памяти с помощью process.stat.memory.rss. Агенты могут анализировать рейтинги или временные ряды за период до 36 часов, используя выполнение кода с помощью Datadog TypeScript SDK.
Метрики процессов: запрашивайте использование ЦП для каждого процесса с помощью process.stat.cpu.total_pct и использование резидентной памяти с помощью process.stat.memory.rss. Агенты могут анализировать рейтинги или временные ряды за период до 36 часов, используя выполнение кода с помощью Datadog TypeScript SDK.
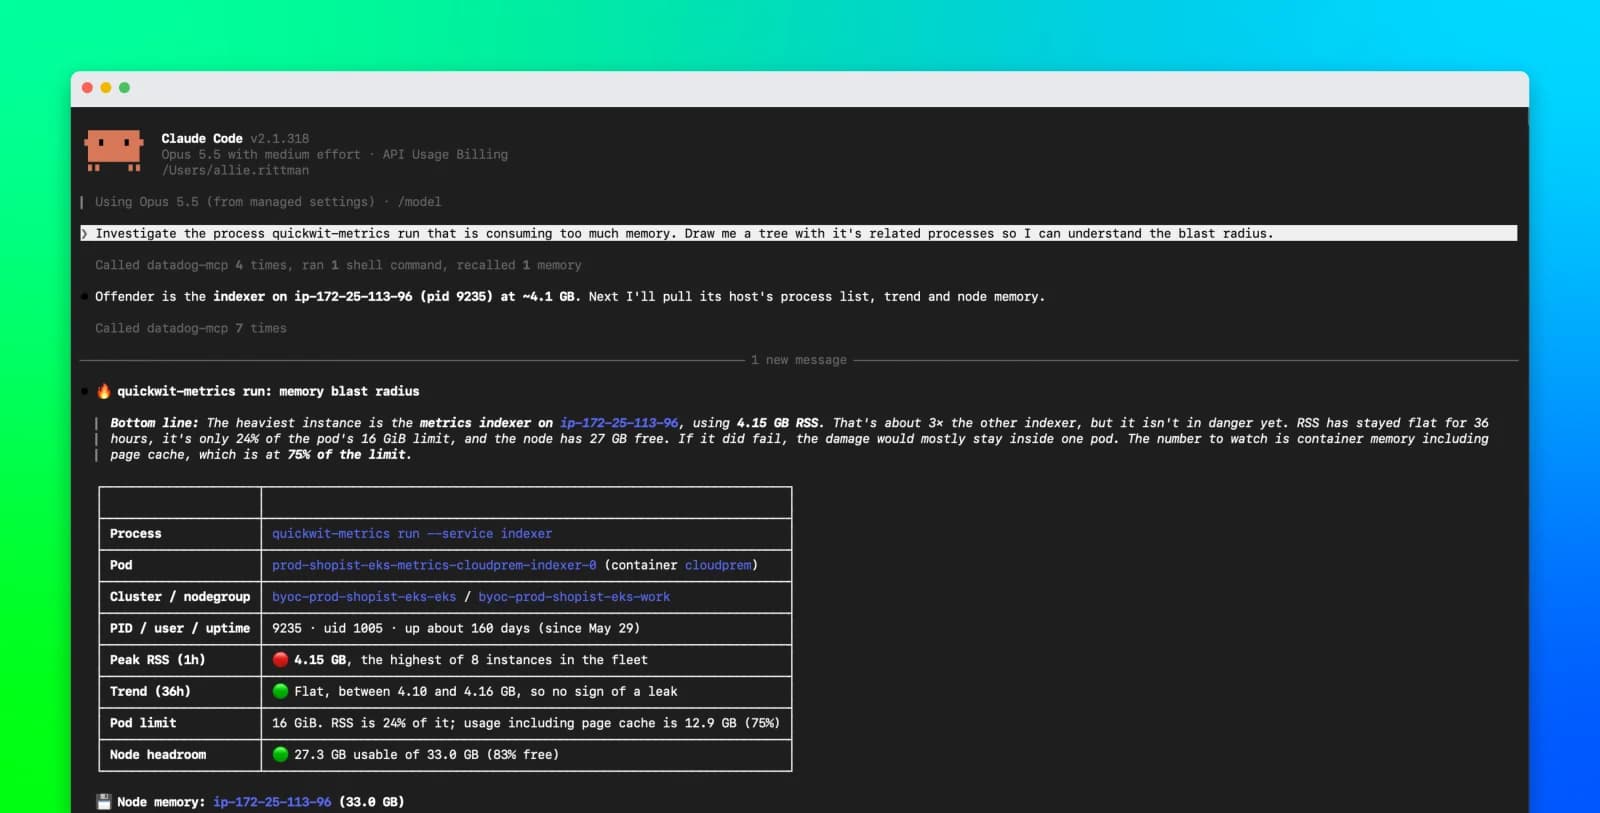
Этот навык помогает агентам направлять вопросы к тому источнику, который с наибольшей вероятностью на них ответит. Например, вопрос о том, где запущен Redis в рамках всего парка машин — это вопрос об обнаружении. Вопрос о том, перезапускался ли конкретный процесс Redis, требует наблюдений Live Processes. Исследование того, увеличилось ли потребление памяти процессом за последний час, требует использования метрик процессов.
Навык процессов может помочь агенту разобраться с вопросами, которые объединяют идентичность сервиса и инфраструктурный контекст. Например, инженер, исследующий покрытие инструментированием, может спросить: «У каких сервисов в пространстве имен payments нет APM?» Агент может использовать данные об обнаруженных процессах, чтобы определить приложения в указанном пространстве имен и проверить, обнаружил ли Datadog трассировщик APM. Для расследования ресурсов инженер может вместо этого спросить: «Какой процесс использует больше всего памяти на web-prod-01 за последний час?» Навык направляет агента к метрикам памяти процессов, позволяя ему сравнивать процессы за запрошенный период времени.
Навык процессов также предоставляет рекомендации для ситуаций, в которых агент может сделать неверный вывод на основе неполного ответа. Например, пустой результат обнаружения процессов не обязательно означает, что процесс отсутствует, а лишь то, что для соответствующего окружения отсутствует покрытие. Навык также объясняет, как обрабатывать усеченные результаты поиска Live Processes, инструктируя агента сузить фильтры и повторить ту же страницу перед тем, как следовать курсору пагинации.
Когда функция Live Processes не включена, навык предоставляет руководства по настройке для поддерживаемых сред, включая Datadog Agent, Docker, Helm, Datadog Operator и Amazon ECS Fargate. Руководство также учитывает требования к тарифным планам и биллингу. Любое изменение конфигурации удаленно через Fleet Automation требует явного одобрения пользователя.
Обучая агентов выбирать источники данных и обрабатывать неполные наблюдения, навык процессов помогает им формировать ответы, основанные на доступных данных.
Начните расследования в Kubernetes с помощью сервера Datadog MCP
Datadog MCP Server предоставляет ИИ-ассистентам доступ к метрикам плоскости управления Kubernetes и данным процессов с помощью инструментов расследования только для чтения. В сочетании с навыком работы с процессами эти возможности помогают SRE и инженерам платформы исследовать работоспособность кластеров, перезапуски процессов, использование ресурсов и покрытие инструментированием с помощью вопросов на естественном языке.
Чтобы начать работу, подключите вашего ИИ-ассистента к Datadog MCP Server. Среди поддерживаемых клиентов — Claude Code, Cursor, Codex, GitHub Copilot и VS Code.
Включите соответствующие наборы инструментов MCP для вашего расследования:
- Процессы: включите набор инструментов процессов для доступа к поиску Live Processes. Навык работы с процессами доступен, когда включен набор инструментов processes или ddsql.
Процессы: включите набор инструментов процессов для доступа к поиску Live Processes. Навык работы с процессами доступен, когда включен набор инструментов processes или ddsql.
- Плоскость управления Kubernetes: включите набор инструментов kubernetes-ops-center для запроса метрик работоспособности сервера API, планировщика, менеджера контроллеров и etcd.
Плоскость управления Kubernetes: включите набор инструментов kubernetes-ops-center для запроса метрик работоспособности сервера API, планировщика, менеджера контроллеров и etcd.
Для использования инструмента поиска и метрик процессов необходимо включить Live Processes. Для расследований плоскости управления Datadog уже должен собирать соответствующие метрики из кластера. Доступные метрики могут различаться в зависимости от дистрибутива Kubernetes и управляемого сервиса.
Инструменты процессов требуют разрешения Hosts Read. Инструменты плоскости управления требуют разрешений Timeseries Query, Metrics Read и Hosts Read.
Для получения дополнительной информации изучите документацию по инструментам Kubernetes для Datadog MCP Server. Если у вас нет учетной записи Datadog,