Наши внутренние ИИ-приложения многократно отправляют одни и те же системные инструкции, определения инструментов и историю разговоров большим языковым моделям (LLM). Кэширование промптов позволяет моделям повторно использовать эти данные из ранее обработанного ввода, сокращая расходы на обработку повторяющегося контента. Но во время расследования наших расходов на LLM мы обнаружили приложения, которые не извлекали выгоду из кэширования, даже когда оно казалось включенным.
Мы использовали Datadog Cloud Cost Management для анализа затрат провайдера, а затем исследовали отдельные запросы моделей с помощью Agent Observability. Мы обнаружили, что небольшие изменения между запросами могут помешать провайдеру повторно использовать уже проделанную работу. В некоторых приложениях кэширование также было включено без отправки информации, необходимой провайдеру для его использования.
В этой статье мы объясним:
- Как мы связали расходы на LLM с отдельными запросами
Как мы связали расходы на LLM с отдельными запросами
- Почему наши приложения не использовали кэшированные промпты повторно
Почему наши приложения не использовали кэшированные промпты повторно
- Как некоторые настройки кэширования не доходили до провайдера
Как некоторые настройки кэширования не доходили до провайдера
- Как мы оценили возможности снижения затрат
Как мы оценили возможности снижения затрат
Как мы связали расходы на LLM с отдельными запросами
Мы начали с анализа расходов провайдера в Cloud Cost Management. Затем мы использовали Agent Observability для исследования конкретных приложений и маршрутов API, которые они использовали для доступа к моделям. Агент может вызывать модель несколько раз для выполнения одной задачи, поэтому мы сравнили первый вызов с последующими вызовами в рамках этой задачи.
Каждый запрос может содержать инструкции для модели, описания инструментов, которые она может вызывать, и предыдущие сообщения. Приложение часто отправляет эти материалы снова, когда добавляет новое сообщение или результат работы инструмента. Мы хотели определить, повторно ли использует провайдер работу по обработке повторяющегося материала.
Мы изучили, сколько токенов использовал каждый запрос, его предполагаемую стоимость и сколько времени потребовалось модели для начала ответа. Записи в кэш показывали входные данные, использованные для заполнения кэша; чтение из кэша показывало входные данные, обслуженные из него. Сравнение этих показателей между вызовами помогло нам оценить, извлекают ли последующие запросы выгоду из предыдущих.
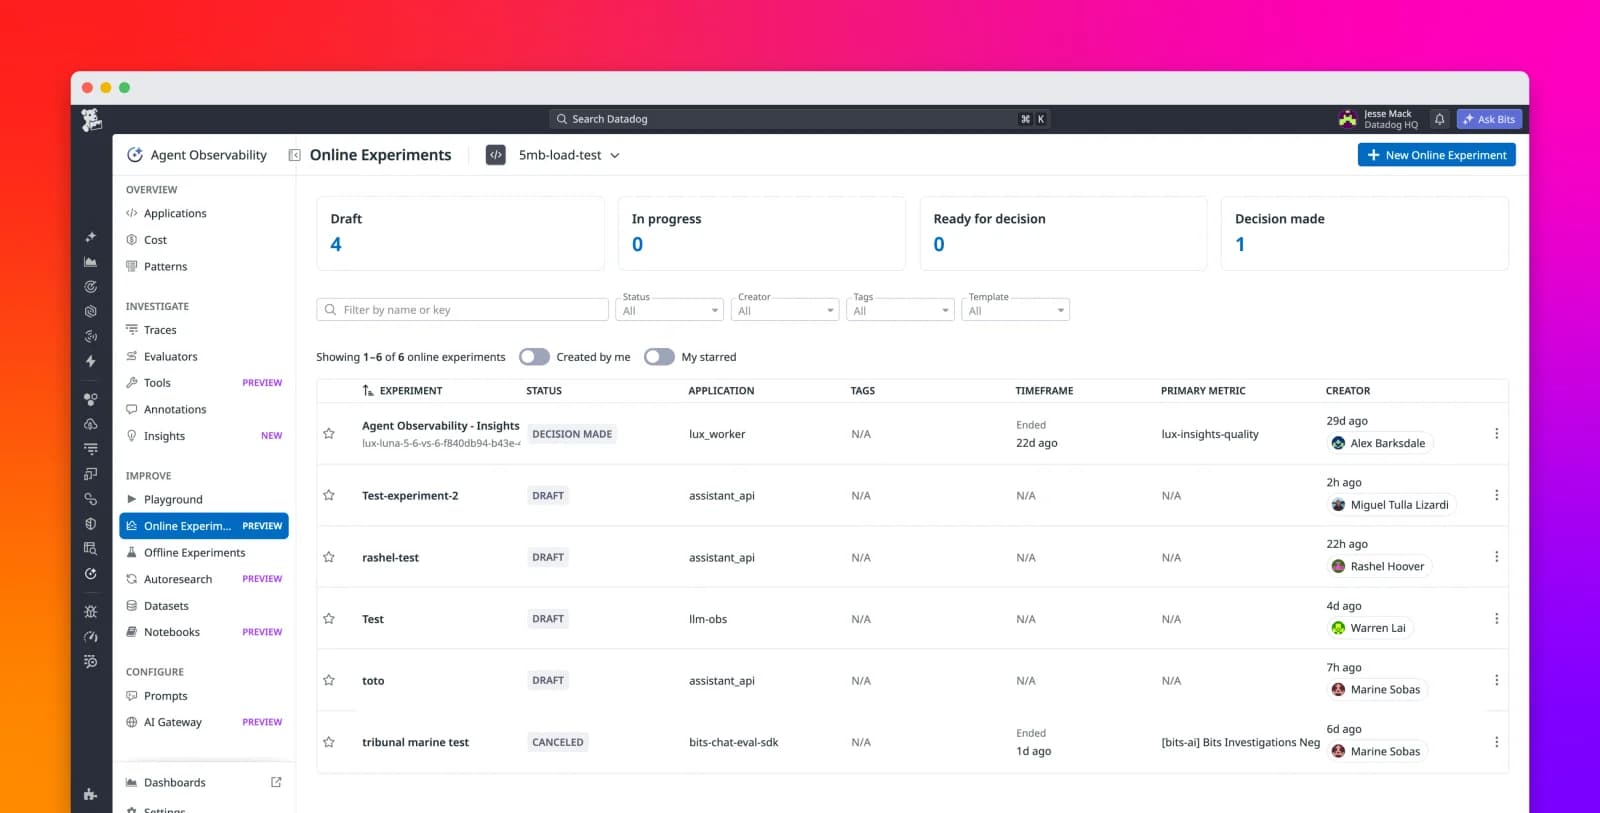
В примере ниже показаны три запроса без зарегистрированных попаданий в кэш. Каждый из них включал более 180 000 входных токенов, а предполагаемые затраты на ввод составляли от $0,74 до $0,82 за запрос.
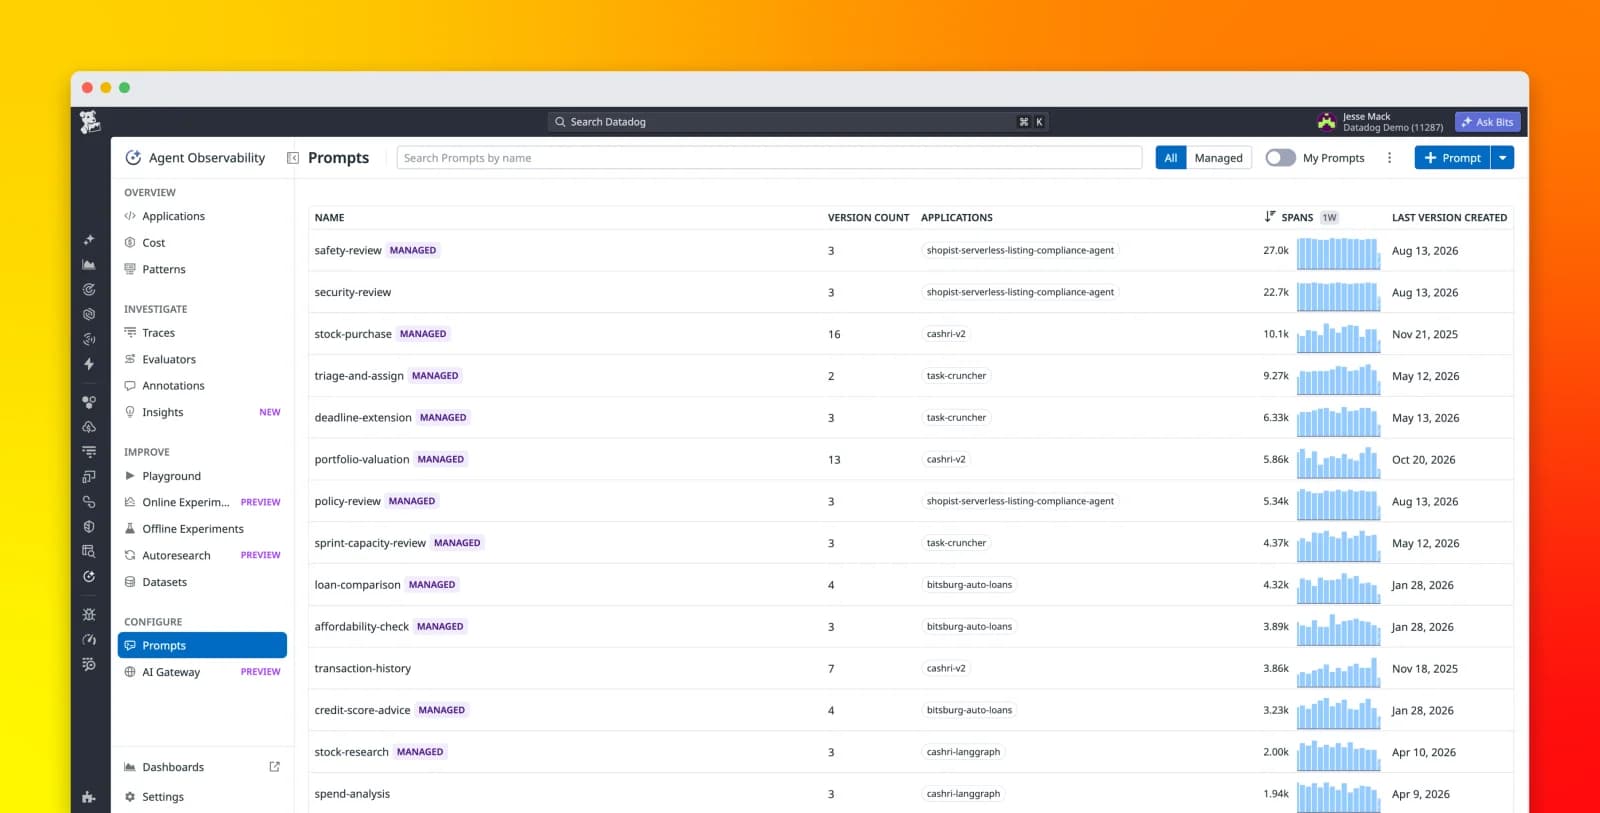
В примере кэширования ниже последующие запросы считывали больше входных данных из кэша и записывали в него меньше нового контента. Расчетные общие затраты составляли от $0,02 до $0,14 за запрос по сравнению с общими затратами от $0,74 до $0,86 за запрос в примере без попаданий в кэш.
Прежде чем делать выводы, мы проверили, что именно записали наши трассировки. Приложение и его шлюз могли одновременно записывать один и тот же вызов модели, из-за чего мы бы посчитали его стоимость дважды. И наоборот, запись с отсутствующими полями кэша могла создать впечатление, что кэширование не используется.
Мы сверили зарегистрированное использование с ответами провайдера и проверили полноту содержимого запросов. Некоторые записи не содержали системных инструкций или инструментов, из-за чего мы не могли объяснить, почему провайдер не использовал предыдущие входные данные повторно. Затем мы изучили код, который формировал и отправлял запросы.
Почему наши приложения не использовали кэшированные промпты повторно
Кэширование промптов зависит от сопоставления начала запроса, называемого его префиксом, с ранее обработанными входными данными. Различие в самом начале может помешать повторному использованию в остальном идентичного контента, следующего за ним. Наше исследование показало, как приложения могут вносить эти различия, даже когда они отправляют те же базовые инструкции или инструменты.
Изменяющиеся детали появлялись в повторяемых инструкциях
Один чат-сервис объединял свои системные инструкции с текущим временем, сведениями об организации, флагами функций и контекстом инцидента. Некоторые из этих значений могли изменяться между запросами. Если изменяющееся значение появлялось рано, провайдер мог не иметь возможности повторно использовать работу для инструкций, следовавших за ним.
Например, представьте запросы, начинающиеся с этих двух версий одной и той же инструкции:
- Первый запрос: «Время 10:00. Помогите инженеру разобраться с этим инцидентом».
Первый запрос: «Время 10:00. Помогите инженеру разобраться с этим инцидентом».
- Более поздний запрос: «Время 10:05. Помогите инженеру разобраться с этим инцидентом».
Более поздний запрос: «Время 10:05. Помогите инженеру разобраться с этим инцидентом».
Инструкция остается прежней, но временная метка меняется до того, как провайдер до нее доберется.
Предложенное нами изменение поставило стабильные инструкции на первое место, а специфичные для запроса детали — после них. Там, где это поддерживается, граница кэша должна была отмечать конец повторно используемой части. Модель по-прежнему получала бы необходимый контекст с теми же ограничениями на то, к какой информации она может получить доступ.
Мы также проверили, как часто меняются значения, прежде чем приписывать им промахи. Системный промпт одного приложения включал дату UTC. Это могло объяснить промах при смене даты, но не повторяющиеся промахи в течение дня. Другая очевидная ведущая временная метка исходила из записанного пользовательского контента, поэтому редактирование системных инструкций не решило бы эту проблему.
Одни и те же инструменты поступали в разном порядке
Чат-сервис формировал список инструментов путем итерации по карте (map) Go, которая не гарантирует порядок появления записей. Он мог отправить инструменты A, B и C в одном запросе, а затем B, A и C в другом. Поскольку описания инструментов могут быть частью кэшированного префикса, такая измененная последовательность могла помешать повторному использованию.
Связанный с этим патч сортировал имена инструментов перед созданием списка. Тест добавлял одни и те же инструменты в карты в разном порядке, а затем проверял, что полученные списки совпадают. Тест проверял поведение кода; для подтверждения того, что провайдер стал повторно использовать больше кэшированных входных данных, все равно потребовались бы последующие запросы модели.
У службы, которая генерировала промпты из исходного кода, была похожая проблема при перечислении файлов из карты. Различный порядок файлов изменял как сам промпт, так и то, какой контент оставался после сокращения промпта. Сортировка путей к файлам устранила эту несогласованность, хотя любые преимущества кэширования по-прежнему зависели от поддержки повторного использования бэкендом.
Как некоторые настройки кэширования не доходили до провайдера
Мы также проследили запросы через ПО, которое готовило их для провайдера. Приложение могло включить опцию кэширования, но при этом отправить запрос, в котором отсутствовали необходимые элементы управления или который использовал неподдерживаемый API.
Включенная опция не содержала необходимых элементов управления
В одном чат-сервисе была опция с именем WithPromptCaching. Она была включена, но в просмотренных нами запросах Anthropic не было никакой активности кэша. Опция добавляла бета-заголовок, но пропускала элементы управления в теле запроса, которые сообщали провайдеру, что именно нужно кэшировать.
Другое приложение не передавало опцию кэширования своего SDK компоненту, который подготавливал запрос для провайдера. Эти результаты дали нам конкретные пути в коде, которые требовалось изучить и изменить. Чтобы проверить исправление, нам нужно было проверить исходящие элементы управления и подтвердить, что последующий запрос считывает ранее кэшированные входные данные.
Один маршрут API не поддерживал кэширование
Наш шлюз мог отправлять запросы через родной API Messages от Anthropic или через его эндпоинт совместимости, который принимал запросы в формате API от OpenAI. Мы наблюдали чтение из кэша для родного трафика Messages и полное отсутствие активности кэширования для маршрута совместимости. В ходе расследования мы подтвердили по документации Anthropic, что маршрут совместимости не поддерживает кэширование промптов.
Перевод приложения на родной API стал потенциальным способом включения кэширования. Перед тем как рекомендовать это изменение, нам нужно было убедиться, что приложение по-прежнему сможет:
- Отправлять сообщения с правильными ролями и содержимым
Отправлять сообщения с правильными ролями и содержимым
- Вызывать инструменты и корректно получать их результаты
Вызывать инструменты и корректно получать их результаты
- Передавать ответы в потоковом режиме должным образом
Передавать ответы в потоковом режиме должным образом
Нам также нужно было измерить, какой объем входящих данных каждое приложение может использовать повторно. Некоторые приложения уже использовали оба маршрута, и использование их кэша на родном маршруте различалось. Сравнение маршрутов выявило возможность для исследования, но не определяло, сколько именно сэкономит каждое приложение.
Как мы оценивали возможности снижения затрат
Наши выводы указали на изменения, которые стоит оценить, включая сортировку инструментов, отделение инструкций от изменяющегося контекста и передачу элементов управления кэшированием провайдеру. Каждое из изменений требовало проверок, выходящих за рамки простой успешности запроса. Приложение могло продолжать отвечать правильно, при этом неоднократно оплачивая обработку входных данных, которые в противном случае могли бы использоваться повторно.
Нам также нужно было оценить задачи целиком. Некоторые провайдеры берут дополнительную плату за запись входных данных в кэш, поэтому многократная запись контента, который редко используется повторно, может увеличить расходы. Сохранение более длинной истории разговоров может увеличить объем отправляемых входных данных, даже если большая их часть кэшируется.
Для оценки изменений нам нужно было сравнить один и тот же маршрут приложения и тип задачи до и после, задаваясь вопросами:
- Читали ли последующие запросы входные данные, закэшированные предыдущими запросами, в том числе после вызова агентом инструмента?
Читали ли последующие запросы входные данные, закэшированные предыдущими запросами, в том числе после вызова агентом инструмента?
- Стала ли каждая выполненная задача дешевле с учетом выходных токенов, повторных попыток и вызовов запасных моделей?
Стала ли каждая выполненная задача дешевле с учетом выходных токенов, повторных попыток и вызовов запасных моделей?
- Как быстро модель начинала отвечать и сколько времени занимало выполнение задачи?
Как быстро модель начинала отвечать и сколько времени занимало выполнение задачи?
- Продолжало ли приложение отвечать точно и успешно использовать инструменты?
Продолжало ли приложение отвечать точно и успешно использовать инструменты?
Провайдеры сообщают о закэшированных входных данных по-разному, поэтому мы проверили, что именно включал каждый подсчет токенов. Наш нормализованный общий объем входных данных Agent Observability уже включает чтение и запись в кэш. Повторное добавление этих категорий привело бы к учету одних и тех же входных данных дважды и искажению расчетной стоимости.
DDSQL может группировать вызовы моделей по приложениям, провайдерам, моделям и временным окнам, чтобы облегчить повторное сравнение после изменений. Эти запросы по-прежнему требуют от нас идентификации того, какие записи представляют вызовы провайдера, которые мы хотим измерить. Расчетные затраты на токены могут помочь объяснить поведение запросов, в то время как счета от провайдеров необходимы для подтверждения финансовой экономии.
Что мы узнали об исследовании затрат на LLM
Изучение запросов помогло нам понять, почему включенные параметры кэширования не всегда работали так, как ожидалось. Некоторые промпты смешивали изменяющиеся детали с многоразовыми инструкциями, а некоторые запросы перечисляли инструменты в разном порядке. Другие запросы пропускали элементы управления кэшированием или использовали маршруты, которые их не поддерживали. Устранение этих проблем помогло нам повторно использовать закэшированные входные данные и сократить расходы на LLM.
Cloud Cost Management помогло нам проанализировать расходы на провайдеров, в то время как Agent Observability помогло исследовать, как приложения вызывают модели и используют токены. Другие команды могут следовать тому же подходу, чтобы проверить, получают ли их приложения пользу от кэширования промптов.
Для начала ознакомьтесь с документацией Agent Observability и документацией Cloud Cost Management.
Agent Observability предлагает бесплатный уровень с лимитом до 40 000 спанов LLM в месяц. Готовы выполнить инструментирование ваших приложений и агентов? Прочитайте руководство по быстрому старту.
Вы стартап? Компаниям, прошедшим отбор, предоставляются кредиты Datadog на год бесплатно. Подайте заявку на участие в программе Datadog for Startups.
Если вы еще не являетесь клиентом Datadog, зарегистрируйтесь для получения бесплатного 14-дневного пробного периода.