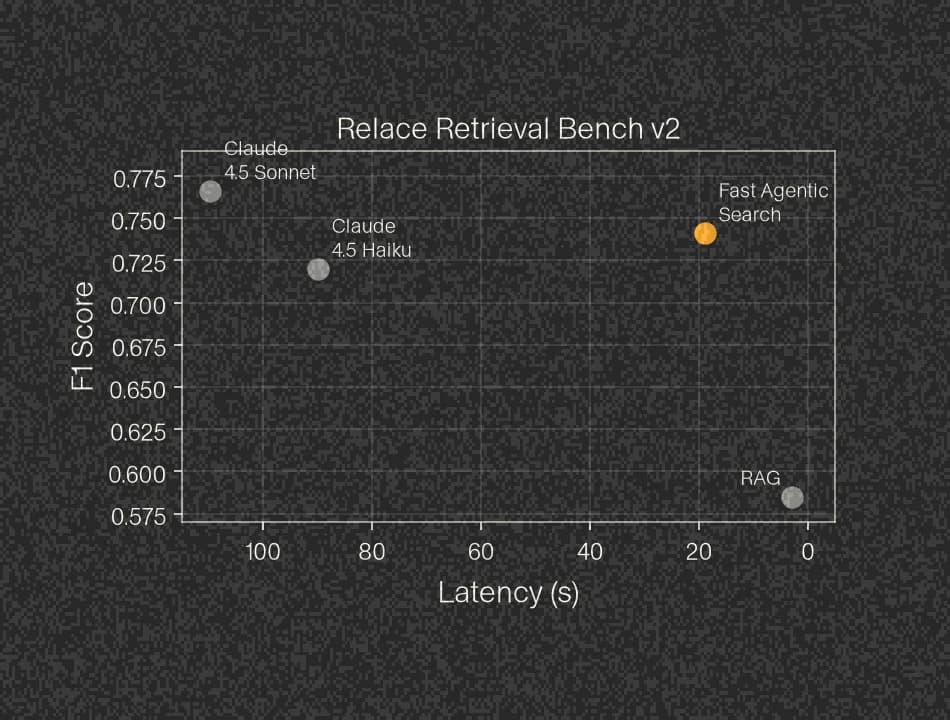
Сегодня мы выпускаем Fast Agentic Search (FAS) — суб-агент, специализированный на коде, обученный с использованием RL для поиска в кодовых базах файлов, относящихся к запросу пользователя.
FAS использует многоступенчатое рассуждение и параллельное выполнение инструментов view, grep и bash для одновременного исследования нескольких цепочек файлов. В конце он вызывает инструмент report_back, чтобы упаковать результаты поиска в минимальный набор файлов, которые основной агент может использовать как контекст для реализации желаемых изменений.
Это первый в нашей линейке небольших агентов, совместно оптимизированных с инфраструктурой. Вы можете запустить FAS в любом репозитории Relace с помощью relace.repo.search(repoId, { query });, который использует наш предварительно собранный агентский harness, предназначенный для обработки параллельных вызовов инструментов с низкими накладными расходами. Мы также предоставляем публичную конечную точку, которую вы можете использовать для вызова модели из своей собственной агентской платформы.
В этом блоге мы подробно рассматриваем, как мы обучили модель FAS, вдохновлённую моделью SWE-grep от Cognition.
RAG против агентного поиска
Месяцами ведётся дискуссия о том, использовать ли RAG или агентный поиск для извлечения данных из кодовой базы.
Раньше RAG был единственным вариантом, когда у моделей были ограниченные окна контекста. Вы разбиваете свою кодовую базу на небольшие фрагменты по границам файлов/функций, вычисляете векторные эмбеддинги для каждого фрагмента и сохраняете их в базе данных. При получении запроса пользователя быстрый алгоритм поиска по сходству векторов находит наиболее релевантные фрагменты кода и передаёт этот контекст модели.
Однако, по мере расширения окон контекста и улучшения способности моделей к многоступенчатому рассуждению, ограничения RAG стали более очевидными. Даже с использованием специализированных для кода моделей эмбеддинга/ранжирования, получить все релевантные файлы за один проход сложно.
Команда Claude Code под руководством Бориса Черни была первой, которая полностью отошла от стандартной настройки RAG, реализовав то, что они назвали агентным поиском. Вместо использования отдельной системы для курирования контекста модель сама ищет контекст в кодовой базе, используя командные строки view и grep.
Команда обнаружила, что это улучшило производительность, но с компромиссом:
За счёт задержки и токенов вы теперь получаете действительно отличный поиск.
За счёт задержки и токенов вы теперь получаете действительно отличный поиск.
Если вы пробовали Claude Code, вы, вероятно, видели почему. Модель работает последовательно, методично рассуждая о том, какие разделы кодовой базы релевантны.
Последовательные операции особенно медленны для моделей, вызывающих инструменты. Помимо сетевой задержки при обращении к серверу вывода, вызовы инструментов должны вернуть результаты перед переходом к следующему шагу.
FAS решает этот компромисс с помощью параллелизма. Модель сохраняет точность благодаря пошаговому рассуждению, но несколько путей поиска выполняются одновременно с использованием параллельных вызовов инструментов.
Изолирование задачи поиска
Конечно, специализированная модель вроде FAS полезна только если вы действительно можете отделить поиск от остальной части агентной задачи программирования.
Для измерения этой разделимости мы использовали кодовый агент для решения набора из примерно 1200 программных задач и искали первый вызов инструмента, не связанного с поиском, в каждой трассе. То есть инструмент редактирования файла или какой-то скрипт тестирования на основе bash.
Мы обнаружили, что в среднем поиск составляет 56,6% всех токенов, потреблённых моделью на протяжении всей трассы.
Многие токены, встреченные во время поиска, также оказываются нерелевантными. Формулирование сбора контекста как отдельной задачи с этапами поиск --> фильтрация --> передача результата предотвращает загрязнение контекста.
В совокупности эти результаты мотивировали целенаправленные усилия по обучению небольшой специализированной модели для поиска, которая могла бы работать быстрее и с меньшими затратами.
Создание среды RL
До FAS мы обучали модели только с использованием supervised fine-tuning (SFT) на наборах данных, состоящих из пар вход/выход чрезвычайно высокого качества.
Это было полностью «off-policy». То есть собранные нами данные не были взяты из выборки базовой модели, которую мы обучали.
Поскольку агентные задачи требуют длинных последовательностей вызовов инструментов с множеством разных путей к успеху, они должны быть гибкими. Мы наблюдали, что модели, обученные с off-policy SFT, являются последовательными, но хрупкими перед сдвигами распределения и изменениями подсказок.
Для задач с низкой энтропией, таких как Fast Apply, где почти всегда есть один правильный ответ и вы можете брать выборку из полного распределения запросов в production, эта хрупкость не является серьёзной проблемой.
Для обучения FAS мы решили, что необходимо настроить «on-policy» конвейер обучения с подкреплением. Вот как мы настроили окружение:
Определение примера поиска
Для FAS каждая точка данных состоит из начального состояния репозитория, хранящегося как Relace Repo, вместе с задачей программирования, определённой некоторым пользовательским запросом.
Мы собираем эти пары репо/подсказок из (1) партнёрств по данным с компаниями prompt-to-app и (2) pull request'ов, собранных с открытых репозиториев GitHub.
Преимущество (1) заключается в том, что данные берутся непосредственно из распределения, которого мы ожидаем увидеть в production для наших клиентов. Недостаток заключается в том, что нам нужно синтетически построить ground truth.
Для этого мы используем кодовый агент для выполнения задачи и парсим трассы, чтобы получить список файлов, отредактированных агентом, и список файлов, просмотренных агентом.
При (2) ситуация обратная. Мы можем получить надёжный ground truth, взяв файлы, фактически отредактированные человеческими разработчиками в pull request. Однако мы используем LLM для перевода истории комментариев pull request в реалистичный, полный пользовательский запрос, описывающий задачу. Для этого набора данных у нас нет аналога «viewed» файлов.
Агентский harness
Мы запускаем FAS внутри фиксированного agent harness, который предоставляет небольшой набор инструментов, специально предназначенных для этой цели.
Harness обеспечивает базовую модель пятью инструментами: view_file, view_directory, grep_search, bash и report_back.
Подсказка указывает модели исследовать репо с использованием этих инструментов, а затем возвращать свои выводы через инструмент report_back в структурированном формате:
Каждый путь к файлу сопоставляется со списком диапазонов строк [start, end], которые относятся к задаче
Использование точно такого же harness во время обучения и вывода критично для производительности. Любое несоответствие между интерфейсом инструмента, наблюдаемым во время обучения, и тем, который используется в production, может ухудшить поведение.
Мы подробно документируем весь harness и prompt здесь.
Функция вознаграждения
Согласно литературе по обучению моделей глубокого исследования, мы решили оценить производительность модели FAS с помощью F-меры инструмента report_back. То есть гармоническое среднее точности и полноты.
Однако мы внесли некоторые ключевые изменения, чтобы лучше соответствовать природе нашего набора данных. Проблема заключается в том, что ground truth для «relevant files» варьируется в зависимости от источника данных.
Отредактированные файлы необходимы, но не всегда достаточны — например, файл utils может быть релевантен для запроса как ссылка, но фактически не изменён. Просмотренные файлы достаточны, но не всегда необходимы — например, агент может случайно просмотреть файл, который вообще не связан с запросом.
Для данных GitHub (2) у нас есть только отредактированные файлы в качестве эталонных данных. Модель может правильно идентифицировать соответствующие справочные файлы, которые не были отредактированы, но они будут отмечены как ложные срабатывания. Чтобы учесть эту несовершенную эталонную информацию, мы используем оценку \(F_2\), которая взвешивает полноту в два раза больше, чем точность:
$$A_2 = \frac{5 P_h R_h}{4 P_h + R_h}$$
где \(P_h\) и \(R_h\) — это «жёсткая» точность и полнота, вычисленные по отредактированным файлам. Это снижает важность точности, поскольку мы ожидаем, что некоторые ложные срабатывания на самом деле будут правильными.
Для данных трассировки агента (1) у нас есть как отредактированные, так и просмотренные файлы. Просмотренные файлы включают шумное исследование, поэтому использование их в качестве эталонных данных неправильно наказало бы модель. Вместо этого мы используем гибридную оценку \(F_1\) с «мягкой» точностью, вычисленной по просмотренным файлам (более лояльно), и «жёсткой» полнотой по отредактированным файлам (гарантирует, что мы находим то, что необходимо):
$$A_1 = \frac{2 P_s R_h}{P_s + R_h}$$
где \(P_s\) — точность, вычисленная по просмотренным файлам, а \(R_h\) — полнота по отредактированным файлам. Это позволяет избежать наказания за правильные предсказания, которые случайно также были просмотрены во время исследования.
Второй критический компонент — это штраф за параллелизм. Хотя базовая модель была оснащена инструкциями для параллельного вызова инструментов, она чаще выполняла поиск последовательно. Наша гипотеза заключалась в том, что мы можем параллелизировать поиск с помощью \(4–12\) одновременных вызовов инструментов за один ход и значительно снизить общее количество ходов, сохранив при этом производительность.
Чтобы стимулировать меньшее количество ходов, оставаясь устойчивыми к манипулированию вознаграждением, мы применили штраф, который не оказывает эффекта при \(n \leq 4\) ходах, но линейно уменьшается до нуля при \(n = 24\) ходах:
$$P = \max\left(0, \frac{n_{\max} - n}{n_{\max} - n_{\min}}\right) \quad \text{где } n_{\min} = 4,\ n_{\max} = 24$$
Сочетая эти компоненты, окончательное вознаграждение выглядит следующим образом:
$$R = A \cdot P \quad \text{где } A = \begin{cases} A_1 & \text{на наборе данных (1)} \\ A_2 & \text{на наборе данных (2)} \end{cases}$$
Обучение модели
Настройка конвейера усиления обучения с гибкостью, необходимой для задачи поиска, заняла около месяца.
Открытые библиотеки полезны, но могут быть сложными, как только вы решите выйти за пределы проторенной дороги. В конечном итоге мы, возможно, опубликуем блог-пост о специфике нашей настройки вместе с экспериментами, которые мы провели вокруг настройки гиперпараметров для поиска, но мы опустим это здесь ради краткости.
Мы построили систему на базе verl и использовали Nebius для доступа к 8 узлам H200. Обучение заняло около 1,5 дней на одном узле для 3 эпох на 3,2 тыс. высококачественных точек данных.
Ниже вы можете увидеть прогрессию функции вознаграждения вместе с количеством ходов генерации, необходимых во время обучения:
Возникающее рассуждение
Первоначальное обращение к модели может оказать значительное влияние на динамику обучения, особенно при использовании многогранных функций вознаграждения (см. также Anthropic's post).
На ранних этапах обучения FAS мы не поощряли модель к рассуждению явно. На этих запусках первоначальные приросты вознаграждения были обеспечены почти полностью за счет использования параллелизма вызовов инструментов без прироста точности. Модель не выполняла рассуждений на этом первоначальном этапе.
Однако, как только количество ходов стабилизировалось ниже \(n_{max}\), модель больше не могла извлекать дополнительное вознаграждение только за счет параллелизма. Это привело к временному застою вознаграждения. После этого плато точность начала улучшаться, и вознаграждение снова увеличилось.
Интересно, что при изучении трассировок обучения на этом более позднем этапе мы заметили, что модель начала вставлять явные шаги рассуждения между всплесками параллельных вызовов инструментов.
Это подтверждает интуицию Бориса и команды Claude Code о том, что агентный поиск превосходит RAG, потому что он является мультишотным — модель может итеративно уточнять свое суждение о релевантности файлов, рассуждая об информации, собранной из других файлов.
Для более поздних запусков RL мы обновили промпт, чтобы поощрять рассуждение заранее. Это сделало увеличение вознаграждения более плавным в течение всего обучения.
Оценка модели
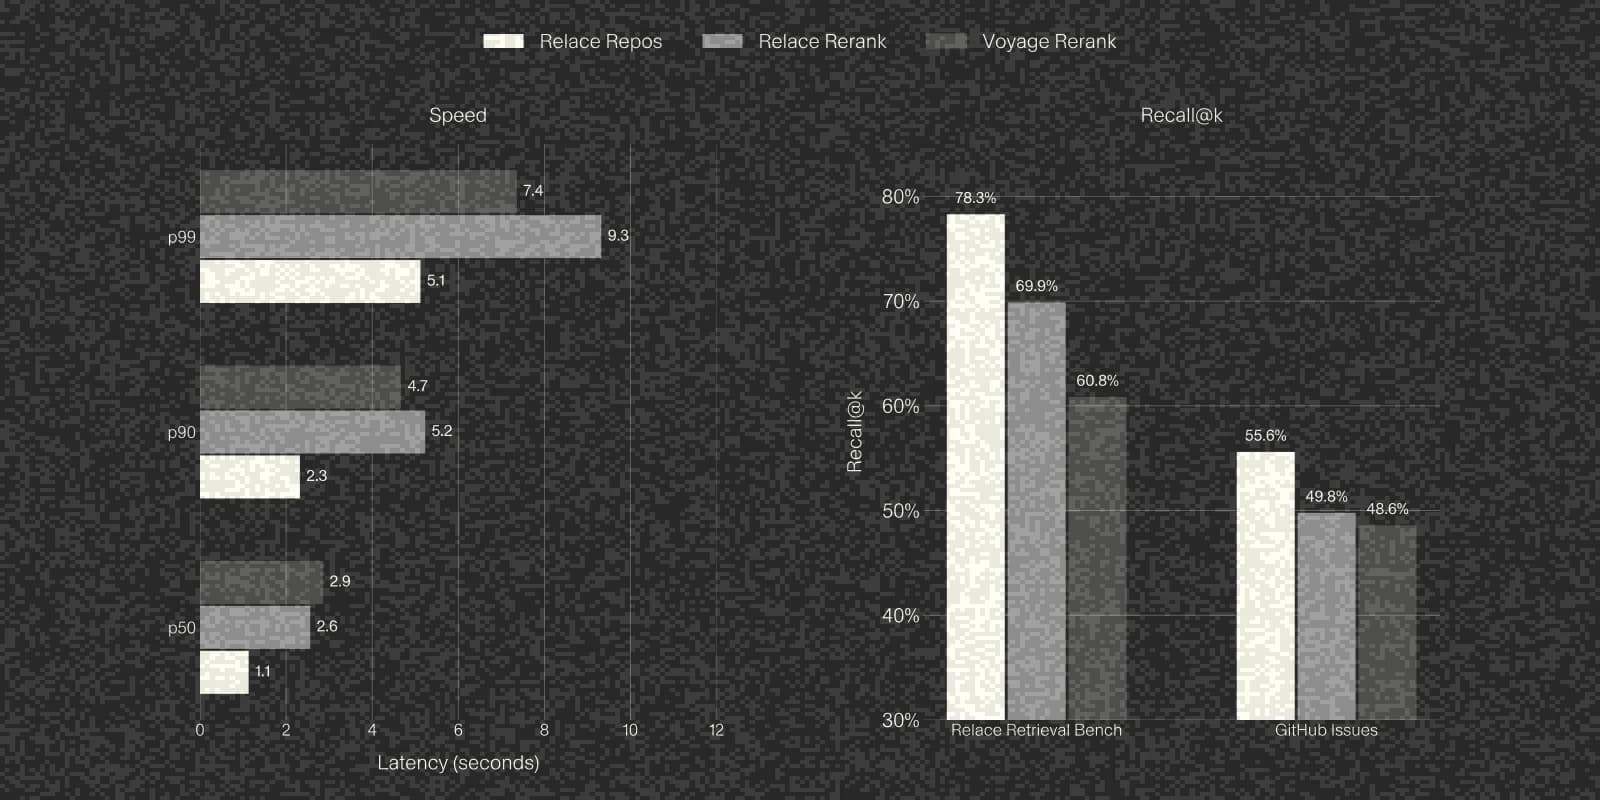
Для оценок, представленных на Рисунке 1, мы выделили 889 точек данных для справедливого сравнения с другими моделями на рынке — 465 из этих точек данных поступили из набора данных (1), а 424 — из набора данных (2).
На обеих задачах мы значительно снизили количество ходов: с 20 до 5 на (1) и с 10 до 4 на (2). Это составило более чем 4-кратное снижение конечной задержки в обоих случаях при сохранении схожей точности по сравнению с моделями типа Claude 4.5 Sonnet!
Поскольку задача поиска является предзаполненной в значительной степени с соотношением входных/выходных данных 15:1, мы обнаружили, что выходной TPS был гораздо менее важен, чем снижение количества ходов генерации и накладных расходов агента.
Вышеуказанное ускорение было достигнуто с использованием стандартного инференсного движка, работающего на скорости ~200 TPS.
На графиках видно четкое tradeoff между точностью и скоростью. RAG полностью параллелизуем и очень быстр, но он отстает в плане точности по сравнению с агентным поиском.
Эксперименты SWE-Bench
Наконец, мы хотели измерить конечную производительность фактической интеграции FAS в производственную систему. Для этого FAS является субагентом, который передает свой контекст центральному агенту «Оракул».
Мотивация
Наша цель для этих экспериментов была двоякой:
- Сохранить или улучшить производительность агента с FAS
Сохранить или улучшить производительность агента с FAS
- Снизить общее время генерации
Снизить общее время генерации
Бенчмарки в предыдущем разделе хорошо оценивали прирост задержки, но не было возможности убедиться, что конечная точность будет сохранена.
Для этого мы настроили оба агента так, чтобы они работали с проверенными данными SWE-Bench, и записали как точность, так и задержку.
Передача контекста
Перед запуском полного эксперимента с 500 примерами мы попробовали различные стратегии передачи данных между FAS и Оракулом, чтобы минимизировать дублирование усилий (повторное просмотр одних и тех же файлов) и регрессию производительности.
Интересно, что сжатие трассировки FAS для сохранения шагов рассуждения вместе с фактическими релевантными секциями файлов помогло агенту Оракулу лучше контекстуализировать результаты. В конечном итоге мы использовали этот метод для полного эксперимента.
Вы можете прочитать больше о точных инструкциях по передаче данных в нашей документации.
Результаты
Ниже приведены результаты эксперимента:
Стратегия
Медианная задержка
Точность
Общее количество токенов
FAS + Оракул
7 м 1 с
71,4%
890 млн
Стандартный Оракул
7 м 44 с
72,0%
1,03 млрд
Интеграция FAS снижает медианную задержку на 9,3% (43 секунды) и сокращает общее использование токенов на 13,6% (140 млн токенов) при сохранении сопоставимой точности.
На первый взгляд, это улучшение кажется низким, учитывая, что FAS обеспечивает ~4-кратное снижение задержки для самого поиска.
Однако мы обнаружили, что для трассировок SWE-bench первоначальный поиск составляет только ~12% от общего количества токенов в полном траекторном пути агента. Задачи богаты деталями и часто напрямую указывают на релевантные файлы.
Это резко контрастирует с нашими 1200 трассировками реального vibe-coding, где пользователи дают расплывчатые инструкции, которые приводят к тому, что почти 60% трассировки приходится на поиск. Мы ожидаем, что приросты будут гораздо больше в таких производственных условиях.
Таким образом, ключевой вывод состоит в том, что мы можем чисто отделить поиск от остальной части задачи программирования, не ухудшая производительность downstream.
Попробуйте модель
FAS теперь доступен поверх Relace Repos с нашим оптимизированным агентским harness. Попробуйте его на нашей площадке и дайте знать, что вы думаете!
Мы также выпустили совместимый с OpenAI конечный пункт как на платформе Relace, так и на OpenRouter, с ценой $1/миллион входных токенов и $3/миллион выходных токенов.
Это наша первая версия, которую мы надеемся улучшить еще больше с помощью отзывов сообщества!
Мы нанимаем
Если вы дошли до этого момента, вероятно, вам это интересно!
Мы нанимаем прагматичных исследователей (физика/математика/компьютерные науки/ML) и выдающихся инженеров, чтобы выпускать модели, на которые полагаются реальные продуктовые команды. Ознакомьтесь со страницей карьеры и присоединяйтесь к нам!