Вы создали конвейер оркестрации нескольких агентов. Один агент завершает свою работу и записывает результат. Следующий агент должен подхватить этот результат и начать выполнение. Что-то должно заметить, что первый агент закончил работу, и «разбудить» второго.
Обычно для этого добавляют брокер сообщений: публикуют событие в Kafka, запускают вебхук или создают очередь. Теперь вы запускаете вторую систему рядом с базой данных, поддерживая синхронизацию двух хранилищ и пытаясь связать журнал аудита, который находится в отдельной системе, с операционным состоянием.
Если ваши агенты уже хранят свое состояние в Neo4j, существует более простое решение. Запись в граф — это и есть событие. Change Data Capture (CDC) превращает каждое зафиксированное изменение в упорядоченный поток, который можно прочитать, поэтому переход задачи из состояния PENDING в ACTIVE становится сигналом, запускающим следующего агента. Состояние, события, решения по управлению и журнал аудита остаются связанными в одном графе, доступном для запросов через Cypher.
CDC — это функция AuraDB Business Critical и самоуправляемых версий Neo4j Graph Database Enterprise или Infinigraph. Если вы сейчас используете AuraDB Professional, это одна из причин, по которой команды переходят на Business Critical.
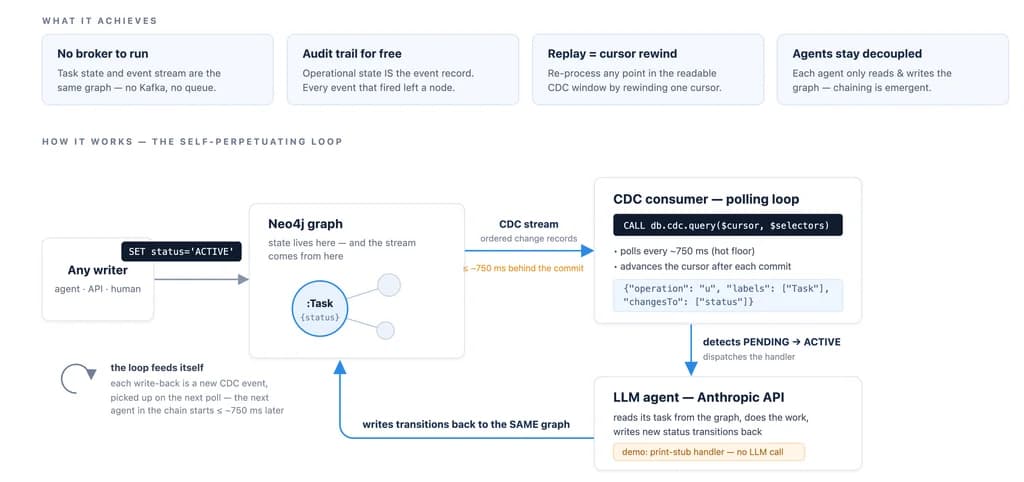
В этой статье рассматривается концепция и компромиссы, основанные на том, как мы используем этот шаблон в продакшене. Поскольку CDC работает в базе данных Business Critical, это скорее архитектурная статья, а не руководство по быстрому запуску за две минуты. Вот как выглядит вся система в целом.
Граф является системой учета состояния задач и передачи управления между агентами. CDC — это уровень, который сообщает вам в момент изменения любого состояния, чтобы вы могли на него отреагировать. В продакшене рабочим процессом является вызов LLM-агента, а результат записи, который он создает, сам по себе является записью об изменении, которая «будит» следующего агента в цепочке.
Один важный плюс сразу, чтобы вы понимали, к чему это ведет. Когда событие не может быть обработано (неверные данные, агент недоступен, попытки повтора исчерпаны), большинство стеков отправляют его в очередь недоставленных сообщений (dead-letter queue), которую вы проверяете с помощью отдельного инструмента. В графе это неудачное событие становится узлом со связями с задачей, к которой оно относилось, и агентом, который не смог его обработать. Вы проводите сортировку с помощью Cypher, прямо рядом со всем остальным. Мы вернемся к этому позже; пока просто отметьте, что сбои также остаются доступными для запросов.
Что открывает CDC
API Change Data Capture в Neo4j (db.cdc.query) возвращает упорядоченный поток записей об изменениях начиная с позиции курсора: создание каждого узла, обновление свойств и редактирование связей.
Вот реальный пример чтения, сокращенный из потребителя в продакшене:
Вы опрашиваете систему в цикле и продвигаете курсор при каждой фиксации; ORDER BY txId, seq сохраняет события в порядке фиксации. Селекторы — это карты, которые фильтруют данные по метке и измененному свойству, поэтому вы подписываетесь только на те переходы, которые вас интересуют. Например, {"operation": "u", "labels": ["Task"], "changesTo": ["status"]} запрашивает только обновления статуса задачи и ничего больше. В продакшене вызов также переключается на нефильтрованное чтение, если запрос селектора не удается, а область видимости во время выполнения не задана.
Каждая запись содержит транзакцию, которая ее создала, а также состояние измененной сущности до и после. Задача, переходящая из PENDING в ACTIVE, возвращается в таком виде, в формате Aura captureMode=DIFF:
Идентификатор (id) — это ваш курсор для следующего опроса. txCommitTime сообщает, когда изменение было зафиксировано, keys содержит идентификатор узла, вложенный под его меткой, а state.before/state.after показывают, что именно изменилось. Этого достаточно для маршрутизации события: прочитайте метки и state.after.properties.status и действуйте, когда задача переходит из PENDING в ACTIVE.
В продакшене это действие представляет собой вызов агента в реальном времени. Потребитель видит переход и передает задачу агенту через любой LLM API. Агент считывает свою задачу из графа, выполняет работу и записывает новые переходы обратно в тот же граф. Эти записи сами по себе являются записями об изменениях, поэтому следующий опрос подхватывает их и «будит» следующего агента в цепочке.
Что вы получаете
Это суть данного шаблона. Четыре преимущества, которые вы получаете бесплатно, когда граф является одновременно вашим хранилищем состояний и источником событий.
Ваше состояние и ваши события — это одна и та же транзакция. При использовании отдельного брокера публикация может быть успешной после того, как запись в базу данных не удалась, или запись может пройти, пока публикация потеряна. В итоге вы примиряете две системы, которые не согласны друг с другом. С CDC запись об изменении исходит из зафиксированной транзакции. Если запись в Neo4j зафиксирована, событие существует. Если она откатывается, откатывается и событие. Вы пропускаете таблицу исходящих сообщений (outbox) и двухфазную синхронизацию.
Все находится в одной плоскости запросов. Состояние задачи, передача управления агентам, история событий и решения по управлению находятся в одном графе. Вы можете ответить на вопрос «какие задачи выполняются более часа и кто над ними работает» с помощью одного запроса Cypher, потому что задача и ответственный за нее — это связанные узлы, а не строки, разбросанные по базе данных, брокеру и агрегатору логов.
Маршрутизация — это селектор. Добавление нового типа события означает добавление метки и расширение селектора. Вам не нужно подготавливать топик, настраивать группу потребителей или переразвертывать конфигурацию брокера. Пример выше
Сбои становятся узлами первого класса. Это то, что удивило меня больше всего. Когда событие не может быть отправлено, вы записываете его обратно в граф:
Эта запись о недоставленном сообщении теперь имеет связи с задачей, которая не удалась, и агентом, который не смог ее обработать. Вы запрашиваете ее, направляете рецензенту, прикрепляете примечания и помечаете как решенную — все это в Cypher. В нашей производственной системе «отравленные» события становятся узлами Handoff, направляемыми роли проверки человеком для сортировки. Очередь недоставленных сообщений живет в графе, рядом со всем остальным, что вы запрашиваете.
Повтор событий (replay) работает по той же модели: укажите потребителю более раннюю позицию курсора, и он повторно обработает данные оттуда, пока эта позиция находится внутри окна чтения. У этого окна есть ограничения, что подводит нас к компромиссам.
Честные компромиссы
Две вещи, которые нужно знать, прежде чем приступать к этому.
У него есть нижний порог задержки. Обнаружение CDC — это опрос курсора, поэтому он имеет порог около 750 мс на горячем пути:
Измерено на реальном развертывании AuraDB:
Дрейф в режиме ожидания является преднамеренным. Снижение активности, когда нечего обрабатывать, удерживает нагрузку на AuraDB почти на нуле, а следующий опрос срабатывает в течение ~750 мс, как только поступает работа. В цепочке рабочих процессов агентов каждый переход добавляет один порог опроса: трехэтапный конвейер — это три перехода, примерно 2,4 с задержки обнаружения от начала до конца, до начала работы самих агентов.
Чтение происходит в ограниченном окне
Ротация логов транзакций Aura и ограничения диска ограничивают глубину чтения потребителя. Сохраненный курсор не переживет ротацию лога транзакций, в котором хранились его записи. Из этого следуют четыре вывода:
- Ваш опросчик должен идти в ногу с интенсивной записью. Следите за его отставанием и рассматривайте растущий бэклог как операционное предупреждение.
- Аренда одного опросчика предотвращает дублирование обработки. Она не защищает от потери данных при ротации логов.
- Если опросчик падает и остается неактивным до тех пор, пока Aura не прокрутит логи дальше его курсора, пропущенные записи исчезнут из окна чтения.
- Когда этот разрыв становится критичным, направляйте CDC в Kafka для обеспечения долгосрочного хранения.
Последний пункт — это путь к масштабированию, и он заслуживает отдельного раздела.
Когда переходить на Kafka
Начните с прямого использования CDC, если Neo4j является вашим источником событий, один канал обработки соответствует рабочей нагрузке, а время обнаружения ~750 мс вас устраивает. Вы получаете минимальные эксплуатационные расходы и сохраняете состояние, события и аудит в одном месте.
Добавьте Kafka (или Temporal), когда вы перерастете эти рамки:
Рассматривайте это как переход на новый уровень. Neo4j остается источником изменений графа; CDC передает данные в Kafka, а Kafka становится надежным уровнем распределения. Temporal работает аналогично: когда вам нужны долговечные таймеры или координация саг, Temporal выполняет рабочий процесс, пока граф сохраняет состояние.
Вот как подход с прямым CDC соотносится с альтернативами. Сначала изучите две верхние строки перед строками задержки, так как именно там кроется основное различие:
Столбец с прямым CDC сохраняет ваше состояние, событие, которое его вызвало, проверку, которая его одобрила, и журнал аудита в одном связанном наборе данных. Остальные три столбца быстрее при передаче по сети, но каждый из них хранит рабочее состояние во второй системе, которую вам нужно запускать и синхронизировать. Таков компромисс: миллисекунды задержки в обмен на единое хранилище, где вся история задачи доступна через один Cypher-запрос.
Откуда это взялось
Этот шаблон работает в продакшене как CDCSessionManager в основе Aura OS, моей личной внутренней мультиагентной системы. Две небольшие части выполняют основную работу, и обе находятся в том же графе, что и данные.
Один опросчик (poller) на канал. Короткая аренда гарантирует наличие только одного активного опросчика на курсор, поэтому два воркера никогда не обработают одно и то же событие. Тот, кто первым выполнил SET, владеет каналом до истечения срока аренды:
Идемпотентная отправка. Каждый эффект обработчика привязан к детерминированной квитанции, поэтому повторное воспроизведение записи об изменении не может вызвать один и тот же побочный эффект дважды:
Что делать дальше?
Neo4j CDC доступен в тарифе Aura Business Critical и в лицензии Neo4j Enterprise Edition для самостоятельного управления. Если Neo4j уже хранит состояние вашей агентной системы, это именно тот компонент, который превращает граф в шину событий без необходимости запускать и синхронизировать отдельный брокер.
- Документация по Change Data Capture охватывает селекторы, курсоры и режимы захвата.
- Начните бесплатную пробную версию Aura Professional, чтобы спроектировать свой граф, а затем перейдите на Business Critical, чтобы включить CDC.