Меня подтолкнул к созданию этого инструмента паттерн, который я постоянно замечал. Люди начинают, не зная, как построить граф знаний.
Функция Document Intelligence решает эту проблему: вы указываете на свои файлы и получаете граф внутри Neo4j Aura. А затем возникает следующий вопрос.
У нас есть граф. Как мне развивать его и подключить к собственному приложению и системе?
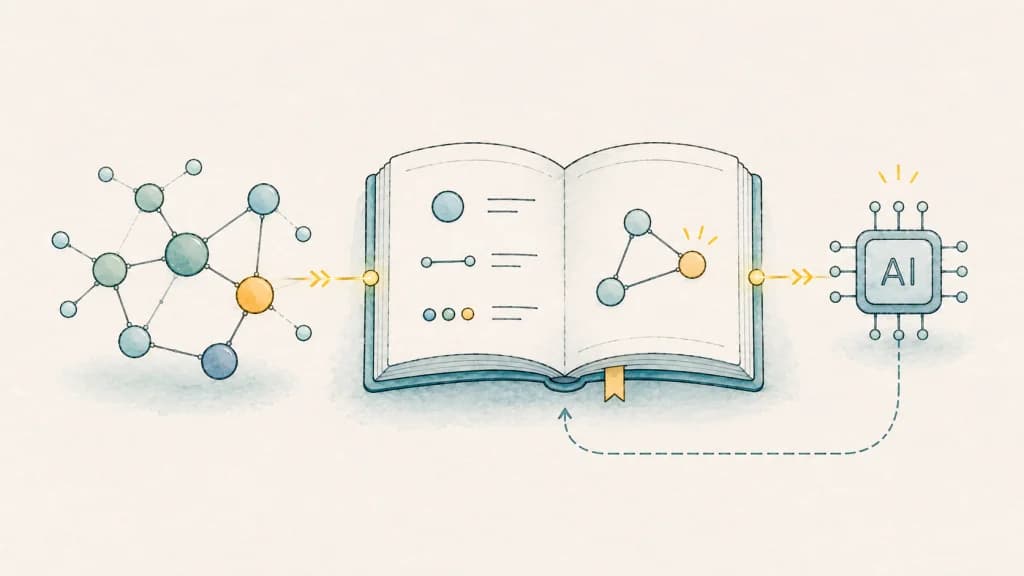
graph-explorer-kit, построенный на базе библиотеки neo4j-graphrag от Neo4j, извлекает граф и запускает над ним агента, работающего через API, к которому может обращаться ваше приложение. The Graph Explorer позволяет пользователям наблюдать за тем, как формируется ответ, и самостоятельно дополнять граф.
Чтобы протестировать весь путь, я запустил его на 240 опубликованных документах о наблюдениях НЛО. Это сканы машинописных отчетов и служебных записок, и одно и то же наблюдение может фигурировать в показаниях свидетеля, сводке разведки и отредактированной записке, которые противоречат друг другу.
1. Document Intelligence: от файлов к графу знаний
Document Intelligence превращает ваши файлы в граф знаний внутри Aura. Я начал с пяти опубликованных PDF-файлов, и результатом стал граф, содержащий информацию из них:
- Исходные файлы, разбитые на фрагменты с эмбеддингами
- Сущности и связи, извлеченные из этих фрагментов: люди, события, локации, агентства
- Ссылка от каждой сущности обратно на фрагмент, из которого она была получена
Эта ссылка обеспечивает прослеживаемость: любое утверждение можно отследить до фрагмента текста и PDF-файла, из которого оно взято.
Остальные 235 файлов были в основном сканами, поэтому я использовал пакет для их подготовки и загрузки по той же схеме.
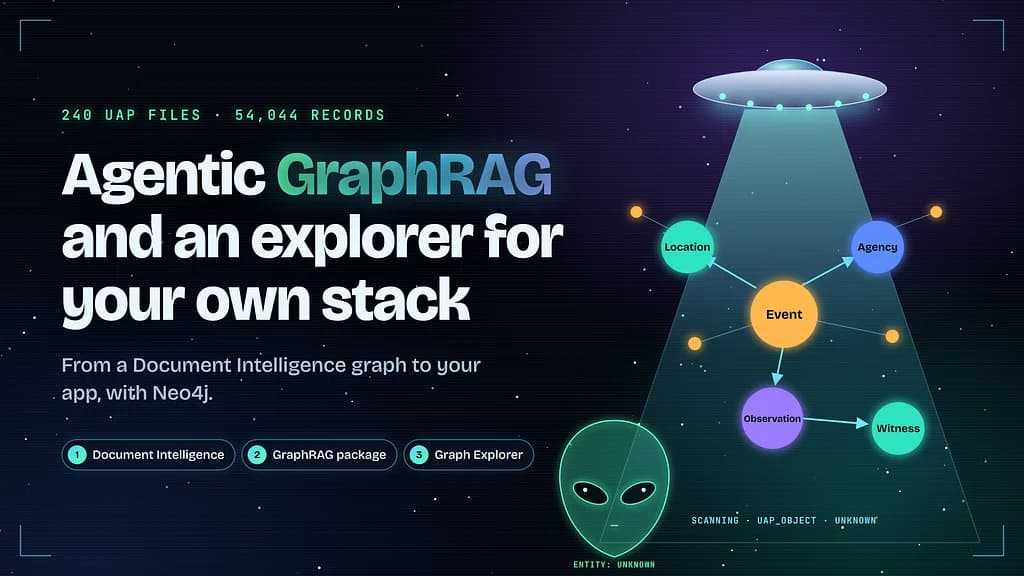
Это POLE (Person, Object, Location, Event — Человек, Объект, Локация, Событие), плюс агентства и сам бумажный след, с узлами Claim (Утверждение), Evidence (Доказательство) и Redaction (Редактирование).
Из 10 214 подготовленных страниц 6 759 имели пригодный текстовый слой, 1 499 потребовали OCR, а 1 956 были признаны нечитаемыми. Конечный результат — 54 044 записи, 58 429 связей и 24 971 фрагмент.
2. Набор GraphRAG: встройте его в свое приложение
Этот набор представляет собой библиотеку Python, построенную на базе neo4j-graphrag, и я старался сделать поверхность интеграции минимальной. Все, что касается вашей предметной области, находится в одном ProjectSpec, дата-классе Python в модуле вашего проекта: схема, правила извлечения, примеры Cypher, начальные вопросы.
Отсюда у вас есть три варианта:
- вызвать ретривер из собственного кода,
- передать его инструменты своему агенту,
- вызвать HTTP API.
POST /api/ask возвращает ответ, извлеченный контекст и связанный контекст графа в формате JSON, а /api/ask/stream отправляет ту же работу через server-sent events.
Он считывает граф Document Intelligence в исходном виде. Спецификация сообщает ему названия меток, а graphrag-adopt добавляет три вещи рядом с вашими данными: метку Chunk рядом с __Chunk__ из Document Intelligence (векторный индекс охватывает только одну метку), эмбеддинги из вашей собственной модели и читаемое имя источника для каждого файла (Document Intelligence хранит там длинную ссылку на загрузку). Флаг –dry-run показывает, что именно будет изменено, а –undo удаляет только то, что было добавлено.
Одним из недостающих элементов были эмбеддинги с использованием вашей собственной модели. Пакет создает эмбеддинги для каждого вопроса с помощью настроенной вами модели, и вопрос сопоставляется только с теми фрагментами, которые были обработаны той же моделью.
Векторы Document Intelligence поступают из модели (gemini-embedding-001), поэтому я снова создал эмбеддинги фрагментов с помощью модели, которую уже использовал для загрузки, поиска и работы агента, и сохранил векторы рядом с оригиналами.
Собственный индекс Document Intelligence продолжает работать. Если вы можете вызвать модель эмбеддингов, которую он использовал, этот шаг можно пропустить. В противном случае выберите любую модель эмбеддингов для набора и установите EMBEDDING_DIMENSIONS в соответствии с размером вектора этой модели (1536 для text-embedding-3-small, 3072 для text-embedding-3-large). Векторный индекс создается с фиксированной шириной, поэтому они должны совпадать.
Теперь перейдем к нашему вопросу о Нью-Мексико: «Что свидетели сообщали о Нью-Мексико в 1949 году и какие агентства это расследовали?» Показания свидетеля говорят о том, что было замечено. Сводка разведки говорит о том, какое агентство проводило расследование. Ни один фрагмент не содержит обоих ответов, поэтому векторный поиск выдает два половинчатых ответа. Граф содержит всю цепочку: Событие, которое ПРОИЗОШЛО_В локации, было РАССЛЕДОВАНО агентством и ИМЕЕТ_НАБЛЮДЕНИЕ, которое было СООБЩЕНО свидетелем.
Фиксированный ретривер все равно отвечает только на часть некоторых вопросов. Семантический поиск недосчитывает. text2cypher считает правильно, но редко читает прозу. Поэтому я даю агенту ретриверы в качестве инструментов. Он выбирает один, иногда вызывает несколько, и делает повторный запрос, как только прочитает результат:
- search_documents: гибридный поиск (векторный, полнотекстовый и графовый) для всего, на что есть ответ в тексте.
- query_graph_with_cypher: подсчет и перечисление всех совпадений. Запись запрещена.
- look_up_entity: поиск по известному имени и его связям.
- graph_overview: обзор существующих типов данных.
Спросите агента: «Какие агентства расследовали больше всего событий?», и он сам сгенерирует Cypher для выполнения. Когда он считает, он замечает, что одно и то же событие записано под разными именами, и сообщает оба числа, что отлично подходит для демонстрации. Если вы предпочитаете выбирать стратегию самостоятельно:
- vector: только векторный поиск. Фрагменты, которые звучат как вопрос.
- hybrid: векторный + полнотекстовый. Восстанавливает имена собственные, которые размываются при эмбеддинге.
- vector-cypher: векторный + графовый. Расширение графа, без сопоставления по ключевым словам.
- hybrid-cypher: векторный + полнотекстовый + графовый. По умолчанию.
- text2cypher: только графовый. Пишет Cypher. «Какие формы были зарегистрированы и как часто?»
Простое слияние по точному совпадению имен объединило бы 48 отредактированных свидетелей из 15 файлов в одного человека. Поэтому [REDACTED] никогда не объединяется, и объединяются только те метки, которые выступают в качестве идентификаторов, такие как Agency и Location, между документами.
Выберите свои модели: Microsoft Foundry или OpenAI
Набору нужна одна модель чата и одна модель эмбеддингов от Microsoft Foundry (по умолчанию, вход через Entra ID после az login, ключи не сохраняются) или OpenAI (LLM_PROVIDER=openai и OPENAI_API_KEY). Убедитесь, что EMBEDDING_DIMENSIONS соответствует вашему развертыванию эмбеддингов. Остальное описано в руководстве по движку.
3. Graph Explorer
Explorer — это просто клиент того же API, и graphrag-serve открывает его в вашем браузере. Задайте вопрос о Нью-Мексико, и граф отобразится вместе с конвейером: сначала найденные фрагменты, затем извлеченные из них сущности, затем один переход к соседям, пока модель еще пишет ответ.
Начните с основы. Графическое представление открывается на наиболее связанных записях: ФБР, USCENTCOM, ВВС, НАСА и AARO. Дважды щелкните по ФБР, и отобразятся шестьдесят его связей.
- Сверните данные. Types показывает по одному узлу на метку, например Document MENTIONS ×37 937. Schema объясняет, почему Claim, Evidence и Redaction являются узлами, а Timeline упорядочивает события по датам.
- Задайте уточняющий вопрос. «Какие агентства расследовали события над Нью-Мексико?», затем «а какие из них фигурируют в отчетах о миссиях 2020-х годов?». Поток живет в том же экземпляре Aura.
- Расширьте граф. Перетащите недавно опубликованный PDF-файл в область загрузки. Скан будет распознан (OCR) при добавлении, а затем то, что он добавил, подсветится.
У этого подхода есть определенные ограничения. Кольца формируются на основе отдельного поиска, поэтому воспринимайте их как связанный контекст графа, а не как трассировку каждого утверждения. Сканирование также содержит шум: некоторые записи Агентства представляют собой строки с датами, считанные со штампа. Ничто здесь не утверждает происхождение чего-либо. Граф хранит то, о чем сообщили наблюдатели, что зафиксировали приборы, к чему пришли агентства и в чем они расходятся во мнениях. Каждый этап я называю кольцом: сначала попадают сопоставленные фрагменты, затем извлеченные из них сущности, а после — один переход соседей, причем каждое кольцо вырастает из того, что уже отображается на экране.
Начать работу
–relax-constraints требуется только в том случае, если вы хотите добавить новые документы. Document Intelligence создает ограничения уникальности и существования, которые отклоняют второе упоминание одной и той же сущности, поэтому новый документ будет безмолвно обработан в ничто. Этот флаг отменяет данные ограничения, заменяет их обычными индексами и записывает точные определения в ваш граф. Команда graphrag-adopt –undo восстанавливает их. Сначала запустите graphrag-adopt –dry-run, чтобы посмотреть, что изменится.
- Начало разработки. Клонируйте graph-explorer-kit и замените его своей собственной схемой и корпусом.
- Посмотрите пошаговое руководство. Превратите публичные документы об НЛО с сайта war.gov/ufo в обоснованного агента графа знаний.
- Прочитайте анонс. Представляем Document Intelligence.
- Получите записи. Публичные релизы доступны по адресу war.gov/ufo.
- Попробуйте Aura. Запустите AuraDB и укажите в файле .env путь к ней.
- Создаете приложения на .NET? Читайте сопутствующую статью Хосе здесь.
Статья Agentic GraphRAG и обозреватель для вашего собственного стека была изначально опубликована на Neo4j Developer Blog в Medium, где продолжают следить за этой историей.