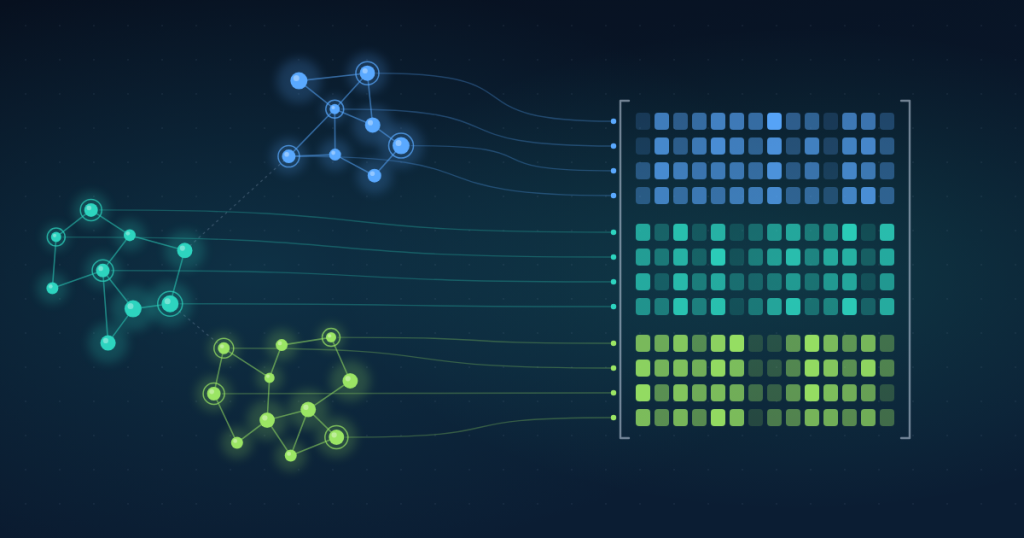
Отдельно взятая учетная запись сама по себе говорит о многом. Но посмотрите, кому она отправляет деньги, кому отправляют деньги те счета, и внезапно у вас появляется масса информации для работы.
В этом суть графовых векторных представлений: возьмите узел и все, что его окружает, и спрессуйте эту структуру графа в вектор. Узлы с похожим окружением в итоге получают похожие векторы. Вы также можете встретить название «векторные представления узлов» (node embeddings) — именно его мы используем в документации, так как каждый узел получает свой собственный вектор.
За последние несколько лет векторные представления стали самым быстрорастущим сценарием использования Neo4j Graph Data Science (GDS), нашей библиотеки для графовой аналитики и машинного обучения, и нас это не удивляет. Когда каждый узел становится вектором, множество сложных задач превращаются в простые:
- Команда по борьбе с мошенничеством может помечать учетные записи, похожие на известные профили мошенников.
- Ритейлер может рекомендовать товары на основе покупок похожих клиентов.
- Аналитик может сегментировать клиентов по тому, как они связаны со всеми остальными, а специалист по работе с данными может передать векторы в стандартную модель для прогнозирования оттока.
По мере того как все больше команд создают агенты ИИ на базе графов знаний, появляется еще один сценарий: текстовые представления подсказывают агенту, о чем идет речь, графовые представления показывают, как все связано, а поиск, использующий и то, и другое, может находить связанные сущности, которые один только текст упустил бы.
Раньше создание векторных представлений было задачей специалистов по работе с данными. Чтобы просто начать, вам сначала приходилось преодолевать целый холм концепций: какая модель подходит для моего графа, какая конфигурация соответствует моему сценарию, что вообще делает этот параметр? Множество команд проделали этот путь, пробуя модели и настраивая конфигурацию до тех пор, пока векторные представления не начинали выглядеть правильно. Это работает, но это слишком многое требует от вас, прежде чем вы увидите первый результат.
Сравните это с текстовыми представлениями. Вы делаете один вызов, получаете векторы обратно в несколько строк кода и никогда не задумываетесь о том, что происходит под капотом. Такая планка уже задана, и мы считаем, что графы заслуживают такого же подхода.
Одна строка, ничего не нужно настраивать
Сегодня мы рады выпустить в предварительной версии новый API векторных представлений (Embeddings API) в клиенте GDS Python (версия 2.2 или выше), созданный для Aura Graph Analytics:
Это и есть весь вызов.
G — это ваш граф, загруженный в сеанс Aura Graph Analytics (среда по требованию, в которой GDS работает в Aura), а create создает векторное представление для каждого узла в нем. Под капотом он запускает FastRP — быстрый и высокомасштабируемый алгоритм с настройками по умолчанию, которые мы выбрали за вас, чтобы вам не пришлось этого делать, и в большинстве случаев они работают отлично. Это означает, что вы можете начать работу, не зная, как работает алгоритм или как его настраивать, и потратить свое время на то, для чего предназначены векторные представления, а не на то, как их получить.
Если вам все же понадобятся тонкие настройки, они доступны. Вы можете задать размер векторного представления и другие параметры FastRP, указать имя свойства, в котором сохраняются векторные представления, встроить только определенные метки узлов или типы связей, а также зафиксировать random_seed для получения воспроизводимых результатов.
Что происходит с вашим графом
Векторные представления добавляются в ваш граф в оперативной памяти как новое свойство узла с именем embedding (если вы не выберете другое имя), при этом в вашу базу данных ничего не записывается. Начиная с этого момента векторы принадлежат вам: выгружайте их в pandas, передавайте другому алгоритму в том же сеансе (kNN для поиска похожих узлов, k-means для их кластеризации) или, если ваш сеанс привязан к базе данных, записывайте их обратно в нее.
Вот как это выглядит в контексте, начиная с самого графа (учетные записи и переводы между ними):
А вот тот же вызов с измененными настройками: размер векторного представления 256, другое имя свойства (поскольку стандартное свойство embedding уже существует в этом графе) и фиксированное начальное число (seed) для воспроизводимых результатов:
Метод create завершается ошибкой, если в графе уже есть свойство с тем же именем, поэтому существующие векторные представления никогда не будут перезаписаны случайно. Пока вы экспериментируете, давайте каждому набору векторных представлений собственное имя свойства, как в примере выше, чтобы вы могли их сравнить. В продакшене, в запланированных конвейерах или в ячейках ноутбуков, которые вы хотите перезапустить, сначала удалите свойство. С параметром fail_if_missing=False этот шаг безопасен: если свойство еще не существует, строка просто игнорируется.
Когда значений по умолчанию недостаточно
Конечно, универсальные настройки по умолчанию имеют свои пределы. Они фиксируют положение каждого узла в общей структуре графа, и это все, на что они смотрят: все, что хранится на ваших узлах, не играет никакой роли. Если ваши учетные записи содержат важные свойства или ваши аналитики уже классифицировали некоторые из них, вам понадобятся векторные представления, сформированные с учетом этих свойств.
Именно для этого предназначен метод gds.embedding.train. Он обучает модель GraphSAGE, которая обучается на свойствах узлов и на уже известных вам классах. Получив модель, передайте ее имя в create — и вы снова вернетесь к вызову в одну строчку.
В этом примере каждая учетная запись также имеет числовой класс риска risk_class и вектор признаков features, поэтому проекция переносит их с собой:
При наличии этих свойств в графе обучение занимает один вызов. Вы указываете на свойство, содержащее уже известные вам классы (target_label и target_property), свойства, на которых должна обучаться модель (feature_properties), и имя, под которым нужно сохранить модель:
За кулисами небольшой классификатор, обученный на ваших известных классах, обучает кодировщик тому, какие паттерны имеют значение. Если параметров по умолчанию недостаточно, вы можете настроить как кодировщик, так и классификатор, а также количество эпох и размер батча.
То, что вы сохраняете — это кодировщик. Передайте его имя в create, и каждый узел получит векторное представление, сформированное вашими классами и свойствами:
Одно предостережение при оценке результатов: модель уже видела ваши обучающие примеры, поэтому оценивайте ее на узлах, на которых она не обучалась.
Модель, обученная таким образом, является обычной моделью Aura Graph Analytics, как и любая другая, которую вы бы обучили в сеансе. Вы можете, например, сохранить ее с помощью gds.model.store, чтобы оставить в каталоге моделей вашего проекта, и тогда более поздний сеанс сможет использовать ее по имени.
Попробуйте сегодня
Aura Graph Analytics доступна на бесплатном уровне AuraDB Free, так что вы можете увидеть это в действии совершенно бесплатно. При этом ваши данные не обязательно должны храниться в Neo4j. Загрузите узлы и отношения из хранилища данных, Databricks или CSV-файла в DataFrame библиотеки pandas, и gds.graph.construct превратит их в граф в автономном сеансе.
В документации по Embeddings API вы найдете полное справочное руководство по параметрам и руководство по быстрому запуску на базе Cora, небольшого графа цитирования, поставляемого с нашим клиентом GDS Python, так что вы можете попробовать его перед загрузкой собственных данных.
Обе конечные точки находятся в предварительной версии, что означает, что они могут измениться по мере того, как мы будем учитывать ваш опыт их использования. API векторных представлений доступен только в Aura Graph Analytics с клиентом GDS Python версии 2.2 или выше.
Что дальше
Это первый шаг. Мы планируем и дальше расширять API, добавляя новые возможности для генерации векторных представлений и их практического использования после получения, а также перенести его в наш Cypher API, если Python — это не ваше.
Поскольку это предварительная версия, ваши отзывы определяют то, что появится в дальнейшем: расскажите нам, какие графы вы обрабатывали, что сработало хорошо и что бы вы хотели улучшить. Свяжитесь с нами на форуме сообщества Neo4j или по адресу [email protected].