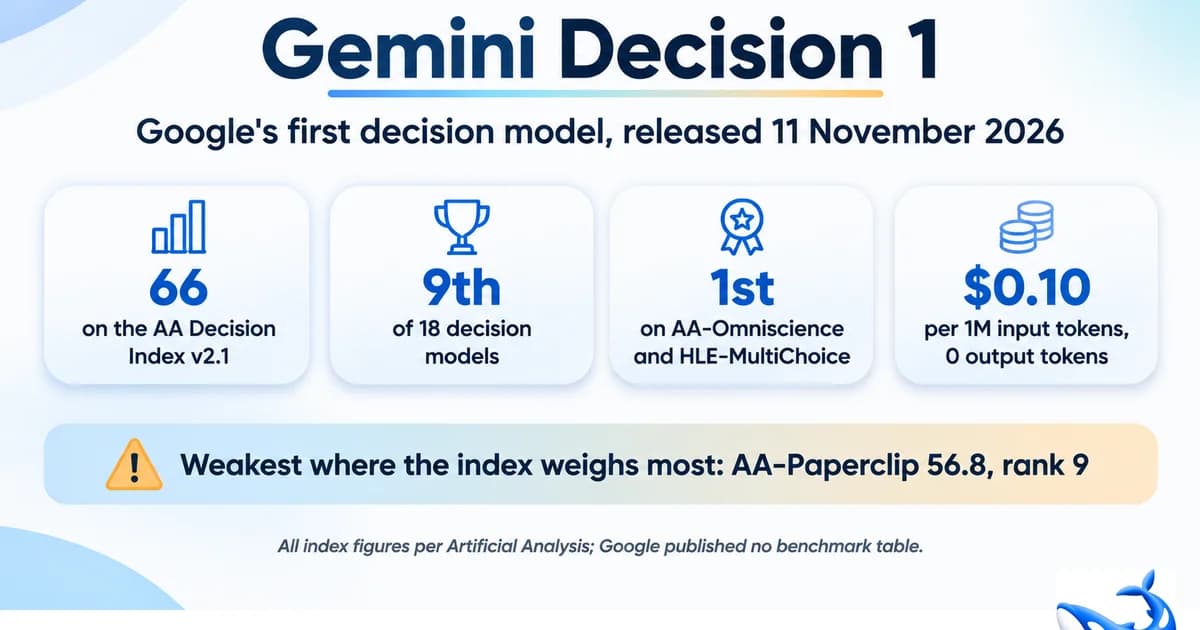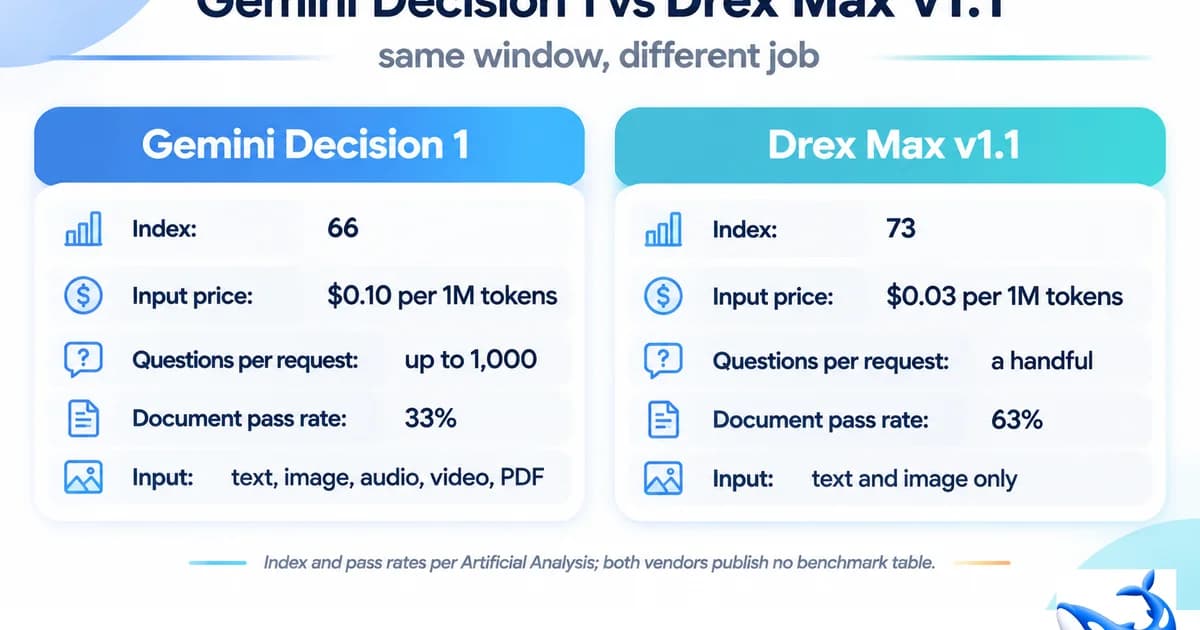
Если поставить Gemini Decision 1 и Drex Max v1.1 рядом, их технические характеристики почти совпадают: обе модели принятия решений, у обеих окно в 262 144 токена, обе работают с изображениями наравне с текстом и обе возвращают вероятности вместо обычного текста. Расхождение обнаруживается в одном месте. В компоненте оценки документов индекса принятия решений Artificial Analysis Decision Index v2.1 (тест с весом 30%, в котором от модели требуется извлечь пять решений и десять фактов из одного плотного документа и ответить правильно на все пятнадцать) Drex Max v1.1 успешно проходит 63% документов, а Gemini Decision 1 — 33%. Именно этот единственный компонент является основной причиной, почему у одной модели балл составляет 73, а у другой — 66.
Остальная разница сводится к арифметике, с которой можно работать. Drex Max v1.1 стоит 0,03 доллара за миллион входных токенов, а Gemini Decision 1 — 0,10 доллара; на миллион задач это 103 доллара против 345 долларов. При этом Gemini Decision 1 обрабатывает до 1000 вопросов за запрос при общем входе, в то время как Drex Max v1.1 ожидает одно состояние с небольшим набором вопросов. Какая именно цифра определит ваш выбор, зависит исключительно от того, поступают ли ваши решения по одному документу за раз или по сорок правил одновременно.
Две разные формы одной идеи
Обе модели отказываются генерировать текст, и обе обладают одним свойством, важным для моделирования затрат: входные данные считываются один раз, и по ним оценивается каждый вопрос. Расходятся они в том, что именно разрешено помещать в этот входной поток.
• Типы ответов — Drex Max v1.1 предлагает choice (выбор), noul и score (оценку), то есть формат запроса, который определил Jev из TypeSafe и который перенял Nace. Gemini Decision 1 предлагает те же три типа, но с возможностью задать от 2 до 255 вариантов для выбора и от 2 до 255 уровней по шкале (рекомендуется от 2 до 10).
• Вопросов на вызов — до 1000 для Gemini Decision 1, каждый из которых оценивается независимо за один проход по предоставленным вами ключам; для Drex Max v1.1 предусмотрено лишь несколько вопросов на состояние, где единицей работы выступает один элемент и связанные с ним вопросы.
• Модальность — Gemini Decision 1 принимает текст, изображения, видео, аудио и PDF; Drex Max v1.1 принимает текст и до восьми изображений на запрос. Ни одна из моделей не принимает медиафайлы внутри инструкций к вопросам; для Gemini Decision 1 это документированное ограничение, и в таком случае медиафайлы должны находиться в общих входных данных.
• Окно контекста — 262 144 токена для Gemini Decision 1 (суммарно для общего входа и всех вопросов); для Drex Max v1.1 заявлено 131 072 токена на один вопрос с учетом токенов изображений, а предельный размер упакованного запроса составляет 262 144 токена.
• Тарификация — Gemini Decision 1 взимает 0,10 доллара за миллион входных токенов и явно выставляет счета за повторное чтение общих входных данных в полном объеме, без кэширования контекста и без использования Batch API. Drex Max v1.1 стоит 0,03 доллара за миллион входных токенов — этот тариф Nace снизил вдвое, когда версия v1.1 пришла на смену v1.
• Доступ — Gemini Decision 1 доступна через Gemini Developer API на этапе v1beta, с бесплатным уровнем и неограниченным количеством ежедневных запросов, начиная со второго уровня (Tier 2). Drex Max v1.1 размещена на серверах Nace.AI по адресу POST /v1/systemone, скачиваемых контрольных точек нет.
Эту распаковку можно свести к одному предложению: Drex Max v1.1 создана для работы с экраном или страницей и парой суждений о них, а Gemini Decision 1 создана для большого контекста и объемного свода правил. Лимит в 1000 вопросов — это не просто красивый пункт в спецификации. Это разница между моделью, которую вы вызываете сорок раз за запрос, и той, которую вызываете единожды.
Откуда на самом деле берется разница в 6,6 балла
Индикатор решений (Decision Index) оценивает модель по шести параметрам, и обе модели прошли тесты по каждому из них. Сопоставление их компонентов дает больше информации, чем итоговый сводный балл:
• AA-Paperclip, 30% — Drex Max v1.1: 72,8, Gemini Decision 1: 56,8. Пятнадцать ответов на документ, по принципу «все или ничего». Именно этот шестнадцатибалльный разрыв определяет итоговое положение в рейтинге.
• EvalSafe-O*NET-AA, 15% — 88,3 против 87,1. Практически ничья.
• When2Call, 10% — 95,3 против 80,5. Drex Max v1.1 здесь занимает второе место на поле, в то время как Gemini Decision 1 — четырнадцатое из восемнадцати.
• AA-Omniscience-Decision v1.1, 15% — 60,3 против 66,3. Gemini Decision 1 выигрывает в этом тесте, а ее чистая точность в 44,8% является самой высокой среди всех моделей принятия решений в таблице.
• HLE-MultiChoice v1.1, 15% — 46,6 против 48,7. Близкие показатели, обе модели находятся в верхней части списка, обе демонстрируют однозначную чистую точность.
• AA-Symmetry v1.1, 15% — 79,8 против 70,5. Drex Max v1.1 сохраняет правильность ответов при изменении порядка и отрицании в 53,3% случаев; Gemini Decision 1 — в 38,3%.
Паттерн вполне устойчив. Drex Max v1.1 побеждает в двух компонентах, которые проверяют, является ли решение воспроизводимым и структурно надежным. Gemini Decision 1 побеждает в двух компонентах, проверяющих способность модели обладать знаниями и осознавать их отсутствие. Оба продукта имеют право на существование; они просто отвечают на разные вопросы о том, для чего предназначена модель принятия решений.
Одно предостережение касательно показателей Drex: стоимость в 103 доллара за миллион задач, о которой сообщает Artificial Analysis, отражает временную цену на момент запуска, а в сносках таблицы указано, что стандартная цена удвоит эти расходы. По прейскуранту Drex Max v1.1 обойдется примерно в 206 долларов за миллион задач — это все еще значительно ниже 345 долларов у Gemini Decision 1, но уже не в три раза дешевле. С задержкой дело обстоит иначе: 283 миллисекунды на задачу у Drex Max v1.1 против 211 у Gemini Decision 1, причем обе модели работают медленнее медианного значения по рынку, составляющего 209 миллисекунд.
Выбирайте по форме вашего запроса, а не по баллам
Выбирайте Drex Max v1.1, если ваше решение касается одного артефакта, а полученный ответ должен быть предельно надежным. Сюда относится триаж страховых претензий по сканам форм, управление агентами на основе скриншотов, где одно и то же кликовое решение запрашивается повторно после перерисовки интерфейса, или проверка контрактов, где инвертированный ответ «да/нет» является критической ошибкой. Процент успешной обработки документов в 63% и показатель симметрии в 53,3% полностью оправдывают себя в таких сценариях, а стоимость в 0,03 доллара за миллион входных токенов делает аргумент об объемах очевидным.
Выбирайте Gemini Decision 1, если ваше решение представляет собой свод правил, применяемых к единому источнику данных, или если входные данные не ограничиваются текстом и изображениями. Сорок проверок политик по одному тикету техподдержки за один вызов — это нагрузка, для которой Gemini Decision 1 и создавалась, в отличие от Drex Max v1.1. Кроме того, если в качестве входных данных выступает запись звонка или PDF-файл, прочитать их сможет только одна из этих двух моделей. В документации Google перечислен ряд неподдерживаемых возможностей наряду с поддерживаемыми, поэтому совместимость легко проверить перед началом работы: откалиброванные решения, все остальное отключено.
Пока не выбирайте ни ту, ни другую модель, если ключевым фактором является масштаб и стоимость. У Gemini Decision 1 нет ни Batch API, ни кэширования контекста, а это значит, что ночной обход миллиона архивных тикетов будет тарифицироваться по полной ставке с повторным чтением документа с правилами при каждом обращении. Начальные цены Drex Max v1.1 носят временный характер. Ни один из продуктов в настоящее время не предлагает структуру скидок, которая делала бы массовую обработку данных дешевой, и для любого, кто рассчитывает затраты на обработку тикетов за целый год, этот фактор окажется важнее шести пунктов индекса.
Использование обеих моделей без заключения второго контракта
OrcaRouter не поддерживает ни одну из этих моделей. Обе они работают исключительно как эндпоинты вероятностей, а не как цели для чат-комплишенов (chat-completions), о чем мы прямо заявляем, не вводя пользователей в заблуждение — модельным решением в каталоге указана сборка TypeSafe typesafe/jev-1.14, которая занимает 66,23 балла на той же доске между двумя рассматриваемыми здесь моделями.
Реальные затраты на тестирование различных моделей — это то, что никогда не попадает в бенчмарки: два SDK, две разные системы управления ключами и два набора лимитов запросов, с которыми приходится разбираться. Именно поэтому генеративная половина конвейера принятия решений должна находиться за маршрутизатором, даже если оценочная половина не может там находиться. Вызов, который создает кандидатный ответ, пишет критерии оценки или формирует резюме для последующей оценки — это как раз тот вызов, где вам захочется сменить вендора за одну послеполуденную сессию: одна точка входа, более 200 моделей, исходные прейскурантные цены провайдеров без наценки и автоматическое переключение при сбое на стороне провайдера. Направьте оценочный вызов напрямую в Google или Nace, а вызов для генерации текста оставьте переносимым. Модель, которую вы не можете маршрутизировать — это дешевая часть; модель, которую можете — это та, которую вам захочется сменить.
Если вы все же протестируете обе модели на собственной разметке — а вы должны это сделать, поскольку ни один вендор не публикует кривую калибровки для ваших данных — запустите их на одних и тех же 200 документах с одинаковым набором вопросов и сравните процент успешных прохождений, а не индекс. Разрыв в 30 пунктов у совета директоров на Paperclip — это сильный априорный показатель. Это не измерение ваших документов.