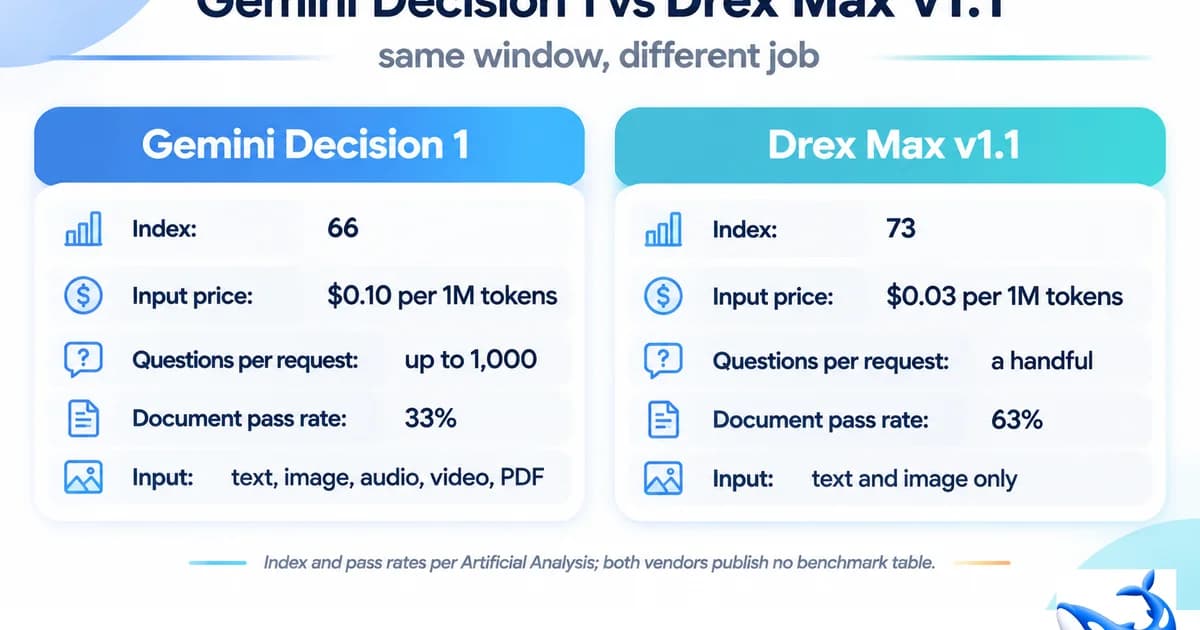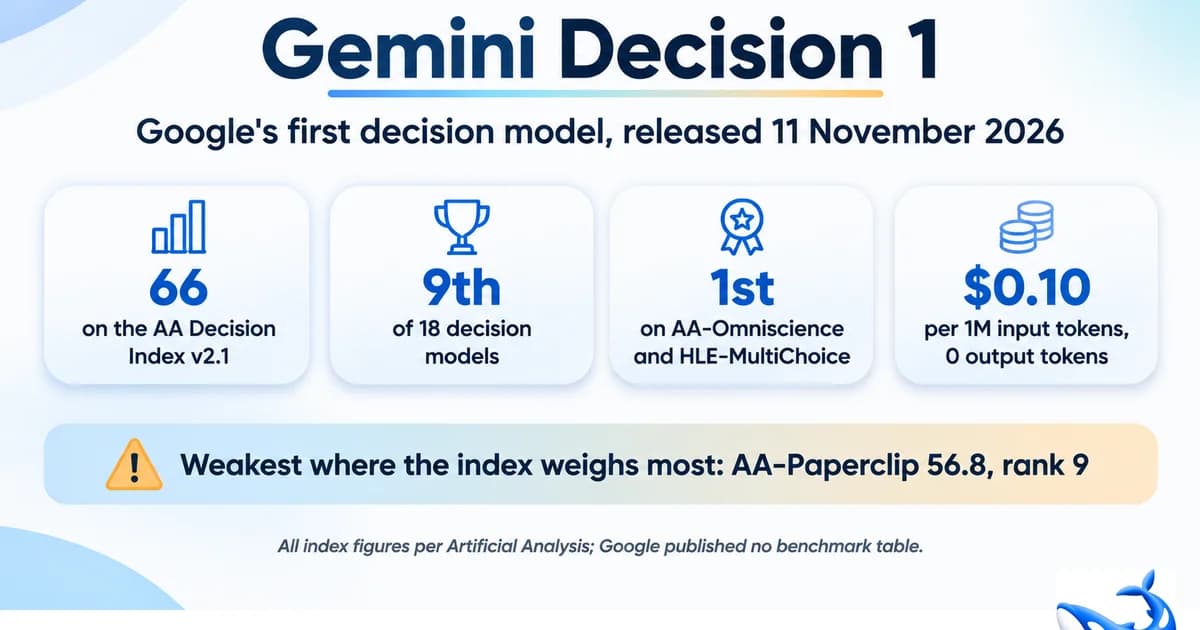
Шестьдесят шесть — это достойный балл и вводящий в заблуждение заголовок. Gemini Decision 1, которую Google выпустила 11 ноября 2026 года под новым интерфейсом Decisions API, набирает 66 баллов в Artificial Analysis Decision Index v2.1 — девятое место среди восемнадцати моделей принятия решений, ранжируемых советом, чуть выше медианы по рынку в 64 балла. Вторая часть заявления о релизе также верна: модель занимает первое место на индексных компонентах знаний и рассуждений. Оба утверждения выдерживают проверку, но кажутся противоречивыми по причине, которую стоит понять. Каждый из этих двух компонентов дает по 15% от общего балла. Компонент с весом 30% — это именно то место, где Gemini Decision 1 выглядит слабее всего на фоне конкурентов.
Это различие не является придиркой к арифметике таблиц лидеров. Оно говорит о том, для чего эта модель была создана, и это совсем не то, что большинство людей подумает при фразе «модель принятия решений от Google DeepMind».
Что Google выпустила на самом деле
Gemini Decision 1 не умеет писать тексты. Это не чат-модель с режимом JSON, и ее нельзя вызвать через обычный путь генерации контента (generate-content). Она работает на отдельном эндпоинте POST /v1beta/decisions, принимает один блок общего ввода плюс карту типизированных вопросов и возвращает один откалиброванный ответ на каждый вопрос с нулевым количеством выходных токенов. Каждый вопрос оценивается независимо по одним и тем же входным данным за один проход, а модель никогда не видит ключи ваших вопросов — только написанный вами текст инструкций.
Вся поверхность охватывается тремя типами вопросов:
• Да/нет (noul) — возвращает вероятность в диапазоне от 0.01 до 0.99 плюс оценку уверенности. Данное ограничение является намеренным, и это означает, что порог, установленный выше 0.99, никогда не сработает.
• Выбор (Choice) — от 2 до 255 именованных опций, возвращает лучший вариант, вероятность для каждого варианта в сумме дающую единицу, и уверенность. Перед оценкой API сортирует ключи ваших опций в алфавитном порядке по байтам UTF-8, поэтому порядок ключей в JSON ничего не меняет, а при точном равенстве предпочтение отдается первому в алфавитном порядке ключу. Именно поэтому в собственных рекомендациях Google советует называть универсальный вариант other, а не none_of_the_above, который сортируется раньше большинства реальных категорий, а не после них.
• Оценка (Score) — от 2 до 255 упорядоченных уровней рубрикатора, рекомендуется от двух до десяти, возвращает взвешенное по вероятности ожидаемое значение уровня. Поскольку ожидаемое значение вычисляет среднее по индексам массивов, шкала 1/10/100/1000 искажает его, о чем Google прямо заявляет в документации.
Остальная часть спецификации выглядит на редкость конкретно для страницы модели в день релиза:
• Ввод — текст, изображения, видео, аудио и PDF в одном запросе, с контекстом в 262 144 токена, охватывающим общие входные данные и все вопросы вместе.
• Масштаб — до 1000 вопросов за запрос, что и отличает данное решение от классификатора. Службу поддержки можно проверить по сорока правилам политики за один вызов, оплатив общие входные данные единожды.
• Мультимедиа — до 100 МБ встроенного base64 на запрос, 50 МБ для PDF, 15 МБ на внешний URL-адрес HTTPS. Никаких ссылок на YouTube и URI gs://; вы передаете ссылку на Files API, подписанный URL или байты.
• Тарификация — $0.10 за миллион входных токенов, выходные данные не тарифицируются. Нет кэширования контекста, нет Batch API, нет инференса Flex или Priority. Повторяющийся ввод в разных запросах каждый раз оплачивается полностью.
• Лимиты — бесплатный тариф на 200 запросов в минуту и 10 000 в день, уровень Tier 1 на 1500 запросов в минуту и 50 000 в день, а со второго уровня (Tier 2) и выше действуют неограниченные ежедневные запросы.
Две детали в этом списке имеют большее значение, чем кажется на первый взгляд. Бесплатный тариф предоставляется безвозмездно, но указано, что он используется для улучшения продуктов Google, что исключает его применение для любых конфиденциальных задач. Кроме того, модель доступна исключительно через Gemini Developer API в версии v1beta — в документации Google нет упоминания о ее наличии на платформе Vertex AI.
Арифметика числа 66
Индекс принятия решений не является таблицей точности. Это взвешенное среднее шести оценок, каждая из которых рассчитывается как точность за вычетом оценки Брайера для вероятности, которую модель присвоила своему ответу. Модель, которая отвечает неправильно, но заявляет об этом с низкой уверенностью, штрафуется меньше, чем та, которая отвечает неправильно и в этом уверена. Такой подход поощряет воздержание от ответов, и это самое важное, о чем нужно помнить при чтении любых цифр из этой таблицы.
Вот как Gemini Decision 1 располагается по каждому компоненту, с указанием места среди восемнадцати моделей:
• AA-Paperclip, вес 30% — 56.8, 9-е место. Это тест на принятие решений по документам: 1500 конфиденциальных резюме, чеков, счетов и документов, каждый из которых содержит пять решений и десять фактов; документ считается сданным только тогда, когда все пятнадцать ответов верны. Gemini Decision 1 полностью справляется с 33% документов. Drex Max v1.1 проходит 63%.
• EvalSafe-O*NET-AA, 15% — 87.1, 8-е место. Оценка документов на рабочем месте. Это сильный результат, и это компонент, в котором все модели сгруппированы наиболее плотно.
• When2Call, 10% — 80.5, 14-е место. Оценка вызова инструментов от NVIDIA и худший результат среди шести компонентов. Drex Max v1.1 набирает здесь 95.3 балла.
• AA-Omniscience-Decision v1.1, 15% — 66.3, 1-е место. Знания и галлюцинации, где вариант «Я не знаю» сформулирован десятью разными способами.
• HLE-MultiChoice v1.1, 15% — 48.7, 1-е место. Последний экзамен человечества (Humanity's Last Exam), с множественным выбором и возможностью отказаться от ответа.
• AA-Symmetry v1.1, 15% — 70.5, 9-е место. Проверка того, сохраняется ли ответ при изменении порядка вопросов, переименовании и отрицании. Gemini Decision 1 сохраняет свой ответ на 38.3% семейств вопросов; Mammoth 27B удерживает 88.2 на том же инструменте.
Взвесив эти показатели, мы получаем 65.98. Первый и четвертый ряды выполняют основную работу в противоположных направлениях, и причина здесь структурная: Paperclip весит вдвое больше любого из тестов на знания, и это оценка, которая требует от модели правильного и одновременного считывания пятнадцати фактов из одного документа.
Два первых места являются реальными, но более узкими, чем кажутся
Первое место в AA-Omniscience-Decision — это реальный результат. Gemini Decision 1 набирает 66.3 балла против 64.4 у d1-ultra и 60.9 у GLiDE v1.2, а ее абсолютная точность в 44.8% является наивысшей среди восемнадцати моделей принятия решений в этом тесте. В HLE-MultiChoice она снова на первом месте с результатом 48.7, опережая Mammoth 27B и d1-ultra с 47.4 баллами. Именно это имеется в виду под «лидерством в знаниях и рассуждениях», и данное утверждение справедливо.
То, о чем умалчивает это заявление — абсолютный уровень. Gemini Decision 1 дает правильные ответы на 13.2% вопросов из «Последнего экзамена человечества». Причина, по которой она все еще возглавляет этот компонент, заключается в том, что она предпочитает воздерживаться от ответа, а не угадывать: уровень отсутствия галлюцинаций в том же тесте составляет 35.7%, а формула подсчета баллов вознаграждает низковероятностный ответ, который оказывается неверным. Быть лидером по калибровке — не то же самое, что быть лидером по знаниям, и 13% точности — это та цифра, которую следует учитывать при планировании ресурсов.
Google не опубликовала собственной таблицы бенчмарков для этой модели — в примечаниях к релизу объявляются сама модель и API, а в документации объясняются формат запросов и ограничения. Все показатели производительности выше получены Artificial Analysis, измерены на собственной тестовой платформе оценщиков, и не существует никаких цифр от вендора, которые могли бы им противоречить. Это выглядит прозрачнее большинства запусков и заслуживает прямого упоминания, поскольку альтернатива в виде таблицы от вендора без сторонней проверки — обычное дело в этой категории.
Что дает эта цена и чего она не дает
При стоимости 345 долларов за миллион задач по индексу Gemini Decision 1 является самой дорогой моделью в верхней половине таблицы. Drex Max v1.1 обрабатывает тот же миллион задач за 103 доллара, Jev 1.14 — за 156 долларов, Microsoft-Decision-1 — за 143 доллара. Это объясняется стоимостью входящих токенов: 0,10 доллара за миллион токенов против 0,03 доллара у Drex Max v1.1, а задача принятия решений предполагает чтение длинного документа без генерации единого токена, который мог бы компенсировать затраты. Artificial Analysis ставит ее на пятнадцатое место из восемнадцати по стоимости и отмечает, что она «особенно дорога».
Задержка ничем не примечательна. При показателе 211 миллисекунд на задачу она чуть медленнее медианы по рынку в 209 миллисекунд и медленнее Jev 1.14 с ее 92 миллисекундами. Для задачи маршрутизации на основе сообщения клиента это нормально. Для циклической обработки живого видео по кадрам, что в документации прямо указано как вариант использования, это скорее довод в пользу выбора меньшей модели, чем против данной.
Пробелы в возможностях — это то, что на странице цен указано как недоступное, а не то, что может показать бенчмарк: отсутствие Batch API означает отсутствие ночной полуторакратной проверки миллиона исторических обращений, а отсутствие кэширования контекста означает, что один и тот же документ с политикой на 40 000 токенов оплачивается заново при каждом запросе. Если ваш конвейер принятия решений в больших объемах повторно считывает общий большой контекст, эти два упущения обходятся дороже, чем следует из базовой ставки, и ни то, ни другое не входит в опубликованную Google дорожную карту.
К чему это подходит, если вы уже занимаетесь маршрутизацией моделей
OrcaRouter не поддерживает gemini-decision-1. Эндпоинт, работающий только с вероятностями, не является целью для chat-completions, поэтому роутер нашего типа не может запрятать его за один ключ — а утверждения обратного были бы из разряда тех заявлений о доступности, которые отлично смотрятся на бумаге и рушатся при первом же запросе. Что мы действительно поддерживаем, так это typesafe/jev-1.14 от TypeSafe — модель принятия решений в той же таблице из 18 моделей с результатом 66,23, так что половина конвейера, отвечающая за оценку, может располагаться на том же ключе, что и половина, отвечающая за генерацию текста, если именно эта модель принятия решений вам подходит.
Половина, отвечающая за генерацию текста — это то, для чего мы на самом деле созданы. Конвейер принятия решений почти всегда состоит из двух вызовов: нечто создает проект ответа или критерии оценки, а нечто оценивает это. Вызов для генерации текста — это как раз то место, где выбор модели вызывает споры и где второй контракт с вендором бьет по карману, и именно этот вызов обрабатывается через один эндпоинт, содержащий более 200 моделей по ценам провайдера с передачей по списку и с 0% наценкой, благодаря чему изменение цены вендора вступает в силу на нашей стороне в тот же день. Направить вызов генерации через нас, а вызов оценки направить на собственный эндпоинт Google — это изменение в две строки кода, а не переработка архитектуры.
Что может изменить эту оценку
Три вещи в порядке убывания вероятности. Ревизия, которая поднимет показатель успешности AA-Paperclip по принципу «все или ничего» с 33%, продвинет композитный результат сильнее, чем что-либо еще, на что способна эта модель, поскольку этот единственный компонент составляет 30% от общей оценки и отставание от лидера в шестнадцать пунктов. Размещение на Vertex AI полностью изменило бы характер обсуждения закупок — на сегодняшний день единственный способ обратиться к ней — это ключ Gemini API, и корпорации, покупающие услуги по контрактам Google Cloud, обратят на это внимание. И вторая независимая комиссия, воспроизводящая результат 66, превратила бы цифру от одной компании в консенсусную.
До тех пор, пока не произошло ничего из этого, точное описание Gemini Decision 1 является узкоспециализированным и полезным: это мультимодальный оценщик на 262 000 токенов и 1000 вопросов, который является лучшей откалиброванной моделью принятия решений в таблице в тех двух областях, где умение вовремя промолчать является проверяемым навыком, и середнячком там, где задача сводится к чтению плотного документа и выдаче пятнадцати правильных ответов одновременно. Если ваши решения похожи на первый тип, оценка 66 занижает ее возможности. Если они похожи на второй, никакое лидерство в бенчмарках знаний не спасет показатель успешности.