JetBrains Research
Исследования имеют решающее значение для прогресса и инноваций, поэтому в JetBrains мы с увлечением занимаемся как научными, так и рыночными исследованиями.
Исследования
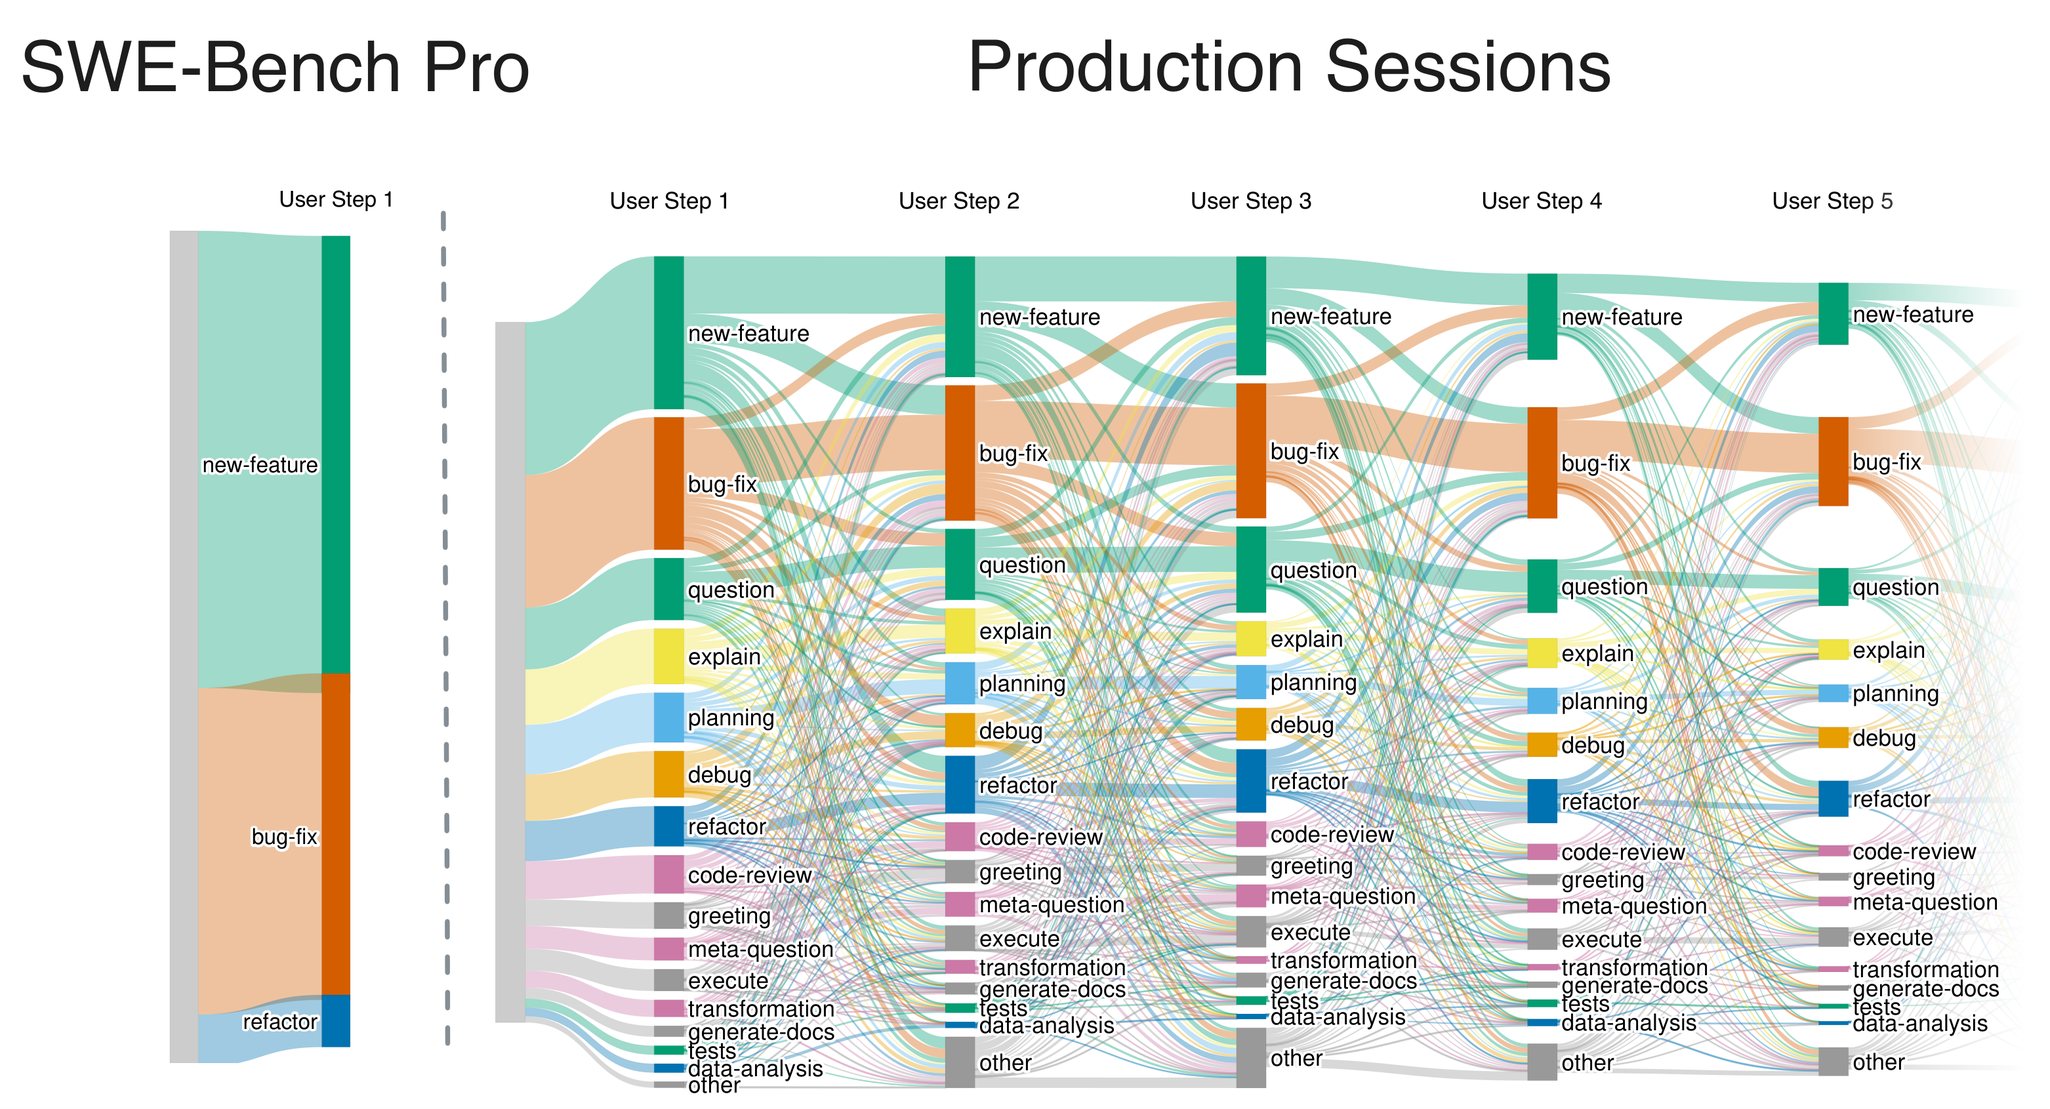
Слева: SWE-Bench Pro, где каждая задача представляет собой одно сообщение пользователя — почти всегда это новая функция или исправление ошибок. Справа: первые пять сообщений разработчиков в сессиях инженеров-программистов, работающих в IDE JetBrains (учитываются только сессии с как минимум тремя сообщениями). Каждый столбец соответствует позиции сообщения, цветные блоки обозначают типы запросов, а ширина полос показывает частоту перехода от одного типа к другому.
В этой статье подводится итог нашей работы Opinion: Coding-Agent Benchmarks Should Match Their Users’ Task Flows, принятой на симпозиум Evaluation of Interactive Agents workshop на NeurIPS 2026.
В этой статье подводится итог нашей работы , принятой на симпозиум Evaluation of Interactive Agents на .
В JetBrains Research мы недавно проанализировали 4782 агентские сессии инженеров-программистов, работающих в IDE JetBrains, и сравнили их с тремя публичными наборами диалогов с агентами. В рассмотренных нами сессиях разработчиков исправление ошибок и добавление функций составляют менее половины того, что разработчики просят сделать агента для написания кода. Остальное включает вопросы о кодовой базе, планирование, код-ревью, рефакторинг и выполнение команд. С другой стороны, в SWE-Bench Pro 93,8% задач — это функции и исправление ошибок, причем каждая задача поступает в виде одного полного сообщения. Такая вот разница.
Этот разрыв и стал предметом данной статьи. Наш вывод по результатам анализа заключается в том, что не существует универсального реалистичного бенчмарка для агентов написания кода: бенчмарк должен быть откалиброван по измерениям для конкретной пользовательской аудитории. SWE-TaskFlow — это наш вклад в решение этой задачи для любого бенчмарка на основе задач (issue-derived); в этой статье мы применяем его к SWE-Bench Pro.
Что измеряет бенчмарк на основе задач
SWE-bench и ее последователи (SWE-Bench Pro, SWE-rebench, DeepSWE) формируют задачи на основе тикетов GitHub. Агент получает чеккаут репозитория и текст тикета, исследует код, редактирует его и отправляет патч. Тесты определяют, решает ли патч проблему; доля решенных проблем — это коэффициент решения (resolve rate).
Инфраструктуру, лежащую в основе таких задач, дорого создавать: например, репозиторий в нужном коммите, окружение, где код запускается, и тесты, проверяющие изменения. Однако уровень взаимодействия поверх этого фиксирован. Полная спецификация поступает в одном выверенном сообщении, после чего оценивается один финальный патч.
Несмотря на фиксированный характер уровня взаимодействия, разработчики в IDE работают далеко не всегда именно так. Иными словами, половина увиденных нами сессий состоит из одного сообщения. В остальных требования поступают частями: между запросом на одно изменение и следующим разработчик просит агента объяснить, как работает та или иная часть проекта, спланировать следующее изменение или проверить сделанное, в то время как более ранние требования все еще должны учитываться.
Как разработчики на самом деле используют агента
Каждая из 4782 сессий, которые мы называем производственными сессиями (Production Sessions), представляет собой один диалог между разработчиком и агентом для написания кода внутри IDE; в совокупности они содержат около 14 000 сообщений разработчиков. Мы рассматривали только сторону разработчика, а на рисунке ниже показано распределение сообщений по производственным сессиям.
4782 сессии по количеству сообщений разработчиков (на графике они названы промптами). Одно сообщение разработчика может вызывать множество действий агента.
Half of the sessions (50.9%) are a single message; about 15% run past five. Since our subject is interactive agents, the rest of the analysis is on the 33% of sessions with at least three developer messages, the long sessions, as follows.
Языковая модель с открытыми весами (Gemma 4-31B) пометила каждое сообщение одним из 16 типов запросов или намерений: исправление ошибки, новая функция, объяснение, планирование, код-ревью, выполнение и так далее (все 16 определены в статье). Тот же классификатор с тем же промптом разметил публичные коллекции и задачи SWE-Bench Pro, поэтому каждое распределение в этой статье измерено на одинаковых условиях.
Во всех сессиях исправление ошибок составляет 26% размеченных сообщений, а новые функции — 19%. В длинных сессиях объяснения собственного кода проекта составляют 6% сообщений, а общие вопросы по программированию — еще 10%; планирование, код-ревью, рефакторинг, отладка и выполнение составляют большую часть остального. SWE-Bench Pro, размеченный тем же способом, состоит из 55% новых функций, 39% исправлений ошибок, 6% рефакторинга и ничего более.
Длина сессии и набор намерений — это два из трех компонентов рабочего процесса (Task Flow); третий — это порядок, в котором намерения следуют друг за другом. Сессия, которая начинается с запроса функции, часто продолжается вопросом о существующем поведении, этапом планирования и запросом на ревью.
Как соотносятся публичные коллекции
Наши производственные сессии относятся к одной пользовательской аудитории. Чтобы увидеть, насколько картина зависит от аудитории, мы запустили классификатор на 1000 сессиях из каждой из публичных коллекций, приведенных ниже, и оставили длинные сессии. Ниже мы приводим диаграммы Санкея для каждой из них. Диаграммы Санкея в этой статье представляют собой рабочие процессы (Task Flows), где каждый столбец — это позиция сообщения, а полосы между столбцами — эти переходы.
SpecStory состоит из публичных экспортов сессий IDE, данные из которых анализировались в Programming by Chat. 521 из 1000 сессий являются длинными. Из трех она ближе всего к нашим сессиям, но имеет большую долю планирования.
DataClaw содержит сессии агентов для написания кода, которыми поделилось сообщество. 585 из 1000 — длинные. В ней преобладают запросы на выполнение и короткие операционные сообщения.
SWE-chat представляет собой коллекцию диалогов с агентами для написания кода от реальных пользователей, собранную в режиме чата. 698 из 1000 — длинные. Выполнение и планирование являются ее самыми крупными намерениями.
Эти три корпуса получены из разных продуктов, от разных пользователей и с помощью разных методов сбора, поэтому мы не сравниваем их количественно. Тем не менее, бенчмарк, откалиброванный под любой из них, будет иметь иной набор задач и переходов, чем бенчмарк, откалиброванный под другой. Ни один из них не является эталонной истиной, как и наши производственные сессии; целевой объект должен быть выбран и четко обозначен.
Для нашего пилотного проекта целью являются длинные производственные сессии. Калибровка по частотам имеет побочный эффект: все редкое в целевом объекте стремится к нулю. Редкие, но важные действия, такие как деструктивная команда оболочки или проверка безопасности, напротив, должны оцениваться в отдельных срезах стресс-тестирования с собственным количеством задач.
Как SWE-TaskFlow адаптирует существующие задачи
Создание нового интерактивного бенчмарка для каждой цели свело бы на нет то, что уже имеют бенчмарки на основе тикетов. Вместо этого мы предлагаем SWE-TaskFlow, который преобразует существующий бенчмарк: он сохраняет репозиторий, окружение, тесты и исходные требования, пересоздавая только сообщения пользователя.
Разбиение тикета на несколько запросов
Большая языковая модель (LLM) переписывает каждое обращение в виде трех упорядоченных запросов; мы называем их запросами к проблеме, поскольку все в них взято из исходной проблемы. Агент работает над первым, прежде чем увидеть второй. Разделение должно сохранить все исходные требования и не добавлять новых; идентификаторы и фрагменты кода остаются без изменений; каждый запрос должен быть выполнимым в том состоянии репозитория, которое осталось после предыдущего. Проход второй модели проверяет результат на полноту. 31 из 731 публичного обращения SWE-Bench Pro не прошли эти проверки разделения и оценки и были исключены, в результате чего осталось 700 задач.
Вот как это выглядит для проблемы в qutebrowser под названием «LinkedIn не работает из-за отсутствия поддержки Array.prototype.at в старых версиях QtWebEngine». Исходная проблема представляет собой одно сообщение длиной около 1000 символов. После разделения оно превращается в следующее:
- Пожалуйста, исправьте проблему совместимости с LinkedIn в qutebrowser на macOS с QtWebEngine 5.15.2. Интерфейсный JavaScript LinkedIn использует Array.prototype.at, который отсутствует в этом старом движке, поэтому выполнение JavaScript завершается ошибкой, а страницы LinkedIn зависают или не реагируют. Добавьте поддержку совместимости с JavaScript в qutebrowser, необходимую для нормальной загрузки и работы LinkedIn, используя полифил для прозрачного решения проблемы.
- Поддержка совместимости должна предоставлять Array.prototype.at в версиях QtWebEngine до 6.3, когда он недоступен нативно, и она должна быть активна и функционировать на страницах домена LinkedIn и тестовых доменах qutebrowser. Для экземпляров массивов положительные целочисленные индексы должны возвращать элемент по указанному индексу, в то время как отрицательные индексы отсчитываются с конца, причем -1 относится к последнему элементу.
- Завершите реализацию поведения так, чтобы индексы за пределами границ массива возвращали undefined как для положительных, так и для отрицательных индексов. Полифил должен внедряться только тогда, когда нативный метод Array.prototype.at еще не доступен в среде JavaScript.
Первого запроса достаточно для начала работы; граничные случаи поступают позже.
Добавление вопросов о репозитории
Объяснения собственного кода проекта являются обычным делом в производственных сессиях и отсутствуют в бенчмарках проблем, поэтому мы генерируем их. Модель считывает репозиторий вместе с траекторией агента, который ранее решил проблему, и предлагает от одного до трех вопросов. Каждый вопрос должен допускать ответ только на основе репозитория, оставаться действительным как до, так и после исправления и не раскрывать решение.
Каждый вопрос поставляется с эталонным ответом и исполняемым скриптом проверки, который собирает доказательства для ответа из репозитория. При создании набора данных мы запускаем скрипт в чистой рабочей копии и сохраняем вопрос только в том случае, если он проходит проверку, предоставляет доказательства и оставляет репозиторий неизменным. Это конструктивно исключает вопросы, ответы на которые невозможно наблюдать в коде («почему это было спроектировано именно так?»). Во время оценки агент отвечает текстом, а отдельная LLM оценивает ответ по сравнению со скрытым эталоном и его доказательствами.
В выпущенной конфигурации упомянутая выше задача qutebrowser получает один вопрос, размещенный между первым и вторым запросами к проблеме:
Краткий ответ: проследите, как соответствующее изменение конфигурации таблиц стилей обновляет как будущие документы QtWebEngine, так и уже загруженный документ, включая сборку CSS, замену скриптов, среду выполнения, поведение подфреймов и путь бездействия для несвязанных опций.
. Эталонный ответ называет две конфигурационные опции, запускающие этот путь, и проходит по пяти файлам. Скрипт проверки выполняет изменение конфигурации таблицы стилей для реального кода, проверяет результирующую регистрацию скрипта и вызов живой страницы, а также подтверждает, что несвязанная опция ничего не делает. Вопрос не связан с Array.prototype.at: он взят из кода, который агент решения прочитал по ходу дела, а не из самого исправления.
. Выбор последовательностей, соответствующих цели
. Вопросы могут размещаться до, между или после запросов к проблеме, поэтому каждая задача имеет несколько вариантов последовательностей. Мы выбираем по одному на задачу так, чтобы бенчмарк в целом напоминал длинные производственные сессии, измеряемые с помощью оценки соответствия потоку задач (TFAS). TFAS сравнивает три распределения (длину сессий, намерения, переходы) между целью и бенчмарком с помощью дивергенции Дженсена — Шеннона и объединяет их в оценку от 0 до 100. Простое разделение получает 59,6 балла по сравнению с нашей целью. Добавление вопросов на фиксированных позициях повышает ее до 75,6–77,1; предоставление оптимизатору возможности выбирать, сколько вопросов сохраняет каждая задача и где они размещаются, повышает ее до 77,8. Результатом являются 454 вопроса в 255 из 700 задач (113 задач с одним вопросом, 85 с двумя, 57 с тремя), причем 67 задач содержат вопросы только до запросов к проблеме, 86 только после и 102 перемежаются. Остальные 445 задач сохраняют свои три запроса к проблеме.
. Поток задач SWE-Bench Pro (слева) и выборки, оптимизированной по TFAS, с TFAS 77.8 (справа). Одна пользовательская подсказка на проблему превращается в сумму до шести последовательных подсказок разных типов. Репозитории, запрошенные изменения и финальные тесты остаются неизменными.
. На правой панели запросы к проблеме несут те типы задач, которые уже были в проблемах: исправление ошибок, новая функция и некоторое рефакторинг — те же три, которые составляют весь SWE-Bench Pro слева. Меньшие намерения также проявляются после разделения проблемы: отладка, преобразование, тесты, планирование и некоторые другие. Это не дополнения, а части исходной проблемы, которые классификатор объединил в доминирующее намерение, когда видел проблему как одно сообщение (например, проблема с исправлением ошибки, которая также требует регрессионного теста), и которые стали видны как отдельные сообщения после разделения. Единственное намерение, которое приходит извне проблемы, — это «объяснение», переносимое вопросами репозитория.
. Пилотные результаты: четыре модели, три настройки
. Для оценки SWE-TaskFlow мы запустили GPT-5.6 Luna, GPT-5.6 Terra, GPT-5.4 Mini и Gemini 3.7 Flash через mini-swe-agent на тех же 700 задачах, по три запуска на настройку:
- . Одиночный: исходная проблема в одном сообщении.
- . Разделенный: три запроса, поступающие один за другим в рамках одного разговора.
- . Разделенный+QA: выбранные с помощью TFAS последовательности с вопросами по репозиторию.
. Средние значения по трем запускам; усы обозначают наблюдаемые мин.–макс. Цвета — модели, формы — настройки.
. Разделение проблемы на три сообщения сделало каждую модель в 2,0–2,6 раза дороже на каждую задачу. Поскольку репозиторий, тесты и требования не изменились, дополнительные затраты измеряют, сколько дополнительных усилий тратит агент, когда требования поступают частями. Коэффициенты решения изменились меньше: GPT-5.6 Terra остался на прежнем уровне, остальные три упали в среднем на 4–5 пунктов, что сопоставимо с разбросом между отдельными запусками одной и той же настройки. При трех запусках на настройку эти результаты не ранжируют модели; они показывают, что прогрессивное раскрытие надежно меняет затрачиваемые усилия и лишь слабо влияет на результат.
Сама переработка с помощью LLM, а не разделение на последовательности, также могла усложнить задачи. Контрольное условие Concat выдает те же три переработанные части, вставленные в одно сообщение. Для трех моделей GPT при одном запуске этот вариант оказывается близким к Single как по стоимости, так и по проценту успешного решения, поэтому дополнительные затраты Split обусловлены именно последовательной доставкой, а не переформулировкой.
Добавление вопросов по репозиторию увеличивает стоимость еще на 4%–24% поверх Split, в зависимости от модели. На 255 задачах, содержащих вопросы, доля ответов, которые судья оценивает как правильные (точность ответов), варьируется от 69.8% (GPT-5.4 Mini) до 83.0% (GPT-5.6 Terra).
Закрашенные кружки: точность ответов. Незакрашенные кружки: процент успешного решения на тех же 255 задачах, из-за чего эти значения успешности отличаются от графика выше.
Разделенная траектория также допускает промежуточную верификацию. После каждого запроса проблемы мы можем делать снимок репозитория и перезапускать тесты, выставляя оценки только на основе требований, раскрытых на данный момент. В тесте из 64 задач на абляцию как процент успешного решения, так и процент прохождения тестов растут с каждым новым обращением с проблемой, а положение вопросов не меняет ход кривых. Вместо одной итоговой оценки получается несколько верифицированных контрольных точек. Это полезно для диагностики и потенциально для обучения; последнее мы еще не пробовали.
Что SWE-TaskFlow пока не охватывает
В настоящее время SWE-TaskFlow генерирует сообщения двух типов: запросы проблем и вопросы по репозиторию. Все остальное в структуре потока задач (Task Flow) реальных сессий (общие вопросы по программированию, планирование, ревью кода, рефакторинг, выходящий за рамки того, что уже содержится в проблемах, выполнение, отладка без исправления) по-прежнему требует собственного генератора и верификатора, причем для большинства из них неясно, как автоматически проверять ответ. Измеренный поток задач по крайней мере подсказывает нам, каких дополнений не хватает и в какой пропорции.
Кроме того, все сообщения фиксируются перед запуском. Это обеспечивает точную воспроизводимость и парные сравнения, а также позволяет измерять прогрессивное раскрытие информации, память и адаптацию, но не то, как агент справляется с обратной связью: «пользователь» не может отреагировать на действия агента. Реактивные бенчмарки с симулированными пользователями охватывают это, но ценой вариативности траекторий; полноценный набор тестов должен объединять откалиброванное статическое ядро с целевыми реактивными срезами. Помимо этого, классификатор не имеет набора данных с точностью, размеченной людьми; некоторые проблемы невозможно разделить, сложность вопросов зависит от написавшей их модели, а пилотный запуск включает три прогона для каждой конфигурации.
Датасет SWE-TaskFlow-SWE-Bench-Pro на Hugging Face содержит 12 конфигураций в виде отдельных частей: оригинальные промпты, разделенные промпты, варианты Split+QA и сессии только с QA. Каждый вопрос поставляется с эталонным ответом и скриптом проверки. Репозитории, эталонные патчи (gold patches) и тесты остаются из оригинального релиза SWE-Bench Pro.