За свою карьеру до Amplitude я запускал кампании в качестве маркетингового аналитика, работал продуктовым аналитиком, а затем стал директором по работе с данными. На каждой должности я отвечал за нашу реализацию. Я многое узнал о правильных и неправильных способах настройки архитектуры продуктовой аналитики.
Некоторые из лучших уроков дались тяжело. Спустя месяцы после запуска кто-то из моей команды задавал вопрос, и я обнаруживал, что данные не могут на него ответить. Иногда было еще хуже: данные могли ответить, но они были неверными.
Во всех этих ошибках были и хорошие новости. У меня вошло в привычку разбирать поток данных, чтобы точно диагностировать, где именно все пошло не так, и выдвигать гипотезы о том, как я мог предотвратить эти ошибки на более ранних этапах процесса, до того как они превратились в срочную задачу по валидации данных. Эта публикация — возможность для меня систематизировать эти уроки, чтобы другим командам не пришлось проходить через те же трудности.
Эти шаги важны как никогда, потому что ИИ — это система, которая зависит от качества данных. Что вы получаете на выходе, зависит от того, что вы вкладываете, а ваши агенты анализа не знают того, чего не знают. Агент с частичными данными уверенно выдаст вам неверный ответ, точно так же, как персональный чат-бот с радостью спланирует ваш день вокруг несуществующего киносеанса.
В Amplitude мы верим, что продуктовый опыт должен улучшаться сам по себе. Это означает, что поведенческие данные должны собираться в реальном времени, дополняться дополнительным контекстом из хранилища, активироваться для пользователей в ходе живых сессий и измеряться для принятия лучших решений с течением времени. Это сложная задача, но современные технологии могут заставить ее работать.
В этом блоге я пройду по списку из шести решений для архитектуры данных, которые необходимо принять, чтобы сделать эти улучшенные продуктовые циклы возможными.
Самое частое возражение клиентов против нашего SDK звучит примерно так: «У нас есть собственный пайплайн, а данные в нашем хранилище хорошо упорядочены. Зачем устанавливать еще один SDK?» Шин КилКаллен ответил на этот вопрос в статье Should I install the Amplitude SDK?, но краткий ответ заключается в том, что данные SDK поступают в реальном времени и качественно отличаются от данных хранилища, поэтому у вас больше гибкости при ответе на вопросы.
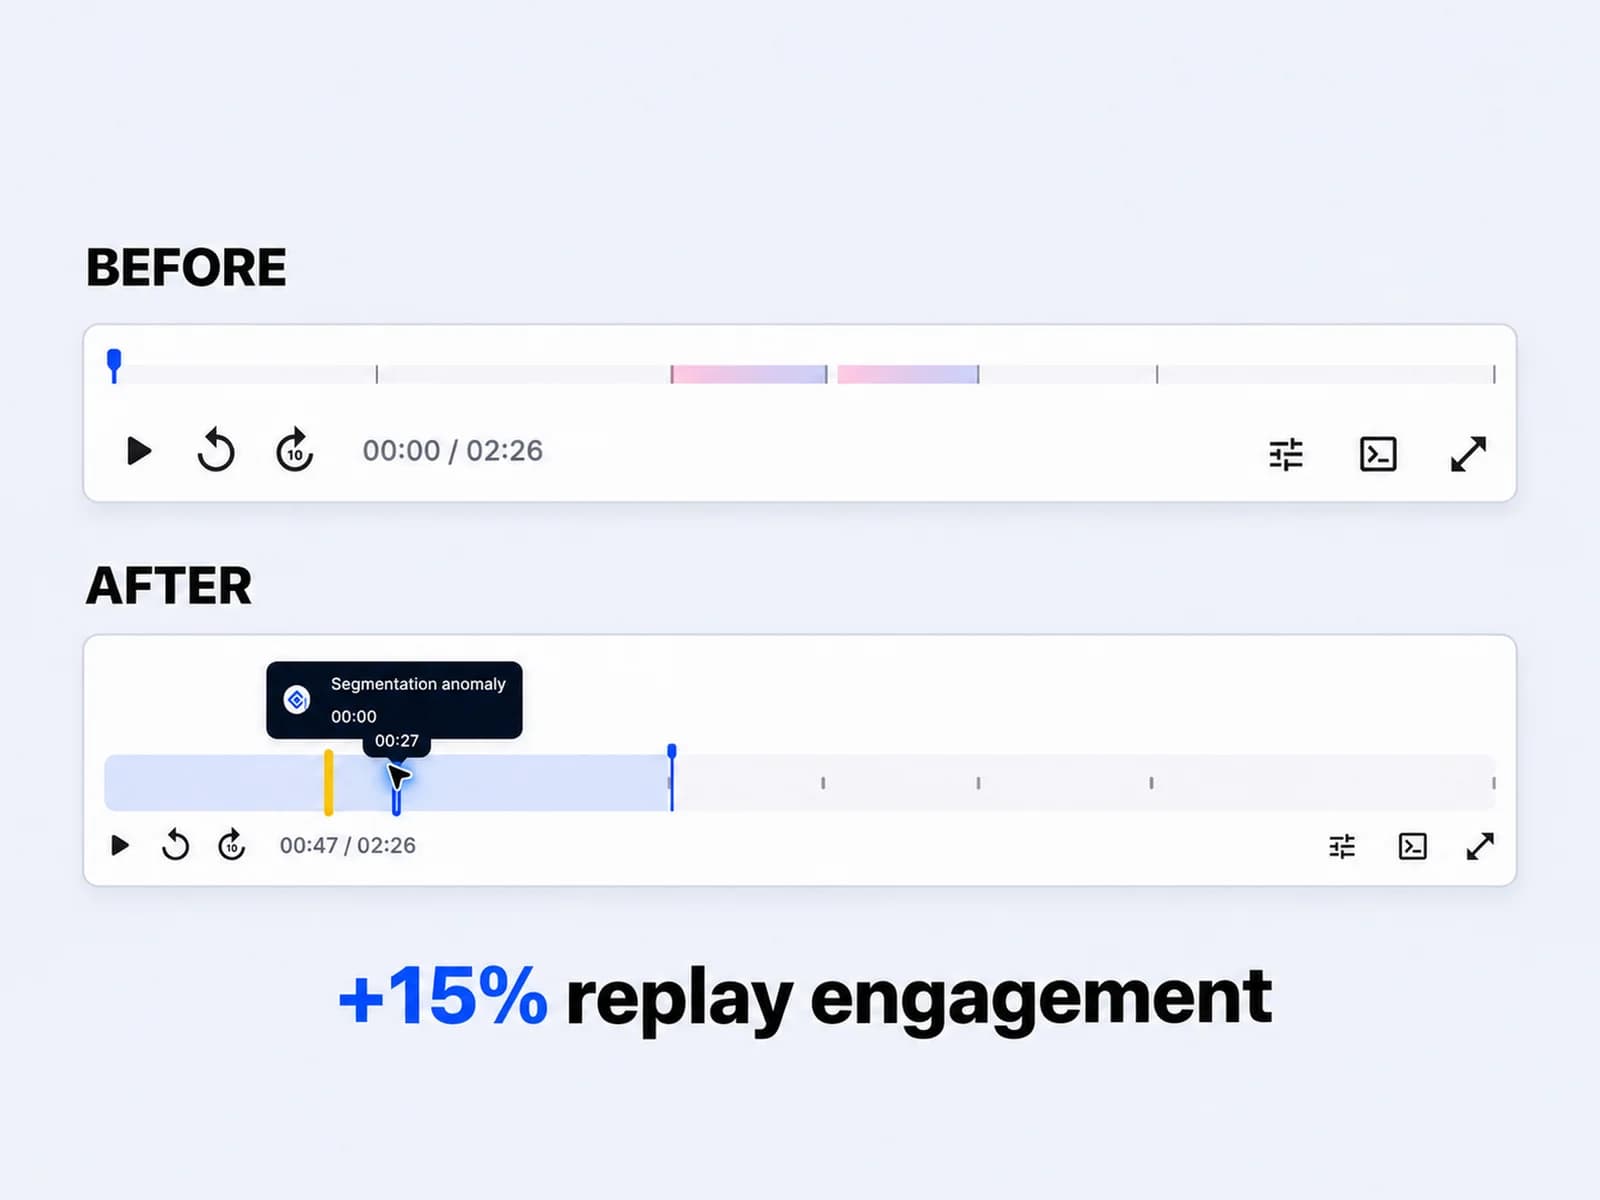
Если бы я начинал все сначала, я бы установил SDK в первый же день и включил Session Replay и автозахват. Данные в этих записях незаменимы. Я понимаю обычное возражение: ни у кого нет времени смотреть часы записей. Но никто и не должен. Агент может просматривать каждую сессию за ночь и отмечать, где пользователи застряли. Это кратчайший путь к пониманию ваших клиентов, и он доступен «из коробки» с Amplitude SDK.
Приступая к сбору данных, пересмотрите свою стратегию идентификации пользователей. Неидентифицированные пользователи завышают показатель удержания и искажают отслеживание конверсий. То же самое делают анонимные пользователи, которые оказываются тем же самым человеком. Идентификация позволяет контексту из хранилища привязываться к правильному пользователю, как только он идентифицирован.
Вашей команде нужна ясность в отношении того, каких клиентов можно идентифицировать, а какой трафик будет анонимным. Это нормально — иметь и то, и другое. Вам просто нужно провести различие, чтобы случайно не сравнить их между собой.
Эти проблемы гораздо проще решить в начале настройки, чем пытаться исправить их позже.
Что вы получаете: агента, который находит проблемы без необходимости гадать, где они могут возникнуть, и показатель удержания, который выдержит любую проверку перед руководством.
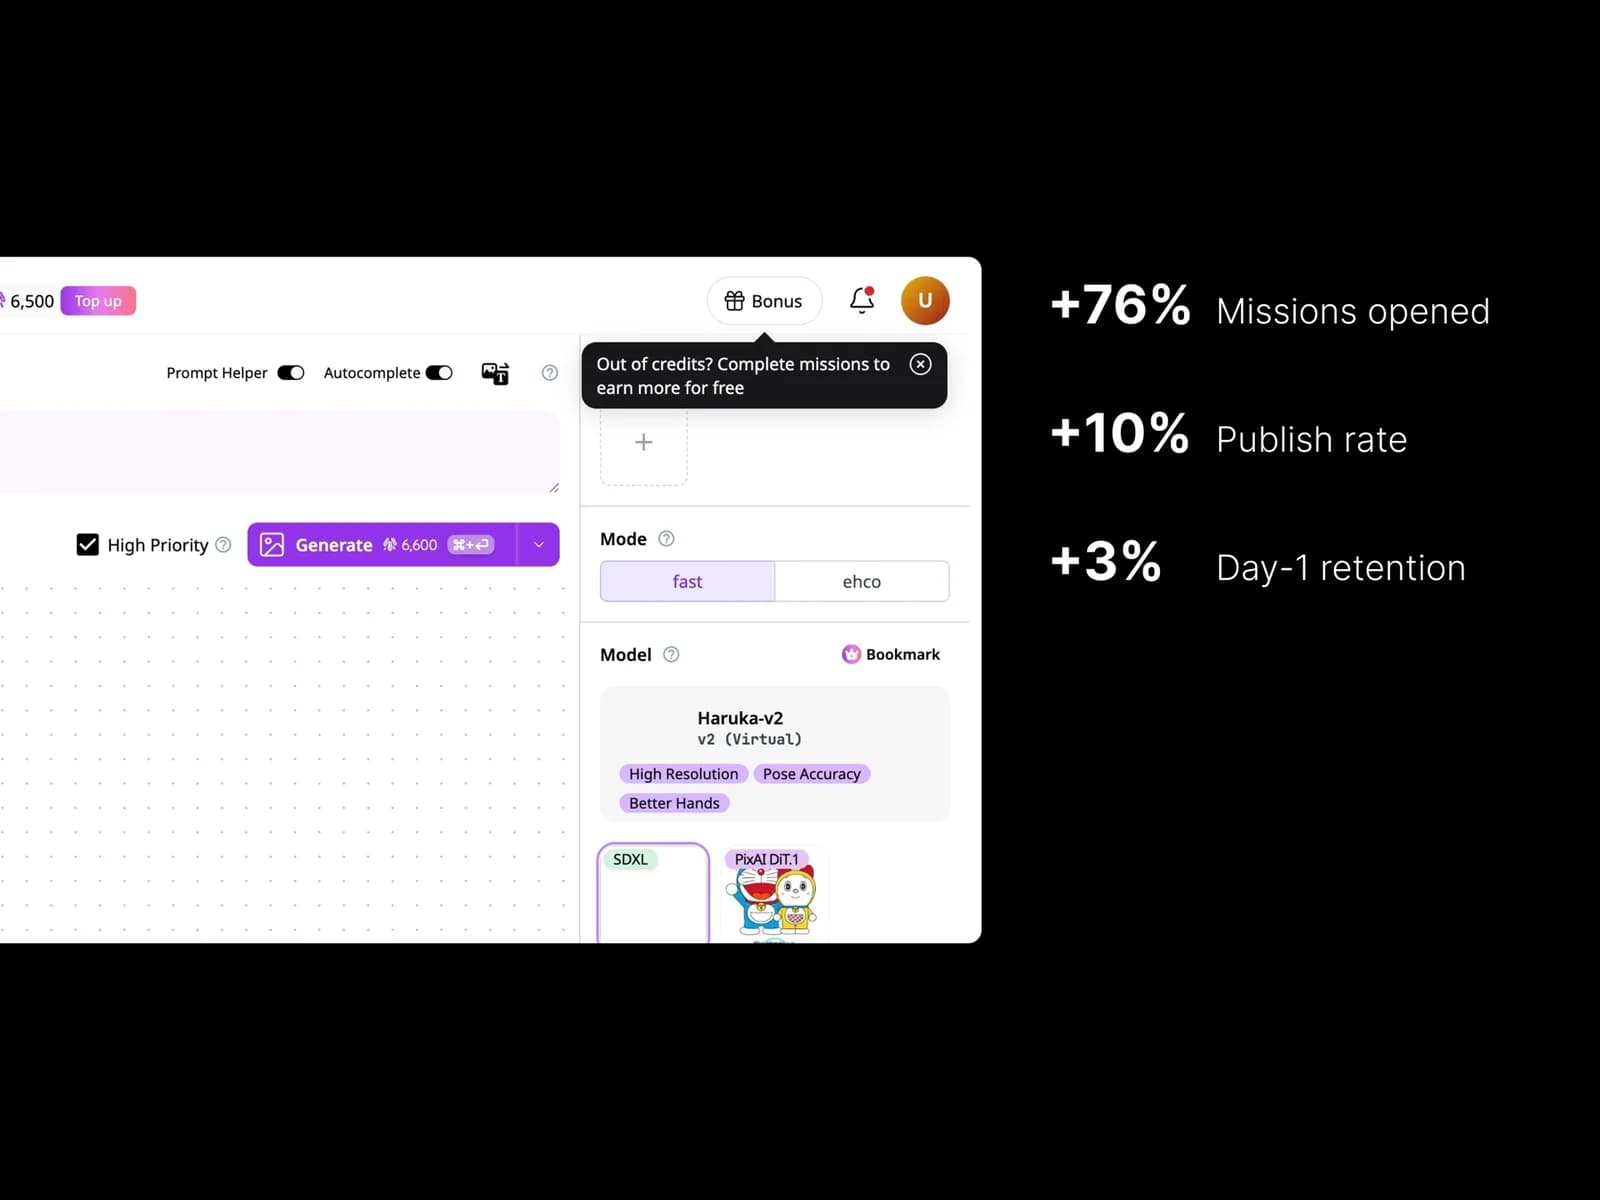
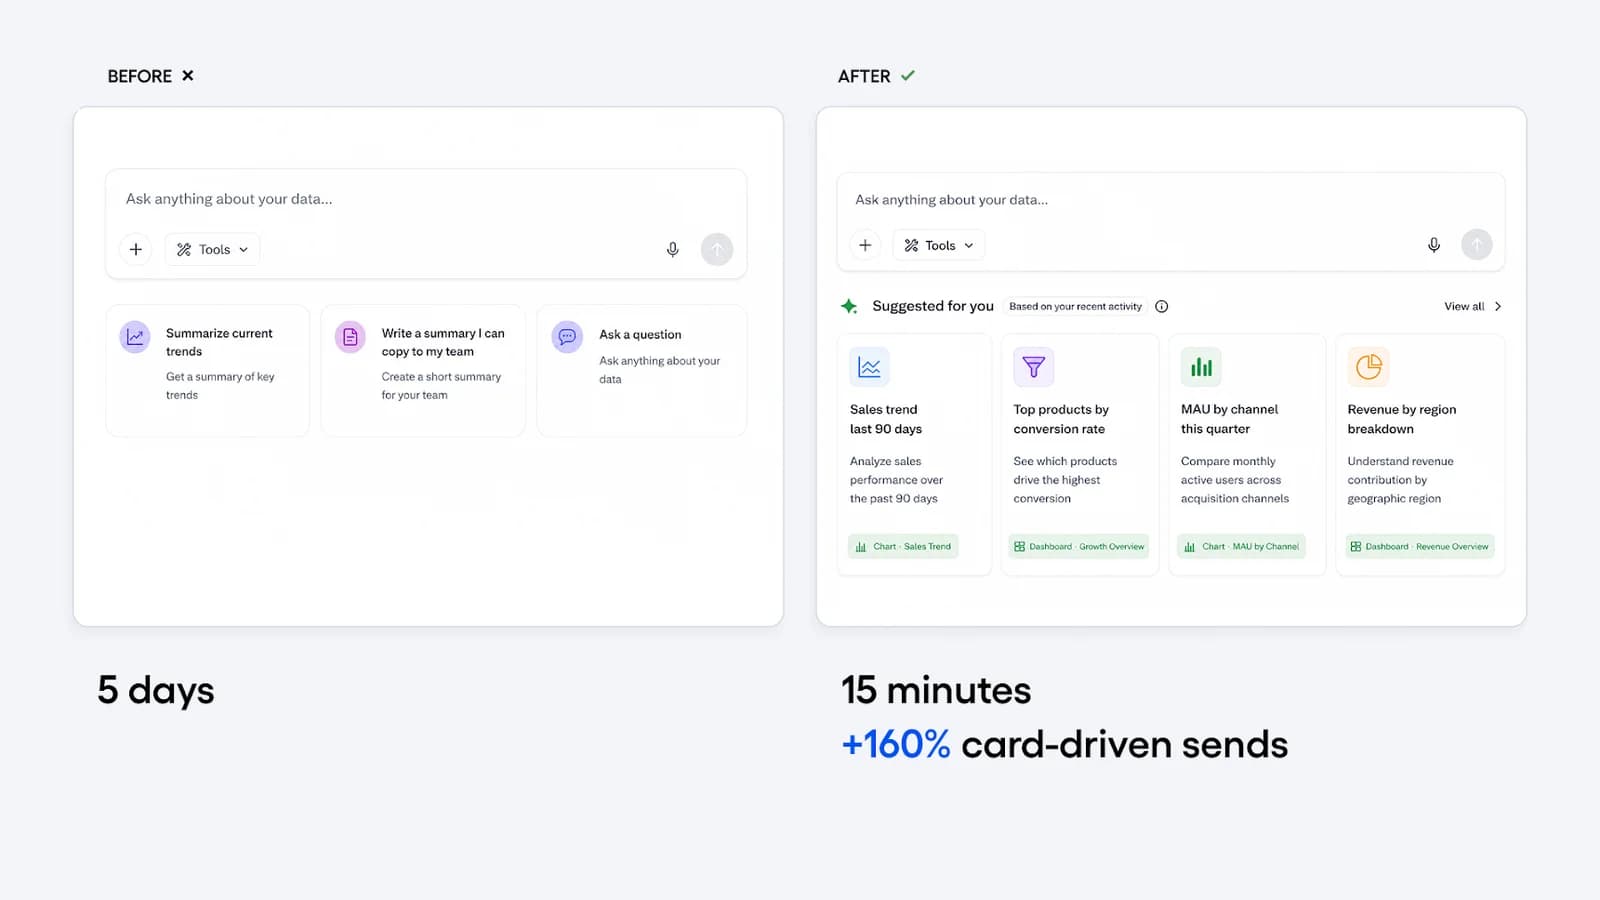
Сбор данных в реальном времени — это лишь полдела. Вторая часть — превращение этой информации в нечто полезное для пользователя в тот самый момент, когда она ему нужна. Когда ваша система замечает, что у кого-то возникают трудности, она должна иметь возможность отправить этому человеку руководство, чтобы направить его в нужное русло, или даже показать ему новый опыт с помощью Web Experimentation.
Оба эти процесса проходят через наш SDK (будь то унифицированный SDK, Guides and Surveys SDK или Experiment SDK). Данные хранилища обычно перемещаются недостаточно быстро, чтобы поддерживать подобные взаимодействия в реальном времени. В дополнение к проблемам со скоростью, хранилища часто с трудом справляются с обработкой данных из нескольких различных специализированных решений в одном месте и эффективным превращением их всех в четкие инсайты без значительных инженерных усилий. Не говоря уже о перетрансляции этого инсайта в действие в другой системе в будущем и решении проблем с (повторным) сопоставлением пользователей.
Что вы получаете: шанс оказать реальное влияние на пользователя, помогая ему, пока он все еще испытывает трудности, вместо того чтобы узнать об этом на следующий день.
Главный урок, который я усвоил, владея процессом реализации, заключается в том, что точность имеет убывающую отдачу. Данные на стороне клиента могут быть неполными по ряду причин, включая блокировщики рекламы и нестабильное интернет-соединение. Эти данные никогда не пройдут проверку, призванную обеспечить всеобъемлющий сбор данных, но этого и не требуется.
Поведенческие данные в реальном времени работают как метеорологический радар. Они могут показать вам зарождение чего-либо до того, как это станет достаточно конкретным для точного измерения. Они не всегда будут точно соответствовать вашему источнику истины, но цель состоит в том, чтобы быстро находить направленные закономерности и действовать на их основе.
Этот тип направленно точных данных — именно то, что нужно для успеха с ИИ. Если вы отслеживаете только точные, дискретные события, все, что находится между ними, остается невидимым. Неправильные повороты, возвраты назад и путаница выпадают из поля зрения. Обладая полной поведенческой картиной, агент может распределить каждого пользователя, столкнувшегося с одной и той же проблемой, на две группы: те, кто нашел обходной путь, и те, кто сдался. Сравнивая эти группы, легко понять, где и почему возникает трение.
Что вы получаете: агентов, которые распознают шаблоны во всем пользовательском опыте, а не только в тех событиях, которые вы додумались отслеживать.
Работа с данными не требует много времени, чтобы понять: они никогда не будут идеальными. Несовершенства, которые наносят реальный ущерб, — это те, которые вы не видите, потому что плохие графики выглядят так же правильно, как и хорошие. А неправильные инсайты кажутся такими же истинными, как и правильные.
Сколько раз вы анализировали маркетинговую кампанию с целью первой покупки клиента и обнаруживали, что «первая» покупка этого клиента на самом деле была совершена годами ранее, а аналитический инструмент не заглядывал так далеко назад? Сколько раз воронка занижала конверсии, потому что аналитический инструмент не включал конверсии для пользователей, которых он не видел на стороне клиента?
Люди совершают ошибки, когда работают с плохой информацией. Они не проявляют беспечности. Они реагируют правильно на те данные, которые видят. Проблема в том, что есть пробелы, которые не видны на графике. Когда цифры не совпадают с данными из хранилища, они обвиняют инструмент, а не реализацию, потому что он находится прямо перед ними. Такие типы невидимых пробелов подрывают доверие по принципу «это выглядит неправильно».
Решение этой путаницы — начать с поиска пробелов. Вот несколько полезных отправных точек:
- Задокументируйте, что означают данные. Договоритесь об общих определениях, о том, что собирают данные, и об их известных ограничениях.
- Регулярно проверяйте их. Автоматизируйте проверки на соответствие этим ожиданиям и отмечайте изменения, которые могут повлиять на решения.
- Руководство по тому, как команды используют это. Объясните, на какие вопросы могут отвечать данные и как интерпретировать различия между источниками.
- Назначьте четких ответственных. Укажите, кто поддерживает определения, устраняет проблемы с данными и обновляет руководства для команды.
ИИ повышает ставки в вопросах надежности ваших данных, поскольку уверенный неверный ответ приносит больше вреда, чем полное его отсутствие. Большая языковая модель поверх хранилища может читать таблицы, но обычно она не знает, как именно события туда попали. Без этого контекста она может неверно понять вопрос или выдумать логику, чтобы заполнить пробел в анализе. Данные SDK несут в себе дополнительный контекст, поэтому вероятность того, что ИИ выдаст неверный ответ, снижается.
Что вы получаете: хорошо задокументированный, полностью контролируемый рабочий процесс с данными, который надежно выдает правильные ответы и повышает доверие во всей организации.
Ваши более медленные данные, служащие единственным источником истины, играют важную роль в качестве дополнения к поведенческим данным, которые вы отслеживаете с помощью SDK.
Несвязанные с событиями данные в вашем хранилище чрезвычайно полезны, включая атрибуты на уровне профиля, такие как уровень клиента, география и пожизненная ценность (LTV). Этот контекст меняется медленно, поэтому ежедневных обновлений достаточно, при условии, что система получает оповещения об изменениях.
Без такого контекста ИИ будет действовать исключительно на основе поведенческих данных. Если он видит, что у пользователя возникают трудности, он вмешается, чтобы помочь. Это хорошая привычка. Но без информации о том, находится ли этот пользователь на бесплатном пробном периоде или является владельцем вашего крупнейшего аккаунта, ИИ может предложить использовать функцию, к которой у пользователя нет доступа. Объединяя поведенческие данные с данными из хранилища, ваша команда получает максимально четкое представление о клиенте, не жертвуя при этом скоростью или доверием.
Что вы получаете: рекомендации и действия, которые выдерживают столкновение с реальным миром, требуют большего, чем просто данные SDK.
Экспериментирование — это процесс, который превращает неточные направленные инсайты в валидированные результаты.
Не тратьте время на то, чтобы сопоставлять каждую цифру и каждый отчет по всей вашей системе. Сведите воедино важные события конверсии, а остальные оставьте верными лишь по направлению. После этого вы сможете со статистической значимостью утверждать, что изменение воронки переводит больше пользователей на следующий этап их жизненного цикла.
Продуктовая аналитика всегда испытывала трудности с этим последним шагом. Вы могли доказать начало уравнения (изменение увеличило количество кликов), и вы знали, что пользователи, которые кликали чаще, ценнее, но соединение точек от этого изменения до роста ценности требовало веры в успех.
Объединив анализ, эксперименты и запуски в рамках одной платформы, вы устраняете этот пробел валидации. Ваша команда может пройти путь от проблемы до ограниченного эксперимента и подтвержденного ответа без каких-либо догадок. В будущем такая взаимосвязанная система сможет выдавать те же результаты еще быстрее, позволяя агентам ИИ выполнять часть работы.
Что вы получаете: измеримый результат, который можно привязать к конкретному решению с помощью цифр, с которыми согласны все.
Вам не нужно принимать все шесть решений в первый же день
Вам не следует ждать завершения работы над всем этим контрольным списком, чтобы внести изменения в архитектуру данных. Разумный план заключается в том, чтобы запустить SDK в течение следующих 90 дней и начать извлекать из него пользу. Но SDK — это первый шаг, а не последний. Не останавливайтесь на достигнутом и не судите о всей системе только по этому элементу. Каждый шаг добавляет контекст к остальным, поэтому ценность накапливается.
Чем быстрее вы двигаетесь по этому списку, тем лучше для вас. Данные, которые вы не собираете сегодня, нельзя восстановить позже. Однако некачественные данные, которые вы собираете сегодня, при необходимости можно будет очистить позже.
Что касается вашей системы ИИ, она не знает того, чего не знает. Люди, читающие графики, имеют такие же пробелы в знаниях. Большинство команд на ранних этапах развития аналитики не осознают и половины того, как данные могут их дезинформировать.
Пока вы настраиваете и запускаете свой самообучающийся продуктовый цикл, вот несколько шагов, которые вы можете выполнить вручную, чтобы получить весьма неплохие результаты:
- Найдите проблему в Session Replay
- Проверьте, кого она затрагивает, по данным из вашего хранилища
- Выпустите исправление для части пользователей в качестве эксперимента
- Измерьте результат по событиям конверсии, которые вы свели
Продуктовый агент Amplitude под названием Wave создан для автоматизации этого ручного рабочего процесса. Он анализирует сигналы данных в совокупности для поиска возможностей продукта. С вашего одобрения Wave принимает меры и измеряет результат. Чем больше таких шагов вы сделаете, тем больше контекста вы предоставите Wave для работы и тем лучше будут итоговые результаты.