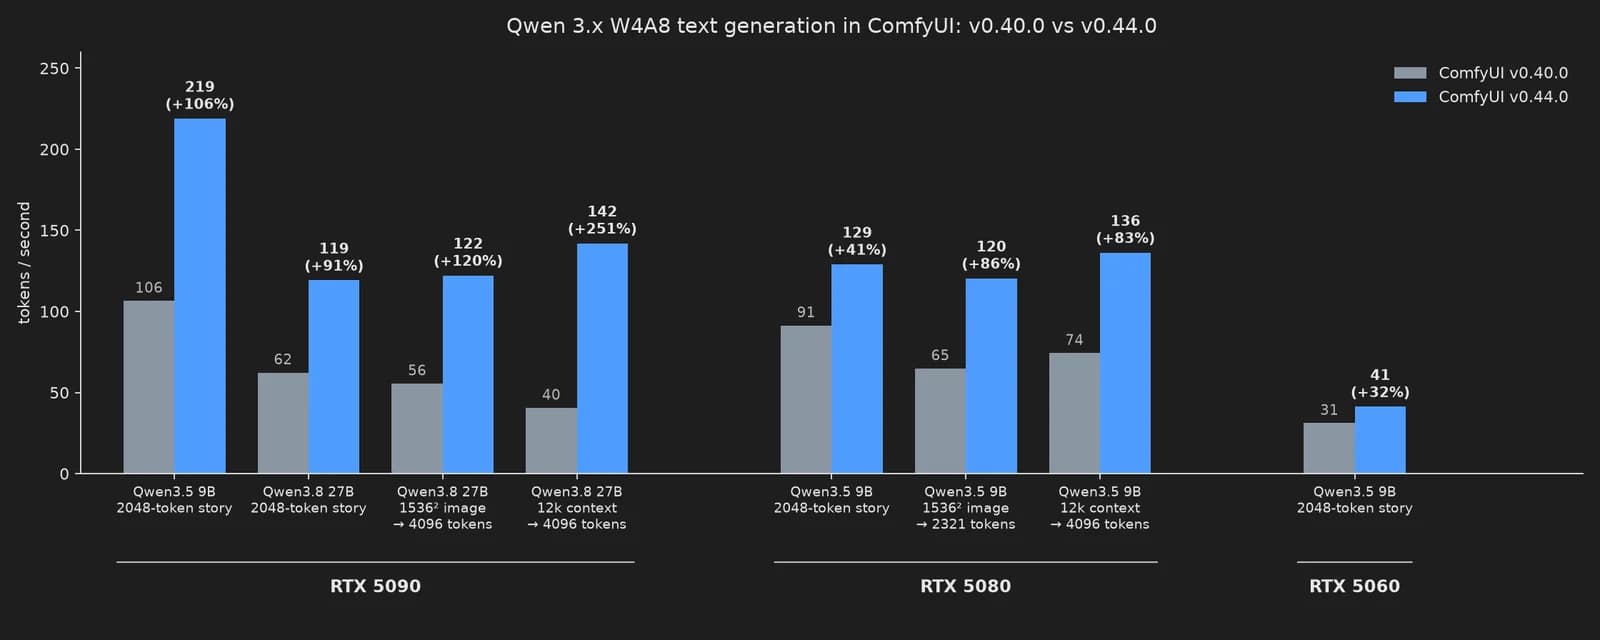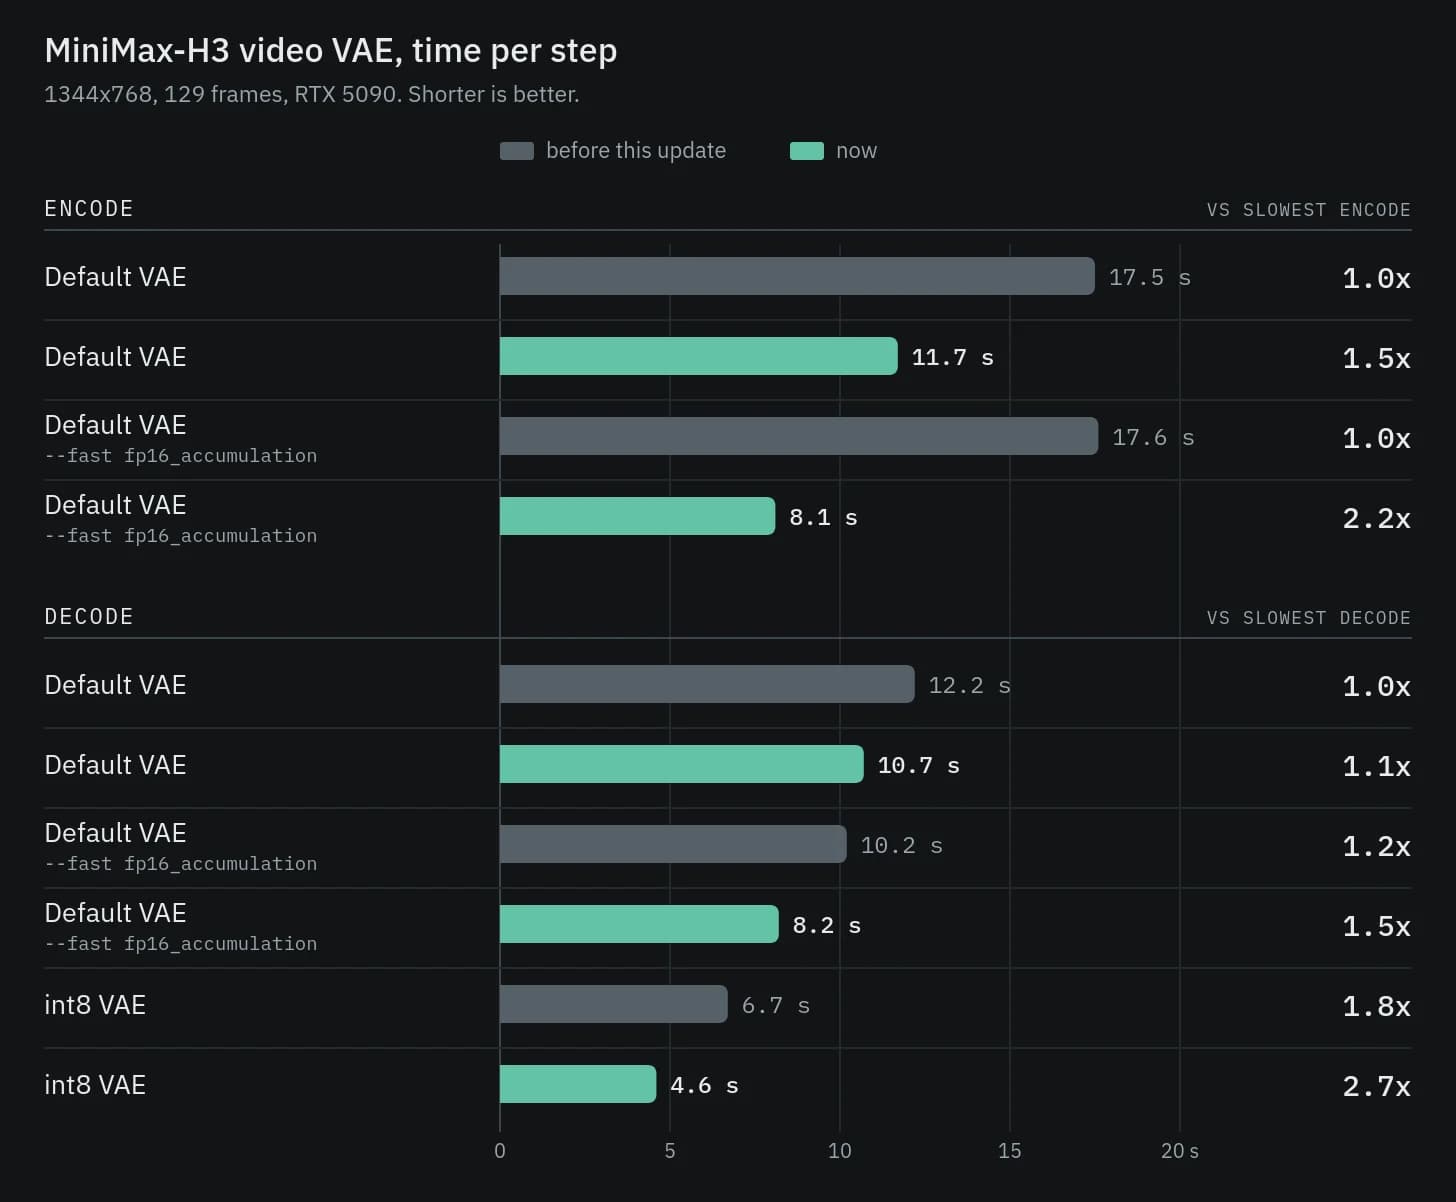
Видео-VAE MiniMax H3 теперь кодирует данные примерно в 2,2 раза быстрее и декодирует их в 1,4–2,7 раза быстрее. В совокупности это может сократить время, которое видео-процесс тратит на работу в VAE, примерно вдвое: цикл кодирования и декодирования 1344x768, 129 кадров сокращается с 24,3 до 12,7 секунд.
- Объединенное ядро кодировщика, включенное по умолчанию, теперь выполняет все операции в одном проходе, записывая данные напрямую в память в том порядке, который требуется свертке. Между свертками кодировщик нормализировал каждый кадр, применял активацию и дополнял края, что ранее требовало отдельного прохода через сотни мегабайт данных. Теперь это занимает примерно в 1,5 раза меньше времени, при этом выходные данные остаются идентичными.
Объединенное ядро кодировщика, включенное по умолчанию, теперь выполняет все операции в одном проходе, записывая данные напрямую в память в том порядке, который требуется свертке. Между свертками кодировщик нормализировал каждый кадр, применял активацию и дополнял края, что ранее требовало отдельного прохода через сотни мегабайт данных. Теперь это занимает примерно в 1,5 раза меньше времени, при этом выходные данные остаются идентичными.
- Новые пользовательские свертки поддерживают флаг --fast fp16_accumulation. PyTorch отправляет свертки в cuDNN, библиотеку NVIDIA, но нет возможности через нее запросить fp16-аккумуляцию, поэтому флаг всегда применялся только к умножениям матриц, и кодировщик ничего от этого не получал. Новая пользовательская свертка поддерживает этот флаг, включая смещение и пропуск соединения, что позволяет кодировщику достичь ускорения ~2,2x.
Новые пользовательские свертки поддерживают флаг --fast fp16_accumulation. PyTorch отправляет свертки в cuDNN, библиотеку NVIDIA, но нет возможности через нее запросить fp16-аккумуляцию, поэтому флаг всегда применялся только к умножениям матриц, и кодировщик ничего от этого не получал. Новая пользовательская свертка поддерживает этот флаг, включая смещение и пропуск соединения, что позволяет кодировщику достичь ускорения ~2,2x.
- Декодер int8 использует 8-битные веса, а нормализация, активация и пропуск соединения объединяются в умножения матриц, поэтому промежуточные результаты никогда не достигают памяти. Внимание также работает в 8-битном режиме. Это обеспечивает ускорение в 1,4 раза по сравнению с предыдущей версией int8 VAE.
Декодер int8 использует 8-битные веса, а нормализация, активация и пропуск соединения объединяются в умножения матриц, поэтому промежуточные результаты никогда не достигают памяти. Внимание также работает в 8-битном режиме. Это обеспечивает ускорение в 1,4 раза по сравнению с предыдущей версией int8 VAE.
Измерения проводились на RTX 5090 при разрешении 1344x768, 129 кадров, с сравнением каждой конфигурации с собой до этого обновления. Ничто здесь не специфично для этой карты, объединенное ядро кодировщика устраняет трафик памяти, что помогает любой видеокарте NVIDIA.
Параметр --fast fp16_accumulation полезен на потребительских картах, где fp16-аккумуляция работает в два раза быстрее.
Вы, скорее всего, не заметите визуальной разницы.
Каждый VAE теряет немного деталей при сжатии видео и его реконструкции, и эта потеря всегда присутствует. Более быстрые пути int8 добавляют к этому примерно в 30 раз меньшую потерю, что значительно меньше, чем что-либо, что видно в кадре.
Кодирование по-прежнему работает в fp16 даже с int8 VAE, объединенное ядро без потерь, оно просто вычисляет те же значения в другом порядке.
В техническом плане: декодер int8 соответствует стандартному декодеру с PSNR 67,7 дБ и более быстрому кодировщику примерно с 68 дБ, в то время как собственная реконструкция реального видео VAE составляет примерно 38 дБ.
- Обновите ComfyUI до версии 0.36.0 или выше. Объединенному ядру кодировщика ничего больше не нужно.
Обновите ComfyUI до версии 0.36.0 или выше. Объединенному ядру кодировщика ничего больше не нужно.
- Запустите ComfyUI с параметром --fast fp16_accumulation для более быстрого кодировщика и декодера.
Запустите ComfyUI с параметром --fast fp16_accumulation для более быстрого кодировщика и декодера.
- Скачайте нижеприведенные рабочие процессы или найдите их в библиотеке шаблонов.
Скачайте нижеприведенные рабочие процессы или найдите их в библиотеке шаблонов.
- Загрузите файл int8 MiniMax-H3 VAE для самого быстрого декодирования. Это полная замена стандартного файла.
Загрузите файл для самого быстрого декодирования. Это полная замена стандартного файла.
Все цифры являются измерениями A/B в тот же день по сравнению с версией до изменений, проведенными через узлы VAE Encode и VAE Decode.
Нет постов