
28 августа 2026 г.
Sefik Emre Eskimez, Ankit Kumar, Françoise Beaufays, Freeman Jiang, Ramon Sanabria, Soham Deshmukh, Bandhav Veluri, Satyapriya Krishna
Мы считаем, что быть хорошим собеседником означает владеть тремя фундаментальными навыками: говорить правильные вещи, правильным образом и в правильное время. В нашей предыдущей технической статье «Преодоление «зловещей долины» разговорного голоса» мы сосредоточились на важности создания эмоционально насыщенных голосов с помощью интонации и просодии.
Человеческий разговор — это сложный социальный танец, где тайминг важен так же, как содержание и подача. Типичная пауза между репликами составляет всего ~200 миллисекунд [1], что меньше, чем ~600 мс, необходимых человеку для планирования одного слова [2]. Это означает, что слушатели не просто реагируют на тишину, а предсказывают момент окончания реплики, основываясь на просодических и лингвистических сигналах. Хороший собеседник должен без раздумий справляться со сменой очередности, поддакиваниями, наложениями и перебиваниями.
Эта координация настолько глубоко укоренилась, что мы замечаем её только тогда, когда она нарушается. Ассистент, который перебивает на полуслове, говорит одновременно с вами или оставляет неловкую паузу, не кажется естественным, каким бы натуральным ни был сам голос. Этот навык — знать, когда говорить, когда уступить очередь и когда промолчать — называется очередностью реплик (turn-taking). Его отсутствие — верный признак того, что вы разговариваете с машиной.
Сегодня мы выпускаем TurnBench, бенчмарк с открытым исходным кодом для оценки динамики очередности реплик в разговорной речи. Он отражает нашу внутреннюю методологию оценки с той же таксономией, задачами и протоколом подсчета баллов. В нем есть публичная таблица лидеров, интерактивный просмотрщик диалогов и возможность самостоятельной оценки на dev-наборе.
Превращение этой методологии в общественный ресурс стало результатом командной работы. Мы сотрудничали с Университетом Карнеги — Меллона, Mundo AI и Oto для записи и аннотирования открытого набора данных. Кроме того, исследователи из Национального тайваньского университета, Academia Sinica и Технологического университета Брно помогли сформировать бенчмарк и предоставили модели очередности реплик для оценки.
Почему очередность реплик — это сложно
С точки зрения разговорного агента, очередность реплик — это решение, которое система должна принимать постоянно, с высоким временным разрешением: говорить или молчать. Правильное решение зависит от того, кто в данный момент владеет инициативой в разговоре, а это редко сигнализируется явно.
Возьмем две очень распространенные точки перехода в разговоре:
1. Пользователь говорил и теперь перестал:
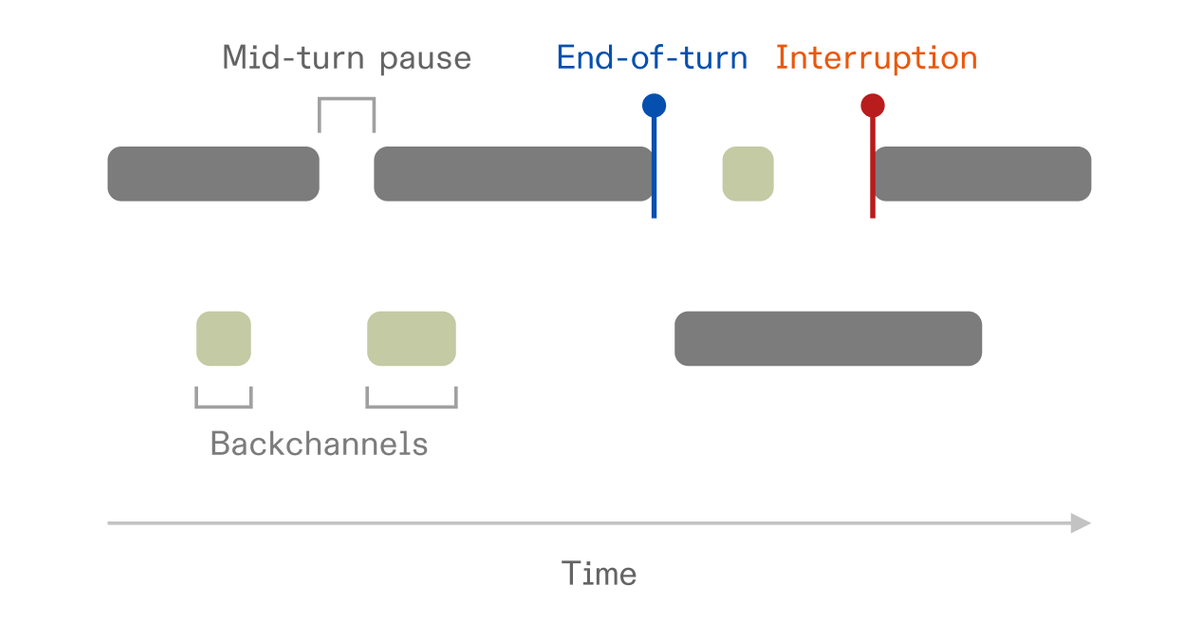
Пауза внутри реплики (Mid-turn pause) — Конец реплики (End-of-turn)
Это естественная пауза внутри реплики или законный конец высказывания?
2. Агент говорил, и теперь пользователь начинает говорить:
Поддакивание (Backchannels) — Перебивание (Interruption)
Пользователь перебивает, чтобы взять инициативу, или это просто поддакивание («угу», «понятно»), чтобы показать, что он слушает? Возможно, это вообще не пользователь, а фоновый шум, кто-то разговаривает в соседней комнате или собственный голос агента эхом возвращается в микрофон.
Идеальные системы очередности реплик должны справляться с этой двусмысленностью. Они должны быть одновременно быстрыми и точными, способными распознавать намерения пользователя на основе тех же просодических и лингвистических сигналов, которые используют люди. Например, они должны понимать, что повышение тона в конце вопроса означает, что следует ожидать смены говорящего. Они также должны распознавать семантическую разницу между перебивающим пользователем и поддакивающим.
Чтобы создать такую систему, нам нужен способ измерения нюансов очередности реплик. Осмысленное измерение требует большего, чем просто число точности: как часто система срабатывает во время паузы внутри реплики? Ошибочно ли она принимает поддакивание за перебивание? Как быстро она реагирует, когда реплика действительно закончилась? Когда мы искали систему оценки, которая могла бы ответить на эти вопросы, мы обнаружили, что таковой не существует.
В чем недостатки текущих бенчмарков
Одна из проблем — отсутствие разнообразия доменов. Последние несколько десятилетий стандартным набором для оценки очередности реплик был Switchboard — коллекция телефонных разговоров между незнакомцами, записанных в начале 90-х. Проблема в том, что эти звонки имеют очень специфический ритм: короткие паузы, предсказуемые наложения и очень похожее содержание. Повседневный разговор (например, ужин с двумя друзьями) звучит иначе. Модель, которая хорошо работает на Switchboard, может плохо работать в других ситуациях.
Вторая проблема заключается в том, что события очередности реплик трудно классифицировать. Например, большинство работ определяют поддакивания с помощью эвристических правил или предопределенного списка, но детерминированные правила не отражают того, как эти события варьируются в зависимости от контекста разговора. Вместо этого нам следует основывать методологию разметки на лингвистических исследованиях и обучать аннотаторов размечать события соответствующим образом.
Что измеряет TurnBench
TurnBench основывает свои метки на анализе разговорной речи — дисциплине в прикладной лингвистике, изучающей, как говорящие координируют владение инициативой. Её ключевая концепция — место, релевантное для перехода (transition-relevance place): структурная точка, в которой смена говорящего становится законной. Вокруг этих критических точек могут происходить четыре различных события:
- Реплика (Turn): Непрерывный набор вокализаций одного говорящего, ограниченный сменой того, кто владеет инициативой.
- Перебивание (Interruption): Вокализация, при которой слушатель намерен взять инициативу в середине реплики.
- Поддакивание (Backchannel): Вокализация, сигнализирующая о понимании без претензии на инициативу.
- Пауза внутри реплики (Mid-turn pause): Тишина внутри реплики, при которой говорящий на самом деле не уступает инициативу.
Наша система оценки в конечном итоге сводится к этим четырем событиям. Кроме того, аннотаторы разметили более детальную таксономию из 17 категорий, которые сохранены в открытом наборе данных для более глубоких исследований.
Задача очередности реплик сводится к определению того, когда уместно говорить, а когда нет. Это дает два направления оценки:
- Детекция конца реплики (EOT): Для каждого говорящего система определяет моменты, когда он уступает инициативу. Истинные срабатывания (TP): Реальные переходы инициативы в конце реплики. Ложные срабатывания (FP): Паузы внутри реплики.
- Истинные срабатывания (TP): Реальные переходы инициативы в конце реплики.
- Ложные срабатывания (FP): Паузы внутри реплики.
- Детекция перебивания (INT): Для каждого говорящего система определяет моменты, когда слушатель перехватил инициативу в середине реплики. Истинные срабатывания (TP): Законные вмешательства. Ложные срабатывания (FP): Поддакивания, шум, наводки канала.
- Истинные срабатывания (TP): Законные вмешательства.
- Ложные срабатывания (FP): Поддакивания, шум, наводки канала.
Корпус
TurnBench построен на 30 часах двухканальной диадической английской речи: 154 диалога с участием 106 актеров озвучивания в 53 парах. Мы записали разговоры в профессиональной студии с одним говорящим на канал в отдельных звукоизолированных кабинах, чтобы обе стороны можно было оценить независимо. Каждый диалог трижды аннотирован по вышеуказанному протоколу с высоким уровнем согласия между аннотаторами (κ Фляйса = 0,78).
Корпус сбалансирован по шести типам диалогов: повседневная социальная беседа, диалог, ориентированный на задачу, инструктивные обмены, совместное решение проблем, аргументированный спор и повествовательный рассказ. Каждый из них нацелен на различное распределение поведения при смене очереди; например, аргументированный диалог насыщен конкурентными перебиваниями, в то время как инструктивные беседы характеризуются более длинными репликами и меньшим количеством смен говорящего.
Наряду с оценочным набором данных мы также выпускаем 104-часовой обучающий набор, размеченный вручную по тому же протоколу, чтобы любой, кто создает модель смены очереди с учителем, мог обучаться и оцениваться на согласованных данных. Сам бенчмарк разделен на публичный набор для разработки (dev set) для самостоятельной оценки и отложенный тестовый набор, метки которого скрыты для предотвращения переобучения под таблицу лидеров.
17.0
10.0
3.09
2.48
20.2
20.9
8.1
5.20
2.05
29.7
21.4
7.9
3.97
2.64
38.2
17.6
10.5
4.30
1.52
12.9
18.8
10.2
4.76
1.50
23.0
18.3
8.9
5.00
1.75
16.7
19.0
9.2
4.32
2.04
23.7
Протокол оценки
Чтобы оценить ответы модели, мы ищем окно вокруг каждого размеченного человеком события (от 0,25 с до до 3 с после) и проверяем, совершила ли модель соответствующее событие в этом окне. Ложное завершение очереди (EOT), срабатывающее в середине реплики, обычно означает, что модель приняла паузу за окончание речи говорящего. С другой стороны, ложное перебивание (INT) — это противоположность: когда модель подумала, что кто-то вклинивается, но на самом деле это был просто шум или фоновая реакция. Мы сообщаем о полноте (recall), частоте ложноположительных результатов и знаковой задержке каждого решения на 10-м, 50-м и 90-м перцентилях. В данном случае отрицательная задержка означает, что модель сработала до времени начала события. Заявки ранжируются по полноте, ограниченной максимальной частотой ложноположительных результатов, поэтому излишне чувствительная модель не может «купить» полноту, срабатывая постоянно.
Мы оцениваем совершенные события, а не кривые вероятностей. Развернутая модель смены очереди должна действовать причинно-следственно в одной рабочей точке: в каждый момент либо брать очередь, либо уступать. Оценка решения в каждый момент соответствует этой реальности. Кроме того, работа с решениями дает нам общую основу для каждой модели: те, которые выдают вероятности, можно просто порогово преобразовать в решения, в то время как те, которые никогда их не раскрывают, как Moshi или Gemini API, могут быть оценены непосредственно по их поведению. Таким образом, любую модель, способную к смене очереди, можно сравнить по одному и тому же протоколу.
Что мы узнали, тестируя 14 систем смены очереди
Мы запустили TurnBench на 14 системах и конфигурациях смены очереди, охватывающих реальные приложения, создаваемые сегодня: от простого базового детектора голосовой активности (VAD) до коммерческих эндпоинтеров, обученных обнаруживать завершение очереди, и полнодуплексных диалоговых моделей, оцениваемых в условиях zero-shot. Каждая система была зафиксирована в одной рабочей точке, настроенной на наборе для разработки, а затем оценена один раз на тестовом наборе, чтобы наилучшим образом отразить условия развертывания.
Выделяются три вывода:
- Обнаружение завершения очереди согласуется между типами диалогов, но ложные срабатывания — нет. Системы одинаково хорошо обнаруживают завершение очереди для разных типов диалогов, но количество ошибок варьируется. Ложные перебивания достигают пика в повседневных разговорах, насыщенных фоновыми реакциями. Это подчеркивает, что повседневная беседа на самом деле является самым сложным режимом для современных разговорных систем.
- Существует компромисс между скоростью и точностью. Чисто акустические системы, срабатывающие на первом кадре речи слушателя, улавливают перебивания быстро, но неточно, потому что в этот момент фоновая реакция и реальное перебивание выглядят одинаково. Системы, которые ждут больше доказательств, точны, но медленны. Это также относится к треку EOT.
- Лучшая система все еще медленна там, где это важно. Voice Activity Projection (VAP) лидирует в обоих треках (0,845 полноты при 0,055 частоте ложноположительных результатов на завершении очереди, 0,945 при 0,107 на перебивании), но в среднем тратит почти секунду на совершение перебивания. Хотя существуют системы с задержкой около 200 мс, они слишком склонны к ложным срабатываниям. Ни одна система не является одновременно быстрой, избирательной и обладающей высокой полнотой.
Ограничения
Во-первых, наш трек перебиваний оценивает аудио пользователя. Это работает для эндпоинтер-стиля и каскадных систем, которые мы оцениваем, но полнодуплексные модели генерируют и слушают одновременно, поэтому оценка их перебиваний требует протокола, учитывающего собственную речь агента.
Во-вторых, TurnBench только на английском языке. Структура смены очереди универсальна, но нормы времени различаются: средние паузы варьируются от ~7 мс в японском до ~470 мс в датском [1]. Модель, откалиброванная по английским нормам, может показаться медлительной японскому говорящему и навязчивой датскому.
В-третьих, корпус записан в студии и является диадическим. Аудио в реальных условиях удивительно шумное, часто содержит фоновый шум, эхо и фоновую болтовню. Оценки смены очереди в «чистых» условиях могут не обобщаться на такие ситуации.
Заключение
То, что мы здесь описали, — это та же методология, которую мы использовали для разработки наших собственных моделей, обеспечивающая надежный сигнал для отделения реальных достижений от шума. С помощью TurnBench мы теперь делаем это доступным для всех.
Мы считаем, что смена очереди находится в той же точке перегиба, которой синтез речи достиг год назад, когда стандартные бенчмарки качества стали насыщенными и больше не могли отличить хорошие модели от отличных.
Открывая нашу методологию бенчмаркинга вместе с корпусом, созданным специально для этой цели, мы надеемся ускорить прогресс в этой области. Мы приглашаем сообщество развивать и улучшать эти результаты. Корпус, обучающий набор, код оценки и таблица лидеров доступны здесь:
- Таблица лидеров и интерактивный просмотрщик: turnbench.sesame.com
- Самостоятельная оценка на dev-сете и формат подачи: turnbench.sesame.com/dev
- Статья (препринт arXiv): arxiv.org/abs/2608.25218
Данные распространяются по некоммерческой лицензии, которая запрещает клонирование голоса.
Присоединяйтесь к нам
Смена очереди — это часть наших усилий по созданию голосовых агентов, которые ощущаются по-настоящему присутствующими. Если вы увлечены таймингом, структурой и динамикой естественного разговора, а также моделями и измерениями, которые помогают нам этого достичь, ознакомьтесь с нашими открытыми вакансиями. Мы нанимаем.