27 февраля 2025 г.
Брендан Ирибе, Анкит Кумар и команда Sesame
Как мы понимаем, что кто-то действительно нас слышит? Редко дело только в словах — всё дело в тонкостях голоса: нарастающем воодушевлении, вдумчивой паузе, теплом утешении.
Голос — наше самое интимное средство общения, передающее слои смыслов через бесчисленные вариации тона, высоты, ритма и эмоций.
Современным цифровым голосовым помощникам не хватает качеств, необходимых для того, чтобы стать по-настоящему полезными. Не раскрыв весь потенциал голоса, они не смогут эффективно взаимодействовать с нами. Личный помощник, который говорит только нейтральным тоном, с трудом удерживается в нашей повседневной жизни после того, как проходит эффект новизны.
Со временем эта эмоциональная плоскость становится чем-то большим, чем просто разочарование — она начинает утомлять.
Достижение голосового присутствия
В Sesame наша цель — достичь «голосового присутствия» — того магического качества, благодаря которому устная речь кажется живой, понятной и ценной. Мы создаем собеседников, которые не просто обрабатывают запросы, а ведут подлинный диалог, укрепляющий уверенность и доверие с течением времени. Тем самым мы надеемся реализовать нераскрытый потенциал голоса как идеального интерфейса для обучения и понимания.
Ключевые компоненты
- Эмоциональный интеллект: считывание эмоционального контекста и реагирование на него.
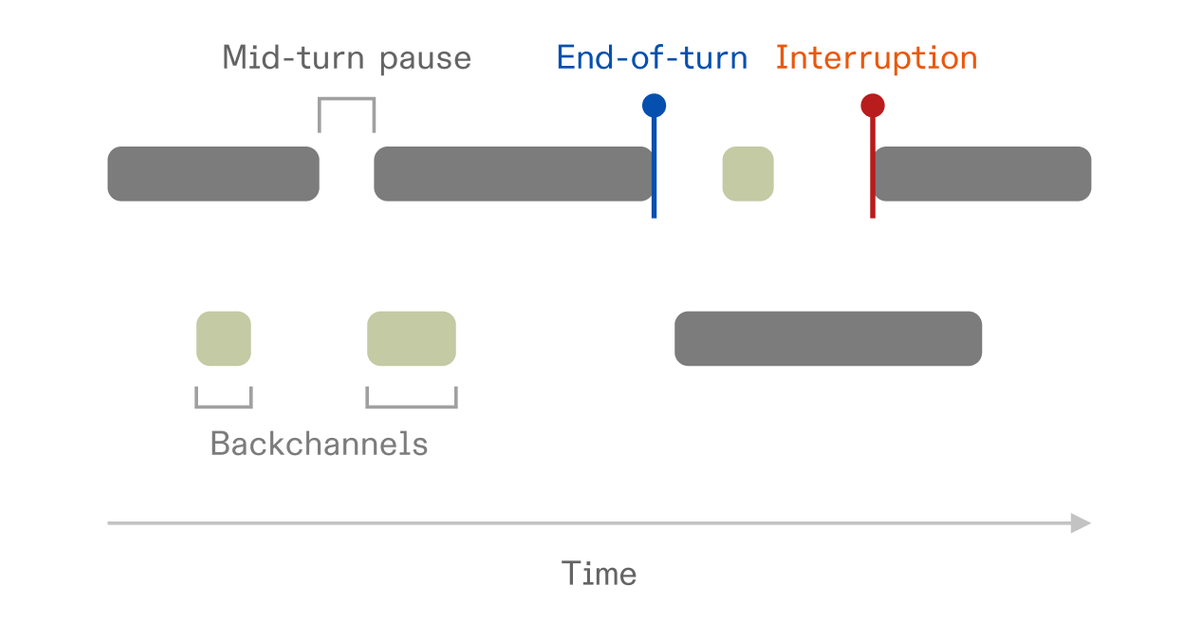
- Динамика разговора: естественные тайминги, паузы, перебивания и акценты.
- Контекстуальная осведомленность: адаптация тона и стиля в соответствии с ситуацией.
- Последовательная личность: поддержание связного, надежного и уместного присутствия.
Мы еще не достигли цели
Создать цифрового компаньона с голосовым присутствием непросто, но мы уверенно движемся вперед по нескольким направлениям, включая личность, память, выразительность и уместность. Эта демонстрация — пример некоторых наших наработок в области генерации разговорной речи. Представленные здесь компаньоны оптимизированы для дружелюбия и выразительности, чтобы проиллюстрировать потенциал нашего подхода.
Техническая статья
Генерация разговорной речи
Авторы
Йохан Шалквик, Анкит Кумар, Дэн Лит, Сефик Эмре Эскимез, Зак Ходари, Синжон Ресник, Рамон Санабрия, Рэйвен Цзян
Чтобы создавать ИИ-компаньонов, которые кажутся по-настоящему интерактивными, генерация речи должна выйти за рамки создания высококачественного аудио — она должна понимать контекст и адаптироваться к нему в режиме реального времени. Традиционные модели преобразования текста в речь (TTS) генерируют аудио непосредственно из текста, но им не хватает контекстуальной осведомленности, необходимой для естественного общения. Несмотря на то, что современные модели создают очень похожую на человеческую речь, они сталкиваются с проблемой «один ко многим»: существует бесчисленное множество правильных способов произнести предложение, но лишь некоторые из них подходят для конкретной ситуации. Без дополнительного контекста — включая тон, ритм и историю разговора — моделям не хватает информации для выбора оптимального варианта. Улавливание этих нюансов требует рассуждения по нескольким аспектам языка и просодии.
Чтобы решить эту задачу, мы представляем модель разговорной речи (Conversational Speech Model, CSM), которая формулирует проблему как сквозную мультимодальную задачу обучения с использованием трансформеров. Она использует историю разговора для создания более естественной и связной речи. Из нашей работы можно сделать два ключевых вывода. Первый заключается в том, что CSM работает как
одноэтапная модель, что повышает эффективность и выразительность. Второй — это наш набор инструментов для оценки, который необходим для отслеживания прогресса в контекстуальных возможностях и решает проблему перенасыщенности общедоступных оценочных тестов.
История вопроса
Один из подходов к моделированию аудио с помощью трансформеров заключается в преобразовании непрерывных сигналов в последовательности дискретных аудиотокенов с использованием токенизаторов. Большинство современных подходов ([1], [2]) опираются на два типа аудиотокенов:
- Семантические токены: компактные, инвариантные к диктору представления семантических и фонетических признаков. Их сжатая природа позволяет улавливать ключевые характеристики речи ценой высокой точности представления.
- Акустические токены: кодировки детальных акустических характеристик, позволяющие восстанавливать аудио высокой точности. Эти токены часто генерируются с использованием остаточного векторного квантования (RVQ) . В отличие от семантических токенов, акустические токены сохраняют естественные характеристики речи, такие как индивидуальность диктора и тембр.
Общая стратегия заключается в том, чтобы сначала моделировать семантические токены, а затем генерировать аудио с помощью RVQ или методов на основе диффузии. Разделение этих этапов позволяет использовать более структурированный подход к синтезу речи: семантические токены обеспечивают компактное, инвариантное к диктору представление, которое фиксирует высокоуровневую лингвистическую и просодическую информацию, в то время как второй этап восстанавливает детальные акустические характеристики, необходимые для высококачественной речи. Однако у этого подхода есть критический недостаток: семантические токены являются «узким местом», которое должно полностью охватывать просодию, но обеспечить это во время обучения сложно.
Методы на основе RVQ привносят свои собственные проблемы. Модели должны учитывать последовательную зависимость между кодовыми книгами в кадре. Один из методов, шаблон задержки (рисунок ниже) [3], постепенно сдвигает старшие кодовые книги, чтобы обусловить предсказания младшими кодовыми книгами в пределах одного кадра. Ключевым ограничением этого подхода является то, что время до начала воспроизведения аудио плохо масштабируется, поскольку RVQ-токенизатор с N кодовыми книгами требует N шагов магистральной сети перед декодированием первого аудиофрагмента. Хотя это подходит для офлайн-приложений, таких как аудиокниги, такая задержка является проблематичной в сценарии реального времени.
Пример генерации с шаблоном задержки в RVQ-токенизаторе с 4 кодовыми книгами
Модель разговорной речи (CSM)
CSM — это мультимодальная модель текста и речи, которая работает непосредственно с RVQ-токенами. Вдохновленные RQ-Transformer [4], мы используем два авторегрессионных трансформера. В отличие от подхода в [5], мы разделяем трансформеры на нулевой кодовой книге. Первый мультимодальный «магистральный» блок обрабатывает чередующиеся текст и аудио для моделирования нулевой кодовой книги. Второй аудиодекодер использует отдельную линейную «голову» для каждой кодовой книги и моделирует оставшиеся N – 1 кодовых книг для восстановления речи из представлений магистрального блока. Декодер значительно меньше магистрального блока, что обеспечивает генерацию с низкой задержкой, сохраняя при этом сквозной характер модели.
Процесс вывода модели CSM. Текстовые (T) и аудио (A) токены чередуются и последовательно подаются в магистральный блок (Backbone), который предсказывает нулевой уровень кодовой книги. Затем декодер (Decoder) выбирает уровни с 1 по N – 1, обусловленные предсказанным нулевым уровнем. Восстановленный аудиотокен (A) затем авторегрессионно подается обратно в магистральный блок для следующего шага, продолжаясь до тех пор, пока не будет выдан символ EOT (конец аудио). Этот процесс начинается снова при следующем запросе на вывод, при этом промежуточное аудио (например, высказывание пользователя) представляется чередующимися токенами аудио и текстовой транскрипции.
Оба трансформера являются вариантами архитектуры Llama. Текстовые токены генерируются с помощью токенизатора Llama [6], в то время как аудио обрабатывается с использованием Mimi, токенизатора с разделенным RVQ, который создает одну семантическую кодовую книгу и N – 1 акустическую кодовую книгу на кадр с частотой 12,5 Гц. Учебные выборки структурированы как чередующиеся перемежающиеся паттерны текста и аудио, при этом идентификатор говорящего кодируется непосредственно в текстовом представлении.
Амортизация вычислений
Такая конструкция создает серьезные инфраструктурные проблемы во время обучения. Аудиодекодер обрабатывает эффективный размер пакета B × S и N кодовых книг авторегрессионно, где B — исходный размер пакета, S — длина последовательности, а N — количество уровней кодовой книги RVQ. Эта высокая нагрузка на память даже при небольшой модели замедляет обучение, ограничивает масштабируемость модели и препятствует быстрому экспериментированию, что критически важно для производительности.
Чтобы решить эти проблемы, мы используем схему амортизации вычислений, которая устраняет узкое место памяти, сохраняя при этом точность полных кодовых книг RVQ. Аудиодекодер обучается только на случайном подмножестве аудиокадров (1/16), в то время как нулевая кодовая книга обучается на каждом кадре. Мы не наблюдаем заметной разницы в потерях аудиодекодера во время обучения при использовании этого подхода.
Процесс амортизированного обучения. Магистральный трансформер моделирует нулевой уровень для всех кадров (выделено синим), в то время как декодер предсказывает остальные N – 31 уровней, но только для случайной 1/16 части кадров (выделено зеленым). В верхней части выделены конкретные кадры, моделируемые декодером, для которых он получает потери.
Эксперименты
Набор данных: Мы используем большой набор общедоступных аудиозаписей, которые мы транскрибируем, размечаем по спикерам и сегментируем. После фильтрации набор данных состоит примерно из одного миллиона часов преимущественно англоязычного аудио.
Размеры моделей: Мы обучили три модели разного размера, различающиеся размерами магистрали и декодера:
- Tiny: магистраль 1B, декодер 100M
- Small: магистраль 3B, декодер 250M
- Medium: магистраль 8B, декодер 300M
Каждая модель обучалась с длиной последовательности 2048 (~2 минуты аудио) в течение пяти эпох.
Примеры
Паралингвистика
00:00
00:00
00:00
00:00
Предложения из Base TTS
Иностранные слова
00:00
00:00
00:00
00:00
Предложения из Base TTS
Контекстуальная выразительность
00:00
00:00
00:00
00:00
Примеры из Expresso, продолжение после звукового сигнала
Исправление произношения
00:00
00:00
00:00
00:00
Предложение с исправлением произношения является записью, все остальное аудио сгенерировано.
Разговоры с несколькими говорящими
00:00
00:00
Одиночная генерация с использованием аудиоподсказок от двух говорящих
Оценка
Наш комплекс оценки измеряет производительность модели по четырем ключевым аспектам: точность передачи текста, использование контекста, просодия и задержка. Мы представляем как объективные, так и субъективные метрики — объективные тесты включают частоту ошибок в словах (WER) и новые тесты, такие как разрешение омографов, в то время как субъективная оценка опирается на исследование с участием людей по сравнительной средней оценке (CMOS) с использованием набора данных Expresso.
Объективные метрики
Традиционные тесты, такие как частота ошибок в словах (WER) и сходство голоса (SIM), стали насыщенными — современные модели, включая CSM, теперь достигают почти человеческого уровня производительности по этим метрикам.
Результаты объективных метрик для тестов частоты ошибок в словах (вверху) и сходства голоса (внизу), показывающие, что метрики насыщены (соответствуют человеческой производительности).
Чтобы лучше оценить произношение и понимание контекста, мы представляем новый набор тестов, основанных на фонетической транскрипции.
- Понимание текста через разрешение омографов: оценивает, правильно ли модель произносит разные слова с одинаковым написанием (например, “lead” /lɛd/ как в “металл” против “lead” /liːd/ как в “вести”).
- Понимание аудио через последовательность продолжения произношения: оценивает, сохраняет ли модель последовательность произношения конкретного слова с несколькими вариантами произношения в многоходовой речи. Одним из примеров является “route” (/raʊt/ или /ruːt/), которое может варьироваться в зависимости от региона говорящего и контекста.
Результаты объективных метрик для тестов разрешения омографов (слева) и последовательности произношения (справа), показывающие процент точности правильного произношения каждой модели. Генерации Play.ht, Elevenlabs и OpenAI были сделаны с настройками по умолчанию и голосами из документации их соответствующих API.
На графике выше сравниваются результаты объективных метрик для трех размеров моделей. Для точности омографов мы сгенерировали 200 речевых образцов, охватывающих 5 различных омографов — lead, bass, tear, wound, row — с 2 вариантами для каждого, и оценили последовательность произношения с использованием wav2vec2-lv-60-espeak-cv-ft. Для последовательности произношения мы сгенерировали 200 речевых образцов, охватывающих 10 различных слов, имеющих общие варианты произношения — aunt, data, envelope, mobile, route, vase, either, adult, often, caramel.
В целом мы наблюдаем, что производительность улучшается с увеличением размера моделей, что подтверждает нашу гипотезу о том, что масштабирование улучшает синтез более реалистичной речи.
Субъективные метрики
Мы провели два исследования по сравнительной средней оценке (CMOS) с использованием набора данных , чтобы оценить естественность и просодическую уместность сгенерированной речи для CSM-Medium. Оценщикам-людям были представлены пары аудиообразцов — один, сгенерированный моделью, и другой, являющийся эталонной записью человека. Слушатели оценивали сгенерированный образец по 7-балльной шкале предпочтений относительно эталона. Разнообразные выразительные образцы TTS из Expresso, включая эмоциональные и просодические вариации, делают его сильным эталоном для оценки уместности контексту.
В первом исследовании CMOS мы представили сгенерированные и человеческие аудиообразцы без контекста и попросили слушателей “выбрать, какое исполнение больше похоже на человеческую речь”. Во втором исследовании CMOS мы также предоставили предыдущие 90 секунд аудио и текстового контекста и попросили слушателей “выбрать, какое исполнение кажется более подходящим продолжением разговора”. Восемьдесят человек получили оплату за участие в оценке и оценили в среднем по 15 примеров каждый.
Результаты субъективной оценки на наборе данных Expresso. Без контекста: слушатели выбирали, “какое исполнение больше похоже на человеческую речь”, не зная контекста. С контекстом: слушатели выбирали, “какое исполнение кажется более подходящим продолжением разговора” при наличии аудио- и текстового контекста. Соотношение побед и поражений 50:50 предполагает, что у слушателей нет явных предпочтений.
На графике выше показан процент побед эталонных человеческих записей по сравнению со сгенерированными CSM речевыми образцами для обоих исследований. Без разговорного контекста (вверху) оценщики-люди не показывают явных предпочтений между сгенерированной и реальной речью, что предполагает, что естественность достигла предела. Однако, когда контекст включен (внизу), оценщики последовательно отдают предпочтение оригинальным записям. Эти результаты показывают, что заметный разрыв между сгенерированной и человеческой просодией в разговорной генерации речи сохраняется.
Открытый исходный код нашей работы
Мы считаем, что развитие разговорного ИИ должно быть совместным усилием. С этой целью мы стремимся к открытому исходному коду ключевых компонентов наших исследований, позволяя сообществу экспериментировать, развивать и улучшать наш подход. Наши модели будут доступны по лицензии Apache 2.0.
Ограничения и будущие задачи
В настоящее время CSM обучается преимущественно на англоязычных данных; некоторые многоязычные способности проявляются из-за загрязнения набора данных, но модель пока работает недостаточно хорошо. Она также не использует информацию, содержащуюся в весах предварительно обученных языковых моделей.
В ближайшие месяцы мы намерены увеличить размер модели, объем набора данных и расширить поддержку языков до более чем 20. Мы также планируем изучить способы использования предварительно обученных языковых моделей, работая над созданием больших мультимодальных моделей, обладающих глубокими знаниями как в области речи, так и в области текста.
В конечном счете, хотя CSM генерирует высококачественную разговорную просодию, она может моделировать только текстовое и речевое содержание разговора, а не структуру самого разговора. Человеческое общение — это сложный процесс, включающий очередность реплик, паузы, темп и многое другое. Мы верим, что будущее ИИ-диалогов заключается в полностью дуплексных моделях, способных неявно изучать эту динамику на основе данных. Эти модели потребуют фундаментальных изменений во всем стеке, от подготовки данных до методологий постобучения, и мы рады двигаться в этих направлениях.
Присоединяйтесь к нам
Если вы хотите создавать самые естественные, приятные и вдохновляющие голосовые интерфейсы, свяжитесь с нами — мы нанимаем сотрудников. Ознакомьтесь с нашими открытыми вакансиями.