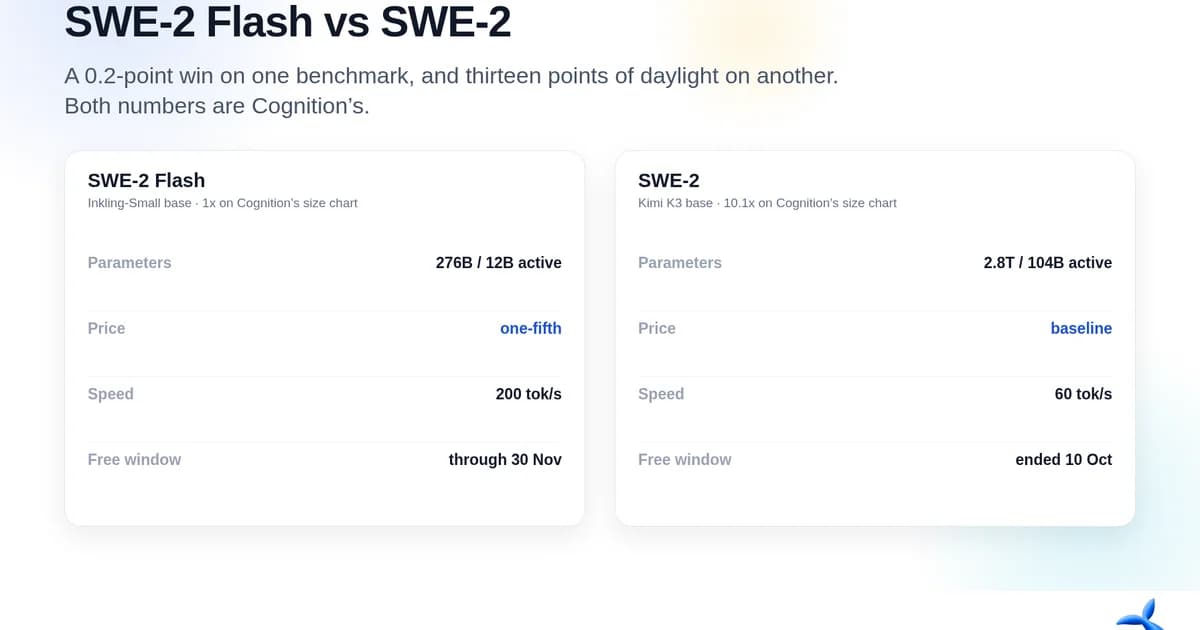
Собственная сравнительная таблица Cognition дает SWE-2 Flash ровно одну победу над SWE-2: 24,0 против 23,8 на FrontierCode 2.0. Две десятые балла в собственном бенчмарке Cognition в таблице, созданной для демонстрации меньшей модели в лучшем свете. Это также самое полезное число в релизе из-за того, что делают строки под ним, и из-за того, что строка выше линии сгиба умалчивает.
Краткая версия для тех, кто принимает решение за рабочим столом, а не читает статью до конца: Flash — это не уменьшенная копия SWE-2. Это другая модель на другой базе, оптимизированная для ограниченного объема работ и оцениваемая в пять раз дешевле в рамках того же продукта. Победа с отрывом в 0,2 балла реальна, но значит меньше, чем кажется.
Две редакции одного бенчмарка противоречат друг другу, и это первое открытие
Поставьте две строки FrontierCode рядом, и таблица перестанет быть историей о том, как маленькая модель догоняет старшую.
• FrontierCode 2.0 — SWE-2 Flash 24.0 против SWE-2 23.8
• FrontierCode 1.1 Main — 45.5 против 50.0
Тот же инструмент, две редакции, противоположные вердикты. В новой редакции Flash немного впереди; в старой — отстает на 4,5 балла. Одна из этих строк попадет на презентационный слайд, а другая нет, и выбор говорит о докладчике больше, чем о модели.
Существует вполне обоснованная точка зрения, согласно которой обе строки верны и не противоречат друг другу: редакция 2.0 сложнее, абсолютные оценки сжимаются, а новый набор задач может поощрять то, под что Flash дообучался. Есть и менее лестный взгляд: скачок на 4,5 балла между двумя редакциями одного бенчмарка показывает, насколько чувствителен сам инструмент, а разница в 0,2 балла находится в пределах этой чувствительности. Cognition не публикует доверительные интервалы и результаты повторных запусков, поэтому при имеющейся информации разницу между 24,0 и 23,8 невозможно отличить от шума. То, что можно утверждать, звучит более узко, но все же полезно: в новейшем бенчмарке Cognition обе модели идут наравне, а не разделены.
Куда деваются тринадцать баллов
Остальная часть таблицы не показывает близких результатов, и форма этого разрыва является самой информативной частью.
• DeepSWE 1.1 — SWE-2 Flash 60.1 против SWE-2 73.0
• Terminal-Bench 4.0 — 20.0 против 27.3
• SWE-Atlas QA — 50.0 против 56.3
• Terminal-Bench 2.1 — 89.2 против 92.8
• SWE-Bench Pro v2 Hard — 89.9 против 90.6
• ExploitBench — 34.8 против 36.1
Если упорядочить их по степени свободы, которую задача дает агенту, проявится закономерность. В SWE-Bench Pro v2 Hard — четко определенной проблеме с заданным исправлением — Flash отстает на 0,7 балла. В Terminal-Bench 2.1 отставание составляет 3,6 балла. В Terminal-Bench 4.0 разрыв равен 7,3, а в DeepSWE 1.1, задаче на долгосрочное планирование, — 12,9. Чем сильнее задача требует от модели самостоятельного принятия решений о дальнейших действиях, тем шире разрыв.
Это правдоподобный механизм, но не доказанный. Модель с десятой долей активных параметров имеет меньше возможностей удерживать в памяти долгий план, и в бенчмарках на долгосрочное планирование это проявляется в первую очередь. Однако Cognition не публикует количество шагов, токенов или разбивку по задачам для Flash так, как это делалось для SWE-2 — где сообщалось о падении среднего количества шагов со 127 до 53 при среднем уровне усилий, — поэтому механизм выводится из формы таблицы, а не демонстрируется напрямую. Воспринимайте это как гипотезу, которая либо совпадает с вашим опытом, либо нет.
Цена и скорость в единственной валюте, которую указывает Cognition
У ни одной из моделей нет цены за токен, поскольку у них нет эндпоинта. Cognition публикует соотношение: SWE-2 Flash стоит в пять раз дешевле SWE-2 и работает в три раза быстрее — 200 токенов/с против 60. Обе цифры получены с использованием одной и той же методологии воспроизведения: прогон каждой модели на задаче gsea-proteomics из Terminal-Bench 4.0, воспроизведенный с симулированной скоростью и сокращенными до равной длины стенограммами. Таким образом, обе цифры описывают целевой профиль обслуживания, а не измеренный.
Тем не менее это соотношение является наиболее важным для принятия решений числом в релизе, если сделать следующий шаг. Цена за единицу работы не равна стоимости решения задачи, а второе — это то, за что команда платит на самом деле. Если эта пятая часть является пятой частью стоимости задачи — единственное толкование, при котором это утверждение имеет смысл в рамках продукта по подписке, — тогда арифметика проста.
• В DeepSWE 1.1 — Flash решает 82% задач при пятой части стоимости, что примерно в 4,1 раза дешевле в расчете на решенную задачу даже в худшей для нее строке.
• Во FrontierCode 2.0 — она решает чуть больше задач при пятой части стоимости, что примерно в 5 раз дешевле в расчете на решенную задачу.
• В Terminal-Bench 4.0 — она решает 73% задач при пятой части стоимости, что примерно в 3,7 раза дешевле в расчете на решенную задачу.
Каждая из этих цифр предполагает, что коэффициент одной пятой применяется к стоимости задачи, а не токена, и что показатели успешности решения переносятся на вашу очередь. Cognition не уточняет это, и сделанное допущение играет здесь ключевую роль. Если эта пятая часть — цена токена для модели, которая генерирует больше токенов на задачу, преимущество сокращается и может поменяться на противоположное в долгосрочных задачах. Эта арифметика является проверкой на чувствительность, а не измерением, и ее следует переспросить под ваши собственные логи.
Что не вызывает сомнений, так это промо-окно. SWE-2 Flash бесплатен в Devin Desktop и CLI до 30 ноября 2026 года. Собственное бесплатное окно SWE-2 закрылось 10 октября. В течение следующих нескольких недель сравнение цен внутри Devin выглядит как одна пятая против нуля, что вообще не является сравнением — это период оценки с дедлайном.
Они не принадлежат к одной линейке, и разница в параметрах — это самое неинтересное в них
SWE-2 дообучена на базе Kimi K3: 2,8 триллиона параметров, 104 млрд активных на токен, база, которая уже прошла масштабное обучение с подкреплением для агентного программирования. SWE-2 Flash дообучена на базе Inkling-Small: 276 млрд всего, 12 млрд активных, Apache 2.0 от Thinking Machines. Собственная таблица размеров Cognition оценивает Flash в 1x, а SWE-2 в 10,1x. По активным параметрам соотношение ближе к девяти к одному.
Теперь сопоставим это с результатами. Разница в активных параметрах более чем в восемь с половиной раз дает 4,5 балла на FrontierCode 1.1 Main и абсолютно ничего на FrontierCode 2.0. Между тем сам этап пост-тренинга имеет гораздо большую ценность, чем разница в параметрах: таблица Cognition показывает Inkling-Small на уровне 21,5 на FrontierCode 1.1 Main и Flash на уровне 45,5 — прирост на 24 балла за счет промежуточного обучения и RL на той же базе. Дисперсия, обусловленная пост-тренингом, примерно в пять раз превышает дисперсию, обусловленную всей разницей в параметрах между двумя моделями.
Это вывод, который пара моделей выдает совместно, и он масштабнее любой из них по отдельности. Он также объясняет, почему Cognition готова продавать меньшую модель за пятую часть цены: дорогой частью SWE-2 никогда не была базовая модель. Это были данные, верификаторы и среды для RL, а Flash использует эти инвестиции повторно на более дешевой базе.
Здесь стоит сделать два предостережения. Это сравнение представляет собой таблицу одного поставщика, основанную на бенчмарках, которые он сам контролирует, и ни один из этих результатов не был независимо воспроизведен. Кроме того, базовые модели не являются эквивалентными входными данными: Kimi K3 обладает контекстным окном в миллион токенов и встроенной поддержкой зрения, в то время как Inkling-Small имеет другую архитектуру с иной поддержкой мультимодальности. Таким образом, формулировка «то же обучение, более дешевая база» — это позиция Cognition, а не изолированная переменная.
Асимметрия настройки усилий
SWE-2 поставлялся с тремя задокументированными уровнями сложности рассуждений — средним, высоким и максимальным, — и в сентябрьском анонсе Cognition объяснялось назначение каждого из них: средний уровень быстрее переходит к действиям, тогда как высокий и максимальный уровни больше планируют, глубже исследуют кодовую базу и тратят больше ресурсов на проверку. Также было заявлено, что для каждой модели приводился лучший результат среди всех настроек усилий.
Для SWE-2 Flash не задокументировано никаких настроек усилий. В анонсе о них не упоминается, а в таблице бенчмарков нет столбца с настройками. Таким образом, опубликованное сравнение представляет собой SWE-2 в лучшем виде против Flash в неуказанной конфигурации. Это корректное сравнение только в том случае, если у Flash есть лишь одна настройка, и некорректное в неизвестную сторону, если их несколько.
Если у Flash действительно нет контроля усилий, это различие в продукте, которое стоит назвать, а не пробел в документации. Усилия — это способ обменять стоимость на глубину для каждой конкретной задачи, и модель без этой функции дает вам одну настройку для очереди, содержащей как тривиальную, так и сложную работу. Это именно тот компромисс, который, как предполагается, позволяет делать соотношение стоимости.
В какую очередь попадает каждая из них
Собственная формулировка Cognition здесь является самым честным ориентиром. В ней говорится, что модели меньшего размера «все чаще способны справляться со значительной частью работы, которую выполняют программные агенты, такой как автоматизация, проверка кода, разработка функций и обновление документации», и что SWE-2 Flash была разработана именно для этой работы. Сопоставьте этот список с характером бенчмарков, и они совпадут: ограниченные задачи, четкое определение завершенности, большой объем, низкая терпимость к задержкам.
• Если задача помещается в промпт и определение завершенности однозначно — проверка кода, обновление документации, небольшая функция, запланированная автоматизация, — Flash является правильным выбором по умолчанию, а приведенная выше арифметика стоимости решенной задачи показывает, что она в несколько раз дешевле, даже если решает меньше задач.
• Если агенту приходится решать, что делать дальше, более нескольких раз — миграция, рефакторинг между репозиториями, сессия отладки, где первая гипотеза обычно неверна, — то разрыв в 13 пунктов в DeepSWE — это именно то, что вы покупаете вместе с SWE-2, и соотношение стоимости не компенсирует это.
• Если вы не можете определить, к какому типу относится задача, начните ее на Flash и при необходимости повысьте уровень. Именно для этого Cognition создала уровни усилий в SWE-2, а отсутствие контроля усилий у Flash делает повышение уровня скорее решением о маршрутизации, чем параметром.
Ошибка, которой следует избегать, — это использование преимущества в 0,2 балла как оправдания для перемещения сложной очереди. Это один бенчмарк, одна версия, один поставщик, и результат находится в пределах чувствительности самого инструмента.
Помимо Devin, ни одна из них не является кандидатом
Ни у одной из моделей нет API. Ни у одной нет публичных весов. Если ваш инструментарий — ваш собственный, то выбор между ними сделать невозможно, и бесплатное окно вам не поможет — это пробная версия внутри продукта, который вы должны купить.
Доступная часть этого стека — это база. Kimi K3 маршрутизируется через OrcaRouter как kimi/kimi-k3 по цене $3,00 за миллион входных токенов и $15,00 за миллион выходных токенов, с контекстным окном в 1 млн токенов и встроенным вызовом инструментов, по прейскуранту провайдера без наценок. Один API охватывает более 200 моделей, что делает разделение очередей, описанное выше, реализуемым вне Devin: правило маршрутизации может отправлять ограниченные задачи дешевой модели и перенаправлять долгосрочные задания более мощной, без ведома клиента о том, кто именно дал ответ. Автоматическое переключение при сбое должно находиться за путем с повышенным уровнем сложности, потому что модель, на которую вы переключаетесь, — это та, чья недоступность для вас критична.
Это другой продукт, отличный от SWE-2 Flash, и он не является его заменой. Это то, что вы делаете, когда у того, что вы хотите оценить, нет конечной точки.
Что могло бы прояснить ситуацию
Три раскрытия информации превратили бы это сравнение из таблицы поставщика в доказательство. Независимый запуск DeepSWE 1.1 и Terminal-Bench 4.0 на обеих моделях кем-то, кто не является Cognition и не использует инструментарий Cognition. Заявление о настройке усилий и каркасе (scaffold) для каждой строки в таблице Flash, соответствующее тому, что было предоставлено при запуске SWE-2. И повторный запуск, чтобы можно было отличить разницу в 0,2 балла от случайных отклонений между запусками.
До тех пор единственно обоснованной интерпретацией остается узкая. SWE-2 Flash — это оптимизированный по стоимости «родственник», построенный на гораздо меньшей базе, находящийся на одном уровне с SWE-2 в новейшем бенчмарке и явно отстающий в долгосрочной работе, продаваемый с соотношением, которое делает его в несколько раз дешевле в пересчете на решенную задачу, согласно имеющимся данным. Это хорошее продуктовое решение и скромная техническая претензия. Преимущество в 0,2 балла не является доказательством того, что она что-то заменила — это доказательство того, что на одном инструменте, в один день, разрыв сократился настолько, что растворился в шуме.