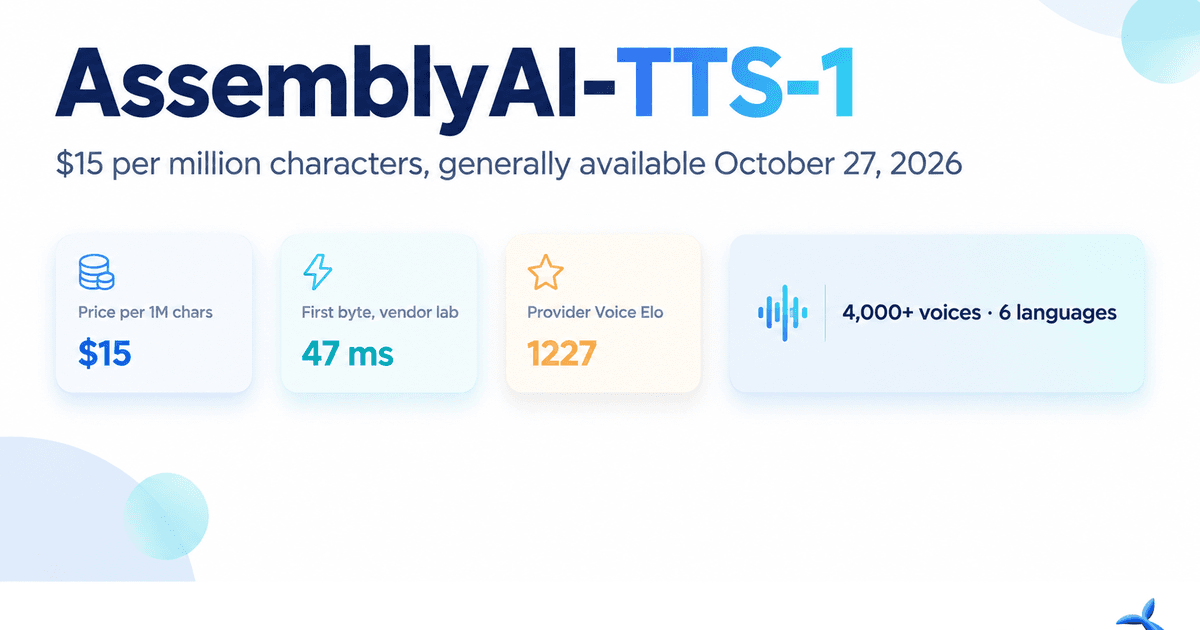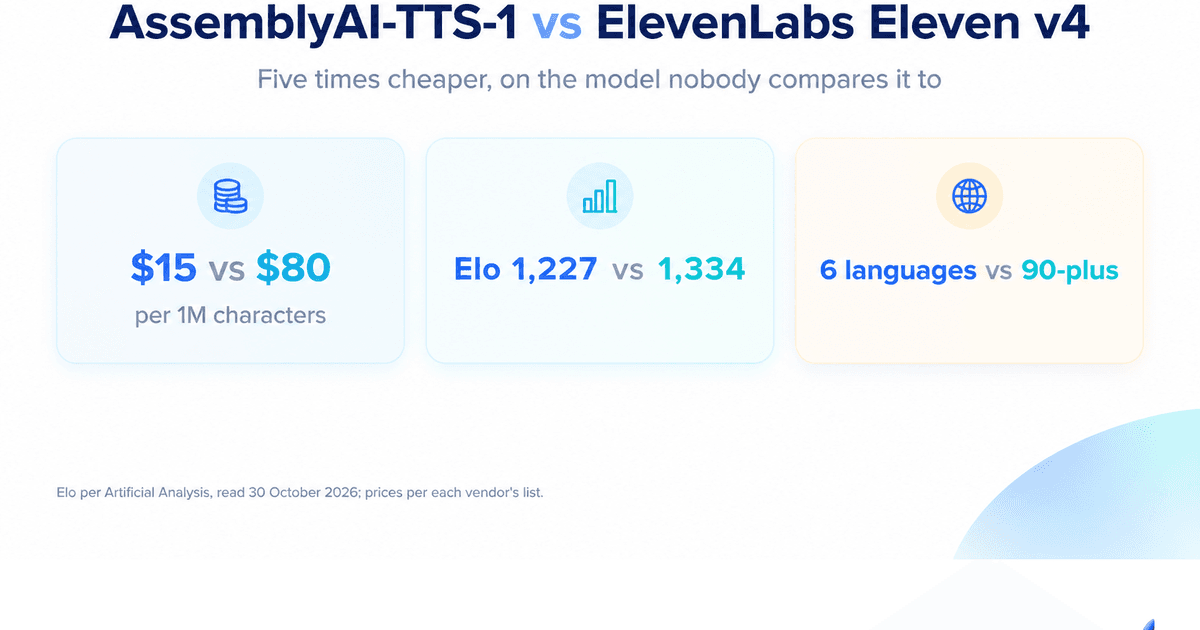
AssemblyAI-TTS-1 стоит 15 долларов за миллион символов. ElevenLabs Eleven v4 — 80 долларов. Это соотношение — 5,3 раза — является главным заголовком в любой статье об их сравнении, и в то же время это самый бесполезный показатель, поскольку модель, которую вы действительно установите в качестве основы для телефонного агента — это не Eleven v4. Это Eleven v4 Turbo стоимостью 40 долларов за миллион символов или Flash v2.5 по той же цене. С учетом этого скидка составляет уже 2,7 раза, а по сравнению с Flash v2.5 — низколатентным аналогом, который ElevenLabs продает ровно для этой задачи — AssemblyAI-TTS-1 вообще не борется со старым лидером рынка. Обе модели вышли за последние пять недель. Обе были созданы для одного и того же клиента. Но одна из них оплачивает верхнюю планку качества, с которой вторая решила не конкурировать.
Таблица цен работает эффективнее таблицы бенчмарков
Модель AssemblyAI-TTS-1 стала общедоступной 27 октября 2026 года, а результаты ее оценки были опубликованы днем позже. Ее тарифная сетка необычно проста: 15 долларов за миллион входных символов, включая пробелы и знаки препинания, и этот единственный тариф распространяется на каждый голос из библиотеки, насчитывающей более 4 000 вариантов, на каждый язык релиза, мгновенное клонирование голоса, пословные метки времени, а также на обработку данных в США или ЕС. Здесь нет платы за каждый отдельный голос, уровней параллелизма или годовых контрактов, а поставщик заявляет, что цена за символ остается неизменной независимо от того, запускаете ли вы десять одновременных звонков или десять тысяч.
Тарифы ElevenLabs разделены по моделям. Eleven v4, анонсированная 28 сентября 2026 года, стоит 0,08 доллара за тысячу символов — 80 долларов за миллион. Eleven v4 Turbo и Flash v2.5 стоят 0,04 доллара за тысячу, или 40 долларов за миллион. Благодаря промоакции в честь запуска цена v4 была снижена на 72% до 12 октября 2026 года; этот период завершился, поэтому 80 долларов — это та сумма, которую вам выставят на самом деле.
Переведем оба варианта в единицы измерения, которые использует команда голосовых агентов при составлении бюджета. При обычной скорости речи около 150 слов в минуту и примерно шести символах на слово, включая пробелы, минута готовой речи составляет около 900 символов. Это оценка, а не данные поставщика, но она достаточно близка к реальности, чтобы увидеть общую картину расходов:
• Один час непрерывной речи — около 54 000 символов — стоит примерно 0,81 доллара на AssemblyAI-TTS-1, 4,32 доллара на Eleven v4 и 2,16 доллара на Eleven v4 Turbo.
• Сто тысяч трехминутных звонков — 300 000 минут, примерно 270 миллионов символов — обойдутся примерно в 4 050 долларов на AssemblyAI-TTS-1, 21 600 долларов на Eleven v4 и 10 800 долларов на Eleven v4 Turbo.
• Разница между AssemblyAI-TTS-1 и Eleven v4 Turbo при такой рабочей нагрузке составляет 6 750 долларов в месяц при одинаковом объеме звонков. По сравнению с Eleven v4 она составляет 17 550 долларов.
Это и есть реальное решение, и оно довольно прозаично: вы выбираете, стоит ли прирост качества 6 750 долларов в месяц при ста тысячах звонков. Все остальное в этом сравнении сводится к тому, насколько велик этот прирост на самом деле.
В слепом прослушивании это дает измеримый результат. Платформа Provider Voice Arena от Artificial Analysis по состоянию на 30 октября 2026 года ставит Eleven v4 Turbo на первое место с показателем 1,336 Elo, а Eleven v4 — на второе с 1,334, в то время как AssemblyAI-TTS-1 находится на четырнадцатом месте с 1,227. Разрыв в 107 пунктов в этой шкале — не случайность, интервалы не пересекаются. На платформе Controlled Voice Arena, где эталонная запись фиксируется, чтобы сравнение касалось точности клонирования, а не стандартных голосов, AssemblyAI-TTS-1 занимает десятое место с результатом 1,110.
Остальная часть разрыва заключается в наборе голосов и средствах управления, и она больше, чем кажется судя по разнице в рейтинге Elo:
• Языки — AssemblyAI-TTS-1 на запуске поддерживала шесть: английский, испанский, французский, немецкий, итальянский и португальский, каждый с несколькими акцентами. Eleven v4 охватывает более 90 языков с родными акцентами, а не с чтением иностранных слов англоговорящим диктором.
• Библиотека голосов — более 4 000 в AssemblyAI-TTS-1 против более чем 17 500 заявленных для Eleven v4.
• Клонирование — только мгновенное клонирование в AssemblyAI-TTS-1 на основе образца, который, по демонстрации поставщика, занимает 24 секунды. Eleven v4 сочетает мгновенное клонирование длительностью от десяти секунд с профессиональным клонированием голоса (Professional Voice Cloning), которое вернулось в версии v4 после отсутствия в v3. Существующие профессиональные клоны могут потребовать переобучения под v4.
• Элементы управления — AssemblyAI-TTS-1 поставляется без разметки SSML, параметра скорости, словаря произношений и тегов эмоций. В релизной статье прямо указано, что знаки препинания и письменные проявления речевой неплавности читаются так, как написаны, а паузы задаются с помощью промптов, а не разметки. Eleven v4 поддерживает встроенные теги аудио, которые можно комбинировать — [смеется], [шепчет] — и ограничение в 10 000 символов на запрос.
• Вывод и интеграция — AssemblyAI-TTS-1 осуществляет потоковую передачу по WebSocket и HTTP, предоставляет эндпоинт, совместимый с OpenAI, передает пословные метки времени, поддерживает сообщение об отмене для прерывания речи (barge-in) и публикует эталонные реализации агентов для LiveKit и Pipecat. Eleven v4 продается через ElevenAPI, ElevenAgents и ElevenCreative под идентификаторами моделей eleven_v4 и eleven_v4_turbo.
Воспринимайте этот список как описание продукта, а не как табло с результатами. AssemblyAI создала эндпоинт синтеза речи для одной задачи — быстро, корректно и по фиксированной цене озвучивать реплику диалога в телефонной линии — и сознательно исключила студийные элементы управления. ElevenLabs продолжила развивать голосовую платформу. Если ваш продукт — это дубляж, закадровое озвучивание или корпоративный голос, который требует обучения и администрирования, эндпоинт с шестью языками не подходит независимо от цены.
Показатели задержки различаются втрое, и оба заслуживают доверия
Это та часть сравнения, которую большинство обзоров понимает неправильно, причем в обе стороны. В релизной статье AssemblyAI заявлено 90 мс до первого аудио в продакшене и медианное время до первого байта в 47 мс в собственных лабораторных тестах, что описывается как лучший результат среди шести моделей. В опубликованной ими таблице прямого сравнения ElevenLabs Flash v2.5 указана с результатом 119 мс, Cartesia Sonic 3.6 — 143 мс, Inworld TTS-2 Flash — 244 мс, Inworld TTS-2 — 280 мс, а ElevenLabs v4 — 612 мс. Собственная документация ElevenLabs заявляет медианное время до первой речи около 150 мс и медианную задержку инференса около 100 мс для Turbo.
Затем независимая тестовая компания Cekura замерила медианную задержку потоковой передачи AssemblyAI-TTS-1 на уровне 159 мс (восьмое место из девятнадцати протестированных моделей), со значением 171 мс в медиане при отправке полного текста и 296 мс на уровне p90. Это не опровержение заявленных поставщиком 47 мс. Это секундомер другого типа: AssemblyAI измеряет время от запроса до первого байта, а Cekura — от отправки последнего слова до вывода первого аудио. Голосовой агент, обрабатывающий диалог, больше заботится о втором замере, поскольку LLM должна сначала завершить генерацию предложения.
Таким образом, объективный вывод заключается в том, что по собственной методологии вендора AssemblyAI-TTS-1 является самым быстрым решением в сравнении, а ElevenLabs v4 — самым медленным с большим отрывом, в то время как по независимой методологии, ориентированной на агентов, AssemblyAI-TTS-1 занимает среднюю позицию, и как его заявления, так и заявления ElevenLabs следует считать неподтвержденными для вашего сценария телефонии. Единственное сравнение задержки, которое выдерживает критику — это сравнение с Flash v2.5, то есть с той версией SKU от ElevenLabs, которая создана для победы в этом споре и задержка которой, по измерениям третьих сторон, составляет в продакшене примерно от 185 до 197 мс. AssemblyAI-TTS-1 с показателем 159 мс работает быстрее и при этом обходится в 2,7 раза дешевле. Это единственный случай в данном сравнении, когда более дешевый и более быстрый варианты совпадают.
Где AssemblyAI-TTS-1 ломается в первую очередь
Не по скорости и не по цене. На длинном хвосте фраз, которые произносит реальный пользователь.
Результаты Cekura по категориям ставят AssemblyAI-TTS-1 на первое место по телефонным номерам и кодам с результатом 91,7%, на четвертое место по естественности с показателем 4,50 и на двадцать второе место из двадцати семи по контекстному произношению с результатом 70,8%. Artificial Analysis также оценивает общую надежность произношения в 81,7% (шестнадцатое место среди оцененных моделей), причем самый слабый субрейтинг приходится на расшифровку аббревиатур — 73,8%. Лидерборд Coval оценивает коэффициент ошибок в словах (WER) в 1,7%, что на три десятых процента отстает от лидера, но опережает Eleven v4 Turbo и Cartesia Sonic 3.6 (1,8%), а также Deepgram Aura-2 (1,9%).
Если сопоставить эти данные, вырисовывается конкретный сценарий сбоя: эта модель очень хорошо читает числа вслух и заметно хуже справляется с принятием решений о том, как должны произноситься аббревиатуры, адреса или коды учетных записей. Это как раз тот тип ошибок, который исправляется словарем произношений, но у AssemblyAI-TTS-1 его пока нет. Если ваш агент зачитывает идентификаторы заказов, вы покупаете модель, чья лучшая функция покрывает эту задачу, а худшая является тем фактором, обойти который через настройки вы не сможете.
Ответ ElevenLabs на ту же проблему — это не более высокие баллы, а более тонкая настройка: словари, теги, скорость и профессиональный клон, обученный на вашем собственном референсе. Вы платите на $65 больше за миллион символов за возможность самостоятельно исправить этот «хвост».
Вторая половина агента все еще оплачивается по другому счету
TTS-модель никогда не работает в голосовом агенте в одиночку. Она функционирует в связке с языковой моделью, которая формирует предложение, и в большинстве архитектур эта языковая модель составляет большую статью расходов и имеет более нестабильные отношения с поставщиком. Именно этот уровень охватывает OrcaRouter: единый API для более чем 200 моделей по прайс-листу провайдера с 0% наценкой, автоматическое переключение при сбое в работе провайдера, DSL маршрутизации для объединения моделей в один вызов, а также слияние моделей, когда одного ответа недостаточно.
Два честных предостережения. Во-первых, AssemblyAI-TTS-1 на данный момент отсутствует в каталоге OrcaRouter (мы поддерживаем голосовые маршруты tts-1, tts-1-hd и gpt-4o-mini-tts от OpenAI и превью Gemini TTS от Google), так что это не призыв купить модель именно здесь. Во-вторых, и это более полезно: поскольку наценка равна нулю, а цены провайдеров транслируются напрямую, снижение цен вендором для любой используемой вами TTS-модели отразится в вашем счете в тот же день. Именно этот механизм делает переход между тарифными уровнями с $80 на $40 стоящим внимания, а не просто чтения новостей.
Что делать в понедельник
Три вопроса помогут определиться с выбором быстрее любого бенчмарка.
Нужно ли вашему агенту говорить на языке, выходящем за рамки шести языков, с которыми запустилась AssemblyAI-TTS-1? Тогда сравнение окончено, и выбор падает не на качество, а на покрытие языков. Дождитесь расширения списка языков или платите ElevenLabs.
Читает ли ваш агент вслух клиенту идентификаторы, коды или адреса? Тогда протестируйте AssemblyAI-TTS-1 на собственных строках, прежде чем принимать окончательное решение, поскольку независимые показатели произношения — это самая слабая часть ее характеристик, а возможности обойти ограничения через настройки пока не существует. Заявленная вендором точность распознавания сущностей в 93,7% на собственном наборе из 580 элементов (против 93,6% у Eleven v4 и 68,0% у Flash v2.5 по данным самого вендора, которые не были воспроизведены независимыми тестами) говорит об абсолютно противоположном по сравнению с контекстной оценкой Cekura. Одно из этих двух значений измеряет нагрузку для вашего сценария, но какое именно — вы не знаете.
Является ли ваш голос уникальным, обученным и защищенным? Тогда выбор падает на ElevenLabs, практически без обсуждений. Мгновенное клонирование из 24-секундного семпла позволяет получить пригодный идентификатор голоса, но оно не создает актив бренда, который можно юридически защитить.
Если ответы таковы: шесть языков, нет и нет (телефонный агент масштабируемого уровня, обрабатывающий обычные диалоговые реплики), то AssemblyAI-TTS-1 за $15 с неограниченным уровнем одновременных запросов и отсутствием платы за параллельность является более дешевым и, судя по независимым измерениям задержки, более быстрым вариантом, а разница в качестве в 107 баллов по шкале Elo слепых предпоччений — это не то, за что стоит переплачивать $6 750 в месяц. Разместите ее за системой отказоустойчивости, протестируйте на записях собственных звонков в течение месяца и держите Flash v2.5 в качестве резервного варианта на тот день, когда ваш массив данных окажется полон аббревиатур.
Вот и все сравнение. Один вендор продает потолок возможностей, а другой — базовый уровень, оба оценены соответственно, и единственная дорогая ошибка, которую здесь можно совершить — это купить потолок для рабочей нагрузки, которая до него никогда не дотягивает.