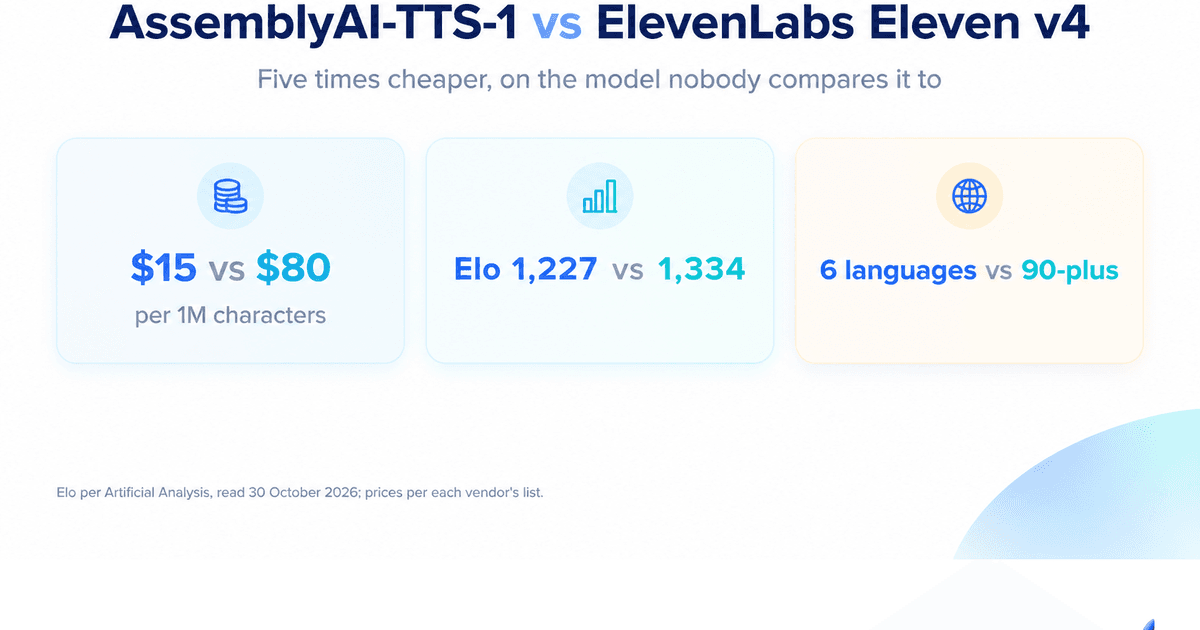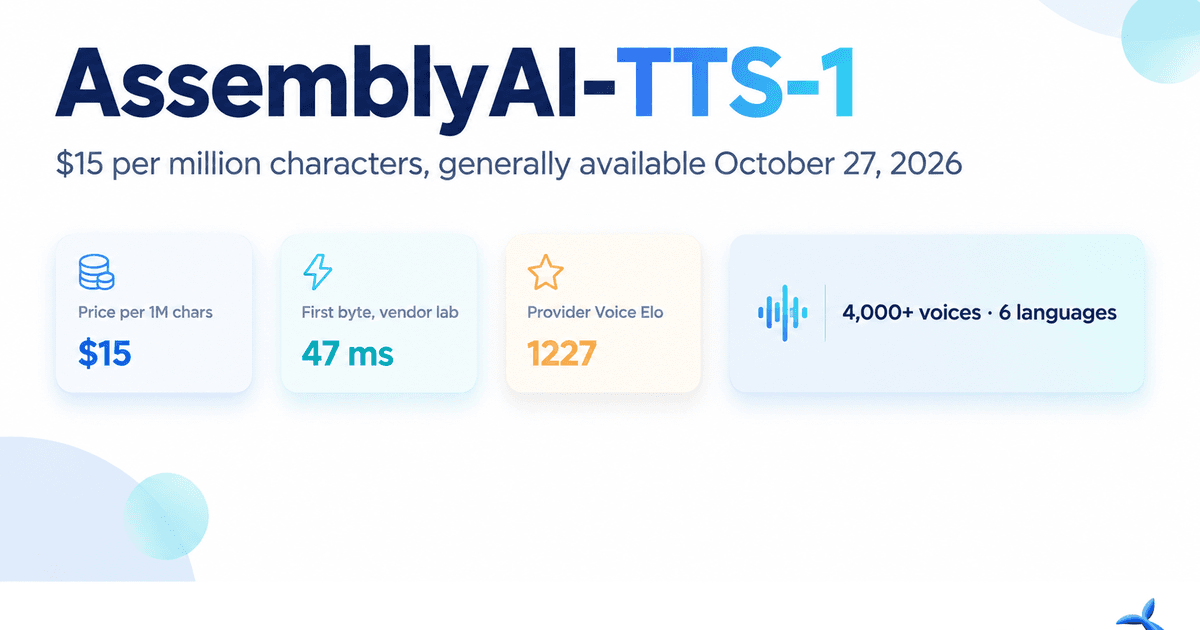
Модель AssemblyAI-TTS-1 стала общедоступной 27 октября 2026 года по цене $15 за миллион входящих символов. При этом значение, которое действительно имеет значение, — это не цифра в заголовке, а результат деления. При нормальном темпе речи около 15 символов в секунду миллион символов составляет примерно 18 часов готового аудио, что выводит стоимость модели примерно на 81 цент за час речи. Cartesia Sonic 3.6, предыдущий лидер по скорости, выставляет счет в $49 за миллион символов (около $2,70 в час). ElevenLabs v4 стоит $80 (около $4,40 в час). Это первая самостоятельная модель преобразования текста в речь от AssemblyAI (до этой недели компания занималась исключительно распознаванием речи) и она вышла на рынок, где лидер взимает за ту же работу в три-пять раз больше.
Это утверждение требует немедленной оговорки, поскольку три разные стороны предоставляют три разных типа данных. Цена взята из официального прайс-листа самой AssemblyAI и проверяется на ее странице цен. Показатель задержки получен в ходе лабораторных испытаний, проведенных AssemblyAI против пяти конкурирующих провайдеров на 30 промптах, в три раунда, по четыре стандартных голоса на модель, по одному запросу за раз. Место в таблице лидеров принадлежит сервису Artificial Analysis и измерено независимо. Что касается оценок качества самой AssemblyAI (точность в отношении сущностей, прогнозируемая MOS, просодия, схожесть при клонировании), то они заявлены самим вендором, и никто за пределами AssemblyAI их не воспроизводил. Единственное по-настоящему независимое измерение задержки указывает на результаты, которые выглядят скромнее маркетинговых заявлений, и с этого стоит начать.
Спецификации на одном экране
• Цена — $15 за миллион входящих символов, оплата за текст с учетом пробелов и знаков препинания, все библиотечные голоса и все языки включены, без платы за конкретный голос или одновременность запросов
• Голоса — более 4 000 в библиотеке, а также мгновенное клонирование по короткому эталонному образцу (в демо использовалось 24 секунды аудио)
• Языки — английский, испанский, французский, немецкий, итальянский, португальский на момент запуска, несколько акцентов, дата выхода следующего пакета не названа
• Задержка — 90 мс до первого аудио для продакшена (описано компанией как консервативная оценка); 47 мс медианного времени до первого байта в собственном лабораторном сравнении
• Пропускная способность — 162 символа в секунду по версии Artificial Analysis, опережая Cartesia Sonic 3.6 с показателем 148,6
• Интерфейсы — HTTP, WebSocket с сообщением об отмене для прерывания (barge-in) и маршрут, совместимый с OpenAI; поставляются эталонные агенты LiveKit и Pipecat
• Вывод — PCM, mu-law и A-law с частотой от 8 до 48 кГц, нативная частота 24 кГц, временные метки на уровне слов возвращаются вместе с аудио
• Размещение и лимиты — обработка в США или ЕС по той же цене, неограниченная одновременность по модели pay-as-you-go, без годового контракта или покупки тарифов
• Чего пока нет — нет SSML, нет параметра скорости, нет словарей произношения, нет тегов эмоций, нет дообучаемого клонирования уровня «про»
Два этих пункта выполняют больше коммерческой работы, чем все остальные. Неограниченная параллельность по базовой цене избавляет от необходимости переговоров, которые большинство вендоров TTS навязывают создателям высоконагруженных голосовых агентов, где тарифы на одновременность запросов могут превышать плату за символы. А тарификация с учетом пробелов и знаков препинания честна, но не бесплатна: скрипт из 1 000 слов насчитывает около 6 000 символов с учетом пробелов и запятых, поэтому эффективная цена за произнесенное слово выше, чем предполагает поверхностное сравнение с ценой за слово. AssemblyAI этого не скрывает (на странице цен это указано прямо), но именно такая деталь превращает трехкратную разницу в заголовке в 2,7-кратную на реальном скрипте.
Почему цифра в 47 мс имеет такой большой вес
В анонсе на первом месте стоит скорость, и сопутствующий тест информативнее большинства сравнений от вендоров, поскольку в нем указаны конкуренты и методология. Медианное время до первого байта, один клиент, последовательные запросы: AssemblyAI-TTS-1 — 47 мс, ElevenLabs Flash v2.5 — 119 мс, Cartesia Sonic 3.6 — 143 мс, Inworld TTS-2 Flash — 244 мс, Inworld TTS-2 — 280 мс, ElevenLabs v4 — 612 мс. Если принять эти условия, AssemblyAI не просто быстра — она примерно в три раза быстрее до первого байта, чем Cartesia Sonic 3.6, с которой она конкурирует по цене, и в два с половиной раза быстрее ElevenLabs Flash v2.5.
Чего этот тест не может показать, так это поведение системы под нагрузкой. Один клиент, отправляющий по одному запросу за раз, оценивает модель, а не сервис: нет очереди, нет борьбы за параллельность, нет холодных стартов, нет сетевых скачков между регионами. Цифра в 90 мс для продакшена — это попытка самой компании учесть эти факторы, и разница между 47 и 90 мс примерно равна реальным издержкам, которые лабораторный тест не видит. Любой, кто запускал масштабные голосовые агенты, узнает в этом стандартный подход маркетинга TTS-задержек: красивый лабораторный показатель для слайда с бенчмарками, более мягкая цифра для продакшена и третья цифра, которая всплывает только тогда, когда вы оказываетесь в публичной сети далеко от эндпоинта.
Эта третья цифра теперь существует, и она хуже. Cekura, независимая организация по оценке голосовых агентов, замерила медианную задержку потоковой передачи в 159 мс для AssemblyAI-TTS-1 на своем тестовом наборе предложений в стиле агентов, что поместило модель на восьмое место из девятнадцати вместо первого. Cekura также оценила точность чтения в 81,5% (что по сути находится на уровне ElevenLabs v4 с 80,4%), при этом поставив AssemblyAI на первое место по номерам телефонов и кодам с результатом 91,7% и на четвертое по естественности с 4,50. Если сопоставить оба источника, складывается четкая картина: AssemblyAI-TTS-1 действительно быстро начинает говорить, необычно хорошо справляется со сложными для произношения токенами и при этом не является самым быстрым решением, когда в дело вступает реальный потоковый маршрут.
Две площадки Artificial Analysis, две разные истории
Artificial Analysis ведет две таблицы TTS, и они измеряют разные вещи. В категории Provider Voice каждая модель говорит своими собственными нативными голосами; в категории Controlled Voice все модели используют одни и те же восемь клонированных голосов. Это различие — самое полезное, что есть в данном запуске, поскольку AssemblyAI-TTS-1 показывает себя лучше в контролируемой таблице, чем на собственном каталоге.
• Provider Voice — 1 227 Elo, 12-е место на старте, 1 626 оцененных появлений. Два дня спустя в живой таблице значится 1 227 и 14-е место: тот же балл, но ниже позиция, потому что выше поднялись две новые модели. Elo — стабильная величина, а рейтинг — движущаяся цель.
• Controlled Voice — 1 110 Elo, 10-е место на старте, 1 674 появления. В актуальной таблице теперь указано 1 108 и 10-е место.
• Надежность произношения — 81,7% по результатам 2 115 оцененных клипов, 16-е место в этой таблице.
• Скорость генерации — 162 символа в секунду.
Модель, которая занимает более высокие позиции среди клонированных голосов, чем в собственной библиотеке из 4 000 голосов, говорит о вполне конкретных вещах: акустика конкурентоспособна, а дизайн голосов еще не стал главным дифференцитором. Breeze TTS 2, лидирующая модель с открытыми весами, демонстрирует противоположную картину — сильна на провайдерских голосах и слаба на контролируемых, и именно это сравнение делает ситуацию интересной. AssemblyAI создала обширный, недорогой и компетентный каталог, но она еще не создала голоса, которые побеждают в слепых тестах прослушивания исключительно за счет собственных достоинств.
Смещение в рейтинге заслуживает упоминания по практической причине. Каждый агрегатор, освещающий этот запуск, цитирует фразу «топ-12 в категории Provider Voice» из анонса Artificial Analysis, и к тому моменту, когда вы это прочитаете, тот же балл может оказаться на 15-м или 16-м месте. Это не означает, что AssemblyAI теряет в качестве. Это таблица лидеров, где горстка очков Эло разделяет пять мест и куда новые записи добавляются почти каждую неделю. Оценивайте рейтинг Эло, обратите внимание на дату прочтения и не воспринимайте падение на два места как регресс.
Где оценки вендора выглядят убедительно, а где нет
AssemblyAI опубликовала более полный набор цифр, чем большинство релизов TTS, причем все они получены в ходе собственной работы и протестированы на 50 общих клонированных голосах со сгенерированным аудио, распознанным обратно через ее распознаватель Universal-3.5 Pro. Методология разумна: закольцовывание аудио через модель ASR является разумным прокси для разборчивости, — но это все же тест, который поставщик разработал и оценил сам.
• Точность передачи сущностей на сложных объектах (номера телефонов, URL-адреса, коды подтверждения, названия лекарств) — 93,7% для AssemblyAI-TTS-1, 93,6% для ElevenLabs v4, 82,5% для Cartesia Sonic 3.6, 68,0% для ElevenLabs Flash v2.5. Десятая доля процента преимущества над ElevenLabs v4 — это ничья в маскарадном костюме победителя; 11-процентный отрыв от Sonic 3.6 — это реальный результат.
• Точность распознавания слов — 99,0%, что настолько близко к потолку, что перестает служить различием между хорошими моделями.
• Прогнозируемый MOS — 3,85, и здесь AssemblyAI проигрывает: Inworld TTS-2 Flash набирает 3,88 по той же шкале, Cartesia Sonic 3.6 — 3,82, а обе модели ElevenLabs находятся ниже них. Собственная таблица вендора не выводит его на первое место.
• Просодия TTSDS — 85,5, показатель без базового уровня сравнения между вендорами в публикации.
• Сходство с клонированным спикером — 0,64, что является низким показателем для мгновенного клонирования и соответствует размещению на контролируемой арене, а не у реального провайдера.
Честное резюме этой таблицы оказывается более узким, чем рекламный текст запуска: AssemblyAI-TTS-1 отлично справляется со сложными строками, конкурентоспособен по разборчивости, занимает средние позиции по естественности и является наиболее слабым в плане голосовой идентичности при клонировании. Для голосового ассистента, зачитывающего номера счетов и почтовые индексы, первая строчка — это то, за что платят. Для надиктованной аудиокниги или голоса персонажа последние две строчки имеют решающее значение, и эта модель не подходит.
Чего она еще не умеет и во сколько это вам обходится
Пробелы в функционале обычны для первого релиза и необычайно важны для этой категории. Здесь нет SSML, поэтому нет надежного способа принудительно сделать паузу, сделать акцент или изменить произношение без переписывания текста. Отсутствует параметр скорости, что означает необходимость регулировать темп выше по потоку путем генерации большего или меньшего количества слов. Нет пользовательских словарей произношений, несмотря на то, что точность сущностей является главной сильной стороной: когда модель действительно неправильно произносит название бренда, вы не можете передать ей лексикон, вы можете только переписать текст и надеяться на лучшее. Теги эмоций и тонко настроенное профессиональное клонирование находятся в статусе «скоро» по собственным словам вендора, а заголовок «родные эмоции» на странице запуска неловко соседствует с разделом часто задаваемых вопросов (FAQ), в котором говорится, что выделенные элементы управления эмоциями недоступны.
Языковой охват — более серьезное ограничение. Шесть языков на момент запуска против 44 у Cartesia Sonic 3.6 и заявленных 50 у Breeze TTS 2 — с той оговоркой, что карточка модели самого Breeze отмечает только английский и китайский. Если вашему агенту нужно ответить немецкоязычному и португалоязычному абонентам на той же неделе, AssemblyAI охватывает оба языка. Если требуется польский, японский или арабский, то нет, и никаких дат названо не было.
Как ее получить на практике
AssemblyAI-TTS-1 предоставляется через собственный API вендора (HTTP, WebSocket и OpenAI-совместимая конечная точка) с хостами в США и ЕС по той же цене, плюс кредитная линия на 50 долларов при регистрации и указанная схема оплаты по мере использования (pay-as-you-go). Помимо этого, она доступна через несколько сторонних платформ. Ее пока нет в каталоге OrcaRouter, и мы не будем притворяться, что это так; если она нужна вам на этой неделе, прямой путь — это API вендора.
То, что действительно беспокоит нас в этом запуске, — это форма решения, которую он создает. Голосовой ассистент представляет собой конвейер из трех моделей (распознавание речи, языковая модель, синтез речи), и компонент TTS теперь обладает самым широким разбросом цен и самыми новыми участниками. Это именно тот компонент, для которого вам нужен второй вариант, подключенный до того, как вы возьмете на себя обязательства, потому что совершенно новая модель с тестом задержки от единственного клиента и без независимого нагрузочного тестирования — это классический пример модуля, который должен находиться за механизмом переключения при сбое (fallback). Маршрутизация более 200 моделей через один API с наценкой 0% — это то, чем мы занимаемся: прейскурантная цена вендора передается напрямую, так что снижение цены вступает в силу в тот же день, а автоматическое переключение при сбое гарантирует, что неудачный день у одного провайдера не выведет агента из строя. Модели TTS, которые мы маршрутизируем сегодня, — это tts-1, tts-1-hd и gpt-4o-mini-tts от OpenAI наряду с Gemini 3.1 Flash TTS Preview от Google, что служит надежным вторым звеном, пока AssemblyAI-TTS-1 доказывает свою состоятельность под вашим трафиком, а не в тепличных условиях.
Что изменило бы вынесенный вердикт
Три вещи в порядке значимости их влияния на решение. Во-первых, независимый запуск для проверки задержки в условиях реальной конкуренции: показатель потоковой передачи Cekura в 159 мс — это пока единственное внешнее измерение, и это одна цифра от одной лаборатории. Вторая лаборатория, воспроизводящая преимущество в 47 мс до первого байта — или не воспроизводящая его, — позволила бы выяснить, выживет ли заявление о скорости при столкновении с очередью. Во-вторых, словарь произношений. Точность сущностей — лучший аргумент в пользу модели, и в то же время это та способность, которую в продакшене с наибольшей вероятностью сведет на нет название продукта, с которым модель никогда не сталкивалась. Доставка словарей превращает победу в бенчмарке в операционную победу. В-третьих, будут ли шесть языков расти по тому же графику, что и остальная часть дорожной карты, поскольку ценовое преимущество усиливается только в том случае, если языковой охват догоняет остальные показатели.
До тех пор, пока это не произойдет, правильная трактовка этого запуска является узкой и полезной: AssemblyAI-TTS-1 — это самый дешевый заслуживающий доверия API TTS на рынке от вендора с десятилетним опытом в области речевой инфраструктуры, он работает быстро в лаборатории и достаточно быстро в единственном существующем внешнем тесте, он читает сложные строки лучше, чем любая из сравниваемых моделей, и при этом занимает средние позиции по естественности и слаб в плане клонированной идентичности. Это отличная покупка для агентов с высоким объемом звонков на шести языках и преждевременная покупка для всего, что требует уникального голоса.