Стоит ли Kimi K3.1 Pro заменять модель, управляющую вашим агентом, или работать вместе с ней? Мы сравнили её с Kimi K3 и ведущими альтернативами с использованием созданных практиками бенчмарков в Specialized Intelligence Index (SII), оценив производительность задач, стоимость модели и время выполнения.
K3.1 Pro набирает больше баллов, чем K3, в четырнадцати из семнадцати общих бенчмарков, причем улучшения включают в себя большее количество выполненных задач по устаревшему коду и более точные действия в банковской поддержке клиентов. По сравнению с другими ведущими моделями возможности различаются: она приближается к показателю Claude Opus 5.5 в веб-исследованиях при существенно меньшей стоимости модели, однако её более высокий процент успешности в банковской сфере сопровождается большими затратами и длительным ожиданием.
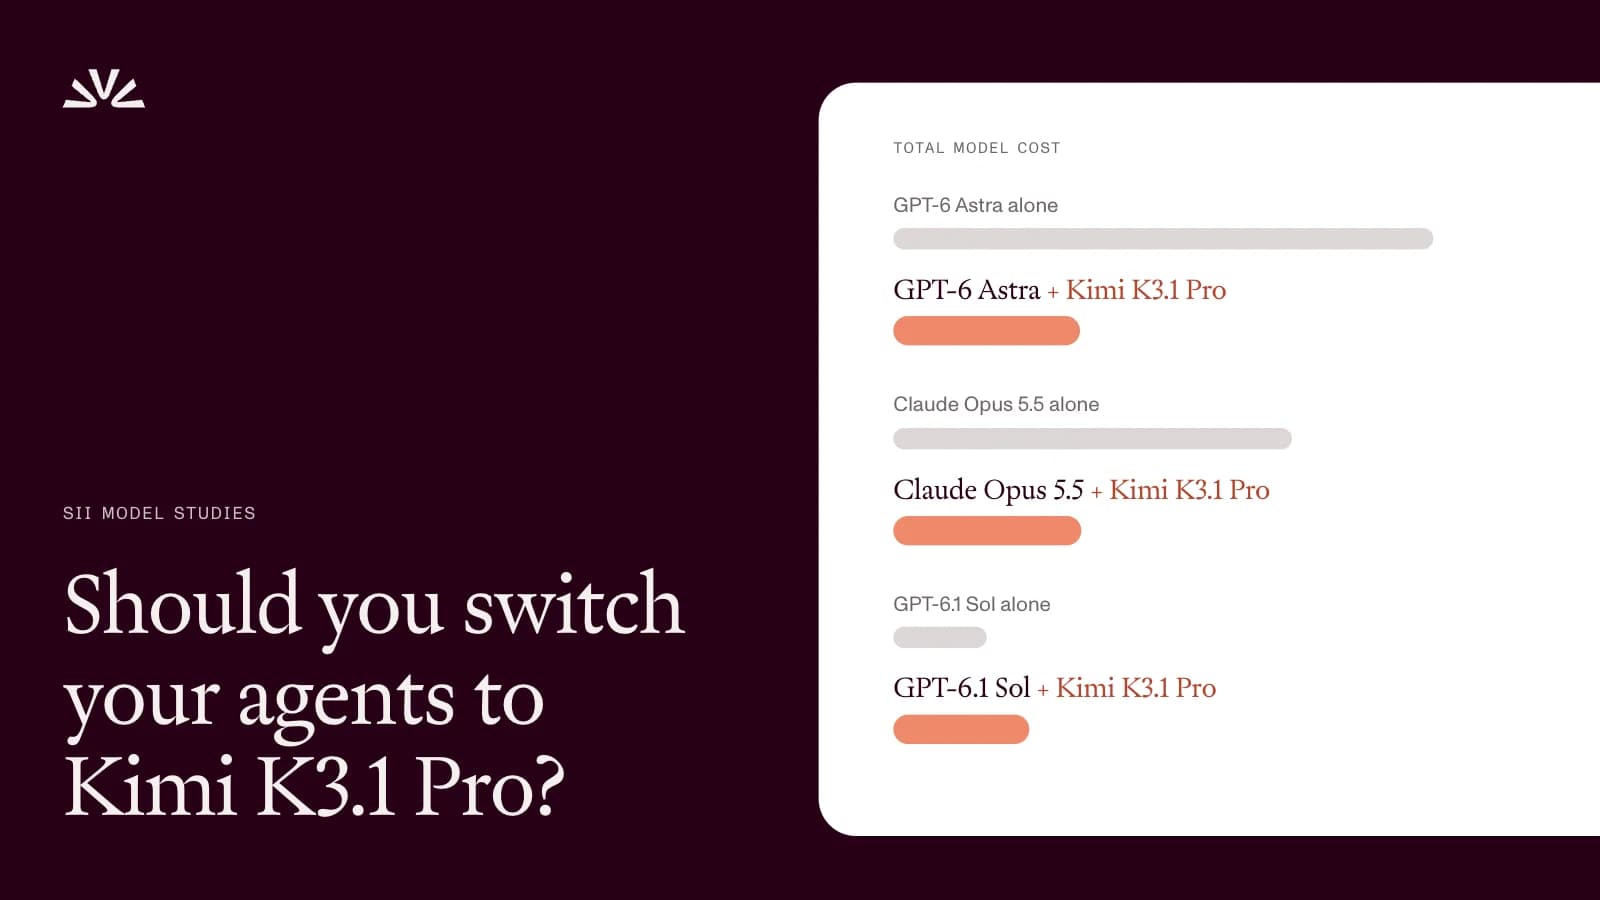
Эти различия также открывают возможности для объединения сильных сторон моделей. В наших симуляциях маршрутизации распределение работы между K3.1 Pro и GPT-6 Astra или GPT-6.1 Sol давало более высокие суммарные результаты, чем любая модель по отдельности. Сочетание с Opus сократило расходы на модель более чем вдвое. Полученные результаты помогают определить, где стоит рассматривать K3.1 Pro в качестве замены, а где сохранение другой модели для некоторых задач может принести больше пользы.
Исследование опирается на 21 лидерборд бенчмарков, сравнивая K3.1 Pro с её предшественницей и другими моделями по качеству, стоимости модели и времени выполнения (где это применимо). Мы более подробно изучили результаты задач и трассировки агентов по четырем направлениям: τ³-Banking от Sierra для службы поддержки в банках, CorporateBench от Epiq для корпоративных записей и электронной почты, Big Finance Benchmark от Rogo для финансовых исследований и Legacy-Bench от Factory для поддержки устаревшего кода. Результаты этих задач также лежат в основе симуляций маршрутизации. Letta и Surge AI предоставили дополнительные аналитические материалы по созданию памяти и поведению в области программной инженерии соответственно. Подробности оценки см. в разделах «Методология» и «Ограничения».
K3.1 Pro набирает больше баллов, чем K3, в четырнадцати из семнадцати общих бенчмарков. Анализ на уровне задач показывает как больший объем выполненной работы, так и более точные действия, но также и регресс в создании памяти и проверке контрактов.
Поддержка устаревшего кода. Legacy-Bench от Factory проверяет исправление ошибок, добавление функций и миграцию в старых языках и средах, включая COBOL, Fortran и Java 7. K3.1 Pro выполняет на 15% больше задач, чем K3, с процентом выполнения 62.5% против 54.3% по тем же 97 задачам. Стоимость модели на 48% ниже, чем у K3.
Поддержка клиентов в банке. τ³-Banking от Sierra тестирует агентов, использующих банковские правила и инструменты управления счетами для обработки запросов клиентов. Просмотренные логи показывают, что K3.1 Pro более точно следует запросам: доля вызовов инструментов для изменения счетов, содержащих незапрошенные поля, снизилась примерно на 69% — с 8.5% у K3 до 2.6% у K3.1 Pro.
Отдельный пример делает последствия наглядными. В беседе, затрагивающей три банковские карты клиента, K3 заблокировала все три. K3.1 Pro заморозила карты, проверила транзакции и закрыла только ту, которая требовала закрытия, избежав ненужного закрытия двух других.
Создание памяти. FrontierMemory от Letta проверяет, может ли агент превратить записи о предыдущих попытках в память, которая поможет другому агенту решать задачи по программированию и интеллектуальной работе. Координирующий агент распределяет эти записи среди исполнителей, которые извлекают и сохраняют полезную информацию. Бенчмарк измеряет успешность выполнения задач последующим агентом с использованием этой памяти.
При создании памяти с помощью K3.1 Pro результат бенчмарка на 22% ниже, чем с K3. Просмотренные запуски выявляют потенциальную проблему, способствующую этому: K3.1 Pro оставляет множество исходных записей не распределенными между исполнителями.
K3.1 Pro проявила меньшую тщательность, чем K3, в этой координирующей роли. Она распределила лишь около 50-65% доступных записей, в то время как K3 распределила весь набор в двух запусках из трех. Для одной задачи с 22 записями K3.1 Pro распределила всего одну запись в одном запуске и ни одной в другом. Ни один из заходов не создал память для этой задачи, оставив последующего агента без преимуществ этих записей.
Проверка контрактов. Legal Agent Benchmark (LAB) тестирует задания, которые может получить юрист первого года работы в различных отраслях права. K3.1 Pro набирает на 18% больше баллов, чем K3, поднявшись с 13.1 до 15.4. Но в отдельном бенчмарке LAB: Contracts, который проверяет анализ контрактов, внесение правок и выявление проблем, её балл падает на 64% — с 8.3 до 3.0. Для команд, использующих K3 для проверки контрактов, общее улучшение LAB не является основанием для перехода.
Эти регрессии выступают против того, чтобы рассматривать K3.1 Pro в качестве автоматической замены K3 во всем приложении, даже если её общие показатели в бенчмарках выше.
Лидерборд возможностей параллельного поиска тестирует модели на сложных вопросах, требующих поиска в Интернете. K3.1 Pro обходится на 72% дешевле, чем Claude Opus 5.5 ($0.27 против $0.95 за вопрос), при этом ее балл ниже на 1.2 пункта (74.2 против 75.4). Для команд, использующих Opus для масштабных веб-исследований, это делает K3.1 Pro кандидатом на сокращение расходов на модель.
Финансовые исследования: GPT-6.1 Sol набирает больше баллов и стоит дешевле, чем K3.1 Pro
Big Finance Benchmark от Rogo измеряет, насколько точно модели отвечают на вопросы финансовых аналитиков с помощью исследовательских инструментов Rogo. K3.1 Pro соответствует результату Claude Opus 5.5 в 48.2% при снижении затрат на модель на 81% ($0.17 против $0.91 за вопрос). GPT-6.1 Sol набирает 52.0% примерно за $0.05 за вопрос, обеспечивая более высокий балл при стоимости примерно на 69% ниже, чем у K3.1 Pro. Среди этих моделей Sol предлагает более выгодное сочетание баллов и стоимости для данной рабочей нагрузки.
CorporateBench от Epiq проверяет, могут ли агенты реконструировать деятельность компании по архивам электронной почты четырех синтетических компаний. Задачи включают определение взаимоотношений подчиненности сотрудников, классификацию документов по темам и ответы на вопросы, требующие увязывания фактов из разных сообщений. Ответы сверяются с известными записями компаний, причем каждая компания и каждый навык имеют равный вес в общем балле.
K3.1 Pro получает более высокий средний балл, чем Claude Opus 5.5 (78.4 против 75.4), при снижении стоимости модели на 83% ($0.47 против $2.80 за задачу). GPT-6.1 Sol набирает больше баллов, чем обе модели (82.2), и стоит $0.41 за задачу.
Истории сотрудников — особая слабость. В 16 задачах, требующих от моделей реконструировать отношения подчиненности сотрудников и даты начала их ролей, K3.1 Pro набирает в среднем 78 баллов из 100 по сравнению с 96 у GPT-6 Astra и 93 у Sol. В просмотренных логах K3.1 Pro иногда делает вывод, что у сотрудника нет руководителя, так как ни в одном документе прямо не указано его имя. Astra же выводит эти отношения из косвенных свидетельств, например, к кому сотрудник обращается за указаниями.
Поддержка клиентов в банке: K3.1 Pro разрешает больше запросов, чем Opus 5.5, но с большими затратами и задержками
τ³-Banking от Sierra проверяет, могут ли агенты разрешать запросы клиентов, используя банковские правила и инструменты управления счетами. K3.1 Pro разрешает на 13% больше запросов, чем Claude Opus 5.5, выполняя 63.3% попыток против 56.0%.
Выше процент успешного выполнения сложных запросов. Бенчмарк включает 12 диалогов, с которыми не справились хотя бы в одном запуске 15 из 20 оцененных моделей. По результатам повторяющихся оценочных запусков, модель K3.1 Pro успешно завершила в среднем пять из этих 12 диалогов, в то время как ни одна другая модель не показала результат выше двух в среднем.
Изученные логи показывают, что K3.1 Pro более активно обращается к банковским инструкциям: в среднем фиксируется 22 обращения к базе знаний на один диалог по сравнению с 10–17 у других моделей, участвовавших в анализе. Это может частично объяснять ее эффективность при обработке сложных запросов, однако сами логи не доказывают, что именно дополнительные обращения обеспечили преимущество в завершении задач.
Более высокие затраты и большее время ожидания. K3.1 Pro обрабатывает примерно в три раза больше входных токенов на один диалог, чем Opus, что нивелирует выгоду от более низких цен на токены. Даже с учетом более высокого процента успешных завершений стоимость одной успешно решенной задачи составляет $1.51 для K3.1 Pro против $0.80 для Opus, что примерно на 89% дороже. Этот показатель рассчитывается путем деления общих расходов на модель (включая неудачные попытки) на количество успешных решений. Среднее время выполнения одной попытки также более чем в два раза выше.
Для службы поддержки дополнительные успешные решения могут оправдать более высокую стоимость, если они позволяют избежать дорогостоящего привлечения операторов-людей, однако большее время ожидания клиентов может сделать использование K3.1 Pro неприемлемым в условиях строгих требований к скорости ответа.
Программная инженерия: в 64% исследованных попыток выявленные риски остались нерешенными и о них не сообщалось
Агент по написанию кода может завершить запрошенные изменения, оставив проверяющего специалиста в неведении относительно проблемы, которую агент уже заметил. Компания Surge AI обнаружила эту закономерность у K3.1 Pro в ходе 256 программных задач, каждая из которых выполнялась по три раза: в 64% попыток модель выявляла риск в своих рассуждениях, но не устраняла его и не упоминала о нем в финальном ответе.
Surge AI имела доступ к полным рассуждениям K3.1 Pro, в то время как сравниваемые модели предоставляли только свои письменные рабочие заметки. По этой причине частота незаявленных рисков напрямую между моделями не сопоставима.
Отдельный бенчмарк sudo L7 от Surge AI оценивает изменения в производственных кодовых базах, включая то, что агент сообщает пользователю впоследствии. Процент успешных прохождений у K3.1 Pro на 37% выше, чем у K3, но она по-прежнему существенно отстает от Claude Opus 5.5 и Claude Sonnet 5.5: 16.7% против 45.6% и 50.6% соответственно. Более широкий поведенческий анализ не позволяет установить, насколько сильно незаявленные риски повлияли на этот результат.
Командам, оценивающим агентов для написания кода, помимо самого кода следует внимательно изучать и финальный ответ. Рецензентам необходимо, чтобы агент сообщал о важных проблемах, которые он заметил, но не исправил, дабы они могли принять решение о готовности изменений к релизу.
Бенчмарк ORCA от компании Traversal проверяет способность диагностировать инциденты в продакшене на основе логов, трассировок и метрик. K3.1 Pro занимает третье место, но определяет точную первопричину лишь в 32.9% случаев по сравнению с 44.3% у Claude Opus 5 (Opus 5.5 в ORCA не оценивался) и 50.2% у GPT-6 Astra. Позиция в таблице лидеров скрывает значительный разрыв: Astra определяет первопричину примерно в половине случаев, в то время как K3.1 Pro — примерно в трети.
Сравнение рабочих нагрузок демонстрирует как причины для использования K3.1 Pro, так и основания сохранить другую модель. Может ли объединение K3.1 Pro с вашей текущей моделью улучшить результаты по сравнению с использованием каждой модели по отдельности? Мы проверили это предположение в рамках симуляции маршрутизации.
Мы смоделировали три ансамбля из двух моделей на тех же 461 задаче, объединив K3.1 Pro по отдельности с Claude Opus 5.5, GPT-6 Astra и GPT-6.1 Sol. Маршрутизатор выбирал одну модель для обработки каждой задачи; модели не проверяли ответы друг друга и не переделывали чужие неудачные попытки.
Бенчмарки предоставили 24 категории задач. Для каждой задачи маршрутизатор выбирал модель на основе ее зафиксированных баллов и затрат по другим задачам в той же категории. Результат самой задачи исключался из этого решения.
Маршрутизатор сопоставлял показатели производительности в бенчмарках с затратами на модель, присваивая условную стоимость в $20 за каждый балл. Это позволяло выбирать более дорогую модель, когда ожидаемое улучшение результата оправдывало дополнительные расходы. Указанная сумма в $20 была допущением в рамках симуляции, а не лимитом расходов или измеренной ценностью для бизнеса.
Для каждой пары мы сравнили вариант использования существующей модели для всех 461 задач с вариантом маршрутизации каждой задачи либо на эту модель, либо на K3.1 Pro.
Пары с Astra и Sol набрали больше баллов, чем любая из моделей по отдельности. Мы провели повторную выборку набора задач 2,000 раз и пересчитали решения по маршрутизации, чтобы проверить, насколько этот результат зависел от оцениваемых задач. Преимущество сохранилось в 98% случаев повторной выборки для Astra и в 89% для Sol, что подтверждает обоснованность улучшения для пары с Astra. Пара с Opus превзошла один Opus в 99% случаев повторной выборки и стоила дешевле во всех из них, но она превзошла одну K3.1 Pro лишь в 55% случаев.
Источники прироста баллов и экономии
Корпоративные исследования. В бенчмарке CorporateBench от Epiq пара K3.1 Pro и Opus распределила семь категорий задач на K3.1 Pro, а за Opus закрепила все 16 вопросов о менеджерах сотрудников и датах начала работы, с которыми K3.1 Pro испытывала трудности. Вместе модели набрали суммарный балл около 100 из 128 (что на 11 пунктов выше, чем у одного Opus), при этом сократив расходы на модели с $358 до $100. Пара с Astra разделила задачи аналогичным образом, оставив за Astra вопросы об истории сотрудников.
Служба поддержки в банковской сфере. Все три пары направили все 97 диалогов на K3.1 Pro. Это позволило завершить больше запросов, чем при использовании только Opus, Astra или Sol. Расходы на банковские задачи выросли по сравнению с Opus и Sol, но снизились по сравнению с Astra.
Поддержка устаревшего кода. Пара с Astra направила 93 задачи из 97 на K3.1 Pro, а оставшиеся четыре — на Astra. Это позволило выполнить примерно на пять задач больше и одновременно сократить расходы на модели примерно на 82%: 61 задача за $43 против 56 задач за $235 при использовании одной Astra.
Эти результаты получены на основе симуляций с использованием записанных результатов и известных категорий задач. Продакшн-маршрутизатор должен будет получать или прогнозировать эти категории. Анализ методом повторной выборки измеряет вариативность в выборке задач, а не вариативность между запусками. Кроме того, в исследовании не проверялось, приносит ли K3.1 Pro дополнительную пользу в составе более крупного ансамбля, который уже осуществляет маршрутизацию между несколькими моделями.
Аргументы в пользу K3.1 Pro выглядят убедительнее, если внедрение подразумевает поручение ей полезной работы, а не повсеместную замену существующей модели. Выводы на уровне задач открывают возможности, которые упускаются при общем рейтинге: где более высокий балл сопровождается более высокими затратами, где слабость модели оправдывает сохранение другой модели и где объединение их сильных сторон улучшает результат. Это делает масштаб внедрения столь же важным, сколь и выбор самой модели.
Попробуйте K3.1 Pro на платформе Fireworks, чтобы оценить ее на вашей рабочей нагрузке, или изучите Fireworks Nexus, чтобы использовать ансамбль открытых и закрытых моделей в рамках ваших привычных инструментов для программирования и совместной работы.
Методология и ограничения
Охват бенчмарков и оценка
Результаты отражают состояние Индекса специализированного интеллекта (Specialized Intelligence Index) по данным на 9 ноября 2026 года. Охват бенчмарков, списки моделей и даты оценки различаются. Баллы сравниваются в рамках одних и тех же бенчмарков, определения успешности в которых различаются.
Анализ на уровне задач охватывает τ³-Banking от Sierra, Legacy-Bench от Factory, CorporateBench от Epiq и Big Finance Benchmark от Rogo. В исследовании используются 97 банковских диалогов, 97 задач по работе с устаревшим кодом (3 задачи не удалось собрать во всех моделях, поэтому они не включены), 128 вопросов CorporateBench и 139 вопросов по финансовым исследованиям. Для анализа маршрутизации каждая задача дает до одного балла к совокупной оценке. В CorporateBench сохраняется система частичного начисления баллов: оценка 0,75 дает 0,75 балла. Совокупная оценка представляет собой сумму баллов за задачи, усредненную по результатам запусков оценки.
Запуски оценки и поведенческий анализ
Обновленные результаты K3.1 Pro включают три запуска по поддержке клиентов в банковской сфере, Legacy-Bench и CorporateBench, а также три попытки на каждый вопрос в Big Finance. Поведенческие наблюдения из журналов агентов используют выбранные более ранние запуски; они иллюстрируют наблюдаемые действия и не устанавливают причину каждого различия в оценках.
Компания Letta предоставила анализ создания памяти на основе своей настройки, где оркестратор распределяет записи о предыдущих попытках выполнения задач между рабочими агентами, которые извлекают информацию для сохранения. Эти наблюдения касаются поведения K3.1 Pro в качестве оркестратора в этом рабочем процессе, а не его способности использовать память в целом.
Компания Surge AI предоставила анализ разработки программного обеспечения, охватывающий три запуска по 256 задачам, включая набор sudo L7 из 60 задач. Этот более широкий анализ отличается от оценки в таблице лидеров sudo L7. Сравнения, включающие видимые рассуждения и итоговые ответы, должны учитывать различия в том, что предоставляют поставщики.
Стоимость модели и время выполнения
K3.1 Pro работал на Fireworks; модели для сравнения работали через API своих поставщиков в разные даты. Стоимость моделей отражает зарегистрированное использование токенов в соответствии с ценообразованием и предположениями о кэшировании каждого бенчмарка, включая прейскурантные цены Fireworks для K3.1 Pro. Они исключают расходы на оценщиков и, где применимо, расходы на симуляцию клиентов. Различия во времени выполнения отражают условия обслуживания и настройки оценки, а также поведение модели. Схожие оценки сами по себе не устанавливают статистическую эквивалентность.
Для каждой задачи маршрутизатор сравнивал средние оценки моделей и стоимость моделей по другим задачам того же типа, оценивая каждый балл в 20 долларов. Результат самой задачи был исключен из решения. Совокупные оценки почти не менялись при изменении этого значения от 10 до 100 долларов, но расходы на модели менялись существенно. Указанная экономия в 53% и 65% использует настройку в 20 долларов. Симуляция использует записанные результаты, а не реальный трафик.
Неопределенность и ограничения
Анализ маршрутизации предполагает, что категории задач, определенные бенчмарком, доступны. Мы провели повторную выборку задач в рамках каждого бенчмарка и пересчитали решения по маршрутизации в каждой из 2000 повторных выборок, исключая каждую копию задачи, для которой выполняется маршрутизация, из решения по маршрутизации.
Пары GPT-6 Astra и GPT-6.1 Sol набрали больше баллов, чем обе составляющие модели по отдельности, в 98% и 89% повторных выборок соответственно. Для пары Claude Opus 5.5 90-процентный интервал варьировался от семи баллов ниже до восьми баллов выше, чем у K3.1 Pro в одиночку. Экономия затрат по сравнению с использованием только Opus оставалась надежной.
Оценка каждой задачи удерживалась на уровне среднего значения по запускам, поэтому эта проверка измеряет вариативность в выборке задач, а не изменчивость от запуска к запуску. Совокупные оценки округляются до целых чисел. Эта проверка не подтверждает классификацию запросов или маршрутизацию реального трафика.