Введение
Две недели назад мы представили Zyphra Hierarchical Attention (ZHA) — новый подход к разреженному вниманию, который позволяет преодолеть проблему квадратичного масштабирования стандартных трансформеров.
Основная идея ZHA проста: вместо поиска по всему KV-кэшу для определения того, какие токены релевантны конкретному запросу, мы строим иерархическое дерево сжатых сводок кэша. При выполнении внимания мы перемещаемся по этому дереву сверху вниз, сначала определяя релевантные крупные области контекста, а затем постепенно сужая поиск до тех пор, пока не дойдем до исходных ключей и значений.
Поскольку мы можем отбрасывать нерелевантные области, не изучая каждый содержащийся в них токен, объем работы, необходимой для поиска по контексту, может расти сублинейно по отношению к длине последовательности. Именно это отличает ZHA от методов разреженного внимания, таких как DSA или MSA, чьи индексаторы все еще должны сканировать весь контекст.
Особенно полезным свойством ZHA является то, что нам не нужно обучать новую языковую модель с нуля. Вместо этого мы можем преобразовать существующую предобученную модель, заморозив ее основу и обучив очень небольшой набор эталонных запросов для воспроизведения распределений внимания исходной модели. В нашей оригинальной статье мы продемонстрировали, что эта процедура позволяет сохранить производительность в сложных задачах математического рассуждения, извлечения данных из длинного контекста и агентного программирования, даже при использовании лишь малой части KV-кэша.
Однако эти эксперименты ограничивались относительно скромными моделями: Qwen3.6-35B-A3B и Nemotron-3.5-Lightning-30B-A3B. Естественный вопрос заключается в том, будет ли этот же подход работать для гораздо более крупных моделей пограничного масштаба. В частности, становится ли процесс преобразования сложнее по мере увеличения размера модели? Требует ли поддержание производительности все большей дистилляции? И, что, пожалуй, самое важное, действительно ли распределения внимания этих более крупных моделей поддерживают субаддитивное масштабирование, для использования которого и был разработан ZHA?
Чтобы ответить на эти вопросы, мы преобразовали несколько моделей с открытыми весами пограничного уровня, обладающих существенно различающимися архитектурами и историей обучения.
Важность масштабирования Top-p
Прежде чем обсуждать отдельные модели, полезно кратко вернуться к важной идее из нашей оригинальной статьи: взаимосвязи между разреженностью внимания и статистической структурой длинных последовательностей.
ZHA использует механизм выбора top-p для определения того, какие области контекста следует исследовать. Для заданного распределения внимания набор top-p — это наименьший набор токенов, совокупная вероятность внимания которых достигает определенного порога p.
Например, если небольшое количество токенов составляет 99% вероятности внимания, то набор top-0.99 будет небольшим. Если внимание распределено почти равномерно по всему контексту, то для восстановления 99% его вероятности потребуется сохранить примерно 99% токенов. Поэтому, в отличие от методов, которые выбирают фиксированное количество токенов, top-p позволяет объему извлечения адаптироваться к распределению внимания каждого запроса.
Это различие становится особенно важным при рассмотрении очень длинных контекстов. Предположим, что последовательность имеет длину N, а количество токенов, необходимое для захвата фиксированной доли вероятности внимания, растет примерно как N^α, где α < 1. В этом режиме объем информации, активно извлекаемой вниманием, продолжает увеличиваться по мере роста контекста, но медленнее, чем сам контекст. Это именно тот тип масштабирования, к которому мы стремимся: модель может получать доступ к возрастающему объему информации, не требуя фиксированной или увеличивающейся доли всей последовательности.
Напротив, если внимание становится приблизительно равномерным, набор top-p растет линейно вместе с N. Чтобы сохранить заданный объем вероятности внимания, мы должны извлекать постоянную долю всего контекста, что сводит на нет большую часть возможностей для субаддитивного масштабирования.
В нашем предыдущем блоге мы описали это как узкий путь к по-настоящему ультрадлинным контекстам. С одной стороны, мы не можем сжать контекст в представление фиксированного размера, не потеряв в конечном итоге полезную информацию. С другой стороны, мы не можем позволить себе извлекать приблизительно линейную долю произвольно длинного контекста для каждого запроса.
Наша гипотеза заключается в том, что объем прогностической информации, содержащейся в естественной последовательности, должен расти сублинейно по отношению к ее длине. Кривые масштабирования top-p модели дают эмпирическое представление о том, насколько успешно ее распределения внимания улавливают эту структуру. Это не прямое теоретико-информационное измерение, но они дают нам полезный способ изучения взаимосвязи между моделированием длинного контекста и вычислительной эффективностью.
Важным следствием является то, что субаддитивное внимание — это не просто архитектурное свойство. Даже при наличии теоретически субаддитивного алгоритма поиска его реальная эффективность зависит от структуры распределений внимания, по которым ведется поиск.
Как мы увидим, разные модели пограничного уровня демонстрируют удивительно разное поведение в этом отношении.
Масштабирование ZHA до моделей пограничного уровня
Мы преобразовали четыре существенно различающиеся модели: Qwen3.8-2.4T-A95B, Nemotron-3.5-Super, GPT-OSS-120B и MiMo-V2.6-Pro.
В совокупности эти модели позволяют нам изучить ZHA при различных масштабах параметров, схемах позиционного кодирования и архитектурах внимания, включая модели с RoPE и частичным RoPE, гибридные архитектуры NoPE и модели, сочетающие локальное и глобальное внимание.
Во всех этих экспериментах сама процедура преобразования работает исключительно хорошо. Большинство оценок остаются очень близкими к их исходным базовым показателям с полным вниманием, включая такие бенчмарки, как SWE-bench, LongBench v2 и RULER, которые требуют извлечения и использования информации из расширенных контекстов.
Различия становятся гораздо более выраженными, когда мы смотрим на структуру лежащих в основе распределений внимания и вычислительное масштабирование, которое они допускают.
Qwen3.8-2.4T-A95B: чистое масштабирование на уровне триллионов параметров
Мы начнем с Qwen3.8-2.4T-A95B, самой большой модели в наших экспериментах, с 2,4 триллионами общих параметров и примерно 95 миллиардами активных параметров. Эта модель является особенно серьезным испытанием того, может ли преобразование ZHA масштабироваться за пределы относительно небольших моделей, рассмотренных в нашей оригинальной работе.
Результаты на удивление хороши.
В сложных задачах извлечения из длинного контекста, математики и агентного программирования различия между моделью с полным вниманием и моделью, преобразованной с помощью ZHA, по сути, находятся на уровне шума. Даже при максимальной длине контекста в 1 млн токенов показатели RULER снижаются менее чем на два пункта, что находится в пределах распределения шума.
Это особенно обнадеживающий результат. Мы можем заменить механизм внимания модели с триллионами параметров, оставив предобученную основу полностью замороженной, и сохранить почти все ее возможности даже в оценках, требующих существенного извлечения информации на больших расстояниях.
Однако более интересный результат получается при изучении распределений внимания этой модели.
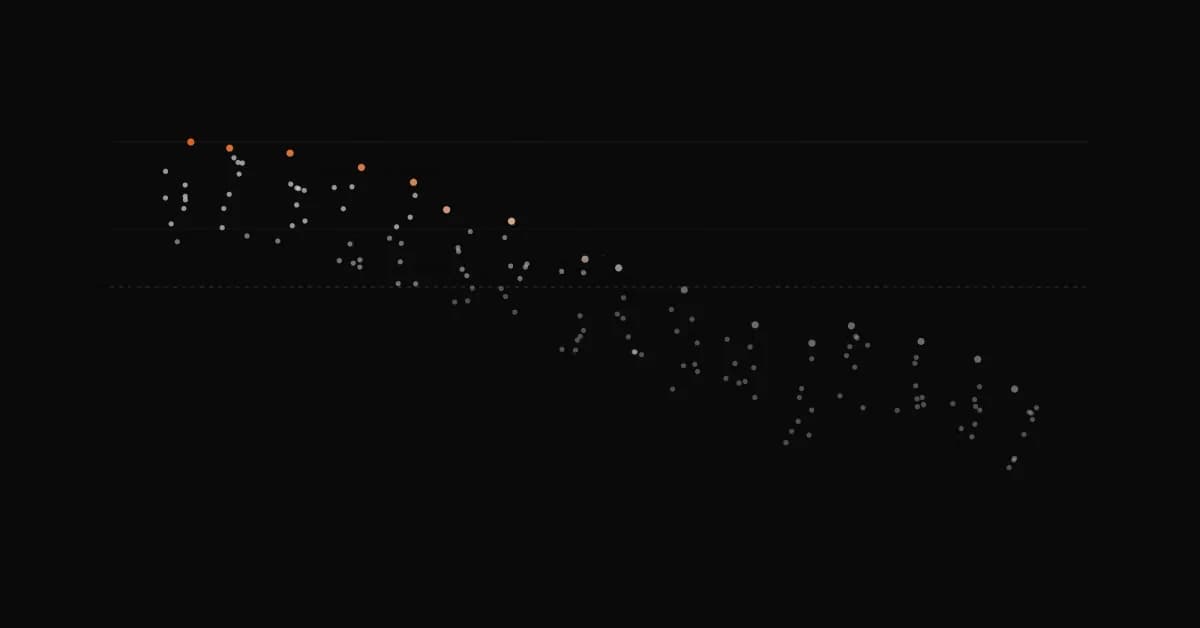
В широком диапазоне значений p размер соответствующего набора внимания увеличивается приблизительно по сублинейному степенному закону в зависимости от длины контекста. Кривые остаются плавными на протяжении нескольких порядков величины, без явных разрывов или изменений в характере масштабирования. Мы наблюдаем схожее поведение во всем семействе моделей Qwen, включая модели разных размеров и слои внимания.
Это именно тот тип структуры, который делает ZHA эффективным.
Когда набор top-p масштабируется сублинейно, последовательное уточнение нашего поиска по иерархии позволяет нам извлекать релевантную информацию, не просматривая линейную долю исходной последовательности. Соответственно, наши смоделированные затраты на внимание демонстрируют все более благоприятное масштабирование по сравнению с плотным вниманием по мере роста контекста.
В более широком смысле мы подозреваем, что это необычно чистое поведение степенного закона может быть ключевым признаком хорошо обученного механизма внимания для длинного контекста. Хорошо обученная модель должна уметь отличать релевантную информацию от растущего объема нерелевантного контекста, а не позволять вероятности внимания беспорядочно рассеиваться по большему количеству токенов. Плавное сублинейное масштабирование top-p согласуется с этим поведением.
Мы пока не знаем, является ли такое масштабирование универсальным и какие именно аспекты обучения Qwen отвечают за него. Тем не менее, это обнадеживающий пример структуры внимания, которая делает возможным эффективное моделирование ультрадлинного контекста.
Nemotron и MiMo: исключения из субодратичного масштабирования в ранних слоях
Хотя Qwen демонстрирует удивительно чистое масштабирование top-p во всех своих слоях внимания, не каждая модель ведет себя так хорошо.
Двумя особенно интересными примерами являются Nemotron-3.5-Super и MiMo-V2.6-Pro. Обе модели хорошо конвертируются в ZHA, сохраняя практически все свои исходные возможности, и обе демонстрируют благоприятное субодратичное масштабирование внимания в большинстве своих слоев.
Однако у них также есть общая любопытная закономерность: самые ранние слои внимания имеют значительно менее благоприятное масштабирование top-p, чем остальная часть модели. В Nemotron это происходит в первом слое внимания. В MiMo — в первых двух. В обоих случаях эти слои сходят с узкого пути к субодратичному масштабированию из-за почти линейного масштабирования top-p.
Nemotron-3.5-Super-120B-12A
Nemotron-3.5-Super — это передовая гибридная модель Mamba-Transformer, которая использует внимание без явного позиционного кодирования (NoPE).
Архитектуры NoPE интересны тем, что они демонстрируют способность моделей восстанавливать полезную позиционную информацию без явного применения RoPE или другого позиционного кодирования к своим запросам и ключам.
В нашей предыдущей работе о позиционной информации в гибридных моделях NoPE мы показали, как механизмы локального смешивания могут вводить неявную позиционную информацию в остаточный поток, которая затем может быть восстановлена последующими слоями глобального внимания.
Это делает Nemotron полезным тестом способности ZHA к обобщению за пределами моделей на основе RoPE, на которых проводилось большинство наших первоначальных экспериментов.
И снова результаты конвертации очень сильные. В целом качество конвертированной модели остается чрезвычайно близким к оригиналу.
Однако распределения внимания выявляют любопытную аномалию.
Большинство слоев внимания Nemotron демонстрируют то самое изящное субодратичное масштабирование, на которое мы надеялись. Однако первый слой полного внимания ведет себя совершенно иначе.
Его логиты внимания относительно равномерны по всей последовательности, с существенно меньшей концентрацией, чем наблюдается в более поздних слоях. Следовательно, его набор top-p растет почти линейно с длиной последовательности, а потенциальная вычислительная экономия от ZHA значительно снижается.
Одна из возможностей заключается в том, что первый слой глобального внимания не выучил такую же эффективную позиционную или релевантную структуру, как последующие слои. В гибридной модели NoPE, где полезная позиционная информация должна возникать неявно из предыдущих вычислений, это может быть особенно чувствительно к расположению слоев внимания и локального смешивания.
Другая возможность заключается в том, что этот первый слой внимания просто не принимает особенно полезных решений по поиску, зависящих от контента, и поэтому имеет относительно слабо дифференцированные оценки внимания.
Мы пока не знаем, какое объяснение верно, но тот факт, что все последующие слои демонстрируют существенно более благоприятное масштабирование, предполагает, что это относительно локализованное явление, а не фундаментальное ограничение архитектуры внимания модели.
MiMo-V2.6-Pro
Мы обнаружили удивительно похожую закономерность в MiMo-V2.6-Pro.
MiMo использует частичное RoPE (как и Qwen выше), применяя вращательные позиционные эмбеддинги только к части представлений запросов и ключей, а не ко всей их размерности. Это делает его еще одним интересным случаем для изучения того, как выбор позиционного кодирования взаимодействует со структурой выученных распределений внимания.
Как и в случае с Nemotron, конвертация ZHA соответствует производительности исходной модели. Есть незначительные колебания в оценках, но в целом они находятся в пределах шума и составляют максимум один или два балла. Некоторые оценки, такие как LongBench-v2, даже улучшаются.
Более интересный результат связан с масштабированием внимания. Подобно Nemotron, MiMo демонстрирует почти линейное масштабирование top-p в своих самых ранних слоях внимания. Однако в данном случае эффект присутствует в первых двух слоях внимания, а не только в первом.
Остальные слои демонстрируют гораздо более благоприятное сублинейное масштабирование top-p, показывая, что модель способна изучать хорошо структурированные, концентрированные распределения внимания на большей части своей глубины. Тем не менее, эти первые два слоя оказывают существенное влияние на общую вычислительную экономию, доступную благодаря ZHA.
В совокупности по всем 10 слоям глобального внимания наша смоделированная задержка предсказывает точку пересечения примерно на 89 тыс. токенов, после которой ZHA становится эффективнее плотного внимания. Однако общее ускорение на 10 миллионах токенов составляет всего 3,9×, что, хотя и существенно, значительно меньше, чем выигрыш, доступный, когда все слои демонстрируют благоприятное масштабирование top-p.
Это происходит не потому, что распределения внимания модели равномерно рассеяны по всей сети. Совсем наоборот: большинство слоев внимания имеют относительно хорошую структуру top-p. Скорее, небольшое количество плохо масштабируемых слоев может непропорционально влиять на общие затраты на внимание, ограничивая общее ускорение, даже когда большинство слоев модели ведут себя хорошо.
Что происходит в первых нескольких слоях?
Сходство между Nemotron и MiMo особенно интересно, поскольку их схемы позиционного кодирования не идентичны. Nemotron использует гибридный NoPE, а MiMo — частичный RoPE. Тем не менее, оба демонстрируют почти линейное масштабирование top-p, сосредоточенное в самых ранних слоях внимания, за которым следует существенно лучшее масштабирование глубже в сети.
Мы пока не понимаем точную причину этого явления.
Одна из возможностей заключается в том, что самые ранние слои внимания выполняют несколько иную функцию, чем последующие. Вместо выборочного извлечения небольшого набора релевантных токенов эти слои могут участвовать в более широком смешивании информации или в создании позиционных и контекстных представлений, которые последующие слои могут использовать для более избирательного поиска.
Другая возможность состоит в том, что позиционные представления, доступные ранним слоям внимания, просто менее развиты. Это согласуется с нашими предыдущими наблюдениями относительно неявной позиционной информации в архитектурах NoPE. Однако неясно, объясняет ли тот же механизм MiMo, учитывая, что Qwen демонстрирует стабильно благоприятное масштабирование, также используя частичное RoPE.
Также возможно, что эти слои просто менее обучены или менее эффективно используются, чем последующие слои внимания, что приводит к распределениям внимания, которые менее избирательны, чем могли бы быть.
Разграничение этих возможностей потребует дальнейшего исследования.
Однако особенно обнадеживает то, что проблема носит весьма локализованный характер. В обеих моделях более поздние слои внимания демонстрируют благоприятные свойства масштабирования, которые мы ожидаем от субодратичного механизма внимания.
Это говорит о том, что относительно целенаправленные вмешательства, такие как дообучение самых ранних слоев внимания для улучшения их структуры top-p, потенциально могут восстановить большую часть вычислительной эффективности, которая в настоящее время теряется, без необходимости внесения каких-либо существенных изменений в остальную часть модели.
GPT-OSS-120B: Сложности расширения длинного контекста
Наконец, мы преобразовали GPT-OSS-120B, важную модель с открытыми весами, имеющую широкое значение для практических и корпоративных развертываний.
GPT-OSS представляет собой интересный контраст с Nemotron и MiMo. В то время как эти модели демонстрируют относительно локализованные проблемы в своих первых нескольких слоях внимания, GPT-OSS демонстрирует другую аномалию, связанную с поведением распределений внимания при длинных контекстах.
Наши результаты преобразования в целом хорошие, хотя снижение производительности более заметно по сравнению с Qwen, Nemotron или MiMo.
В то время как большинство показателей оценки остаются неизменными, производительность в SWE-bench снижается несколько более заметно, с 59,6 до 55,8, а наибольшее ухудшение происходит в RULER на 128 тыс. токенов, где производительность падает с 63,3 до 46,0.
Хотя это значительная потеря, стоит также отметить, что плотный базовый уровень работает относительно плохо при такой оценке поиска по длинному контексту по сравнению с другими моделями, которые мы изучаем.
Изучение распределений внимания дает нам потенциальную подсказку, почему это происходит.
В отличие от Qwen, GPT-OSS не демонстрирует равномерно чистого степенного масштабирования top-p во всем диапазоне контекста. Вместо этого мы наблюдаем необычное выравнивание кривых к концу контекстного окна, что предполагает изменение структуры распределения внимания при длинных последовательностях.
Одним из возможных объяснений является процедура расширения контекста модели.
GPT-OSS использует YaRN для расширения своего внимания на основе RoPE до контекстного окна в 131 тыс. токенов. Вполне вероятно, что некоторая комбинация позиционной экстраполяции, обучения расширению контекста или недостаточного воздействия длинных контекстов приводит к аномальному поведению внимания, которое мы наблюдаем.
Однако мы не можем установить это на основе имеющихся данных. Хотя архитектура и использование YaRN задокументированы публично, полные детали, необходимые для определения причины, недоступны.
Отчасти из-за этих осложнений и возникающей в результате аномальной разреженности внимания при длинных контекстах, ZHA фактически обеспечивает особенно значительную модельную вычислительную экономию.
Наша модель задержки предсказывает точку пересечения примерно на 40,1 тыс. токенов, при этом ZHA становится все более эффективной по мере увеличения длины контекста. При 10 миллионах токенов прогнозируемое ускорение внимания составляет примерно 58,2× по сравнению с плотным вниманием.
Эти результаты подчеркивают разницу между двумя отдельными вопросами: можно ли эффективно аппроксимировать внимание модели и сохраняет ли полученная разреженная модель свою способность эффективно использовать очень длинные контексты.
Для GPT-OSS мы получаем существенные вычислительные преимущества, но необычная структура внимания при длинном контексте, по-видимому, затрудняет точное преобразование, особенно при оценках, требующих интенсивного поиска. Будь то из-за базовых плотных паттернов внимания, дефицита обучения в нашем маршрутизаторе или того и другого вместе, GPT-OSS, следовательно, сходит с узкого пути в другом направлении по сравнению с Nemotron и MiMo: поиск недостаточно масштабируется с длиной последовательности.
Это несколько отличается от поведения, наблюдаемого в Nemotron и MiMo, где основная проблема заключается в относительно небольшом количестве плохо масштабируемых ранних слоев, в то время как общая модель сохраняет свои возможности чрезвычайно хорошо.
Вместе эти примеры демонстрируют, что структура распределений внимания модели может влиять как на эффективность, так и на точность преобразования ZHA, но не всегда одинаково.
Преобразование ZHA остается чрезвычайно дешевым в масштабе
Одним из самых обнадеживающих результатов этих экспериментов является то, насколько мало дополнительного обучения требуется для преобразования даже самых больших моделей.
Наша процедура дистилляции работает локально на отдельных слоях внимания. Вместо того чтобы обновлять основу модели для воспроизведения ее исходных выходных данных с помощью крупномасштабного сквозного процесса обучения, мы независимо обучаем эталонные запросы, используемые для построения и поиска иерархических сводок. Цель состоит просто в том, чтобы сопоставить массу вероятности внимания, назначенную различным фрагментам контекста, что является гораздо меньшей задачей обучения, чем обычная дистилляция знаний.
Важно отметить, что мы вообще не обучаем основу. Ее исходные веса остаются замороженными, что означает, что нам не нужно поддерживать состояния оптимизатора или градиенты для триллионов предобученных параметров. Дополнительное обучаемое состояние состоит только из эталонных запросов, которые ничтожны по размеру по сравнению с самой моделью.
На практике процедура дистилляции настолько недорога, что выполнение полного набора оценок заняло значительно больше времени, чем само обучение преобразованию, даже для наших самых больших моделей.
Это довольно примечательное свойство для архитектурной модификации, которая фундаментально меняет то, как внимание получает доступ к длинным контекстам.
Это говорит о том, что преобразование ZHA не обязательно должно быть новым крупным этапом обучения. Вместо этого его потенциально можно рассматривать как легковесную процедуру адаптации, применяемую к уже способной предобученной модели, без необходимости дорогостоящего процесса переобучения или обширных изменений в ее базовых возможностях.
Возможно, удивительно, но мы не обнаружили, что размер модели сам по себе является серьезным препятствием. Действительно, самая большая модель в наших экспериментах, Qwen3.8-2.4T-A95B, демонстрирует самое чистое масштабирование внимания и самое сильное сохранение производительности при преобразовании ZHA.
Более сложная проблема кроется в другом.
Настоящим узким местом может быть основа модели.
Возвращаясь к аргументу об «узком пути» из нашей первоначальной статьи, эти эксперименты показывают, что самым важным препятствием для масштабирования эффективного внимания может быть не сам алгоритм внимания.
ZHA предоставляет механизм для поиска релевантной информации без необходимости проверки каждого токена в последовательности. Это позволяет сохранять большую часть поведения чрезвычайно крупных предобученных моделей, а процедура дистилляции остается недорогой даже при масштабе в триллионы параметров.
Однако ничто из этого не гарантирует, что базовая модель выучила распределения внимания, хорошо подходящие для сублинейного поиска. Для этого модель уже должна была научиться осмысленно распределять вероятность внимания по мере увеличения длины контекста. Наши результаты показывают, что это свойство крайне чувствительно к тому, как обучается базовая модель.
Qwen демонстрирует удивительно чистое степенное масштабирование в длинных контекстах. Nemotron и MiMo в основном показывают схожее благоприятное поведение, но с почти линейным масштабированием в своих самых ранних слоях внимания. GPT-OSS демонстрирует аномальное поведение top-p ближе к концу своего контекстного окна.
Почему возникают эти различия? Мы подозреваем, что важную роль могут играть несколько аспектов обучения.
Во-первых, расширение контекста может играть особенно значительную роль. Модель, которая хорошо работает с более короткими последовательностями, не обязательно выучивает правильную статистическую структуру для гораздо более длинных контекстов. Расширение позиционного кодирования или выполнение ограниченной донастройки для длинного контекста может создать видимость эффективной работы с длинным контекстом, не восстанавливая при этом ту же структуру внимания, что и у модели, обученной более основательно на таких длинах.
Во-вторых, недообученность на длинных контекстах может быть особенно актуальна для моделей передового уровня. Обучение чрезвычайно больших моделей на очень длинных последовательностях дорого стоит, а количество токенов или шагов оптимизации, доступных при максимальной длине контекста, может быть ограничено. В результате у некоторых моделей может быть недостаточно возможностей для изучения стабильных, хорошо откалиброванных распределений внимания на больших дистанциях.
В-третьих, выбор и обучение позиционных представлений могут влиять на структуру внимания, особенно в самых ранних слоях. Сходства между Nemotron и MiMo позволяют предположить, что было бы интересно понять, систематически ли архитектуры NoPE и partial-RoPE демонстрируют иное поведение top-p по сравнению с моделями full-RoPE, или же это просто следствие других решений при обучении. Однако различное поведение top-p, наблюдаемое у Qwen3.8 2.4T, которая также использует partial RoPE, говорит о том, что только позиционное кодирование не объясняет эти закономерности.
Наконец, могут быть важны нестабильность обучения и калибровка логитов внимания, особенно в моделях передового уровня. Известно, что более крупные модели менее стабильны и сильнее страдают от взрывного роста нормы логитов внимания или других патологий, связанных с вниманием, если ими не управлять должным образом с помощью выбора архитектуры или гиперпараметров. Таким образом, патологии, которые мы наблюдаем у этих более крупных моделей, могут быть следствием самого масштаба.
Мы пока не знаем, какое из этих объяснений является доминирующим для той или иной конкретной модели.